最近对一个统计库做了计划内的容灾切换,即主备切换。操作的过程其实还是蛮顺利的。但是灾难切换中如果出现在问题,那就是灾难中的灾难了。
按照计划对配置信息做了同步,然后使用DG Broker做了SwitchOver操作。
这一次切换速度还是蛮快,我开了几个窗口看到日志都在不断输出,角色已经替换过来了。DG Broker切换的日志如下:
DGMGRL> switchover to test29;
Performing switchover NOW, please wait...
New primary database "test29" is opening...
Operation requires shutdown of instance "test2" on database "sgstatdb3"
Shutting down instance "test2"...
ORA-01031: insufficient privileges
Warning: You are no longer connected to ORACLE.
Please complete the following steps to finish switchover:
shut down instance "statdb2" of database "stest3"
start up instance "statdb2" of database "stest3"
这个时候备库已经切换为主库,只要重启切换前的主库即可。
但是这么一个简单的操作就出了问题。shutdown immediate命令敲下去之后,客户端就没有反应了。
SQL> shutdown immediate
ORA-01092: ORACLE instance terminated. Disconnection forced
SQL> Write failed: Broken pipe
然后等了一下,从中控端去登录就无法连通了。这个问题确实够奇怪,我去ILO查看发现系统已经在自动重启了。
当然宽慰的是切换已经完成,可以先让应用的同学去测试他们的业务了。我们可以继续处理这个意料之外的问题。
在宕机的瞬间,数据库alert日志只输出了一行内容“
ORA-1092 : opitsk aborting process
Write failed: Broken pipe
查看ILO的界面,发现系统已经在初始化中了。
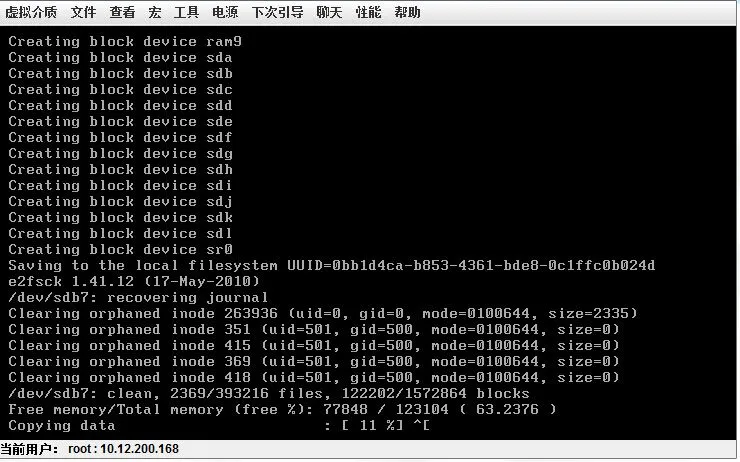
等了一会就看到系统的界面提示RAID信息貌似不一致了。这个库里的盘很多,配置这个还真不在行。
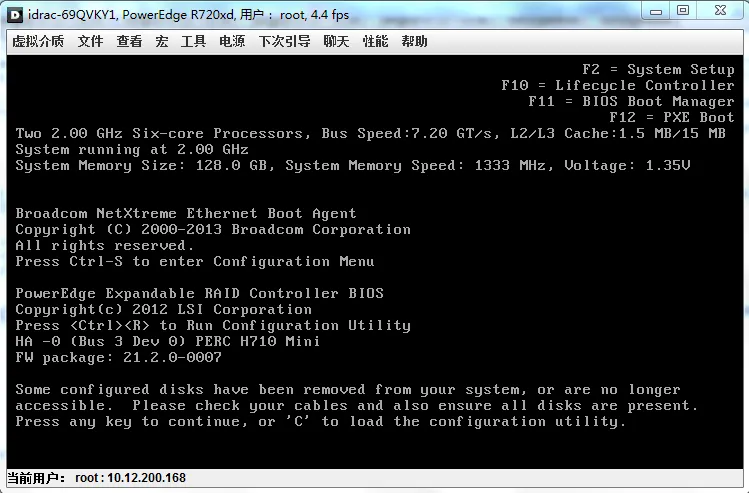
简单咨询了下同事,还是选择热引导重启,重启之后,貌似那个问题是过去了,然后就弹出一个错误。已经很明确告诉我是BUG,而且是CPU相关的。
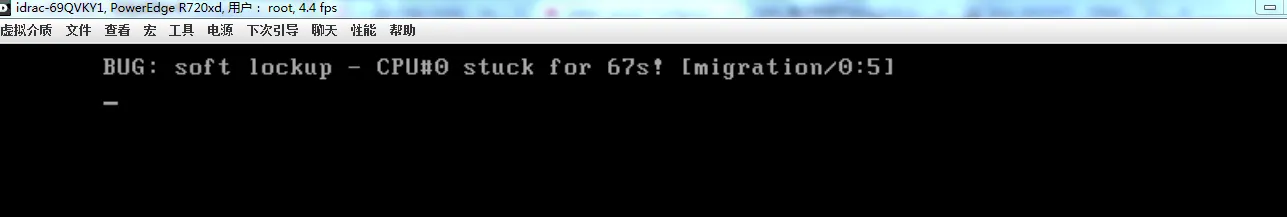
再次重启,还是同样的问题,这个时候我们就需要两手准备,如果服务器无法重启,就需要马上开始准备新的备库的事宜了。
最后我们还是尝试冷引导,类似断电重启的方式,这一次系统竟然起来了,也算是不幸中的万幸了。
当然对于这个问题。马上就收到了一个报警短信,提示服务器的/var目录空间不足了。
仔细一看原来生成了kdump文件,有大概6G左右。
-rw------- 1 root root 6446125056 May 26 11:15 vmcore-incomplete
对这个文件是需要使用命令crash或者其它第三方工具查看的,根据同事的反馈,在Dell 720XD,系统6U3中确实会有这种问题。
我这个问题的必备条件全满足了,我还在想是否为什么之前没有碰到过,仔细一看原来早就有这个坑了,去年的时候这个数据库就重启过,已经有了crash的问题了。
# ll
total 8
drwxr-xr-x 2 root root 4096 Aug 2 2015 127.0.0.1-2015-08-02-09:50:47
drwxr-xr-x 2 root root 4096 May 26 15:46 127.0.0.1-2016-05-26-11:05:18
后续进行更多的分析。
按照计划对配置信息做了同步,然后使用DG Broker做了SwitchOver操作。
这一次切换速度还是蛮快,我开了几个窗口看到日志都在不断输出,角色已经替换过来了。DG Broker切换的日志如下:
DGMGRL> switchover to test29;
Performing switchover NOW, please wait...
New primary database "test29" is opening...
Operation requires shutdown of instance "test2" on database "sgstatdb3"
Shutting down instance "test2"...
ORA-01031: insufficient privileges
Warning: You are no longer connected to ORACLE.
Please complete the following steps to finish switchover:
shut down instance "statdb2" of database "stest3"
start up instance "statdb2" of database "stest3"
这个时候备库已经切换为主库,只要重启切换前的主库即可。
但是这么一个简单的操作就出了问题。shutdown immediate命令敲下去之后,客户端就没有反应了。
SQL> shutdown immediate
ORA-01092: ORACLE instance terminated. Disconnection forced
SQL> Write failed: Broken pipe
然后等了一下,从中控端去登录就无法连通了。这个问题确实够奇怪,我去ILO查看发现系统已经在自动重启了。
当然宽慰的是切换已经完成,可以先让应用的同学去测试他们的业务了。我们可以继续处理这个意料之外的问题。
在宕机的瞬间,数据库alert日志只输出了一行内容“
ORA-1092 : opitsk aborting process
Write failed: Broken pipe
查看ILO的界面,发现系统已经在初始化中了。
等了一会就看到系统的界面提示RAID信息貌似不一致了。这个库里的盘很多,配置这个还真不在行。
简单咨询了下同事,还是选择热引导重启,重启之后,貌似那个问题是过去了,然后就弹出一个错误。已经很明确告诉我是BUG,而且是CPU相关的。
再次重启,还是同样的问题,这个时候我们就需要两手准备,如果服务器无法重启,就需要马上开始准备新的备库的事宜了。
最后我们还是尝试冷引导,类似断电重启的方式,这一次系统竟然起来了,也算是不幸中的万幸了。
当然对于这个问题。马上就收到了一个报警短信,提示服务器的/var目录空间不足了。
仔细一看原来生成了kdump文件,有大概6G左右。
-rw------- 1 root root 6446125056 May 26 11:15 vmcore-incomplete
对这个文件是需要使用命令crash或者其它第三方工具查看的,根据同事的反馈,在Dell 720XD,系统6U3中确实会有这种问题。
我这个问题的必备条件全满足了,我还在想是否为什么之前没有碰到过,仔细一看原来早就有这个坑了,去年的时候这个数据库就重启过,已经有了crash的问题了。
# ll
total 8
drwxr-xr-x 2 root root 4096 Aug 2 2015 127.0.0.1-2015-08-02-09:50:47
drwxr-xr-x 2 root root 4096 May 26 15:46 127.0.0.1-2016-05-26-11:05:18
后续进行更多的分析。