一句话定位:这不是"哪个 AI 评审最强"的排行榜,而是"这张考卷本身靠不靠得住"——考卷的答案不是一个人写的,是四路来源凑出来再逐条校验的。同样的方法可迁移到缺陷单的有效性标注、客服回复的质量抽样、代码扫描告警的误报率评估、内容审核规则的回测。
摘要
GitHub 在 10 月 5 日开源了 ReviewBench,一个面向 AI 代码评审的离线基准。它的做法不是让几个人拍板"这条评论对不对",而是从人类评审、后续提交、静态分析工具、多个模型四路收集候选发现,去重后按同一把尺子逐条判定。本文拆开它的三处设计——黄金集怎么来的、为什么主指标只能比召回、离线预测和线上 A/B 差在哪——看一个基准要怎样才能被信任。
评测代码评审工具最难的地方不是打分,是标准答案从哪来。
一条被 AI 指出来的问题,到底是真问题还是噪音,得有人判断。如果判断的人只有两个,他们的偏好就成了答案;如果判断的是一个模型,这个模型的偏见就成了答案。GitHub 在 10 月 5 日公开的 ReviewBench,花大力气解决的正是这一件事。
考卷是从 1.039 亿个 PR 里挑出来的
先看规模。GitHub 分析了 103.9 million(1.039 亿)个 pull request,用来看真实的评审负载长什么样。最终基准包含 219 个公开 PR,来自 187 个有公开开源许可证的仓库,覆盖 19 种语言。
这里有一个刻意的调整值得注意:语言分布和仓库规模是照着 GitHub 整体直接对齐的,但 PR 规模向"可审查的中间与尾部"加权,减少微小单文件改动的过度代表,保留更有实质内容的多文件 PR。
这个选择的含义是——他们不追求"真实分布",而追求"有区分度的分布"。真实分布里大量 PR 是一行改动,测不出评审工具的水平。
标准答案不是一个人写的
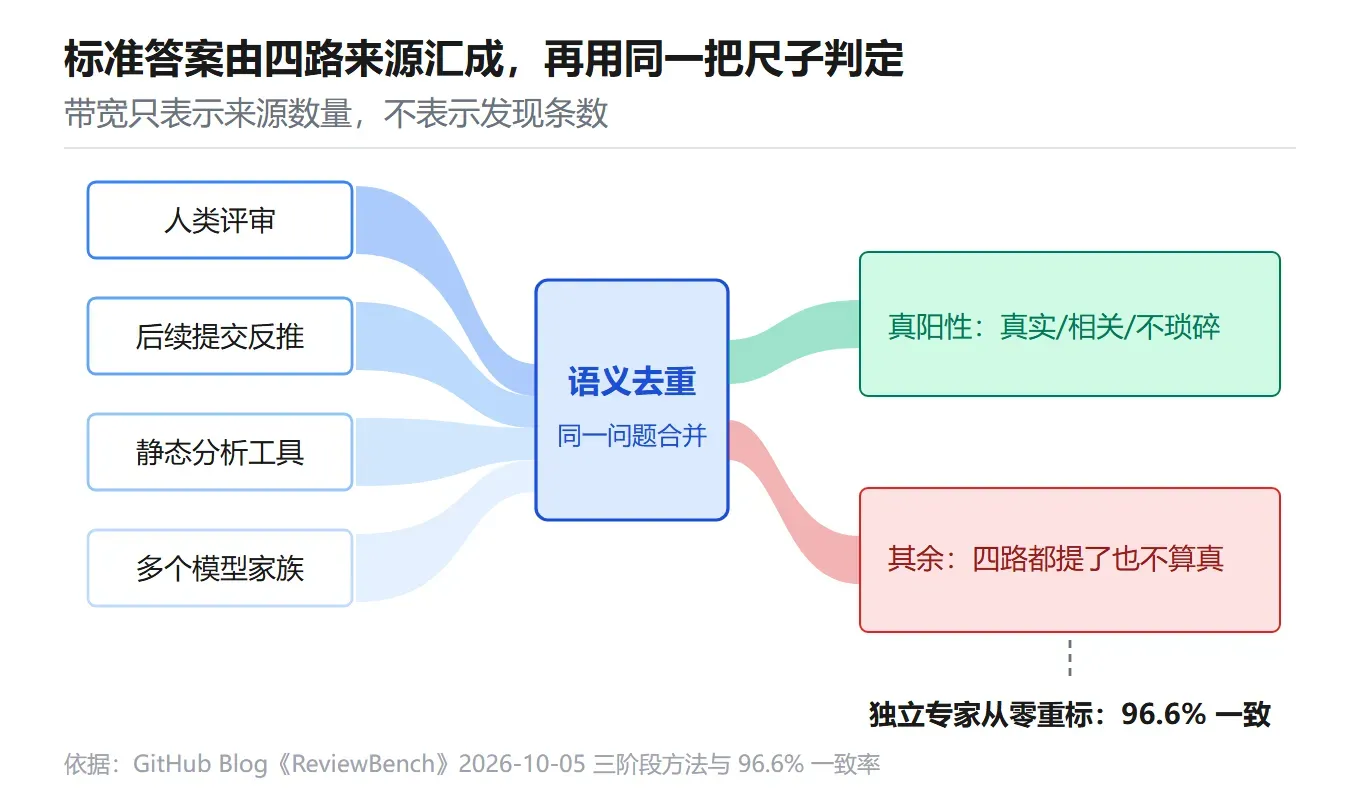
ReviewBench 的黄金集由四路候选凑出来:真实的人类评审意见、从作者后续 commit 反推出来的问题、确定性静态分析工具的输出、多个不同模型家族的前沿 LLM 的发现。
四路凑完之后要做语义去重,把指向同一个底层问题的发现合并。去重不只是为了干净,原文给了两条理由:一是避免多个来源"一致"而人为抬高黄金集,二是避免依赖单一来源的盲区。
然后是判定的核心原则,原文写得很清楚:一条发现是否为真,不看它的来源。人提的、工具提的、模型提的,都过同一把尺子——只有真实、相关、不琐碎,才算真阳性。评分模型用的是 Claude Sonnet 5,评分标准与评审模型都公开,便于复现。
最后一层保险是独立复核:发布前,未参与构建的资深工程师从零重新标注每一条真实发现,他们的真/假阳性判断与 ReviewBench 一致率 96.6%。数据集、评审模型、匹配器都做版本管理。
96.6% 这个数在这里的作用,相当于给一把新尺子做的校准记录。它不说明尺子绝对正确,但说明两个独立的人按同一份标准做,能落到同一个答案上。
为什么要出两套指标
ReviewBench 有六个指标,分成两组。
第一组是 grounded precision / recall / F1:只对照黄金集里已有的标签,同口径比较。
第二组是 augmented precision / recall / F1:黄金集里没匹配到的新发现,也交由评审模型独立判断它是真阳性还是假阳性。这一组的用意是让评审工具因为"发现了一个谁都没记录过的真问题"而加分,而不是被自动扣分——原文的原话是,增强指标要承认这种行为,而不是自动惩罚它。
听起来第二组更公平,但原文紧接着做了一个很硬的规定:因为增强召回率的分母会随每个 agent 发现的东西而变化,跨系统比较时用 grounded recall 作为主指标,augmented 指标只作为单个系统的诊断。
这条规定值得所有做评测的人抄一遍:可以让指标更公平,但不能让分母变成变量。一个分母会变的分母,等于没有分母。
线下预测对上线上
第三部分是这个基准为什么被 GitHub 自己当回事。
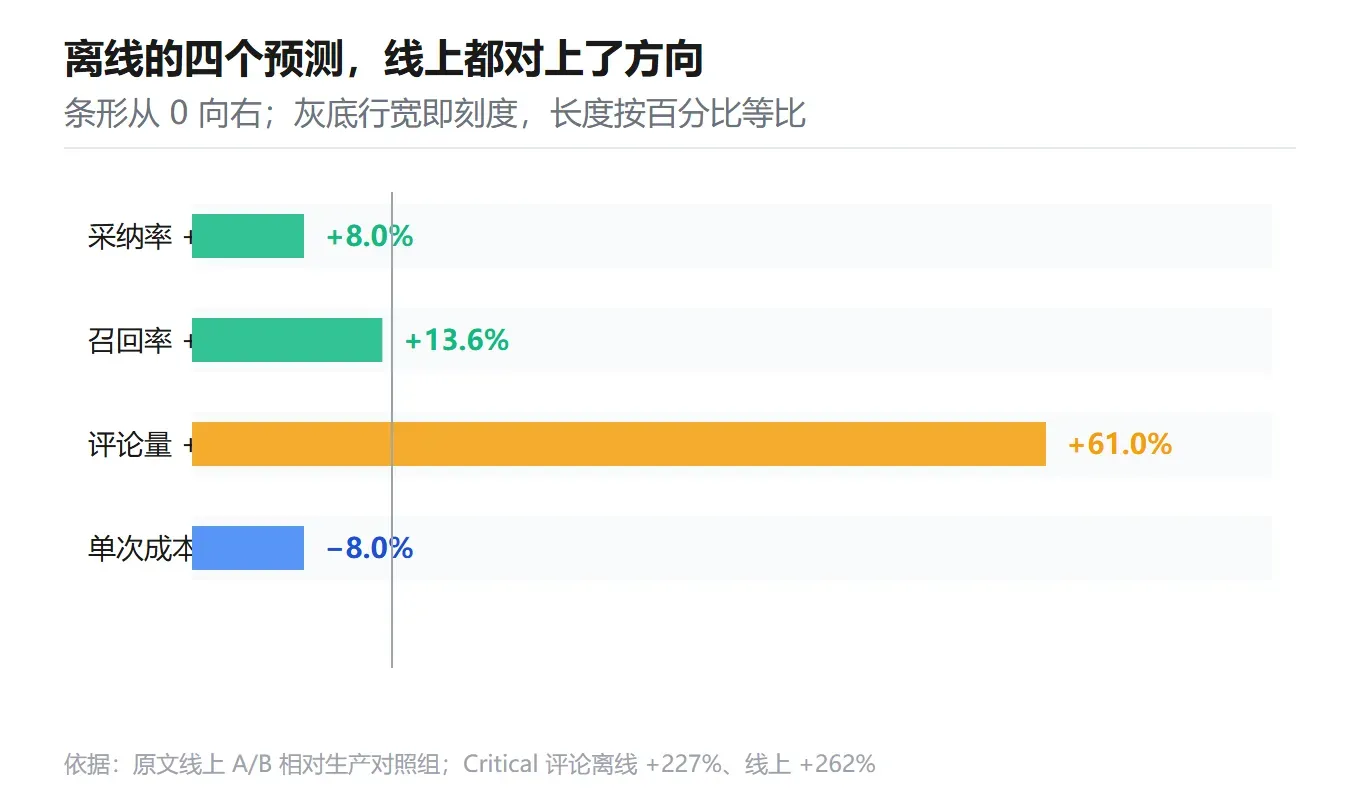
他们用 ReviewBench 评估 Copilot code review 的一次改动:从单次运行改成多模型集成审查,把多次独立模型运行合并成一份评审。离线预测是精确率、召回率、评论量都上升,单次审查成本下降。
线上 A/B 的结果(相对生产对照组):addressed rate +8.0%,召回率 +13.6%,评论量 +61%,单次审查成本 −8.0%。严重程度这一层也对上了:ReviewBench 预测 Critical 评论 +227%,线上是 +262%,同时呈现出更多中等评论、更少吹毛求疵的偏移。
这里最容易误读的是 +61% 的评论量。评论变多通常被当成噪音,但在召回率也上升、且中等评论占比提高的情况下,它说明原来漏掉的问题被找出来了。方向一致比数值一致更重要——原文自己也承认,线上实验才是用户影响的最终衡量,ReviewBench 只是提前给出方向。
跑一次要交什么
想把自己的系统放上去,流程是公开的:用 GitHub 账号登录,注册 agent,提供容器镜像、配置和自己的模型密钥(评分模型由官方提供);先在 25 个 PR 的测试集上反复调;再对完整 219 个 PR 跑 3 轮,由与其他条目相同的评分模型打分;维护者审核前分数保持私密,只有超过当前榜上分数或首次上榜才公开。
这个流程本身就是一道防作弊设计——先在小子集上调参,再在全量上跑固定的三轮,调参与计分用的不是同一批数据。
局限它自己写了
原文直接列了三条局限:固定黄金集必然不完整,系统变强之后会发现自己没预见的问题;增强召回率的分母可变,不适合跨系统比较;线上实验仍是最终判据。
还有几条是文章没写、但从数据能看出来的:219 个 PR、187 个仓库、19 种语言的规模,覆盖不到私有代码库的特征;评审模型是 Claude Sonnet 5,评分质量与这个模型和它的提示配置绑定;语料全部来自 GitHub 平台。
一个基准把这些都写出来,比它把分数做高更有价值。因为使用这个基准的人,需要知道什么时候不能信它。
评测里最贵的一步,从来是造答案,不是打分。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。