本文是“系统学习推荐算法”的第七期,首发于我的博客
当你是抖音的资深用户时,推荐系统对你的习惯早已了如指掌,你日积月累的点赞、停留、转发都会变成系统理解你的线索,但如果这是你第一次打开抖音的推荐系统。面对的是一个没有任何历史信息的新账号,该给你推荐什么呢?
同样的一条刚发布的视频,没有播放数据,没有点赞评论,系统该把它推给谁呢?甚至一个刚成立的新平台,既没有用户也没有内容,整个系统几乎一片空白。推荐系统又该如何开始运转呢?
这就是推荐系统领域最经典的问题之一,冷启动。
三类冷启动问题
用户冷启动、内容冷启动和系统冷启动。虽然表现形式不同,但它们都指向同一个难题,在起始阶段缺少足够的数据来理解用户和内容。推荐系统强大的能力本质上是从历史数据中学习来的,冷启动却没有历史,当数据一片空白时,推荐系统该如何工作呢?
用户冷启动——解决方案
非个性化推荐
最常见的一类策略就是先猜,既然不了解你的兴趣,那就直接利用一些全局统计规律,给你推荐大家都爱看的内容,也就是召回里提到的非个性化推荐。
比如给新用户推荐全平台最热门的视频,最近增长最快的内容,还有平台当前重点推广的话题活动。
静态特征
光靠热门推荐还远远不够,因为人和人的兴趣差异实在太大了。于是推荐系统开始利用有限的用户特征和内容特征,尽可能缩小猜测的范围。新用户刚登录平台时,往往会填写年龄、性别、地区等资料。有些平台还会主动询问你的兴趣偏好,让你先选择几个感兴趣的频道,关注几位知名创作者。
除此之外,平台还会收集更多信息,比如你的设备型号、注册渠道,甚至是你从哪个广告点进来的,这些信息共同组成了用户画像里的静态特征。当系统几乎没有行为数据可用时,这些基础信息是最重要的线索。
内容冷启动
分析内容特征
而对于内容冷启动来说,即使新内容没有浏览量,系统依然能够分析它本身包含的内容特征,推测它可能适合哪些人
比如一个新视频被识别为篮球集锦,系统也可以把它推荐给平时关注 NBA、浏览体育内容的用户,等得到用户的真实反馈后,再逐渐用行为数据接管后续的推荐过程。
内容冷启动的目标:
精准推荐:把新内容推荐给合适的用户,不引起用户反感
激励发布:流量向低曝光新内容倾斜,激励作者发布
挖掘高潜:通过初期小流量试探(初期每篇内容都给曝光,雨露均沾),找到高质量的内容,给予流量倾斜
假如一篇笔记没有获得几次曝光。即使笔记的质量特别高,系统也没有办法发现这是篇优质笔记,不会给这篇笔记更多的流量。让它变成热门笔记,所以我们要保证,每篇新笔记在初始的探索阶段都能获得足够多的曝光
探索与利用
然而,不管是“利用静态特征”还是“分析内容特征”,系统能够获得的线索终究十分有限。于是冷启动发展进入第二个阶段——探索与利用利用
把你已经表现出兴趣的内容继续推给你。你看 NBA 集锦,它就给你更多球星高光时刻,但只利用会把你锁进信息茧房,你永远看不到篮球之外的世界。于是探索登场了,系统故意向你推荐一些从未交互过的内容。对于新用户来说,这是在试探你的兴趣边界。对于新视频来说,这是在测试它到底有没有潜力。探索是有代价的,一次失败的探索换来一个滑走,可能还伴随短暂的失望。但一次成功的探索可能打开一扇新的大门,让用户的长期满意度飙升。
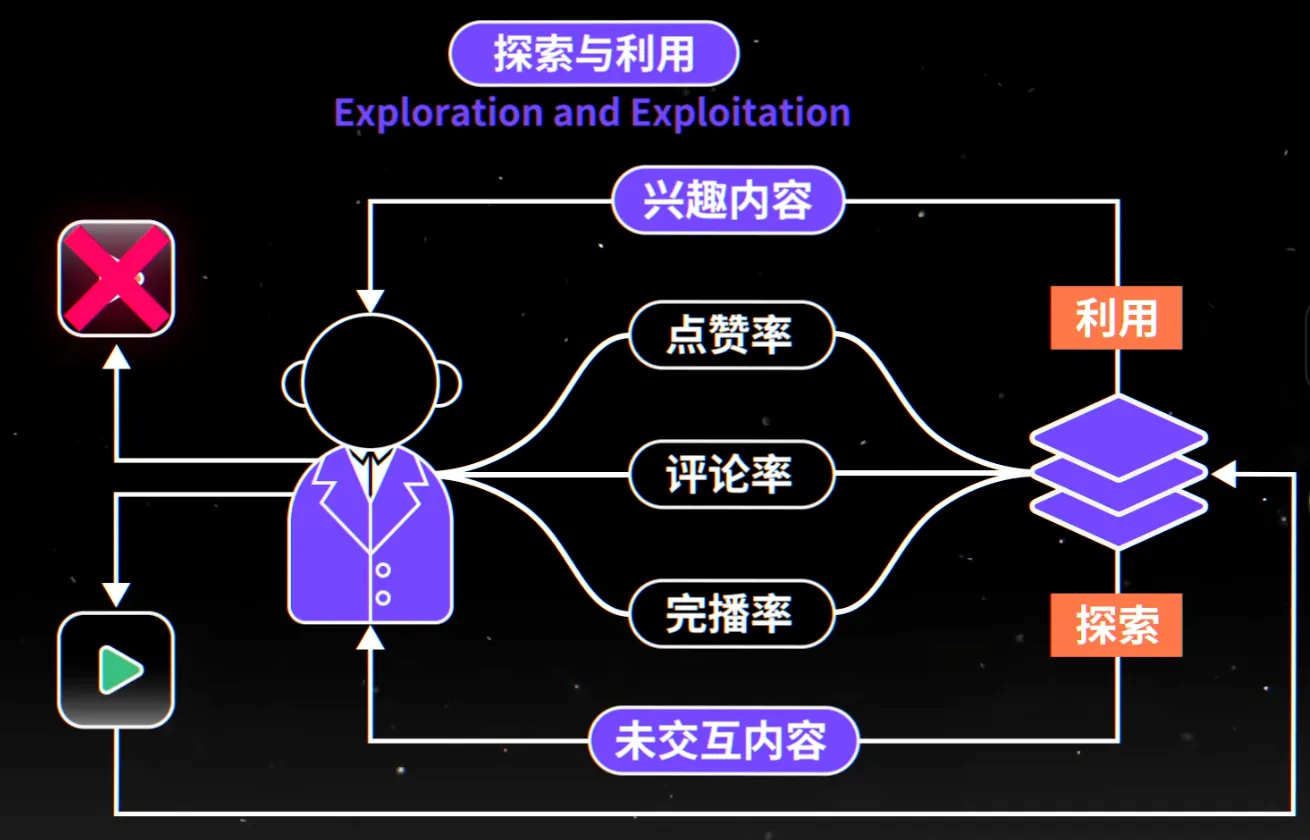
而冷启动最核心的问题就是如何在探索与利用之间找到平衡,这个问题在数学上对应一个经典难题。多臂老虎机。
赌场里有一排老虎机,它们外表一模一样,但重奖概率却不同。你投入几个硬币摇动摇币就能随机获得一些收益。你的目标很简单,用有限的次数引到尽可能多的钱。这时候你有两种选择,一种是一直玩目前中奖率最高的那台机器,也就是利用,另一种是尝试其他机器。虽然短期可能会输钱,但有可能发现中奖率更高的新机器,也就是探索。
这与推荐系统的冷启动都很相似,每个内容类别就是一个老虎机,每次推荐就是一次摇臂,用户点击就是中奖系统
由此引出了以下几种解决这个平衡问题的算法
贪婪算法
要在已知的好内容和未知的可能之间做决策,最简单的方法是大部分时间选择当前表现最好的内容,一小部分时间随机探索,这就是贪婪策略。例如90%的时间推荐当前平均收益最高的视频类型,剩下10%的时间随机尝试其他内容,系统都会根据用户反馈更新各类内容的平均收益。
这种方法简单高效,但探索太随机 会导致流量浪费在一些明显不感兴趣的内容上,更关键的是用平均收益来衡量视频的表现有很大的不确定性。比如两个视频的平均点击率都为10%,一个已经获得上万次曝光,另一个只获得十次曝光,并不能说明两个视频一样好。
UCB 算法
于是工程师改变了思想,每次尝试选择收益上限最大的视频,也就是置信上界算法(UCB (Upper Confidence Bound))。
$A{t}=\arg \max {a}\left[Q{t}(a)+c\sqrt{\frac{\ln t}{N{t}(a)}}\right]$
每一个视频得分由两部分构成,第一部分是历史平均收益代表利用,第二部分是不确定奖励代表探索。
如果一个视频的曝光次数 $N_{i}$ 很少,那么分母小,整个根号值就很大,系统会因为这个视频不确定性大而去探索它。随着曝光次数增加,不确定性奖励会逐渐变小,系统会更相信平均收益。
UCB 算法将探索与利用合二为一、表现良好且稳定的内容,持续获得流量,很少出现潜力大的内容,也会有机会被发现。
汤姆森采样
如果说贪婪是在随机探索,ucb 是在奖励高潜力,接下来的汤普森采样则是在进行概率评估。他不为每类视频维护一个固定分数,而是维护一个可能性范围。
可以把自己想象成一位带研究生的教授刚招来一批学生时,你并不清楚每个人的真实水平,每个人的实力都可能在青铜和王者之间。我们假设实力分布符合一个 Beta 分布,win表示完成任务的次数,lose表示失败的次数。初始时win 等于1,lose 等于1,表示你对学生的水平一无所知。随着时间的推移,每出现一个任务你就要安排一个当前最看好的学生去做。如果学生任务做的很好win加1,如果学生搞砸了lose加1,实力分布的曲线会随之变化。下次出现新任务时,就从更新的实力分布曲线里随机选猜测实例。随着某个同学做的任务越来越多,曲线越来越集中在某个值表示老师对他的水平也越来越了解。
你是王者还是青铜都可以明了,王者大多数时候都会被选中,但经验不多的新人虽然真实水平未知,但由于存在成为隐藏大佬的可能,也会获得展示自己的机会,这就实现了探索和利用的平衡。
举一反三
探索和利用虽然有效,但如果每认识一个用户都要从零开始摸索一遍,代价还是太高了,如果平台已经积累了海量用户和视频的数据,能不能把这些经验利用起来?这便进入了冷启动发展的第三阶段:举一反三
迁移学习
最先出现的思路叫迁移学习,顾名思义,就是把一个场景中学到的经验迁移到另一个场景。比如视频平台新上线短剧业务,虽然短剧数量很少,但平台已经积累了大量长视频数据,于是系统可以先利用长视频领域学到的经验,再针对短剧场景进行调整,从而在数据不足时也能快速获得不错的推荐效果。
主动学习
不过,借来的经验终究不是自己的经验,系统还是需要尽快获得真实反馈。于是主动学习出现了。推荐系统往往是被动等待用户反馈,你点赞系统才知道你喜欢。你划走,系统才知道你不感兴趣。整个过程只是在已有的数据里学习,
但主动学习的思路是,如果我知道我自己缺少哪些重要信息,为什么不主动去获取?比如一个新用户只看过篮球视频,系统面临一个关键的不确定性,它是喜欢所有体育内容还是只喜欢篮球。这时系统可能会推荐世界杯视频进行测试。如果用户点赞,说明他对更广泛的体育内容感兴趣。如果滑走,则说明他的兴趣可能更集中在篮球本身。换句话说,主动学习关注的不只是推荐什么最可能成功,还关注推荐什么最能帮助我理解用户。
元学习
随着研究深入,工程师把目光投向更高一层,能不能让系统掌握一种能力,每当遇到新的冷启动场景时,都能迅速找到最有效的学习方式。这便引出了元学习,元学习被称为学习如何学习。传统模型的训练样本通常是一条条用户行为数据,而元学习的训练样本则是一个个任务。
在推荐场景中,一个任务可以理解为一次完整的能启动过程。系统先观察一批用户的少量行为数据,称为支持集,再观察后续产生的新行为,称为查询集。训练过程中,模型先利用支持集建立判断,再用查询集验证效果,并不断调整学习策略。模型目标不是记住某个用户喜欢什么,而是通过大量任务,学会利用少量样本快速适应新用户的方法。
总结
冷启动并不是完全没有办法推荐,而是在行为数据不足时,先用已有线索做出初步判断,再通过反馈逐渐修正判断。面对新用户,可以从热门内容、静态特征和主动选择的兴趣入手;面对新内容,可以先分析内容特征,把它推荐给可能感兴趣的人。系统冷启动则是用户和内容两端都缺少历史数据,起步更难。
有了初步推荐之后,系统还要在利用已知兴趣和探索未知可能之间做选择。贪婪策略留出少量随机探索,UCB 根据收益和不确定性分配机会,汤普森采样则从可能的收益分布中抽样。它们的共同目的,是让当前表现好的内容继续被看见,也让尚未获得足够曝光的新内容有机会证明自己。
如果每次冷启动都从零开始,学习成本会很高。迁移学习借用相近场景的经验,主动学习有针对性地获取关键反馈,元学习则训练模型用少量样本快速适应新任务。把线索用起来、给未知留机会、尽快从反馈中学习,就是解决冷启动问题的主线。