做 SEO 排名监控,最容易踩的坑不是“抓不到”,而是抓到了却比错了。
同一个关键词“企业代理 IP 服务”,从北京出口抓到第 3 位,从深圳出口抓到第 7 位——你以为是排名波动,实际上只是两个城市的 SERP 本来就不一样。更隐蔽的情况是:你用了轮换代理,同一个城市的两轮抓取走了不同出口,排名从 5 跳到 8,触发了告警,排查半天才发现页面根本没变,是出口层不一致造成的“地区漂移”。
再加上 SERP 页面里天然存在的噪声——跟踪参数导致的重复链接、同一文章以不同 URL 出现、聚合页和原文页混排——如果不做 URL 规范化和内容去重,排名数据本身就是不可比的。
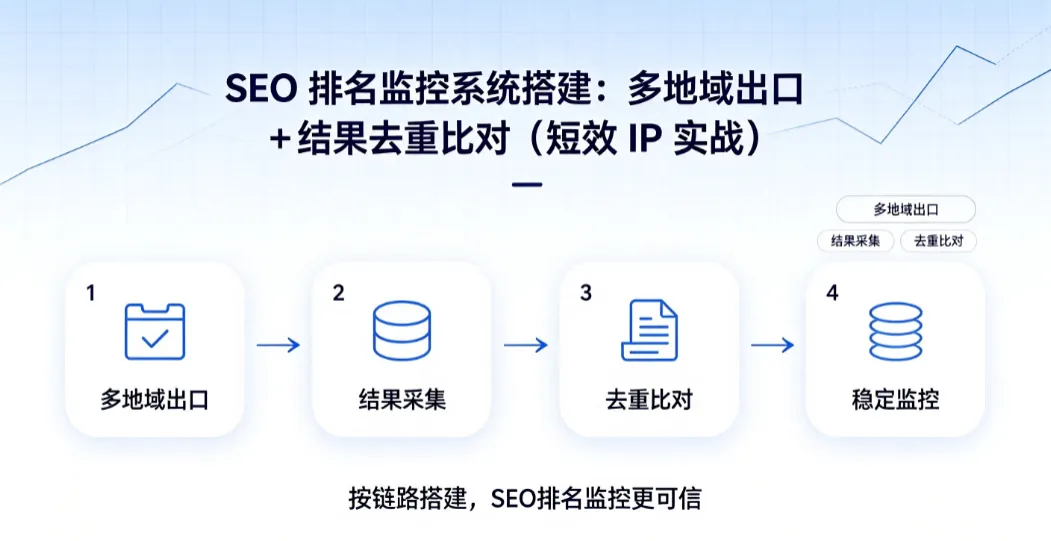
这篇文章拆解一套可落地的 SEO 排名监控方案:多地域出口分层保证“从正确的地方看”,结果去重比对保证“看到的东西可比”。
一、排名监控比落地页监控多了两个维度
落地页可用性监测只回答“页面能不能打开”。SEO 排名监控要回答的是“在特定地区的特定搜索引擎上,目标页面排在第几”。多出来的两个维度,决定了架构的不同:
| 落地页可用性监测 | SEO 排名监控 | |
|---|---|---|
| 出口要求 | 多地区覆盖即可,出口可随机 | 按城市锁定出口层,同一对比组内出口不能漂移 |
| 结果判定 | 状态码 + 关键元素 | 从 SERP 中解析出目标 URL 的排名位置 |
| 噪声来源 | CDN/线路故障 | 重复链接、参数变体、聚合页挤占 |
| 失败代价 | 误报可用性故障 | 误判排名变化,导致错误的 SEO 决策 |
关键差异在出口层。轮换代理在采集场景里是优点,能有效分散请求来源、降低 403/429 封禁率;但在排名监控的对比型任务里,出口漂移反而是噪声源。同一关键词的排名对比,必须在同一个出口层内完成;跨出口层的比较,只能用于“覆盖”或“发现”,不能用于判断“涨了还是跌了”。
还有一个 2025 年之后必须纳入设计的约束:Google 已于 2025 年 9 月正式移除 &num=100 参数,SERP 不再支持单次返回 100 条结果,必须用 start=0,10,20... 分页获取。这意味着排名监控如果覆盖前 30 或前 50,每轮需要发 3–5 次分页请求,出口层管理和请求节奏控制变得更加重要。
二、整体架构:出口层是核心抽象
text
┌─────────────────────────────────────────────┐
│              调度器(Scheduler)              │
│   关键词 × 城市 × 设备 / 分页轮转              │
└────────────────────┬────────────────────────┘
                     │ 下发 (keyword, city, page_start)
┌────────────────────▼────────────────────────┐
│          出口层管理(Egress Layer)           │
│   城市 → 代理池映射 / 同层内轮换 / 层间隔离     │
└────────────────────┬────────────────────────┘
                     │ 返回该城市可用的代理
┌────────────────────▼────────────────────────┐
│           SERP 抓取与解析(Probe)            │
│   分页请求 / HTML 解析 / 目标 URL 排名提取    │
└────────────────────┬────────────────────────┘
                     │ 原始结果(含重复/噪声)
┌────────────────────▼────────────────────────┐
│           去重比对(Deduplicator)            │
│   URL 规范化 / 内容指纹 / 排名合并            │
└────────────────────┬────────────────────────┘
                     │ 干净的结构化排名
┌────────────────────▼────────────────────────┐
│           存储与告警(Sink)                  │
│   按出口层聚合 / 环比同层基线 / 异常排名告警   │
└─────────────────────────────────────────────┘
出口层管理是地基。它的职责不是“搞到代理”,而是保证同一个对比任务里的请求走同一个逻辑出口层。一个出口层 = 城市 + 运营商(可选)+ 设备类型的组合,层内允许轮换 IP,但轮换不能跨层。
三、出口层管理:按城市提取,同层内轮换
短效接口支持按城市提取,也支持指定协议和去重模式。基础接口格式为:
text
https://api.sdbufeng.vip/bf/shared/getip?token=TOKEN&proxy\_type=socks5&amount=1&expire=1-3
参数中 time 控制 IP 存活分钟数,短效提供 3、5、10、30 分钟多档;area 用于指定城市;protocol指定 HTTP/HTTPS/SOCKS5;filter 控制 IP 去重模式。对于城市级排名监控,按城市提取是必须的——你需要的是“从上海出口探一次、从北京出口探一次”,而不是“随机拿一个 IP 探一次”。
python

import requests

def fetch_city_proxies(api_key: str, city: str, num: int = 3,
                       protocol: str = "http",
                       lifetime: int = 5) -> list[str]:
    """按城市提取步峰短效代理。"""
    try:
        resp = requests.get(
            "https://api.bufengip.com/getip",
            params={

                "key": api_key,
                "num": num,
                "type": "json",
                "time": lifetime,       # 分钟,步峰短效支持 3/5/10/30 档
                "area": city,           # 指定城市
                "protocol": protocol,   # http / https / socks5
                "filter": 1,            # IP 去重,避免短时间内拿到重复出口
            },
            timeout=10,
        )
        data = resp.json()
        if data.get("code") != 0:
            return []
        return [
            f"http://{item['ip']}:{item['port']}"
            for item in data.get("data", [])
        ]
    except Exception:
        return []
但“拿到代理”只是第一步。更关键的是出口层的数据结构设计。不要维护扁平代理列表,而是按层组织:
python

from dataclasses import dataclass, field

@dataclass
class EgressLayer:
    city: str
    protocol: str
    proxies: list[str] = field(default_factory=list)
    fail_count: dict[str, int] = field(default_factory=dict)

    def pick(self) -> str | None:
        """从本层健康代理中选一个。永不跨层。"""
        healthy = [
            p for p in self.proxies
            if self.fail_count.get(p, 0) < 3
        ]
        if not healthy:
            # 层内全部失效,重置失败计数(不借用其他层的代理)
            self.fail_count = {
   p: 0 for p in self.proxies}
            healthy = self.proxies
        return healthy[0] if healthy else None

    def mark_fail(self, proxy: str):
        self.fail_count[proxy] = self.fail_count.get(proxy, 0) + 1
核心约束是: pick() 永远不会返回其他城市的代理。 如果上海层暂时没有可用 IP,正确做法是跳过本轮上海采样并标记“未覆盖”,而不是“借一个杭州的 IP 先跑着”。后者正是把出口漂移引入对比数据的典型操作。步峰短效接口覆盖 100+ 城市,城市资源总体充足,但层内临时枯竭仍然可能在某个时刻发生,代码必须显式处理这一情况。
如果某些场景下城市级锁定要求不那么严格,也可以使用隧道代理简化接入:客户端只持有一个固定入口地址,出口轮换由服务端完成。代价是出口选择权交给服务端,无法精确指定城市。两种方式的选择取决于你的监控矩阵是否需要“城市级可解释性”。
四、SERP 抓取:2025 年之后必须分页
Google 移除 num=100 之后,每页最多返回 10 条结果,覆盖前 30 名需要 start=0、start=10、start=20 三次请求。每次分页请求都必须走同一个出口层的代理,否则第 1 页从上海看、第 2 页从杭州看,拼出来的“前 30 名”是不成立的。
python

import time
import requests

def fetch_serp_pages(keyword: str, proxy: str,
                     max_pages: int = 3,
                     delay_range: tuple = (2, 6)) -> list[str]:
    """抓取 SERP 分页 HTML 列表。同一出口层内完成。"""
    pages = []
    for i in range(max_pages):
        start = i * 10
        try:
            resp = requests.get(
                "https://www.google.com/search",
                params={
   "q": keyword, "start": start, "hl": "zh-CN"},
                proxies={
   "http": proxy, "https": proxy},
                headers={
   "User-Agent": "Mozilla/5.0 ..."},
                timeout=(5, 15),
            )
            if resp.status_code != 200:
                break
            pages.append(resp.text)
        except requests.RequestException:
            break
        # 分页之间随机间隔,避免固定节奏被识别为自动化
        if i < max_pages - 1:
            import random
            time.sleep(random.uniform(*delay_range))
    return pages
请求节奏值得单独说明。社区和代理服务商的经验阈值一致指向同一个结论:固定间隔比随机间隔更容易触发 Google 的速率保护。同一 IP 下,固定 3–5 秒间隔的风险显著高于随机 8–15 秒;完全按请求轮换 IP 则能将进一步降低单 IP 曝光。在出口层框架下,这意味着:单层内分页请求之间加随机延迟,层与层之间通过短效 IP 轮换分散负载。
五、结果去重比对:URL 规范化是第一道闸
SERP 里的“重复”有两种性质完全不同的问题:
| 类型 | 例子 | 处理方式 |
|---|---|---|
| 同一内容的 URL 变体 | ?utm_source=x、HTTP/HTTPS、尾斜杠、大小写 |
URL 规范化,排名提取之前执行 |
| 不同 URL 的近似内容 | 同一文章被聚合页/镜像站转载 | 内容指纹(SimHash),作为辅助标记 |
第一道闸必须在排名计算之前执行。 如果先按原始链接算排名,第 3 位是带 utm_source 的变体,第 5 位才是干净链接,去重后你看到“干净链接排第 4”,但用户实际看到的干净链接本来就在第 5 位——排名口径已经偏了。
python

from urllib.parse import urlparse, urlunparse, parse_qsl, urlencode

TRACKING_PARAMS = {

    "utm_source", "utm_medium", "utm_campaign",
    "utm_term", "utm_content", "gclid", "fbclid",
    "ref", "source", "spm", "igshid", "mkt_tok",
}

def normalize_url(url: str) -> str:
    """URL 规范化:SERP 排名比对前必须执行。"""
    p = urlparse(url.strip())
    scheme = "https"
    netloc = p.netloc.lower().removeprefix("www.")
    path = p.path.rstrip("/") or "/"
    query_pairs = [
        (k, v) for k, v in parse_qsl(p.query, keep_blank_values=True)
        if k.lower() not in TRACKING_PARAMS
    ]
    query = urlencode(sorted(query_pairs))
    return urlunparse((scheme, netloc, path, "", query, ""))
注意查询参数不能一刀切全删。有些页面靠特定参数标识内容(如文章 ID、分类参数),全部丢弃会导致不同页面被错误合并。只剔除已知的跟踪参数,保留功能性参数并排序,是更稳妥的做法。
规范化后的排名提取:
python

def find_target_rank(pages_html: list[str], target_url: str) -> int | None:
    """在分页 SERP 中查找目标 URL 的 1-based 排名。"""
    canon_target = normalize_url(target_url)
    rank = 0
    seen = set()
    for html in pages_html:
        links = extract_result_links(html)  # 按搜索引擎选择器解析
        for link in links:
            canon = normalize_url(link)
            if canon in seen:
                continue
            seen.add(canon)
            rank += 1
            if canon == canon_target:
                return rank
    return None
extract_result_links 需要针对目标搜索引擎写选择器,这里不展开。关键是去重后的位次才是用户实际看到的可见位置:同一个规范化 URL 在 SERP 中即使出现两次(比如聚合页和原文页指向同一 canon),也只占一个排名位。
内容级近似去重(SimHash)在第一版中建议只作为辅助标记,不直接踢链接。SERP 的标题和摘要文本量很小,SimHash 的区分度有限;URL 规范化已经能覆盖绝大多数噪声。把 SimHash 指纹存入结果字段,积累人工确认的样本后再决定是否启用硬去重,是更务实的路径。
六、调度与比对:同层基线才是可比的基线
去重后的排名落库时,出口层标识必须作为主键的一部分。没有出口层标识的排名记录,本质上是一堆无法解释来源的数字。
sql

CREATE TABLE serp_rank (
    id          BIGSERIAL PRIMARY KEY,
    keyword     TEXT NOT NULL,
    city        TEXT NOT NULL,
    protocol    TEXT NOT NULL,
    device      TEXT NOT NULL DEFAULT 'desktop',
    target_url  TEXT NOT NULL,
    rank        INT,
    page_start  INT,
    egress_hash TEXT NOT NULL,
    sampled_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);

CREATE INDEX idx_serp_compare
    ON serp_rank (keyword, egress_hash, device, sampled_at DESC);
egress_hash由 city + protocol + device 生成,不依赖具体代理 IP:
python

import hashlib

def egress_hash(city: str, protocol: str, device: str) -> str:
    raw = f"{city}|{protocol}|{device}"
    return hashlib.sha256(raw.encode()).hexdigest()[:16]
比对逻辑不跟“全站平均”比,只跟同一 egress_hash + 同一设备类型的最近一次有效采样比。出口层变了,系统自动把该条记录标记为“不可比”,而不是硬算出一个 delta 去触发告警。
python

def rank_delta(current: dict, previous: dict | None) -> dict:
    if previous is None:
        return {
   "delta": None, "comparable": False}
    if current["egress_hash"] != previous["egress_hash"]:
        return {
   "delta": None, "comparable": False,
                "reason": "egress_mismatch"}
    if current["rank"] is None or previous["rank"] is None:
        return {
   "delta": None, "comparable": False,
                "reason": "rank_missing"}
    return {
   "delta": previous["rank"] - current["rank"], "comparable": True}
七、几个工程上的判断
第一,重试不能替换出口层。 一次请求失败后,在同一出口层内换一个 IP 重试可以接受;因为“上海层没 IP 了”就换杭州 IP 重试,失败样本就被替换成了“其他地区的成功样本”,对比结论直接失真。重试函数应该接收 EgressLayer 而不是裸 proxy,从接口设计上堵住跨层重试。
第二,短效 IP 的存活窗口要覆盖整组分页请求。 3 分钟短效 IP 覆盖 3 次分页请求(每次间隔 2–6 秒)绰绰有余;但如果分页间隔设得较大或超时阈值较高,需要确认 IP 存活时间覆盖整个分页周期,避免第 1 页抓完后 IP 到期、第 2 页被迫用新 IP,导致同一组 SERP 的分页数据来自两个出口。
第三,filter 参数和出口层轮换是互补关系,不是替代关系。 filter=1 防止同一批提取中拿到重复 IP,但它不控制跨批次的城市锁定。出口层的数据结构才是“同层可比”的保证;filter 只是减少同批次的冗余。
第四,留存原始 SERP 哈希,不要只存最终排名。 当业务方质疑“深圳的排名是不是抓错了”,你需要能回溯:那一轮用了哪个城市、哪个协议、分页覆盖到第几页、规范化后目标 URL 的匹配结果是什么。只存一个 rank=7 是排查不了的。
SEO 排名监控的本质,不是“抓 SERP”,而是构造可比较的观测。多地域出口解决“从哪看”,结果去重比对解决“看到的东西算不算同一件事”。短效 IP 在这个方案里承担的是出口层基础设施的角色:按城市提取保证地域视角可控,层内轮换保证长期运行不被限流,层间隔离保证对比基线不被污染。步峰的短效接口在参数层面提供了城市、协议、去重和有效期几个关键控制点,接进上面这套出口层结构,就可以跑起一个可解释、可回溯的多地域排名监控循环。