
引言
语音转写这件事,实时和离线是两套完全不同的工程。实时转写追的是"延迟",一秒内必须出字;离线转写追的是"精度与吞吐",一段两小时的录音可以慢慢跑,但错一个字都可能影响后续检索与归档。
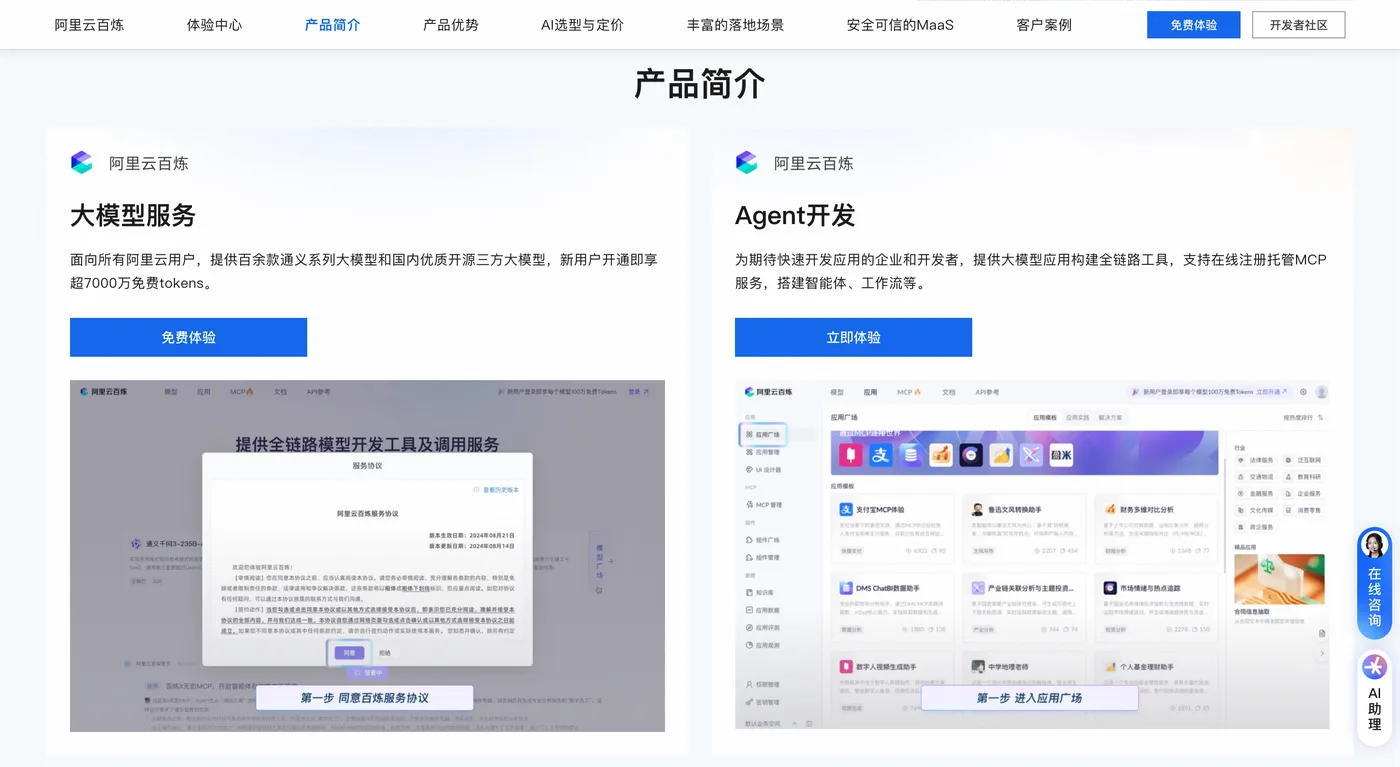
Qwen-Audio-ASR-Flash-Filetrans 属于后者。它专为非实时、整段音视频文件设计,模型 ID 为 qwen-audio-3.0-asr-flash-filetrans,按音频秒数计费。下面从定位、特征、能力、场景与计费五个层面完整介绍。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、模型定位:为整段文件设计的高性能转写
官方描述非常克制,就一句话:"专为非实时、整段音视频文件设计的高性能转写模型"。这一定位带来三个直接推论:
第一,不做流式。 只有 HTTP API 一种调用方式,提交任务后由平台异步处理、回调或轮询取结果。你没法"边说边出字幕",但可以"一次交一整个文件"。
第二,单次输入是完整文件。 官方没有标注上下文与输入长度上限(页面显示为"—"),这与对话类模型的窗口概念不同——它按音频时长处理,不受 Token 窗口约束。
第三,设计目标很具体。 官方直接点名三个场景:短视频字幕、客服质检、金融双录。这三个场景的共同点是:量大、需要批量跑、对专有名词准确率要求高。
在三代同堂的 ASR 家族里,它的位置很特别:3.0 是"按秒计费"的那一版,3.1 已改为"按 Token 计费",qwen3-asr-flash-filetrans 则是另一条产品线。这三者的价格口径完全不同,后面会专门拆开算。
详情👉访问阿里云百炼大模型服务平台页面 了解。
二、核心特征
第一,Context 上下文增强。 这是它区别于基础 ASR 的关键能力。简单说,模型不只看当前这一小段音频,还会参考前后文来判断词义——同音字、断句、指代都靠这个纠正。长录音里"上一句说了什么"对"这一句怎么断"影响极大,上下文增强正是为此设计。
第二,垂直行业热词识别强化。 官方明确写了"强化了垂直行业热词的识别精度"。这对金融、医疗、法律、电商这类专有名词密集的行业是刚需——"授信额度"不能被听成"受信额度","双录"不能被听成"双路"。
第三,端到端模型,不是拼接流水线。 传统 ASR 是声学模型+语言模型+解码器的组合,每一段都有误差累积。端到端大模型把识别与纠错放在一个网络里,复杂噪声环境下的稳定性更好。
第四,多声道支持。 调用参数里有 channel_id 数组,可以按声道分别转写。客服双录、坐席与客户分轨录音的场景,靠这个参数实现"谁在说话"的分离,而不必依赖声纹聚类。
第五,输出为纯文本。 输入音频、输出文本,不做结构化标注。需要时间戳、角色标签、JSON 字段,要在后处理层自己补。
第六,能力边界清晰。 不支持 Function Calling、结构化输出、联网搜索、前缀续写、上下文缓存、批量推理与模型调优。它是转写工具,不是对话模型;"批量推理"不支持,意味着大批量任务要靠自行排队调度。
第七,限流宽裕。 RPM 600,在转写类模型里属于较高水位,适合并发提交多文件任务。
三、能力拆解:能做好什么,做不好什么
做得好:
- 短视频字幕:整段视频批量转写,产出字幕底稿。
- 客服质检:全量通话转写,做关键词与话术命中分析。
- 金融双录:销售过程录音留痕,双声道分离,便于逐句核对。
- 会议与访谈纪要:长录音一次性转写,产出文字底稿。
- 内容生产:播客、课程、直播回放的文字化。
- 通话分析:批量转写后做意图分类、情绪识别。
- 方言与多语种素材:配合 3.1 版本可做方言与语种可控输出。
不擅长的:
- 实时字幕(不做流式,要用实时版);
- 需要模型直接输出结构化 JSON(不支持结构化输出,需后处理);
- 需要说话人分离标签(该能力在 3.1 版本明确标注,3.0 页面未列此项,需实测确认);
- 需要模型自带批量调度(不支持批量推理,自己排队);
- 需要边转写边翻译(转写与翻译分两步做)。
一句话判断:"文件进、文字出、量大、要准"——就是它的主场。
详情👉访问阿里云百炼大模型服务平台页面 了解。
四、适用场景
| 场景 | 关键需求 | 说明 |
|---|---|---|
| 短视频字幕 | 批量、快速 | 整段文件转写,产出 SRT 底稿 |
| 客服质检 | 全量、关键词 | 与话术库比对,命中率分析 |
| 金融双录 | 分轨、留痕 | channel_id 按声道分离 |
| 会议纪要 | 长音频、准确 | 长录音一次提交 |
| 播客/课程文字化 | 内容量、可读性 | 后续做摘要与检索 |
| 通话分析 | 批量、意图分类 | 转写后接文本模型 |
| 实时字幕 | 低延迟 | 不适用,需实时版 |
| 结构化抽取 | JSON 字段 | 转写后接结构化模型 |
五、计费解析:按秒计费,输出不计费
计费口径很干净:按输入音频的秒数计费,输出文本不另计费。
| 计费项 | 华北2(北京) | 国际(新加坡等) |
|---|---|---|
| 音频时长 | 0.00022 元/秒 | 0.00026 元/秒 |
| 折合每小时 | 约 0.792 元 | 约 0.936 元 |
| 输出文本 | 不计费 | 不计费 |
| 限流 | RPM 600 | RPM 600 |
折算成好记的数:一小时音频约 0.79 元,一百小时约 79 元,一万小时约 7920 元。 这个量级对批量业务很友好——成本只与"录了多久"绑定,与音频码率、说话密度、识别难度都无关。
必须做的横向对比(口径不同,别直接比单价):
| 模型 | 计费方式 | 单价 | 折合每小时(估算) |
|---|---|---|---|
| qwen-audio-3.0-asr-flash-filetrans | 按音频秒数 | 0.00022 元/秒 | 约 0.79 元 |
| qwen-audio-3.1-asr-flash-filetrans | 按 Token 双向计费 | 输入 0.8 / 输出 2.7 元每百万 Token | 约 0.10–0.15 元 |
| qwen3-asr-flash-filetrans | 按音频秒数 | 0.00022 元/秒 | 约 0.79 元 |
| 美国部署版本 | 按音频秒数 | 0.000035 元/秒 | 约 0.126 元 |
(3.1 的折算依据是官方口径"每秒音频对应 25 个 Token",输入侧每小时约 9 万 Token,输出侧按中文语速估算;实际随语速浮动,仅供量级参考。)
结论有三条:
第一,按 Token 计费的 3.1 折算下来便宜得多。 差距在数倍量级。原因不是模型更强更贵,而是计费维度换了:按秒计费不看"说了多少字",按 Token 计费则与内容密度挂钩。做纯转写、追求单位成本低的,应优先核算 3.1。
第二,3.0 的价值不在单价,而在成熟度。 Context 增强与垂直行业热词的强化是这一版的重点投入。当业务对"专有名词一字不错"的要求高于"每千小时省几百块",3.0 更稳。
第三,别忘了跨地域价差。 同一能力在美国部署版本上是 0.000035 元/秒(约 0.126 元/小时),与北京口径差了近六倍。数据存放地域与合规定位不同,选哪个先看数据能不能出境。
省钱五个实招:
- 能切就切:只转写有效片段,静音与空白段先切掉。
- 先降采样:16kHz 单声道足够,高码率上传不省钱也不涨精度。
- 按需选代:纯转写走 3.1,术语密集走 3.0。
- 复用转写结果:同一音频不要重复提交,落库并做版本标记。
- 小样本先试:先用免费额度跑真实素材,量出"每小时真实成本"再谈预算。
详情👉访问阿里云百炼大模型服务平台页面 了解。
六、接入示例
提交异步转写任务:
curl --location '[https://dashscope.aliyuncs.com/api/v1/services/audio/asr/transcription](https://dashscope.aliyuncs.com/api/v1/services/audio/asr/transcription)' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--header "Content-Type: application/json" \
--header "X-DashScope-Async: enable" \
--data '{
  "model": "qwen-audio-3.0-asr-flash-filetrans",
  "input": { "file_urls": ["[https://your-bucket.example.com/call_001.wav](https://your-bucket.example.com/call_001.wav)"] },
  "parameters": { "channel_id": [0, 1] }
}'
双声道录音先拆轨,再分别提交,便于逐句核对:
ffmpeg -i stereo.wav -filter_complex "[0:a]channelsplit=channel_layout=stereo[L][R]" \
  -map "[L]" agent.wav -map "[R]" customer.wav
Python 轮询任务结果:
import os, time, requests

H = {
   "Authorization": f"Bearer {os.environ['DASHSCOPE_API_KEY']}"}
task_id = "提交后返回的 task_id"
url = f"[https://dashscope.aliyuncs.com/api/v1/tasks/{task_id}](https://dashscope.aliyuncs.com/api/v1/tasks/{task_id})"

while True:
    r = requests.get(url, headers=H).json()
    status = r["output"]["task_status"]
    if status in ("SUCCEEDED", "FAILED"):
        print(status, r["output"].get("results"))
        break
    time.sleep(5)      # 长音频轮询间隔别太密
详情👉访问阿里云百炼大模型服务平台页面 了解。
七、使用注意事项
第一,先确认计费口径。3.0 按秒、3.1 按 Token,同名同族价格差数倍,接入前用真实素材各跑一遍再定。
第二,channel_id 从 0 开始。多轨文件要逐轨提交或按数组提交,别把双声道当单声道跑,否则两个人同时说话会被合到一起。
第三,长音频要分段。单文件过长会影响处理时长与失败重试成本,按 30–60 分钟切、保留 1–2 秒重叠,避免切点吞字。
第四,热词表要"少而准"。塞几百个词反而干扰识别,只放高频专有名词、产品名、人名,定期按错词日志迭代。
第五,输出是纯文本,时间戳与角色标签要自己补。需要结构化字段的,转写完再走一次结构化模型。
第六,涉及通话录音、双录影像的处理,需完成告知与授权,并按数据分类分级要求存放;转写能力可用,不等于采集与留存合规。
结语
Qwen-Audio-ASR-Flash-Filetrans 是个定位非常清晰的工具:不做实时、不做结构、不做工具调用,只把"整段音频变成准文字"这一件事做扎实。它的成本结构也干净——按秒计费、输出免费、一小时约八毛。选它的理由通常是"术语不能错、场景要稳";只是想把音频批量变成文字,那么同族里按 Token 计费的 3.1 更省钱。判断标准只有一条:你的错误成本,是每小时八毛的差价,还是一句听错造成的返工。
