选服务器配置时,最常见的两种做法都不太可靠:一种是照抄别人的配置单,另一种是「反正是起步,买大一点总没错」。前者忽略了业务形态的差异,后者把一次性预算花在了长期用不上的余量上。更稳妥的次序是反过来——先把负载说清楚,再决定规格。
本文不谈规格命名怎么读、也不比较付费方式的优劣,只做一件事:给出一套从业务负载反推配置的可复用判断方法,外加升配前的四项检查。具体规格、实例族、付费方式与价格以官方页面实时展示为准,本文不列举易变数字。
一、先把「配置」拆成四个独立维度
很多人把配置理解成一个整体数字,结果一犹豫就整体升一档。实际上要判断的是四条彼此独立的资源线,瓶颈通常只出现在其中一条上。
| 维度 | 该观察什么 | 吃紧时的典型表现 | 常见误判 |
|---|---|---|---|
| 计算 | 稳态 CPU 使用率、峰值持续时长、单核还是多核 | 请求排队、响应变慢、进程 CPU 长期贴顶 | 把短暂编译峰值当成常态需求 |
| 内存 | 常驻占用、缓存命中、是否触发 swap | 频繁 swap、进程被 OOM 终止、数据库缓存失效 | 把文件系统缓存算成内存不足 |
| 存储 I/O | IOPS、吞吐、读写延迟、云盘队列深度 | 数据库慢查询、写入抖动、iowait 偏高 |
只看容量不看 IOPS,或反过来 |
| 网络 | 公网出带宽、连接数、包量 | 下载慢、连接超时、带宽打满 | 把回源流量与用户流量混在一起算 |
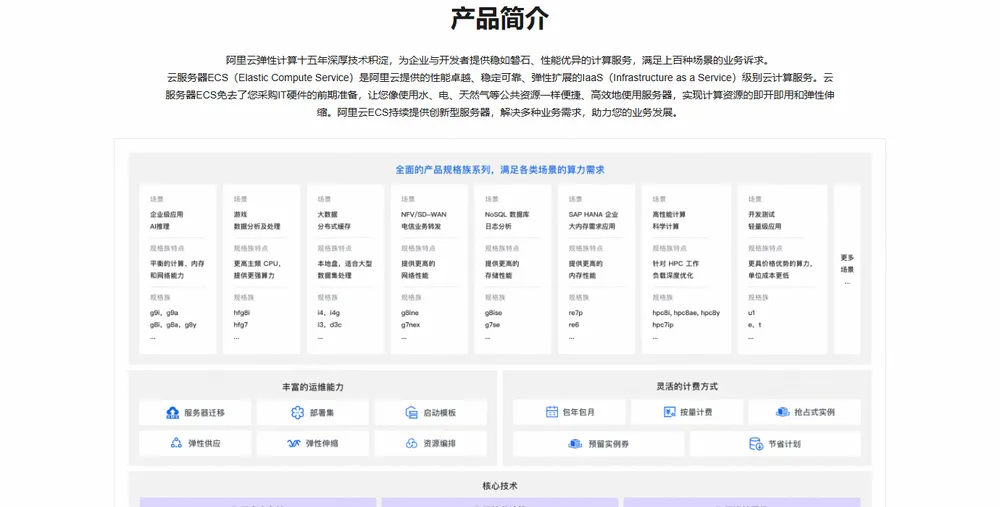
四条线分开看的意义在于:云服务器 ECS 产品页明确写了计算资源、存储空间、网络带宽可分别按需升降,也支持分钟级别的弹性扩容。既然能单独调,就没必要为了一个维度的瓶颈把整台机器升一档。
先取一组基线数据,别凭感觉:
# 计算与内存
top -b -n 1 | head -20
free -h
vmstat 1 5

# 存储 I/O
iostat -x 1 5

# 连接与带宽
ss -s
sar -n DEV 1 5
采样要覆盖业务高峰时段,最好连续取几天。单次 top 看到的数字几乎没有决策价值——它只说明那一秒发生了什么。
二、四类业务,四种判断侧重
把常见负载归成四类,不是为了贴标签,而是为了明确「先看哪一条线」。
| 负载类型 | 主要瓶颈维度 | 判断侧重 | 一个容易忽略的点 |
|---|---|---|---|
| CPU 密集型(批处理、转码、编译、科学计算) | 计算 | 峰值持续时长、能否并行、是否可错峰跑 | 作业型负载适合弹性,不必按峰值常驻 |
| 内存密集型(缓存、Java 服务、内存数据库) | 内存 | 常驻占用、堆上限、缓存命中率 | 留出系统与页缓存余量,别把内存配到刚好 |
| I/O 密集型(数据库、日志写入、文件服务) | 存储 I/O | IOPS 与吞吐、读写比例、延迟分布 | 云盘性能与容量是两件事,要单独确认 |
| 低流量 / 突发型(个人站、内部工具、活动页) | 通常不在单机 | 常态水位、峰值倍率、峰值可预测性 | 先用弹性与缓存扛峰值,而不是买常驻高配 |
这张表的使用方式是「先归类,再取样」:确认自己落在哪一格,然后只重点观测那一两条维度,其余维持起步即可。四类之间没有高低之分,同一台机器上跑混合负载时,按占主导的那类定主基调,再给次要负载留一点余量。
有个边界值得单独说:iowait 高不等于 CPU 不够。它表示 CPU 在等 I/O,此时升 CPU 基本无效,该动的是云盘性能或数据访问方式。把「慢」直接翻译成「配置不够」,是升配花冤枉钱最多的一条路径。
三、升配前的四项检查
真到了考虑升配的时候,按下面四条顺序过一遍。多数情况下,前两条就能把升配需求消掉。
检查 1:瓶颈是不是真的在配置上。 对照第一节的四个维度,确认哪条线持续吃紧、持续多久。如果 CPU 常年个位数、内存也没压力,只是某个接口慢,那问题多半在代码、数据库索引或外部依赖,不在规格。
检查 2:能不能先把负载搬出去。 静态资源外置、加一层缓存、把图片和下载流量交给对象存储与加速服务,往往比升配有效得多。这类调整还有个好处:它同时降低了对单机四个维度的压力,且不必改动业务代码结构。
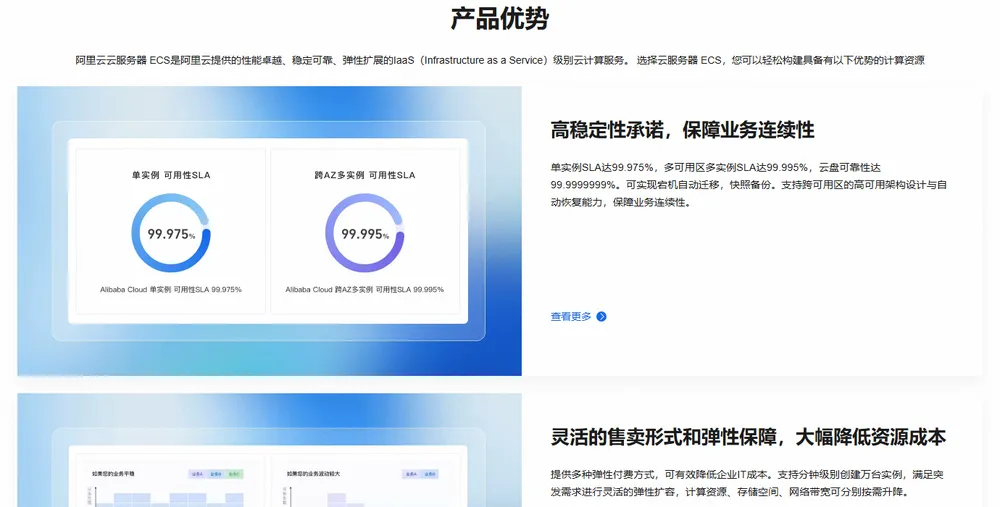
检查 3:能不能用弹性而不是常驻。 官方页把弹性扩容、按需升降列为产品能力,也提到面向突发需求的分钟级创建能力。如果峰值是可预测的(定时作业、活动时段),按峰谷安排弹性比按峰值买常驻更合理。这一条对第一类和第四类负载尤其有效。
检查 4:确认口径再动。 地域、可用区、镜像、云盘类型、带宽计费方式都会影响最终账单和迁移成本。具体规格、实例族、付费方式与价格以官方页面实时展示为准,动手前按当前页面核对一次,别沿用几个月前看过的数字。
四项都过完仍决定升配,也建议一次只动一个维度,观察一到两个业务周期再决定下一步。同时升 CPU、内存、云盘和带宽,出了问题很难判断是哪一项起了作用、哪一项白花了钱。
四、两个「什么情况别选它」
情况一:偶发峰值,别用常驻高配去扛。 一个月只出现几小时的高负载,用长期高规格覆盖,等于为绝大部分空闲时间付费。这类场景优先考虑弹性扩容、排队削峰或把作业挪到低峰时段。判断依据不是「峰值有多高」,而是「峰值占全年时长的比例」。
情况二:该横向拆的问题,别用单机升配解决。 当单机已经承载了 Web、数据库、缓存、定时任务好几类角色,继续往上加规格只会让故障域更大、排查更难。这时候更该做的是把角色拆开、把状态外置,而不是继续把一台机器做大。规格提升有上限,架构调整没有。
这两条其实是同一个判断:升配解决的是「同一类负载变多了」,不解决「负载类型变了」或「架构该拆了」。
五、验收:改完怎么确认改对了
- 记录改前基线:四个维度各取一组高峰时段数据,保存下来;
- 一次只改一个维度,改后同样口径再取一组;
- 对比关注指标是否真的改善——响应时间、吞吐、
iowait、swap 次数,而不是只看配置页面上的数字变大了; - 观察至少一个完整业务周期(含一次峰值),确认没有把瓶颈转移到另一条线上;
- 把「改了什么、为什么、效果如何」记一行,供下次判断参考。
第 5 条最常被省略,但它决定了下一次选型是重新开始,还是能站在上次的结论上。
小结
按负载定配置的顺序是:拆成计算、内存、存储 I/O、网络四条线 → 判断负载属于哪一类 → 只测关键维度 → 升配前过四项检查 → 改完用同口径验收。这套方法不依赖任何具体规格数字,换个业务、换个时间也能照着走。
产品能力、实例族、规格与价格以 云服务器 ECS 官方产品页实时展示为准。真正省钱的不是选到那个「刚好够」的档位,而是先弄清楚自己到底在为什么付钱。