摘要
GitHub 在 2026 年 11 月 17 日给每个仓库的 Insights 页加了「Repository insights」,第一个模块就是 Copilot 代码审查的产出:已处理意见数、高危已处理数、审查后没有后续人工改动的 PR 数、以及未经 Copilot 审查就合并的 PR 数。同一天还给了一个比例指标——addressed rate,即"已处理的可评估意见 ÷ 可评估意见",并附带分子、分母、无法评估的排除项。这个设计比一个单一的处理率诚实得多,但也把三个容易被忽略的口径问题摆到了台面上。这篇讲清楚:当"已处理"包含"延到下一个 PR 再改"时,它到底在奖惩什么。
新页面上第一屏摆的是四个数,先把它们认全。
Repository insights 放在每个仓库 Insights 标签页的第一项,给四个汇总信号:
已处理的审查意见:被处理过的 Copilot 审查评论。
已处理的高危意见:被抓到、并且被处理的高危 Copilot 审查评论。
审查后没有后续人工改动的 PR:经过 Copilot 审查、但之后没有收到人类审查者改动要求的 PR。
未经 Copilot 审查就合并的 PR:合并了,但 Copilot 审查没审过的 PR。
除了这四个数,还能看"处理率"(addressed rate):已处理的可评估意见占可评估意见的比例,连同分子、分母、无法评估的排除项、时间趋势和可用的细分维度。评论类别也能看。同样的指标也在企业级和组织级的 repository 1-day 报表(repos-1-day)里,可以通过 Copilot usage metrics API 拿到。
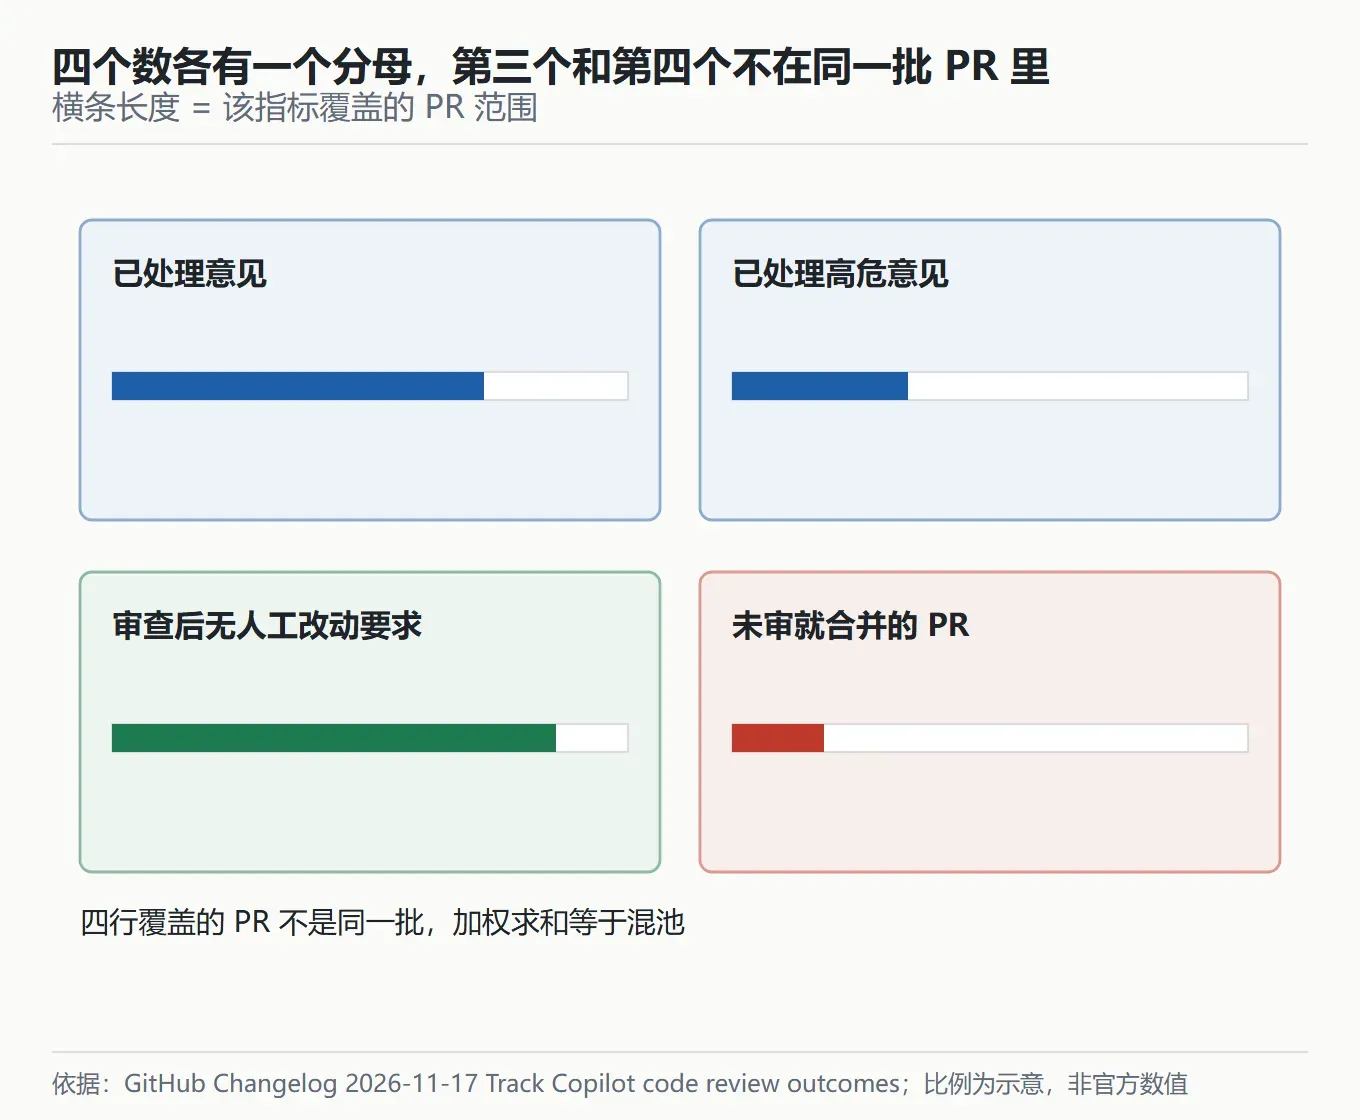
四个数不能合成一个分
第一个容易犯的错,是把这四个数揉成一个"审查质量分"。
它们量的不是同一件事:第一个和第二个量的是审查被采纳的程度,第三个量的是审查有没有拦住后续改动,第四个量的是审查覆盖率。三者之间不是加权关系,是并列关系。
尤其第三个和第四个。一个团队的"处理率"很高,同时"未经审查就合并的 PR"也很多——这不矛盾:前者只统计被审过的那些 PR 里的意见处理情况,后者统计的是根本没进统计范围的那部分。只看看处理率,会得出一个和事实相反的结论。
"已处理"这个词,被定义得很宽
现在来看最值得琢磨的一处设计。
按 GitHub 的说法,"已处理"指审查意见被处理过。而"处理"包括:应用建议、让 Copilot 去修、手动改代码,以及把修复推迟到后续的 PR。
四种做法都算"已处理",它们的分母是同一个。
这条规定在工程上很好理解——审查意见不一定要当场改完,尤其是和历史遗留相关的问题。但它也让这个指标的性质发生了变化:它度量的是"这条意见有没有被接收并被安排",而不是"这个风险有没有被消除"。
对一个测试团队来说,这个区别很实际。你可以用它回答"团队有没有在看这些意见",不能用它回答"这些意见指出的问题有没有被修掉"。
时间口径:两条不相交的账
第二处设计,藏在一句更靠后的话里。
旧版本的仓库 1-day 报表里,这个比例是拿"已处理意见总数 ÷ 已评估意见总数"算出来的。而按照第三方对 GitHub 计量口径的整理(非官方文档),这里有两个时间点需要注意:意见是在它所在的 PR 合并那天被计入的,不是 Copilot 发布它的那天;而 AI 额度是在审查运行的那一刻计费的。
这两件事放在一个月的窗口里,就会错开。
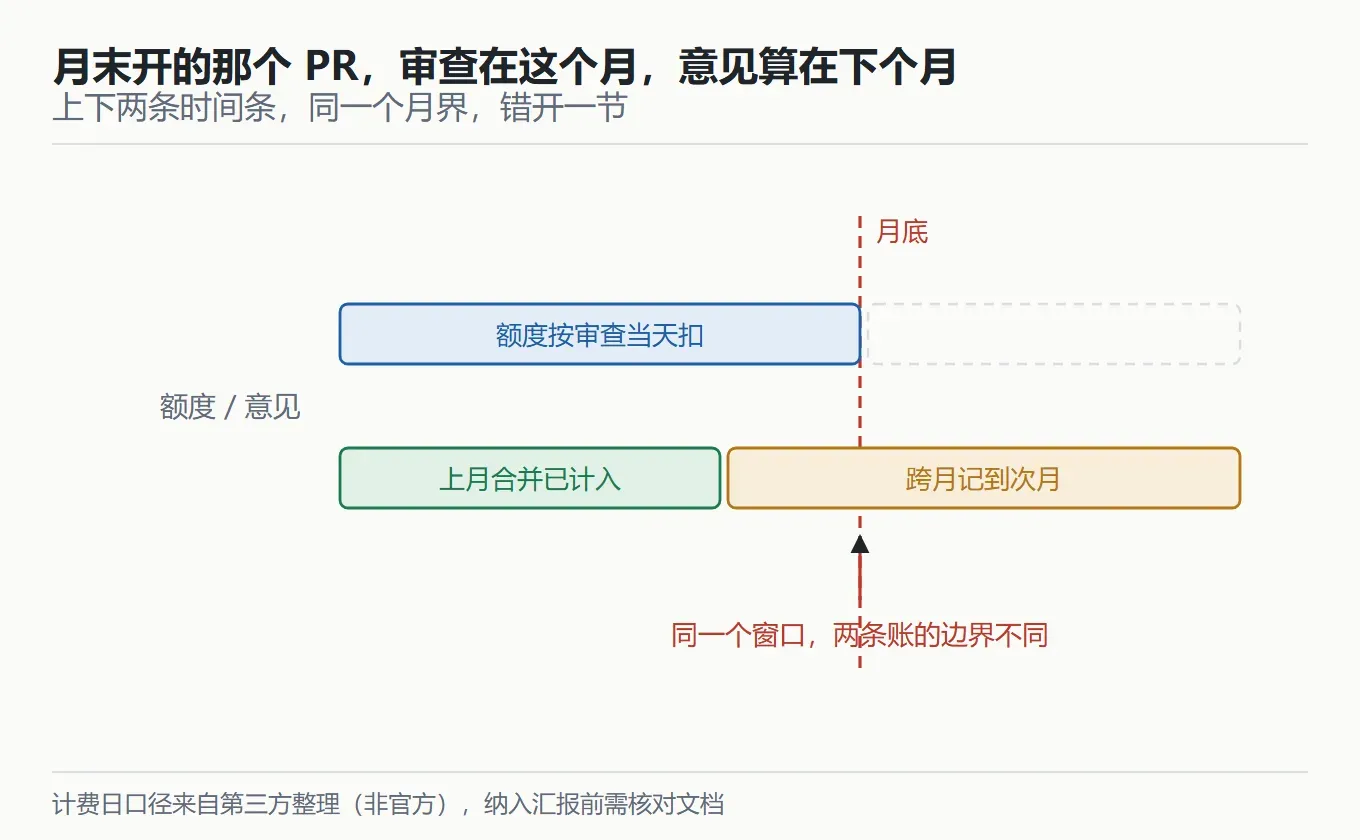
月末最后一周开的 PR,审查在当月发生、计费在当月,但意见要到次月合并时才计入统计。于是当月看到的"处理率",分母里少了一批最新的意见;次月的处理率里,又多了一批上个月的工作。
这个错位不是 bug,是"按合并计"这个口径的必然结果。但它会让两个动作失效:用单月处理率做团队考核,以及把处理率和当月额度账单对照看成本收益。对前者,至少要用季度窗口;对后者,要先明确自己问的是"每块钱买到多少条被采纳的意见"还是"每块钱买到多少次审查"。
我要标明一下来源:这段关于计费与计入时间点的说法,出自对 GitHub 2026 年 11 月额度报表变更的第三方分析,不是 GitHub Changelog 里的原话。用到团队汇报里之前,建议先去 repos-1-day 的实际字段和文档确认一遍。
还有一类意见,被明确排除在外
第三个口径问题在"可评估"这三个字上。
addressed rate 的分母不是"全部意见",是"可评估的意见"。GitHub 把"无法评估"的排除项单独列出来展示,但在这篇 Changelog 里没有展开判定标准。
这个设计是对的——有些意见确实无法判断有没有被处理(比如 PR 被关掉了、评论被删了、上下文变了)。但它意味着一个团队在处理率上看到的数字,取决于排除规则的具体边界。排除得越宽,比例看起来越好看。
所以要看的不是"处理率是多少",而是"排除项占比多少"。一个 85% 的处理率,配上 40% 的排除项,和 70% 的处理率配上 5% 的排除项,是两个完全不同的事实。
怎么拿它做门禁
这套指标的价值不在看板,在能不能变成门禁。我按可操作性排了三层。
第一层,只做暴露,不做阻断。 先把"未经 Copilot 审查就合并的 PR"列出来,按仓库排序。这个数不涉及任何口径争议,就是覆盖率。找出覆盖率低的那几个仓库,问一个很具体的问题:是没开审查,还是开了但被绕过(比如由 bot 提的 PR 没进评估)。
第二层,用比例做趋势,不用比例做考核。 处理率适合看方向(连续三个月在降),不适合做绝对目标。原因就是上面三处口径问题叠加之后,单月数值的可比性不够。
第三层,补一个 GitHub 没给的指标。 "已处理"里包含"推迟到后续 PR",那就要自己统计"被推迟的意见最终有没有真的被修掉"。做法很朴素:对每条被推迟的意见打一个标记,在后续 PR 里追踪它关联的问题单或行号。这个数不好看,但它和"风险有没有被消除"是同一件事。
一段必须说的边界
四个指标里,有一个是"审查后没有后续人工改动要求"。这个数看起来最像质量证明,但它和"审查做得好"之间不是充分关系。
一个 PR 没有收到后续的人工改动要求,可能是因为 Copilot 审得很到位,也可能是因为人工审查者本来就没时间细看、或者这个改动本来就不需要人工再提意见。这个指标需要和"这个仓库人工审查的强度"一起看才有意义。
第二,这些指标都建立在"Copilot 审查被使用了"的前提上。没被使用的部分不会进入统计,也不会拉低任何比例。
我的判断是:这套指标最该被表扬的地方,是它把分子、分母、排除项都摊开了——这比只给一个处理率诚实太多。一个测试团队做质量看板,最该学的也是这一点:任何一个比例,都要能同时回答"分子是什么""分母是什么""哪些被排除了"。答不上来的比例,早晚会在某次汇报里被人问住,而那一刻它就从资产变成了负债。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。