作者:深势科技周慧
科研任务往往需要检索文献与数据、调用专业工具、运行科学计算,并对结果进行分析和验证。与通用 Agent 不同,科研 Agent 不仅要给出答案,还要持续管理跨工具、跨环境的复杂执行过程,并保留足以支撑结论的依据。
围绕这一需求,我们将阿里云 AgentLoop 接入深势科技科研 Agent 的 Shrimp Runtime,对关键调用、耗时与 Trace 进行运行观测,并让这些信号与任务状态、外部作业、执行步骤和研究产物等业务记录协同。我们的目标不是用观测代替科学验证,而是让执行过程更容易被看见、异常更容易被定位,并为后续交付与迭代提供运行层依据。
01 为什么需要一套公共 Agent Infra
我们围绕 AI for Science 构建科研 Agent 产品与基础设施。
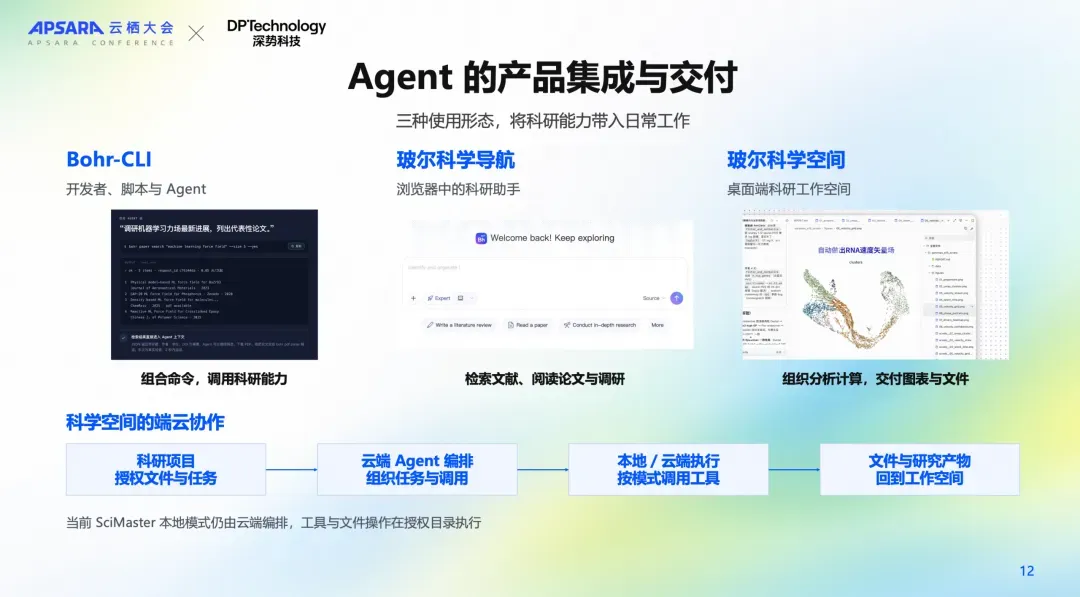
深势科技的科研 Agent 生态包括面向通用科研任务的 SciMaster,以及服务材料、生物等专业场景的 MatMaster、BioMaster 等应用,并通过玻尔科学导航、玻尔科学空间和 Bohr-CLI 等形态,将文献研究、数据处理、科学计算与结果交付融入科研人员的日常工作。
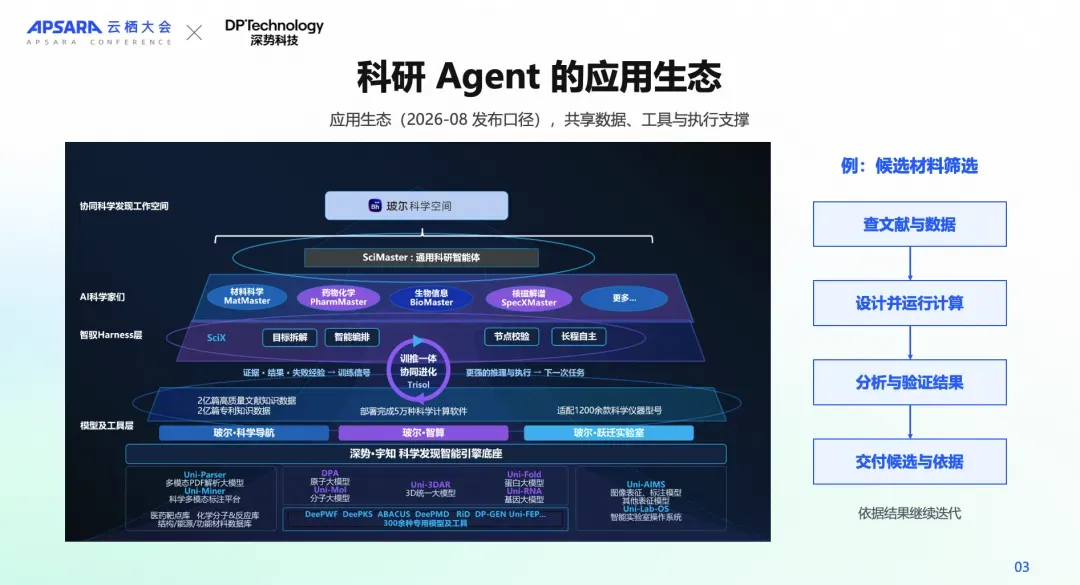
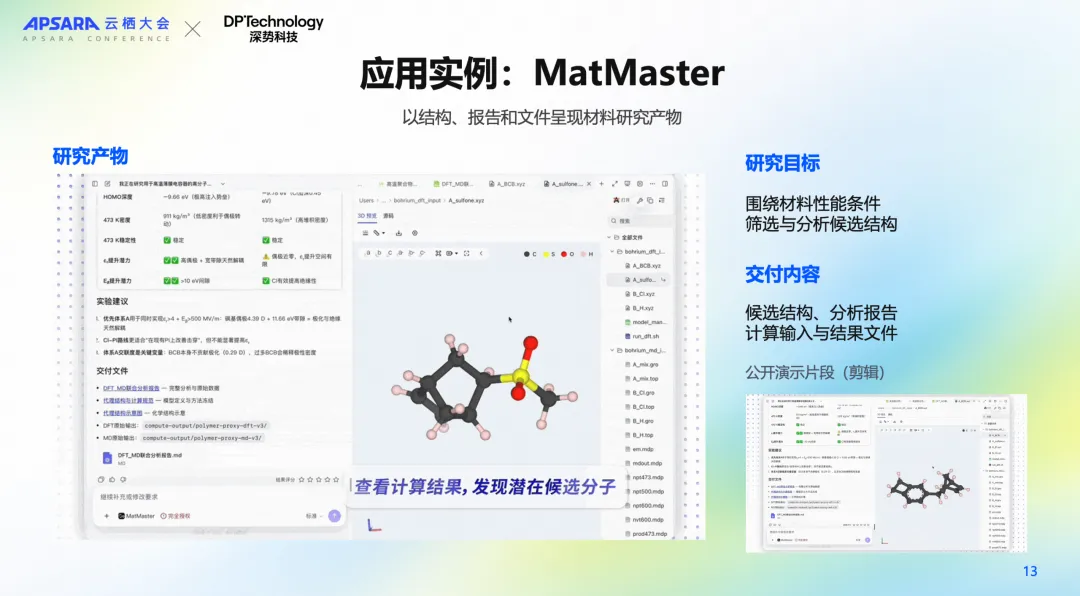
以候选材料筛选为例,通用流程包括检索文献与数据、设计并运行计算、分析与验证结果,最终交付候选及其依据;发现缺项时再继续查证。MatMaster 的公开演示则展示了候选结构、分析报告、计算输入与结果文件等交付形态,分别从过程和产物两方面呈现科研 Agent 的工作方式。
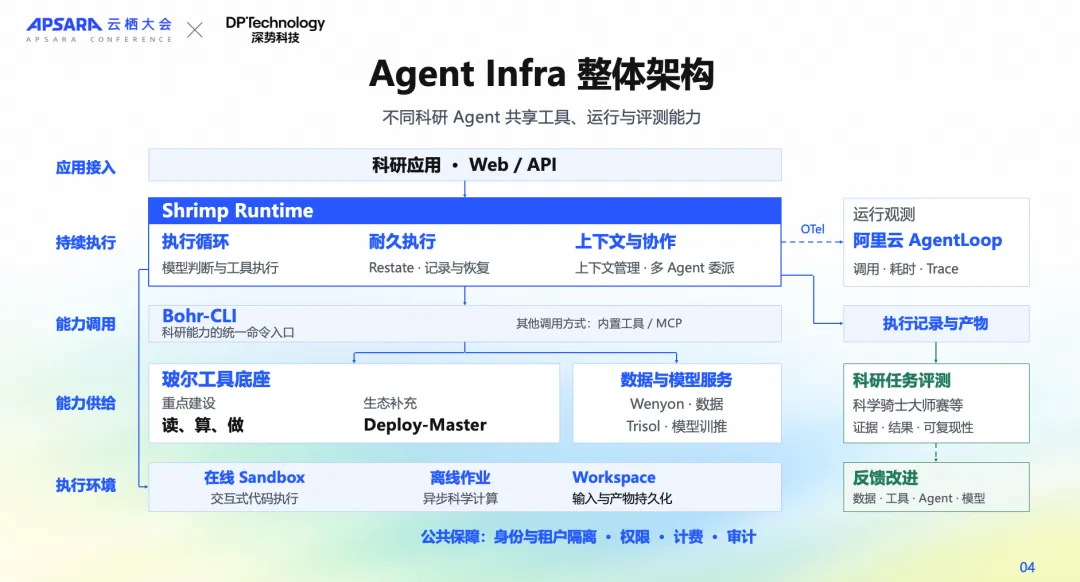
虽然领域方法各不相同,但工具调用、运行状态管理、长任务执行和证据留存,是这些科研 Agent 共同面对的基础设施问题。我们把不同领域 Agent 所需的公共能力沉淀为 Agent Infra。任务从科研应用、Web 或 API 进入后,由 Shrimp Runtime 组织模型判断、工具执行、上下文管理与持续运行;Bohr-CLI 为科研能力提供统一命令入口,Runtime 也可按需采用内置工具或 MCP。
02 Agent Infra 的演进挑战
▍科研 Agent 的运行问题,必须从“黑盒”中被定位
科研 Agent 在不同任务中可能调用文献解析、知识检索、建模仿真或实验数据分析等一种或多种能力。工具、参数、依赖环境和返回结果中的任何一环出现异常,都可能影响后续判断。如果缺少统一的运行观测,我们很难快速识别问题究竟发生在模型判断、工具调用,还是外部计算环境。
▍科学计算周期长,运行状态需要持续管理
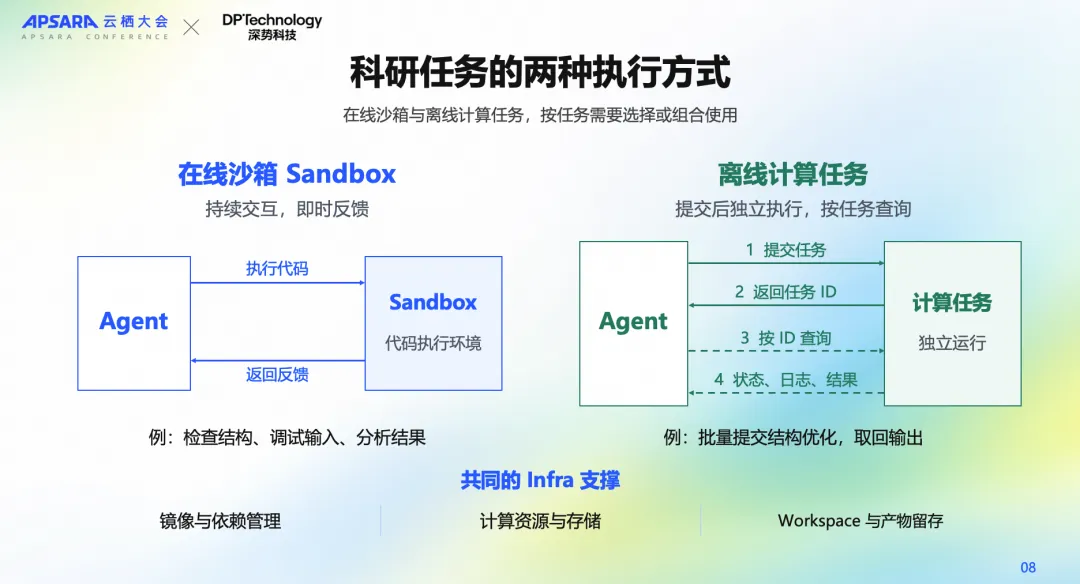
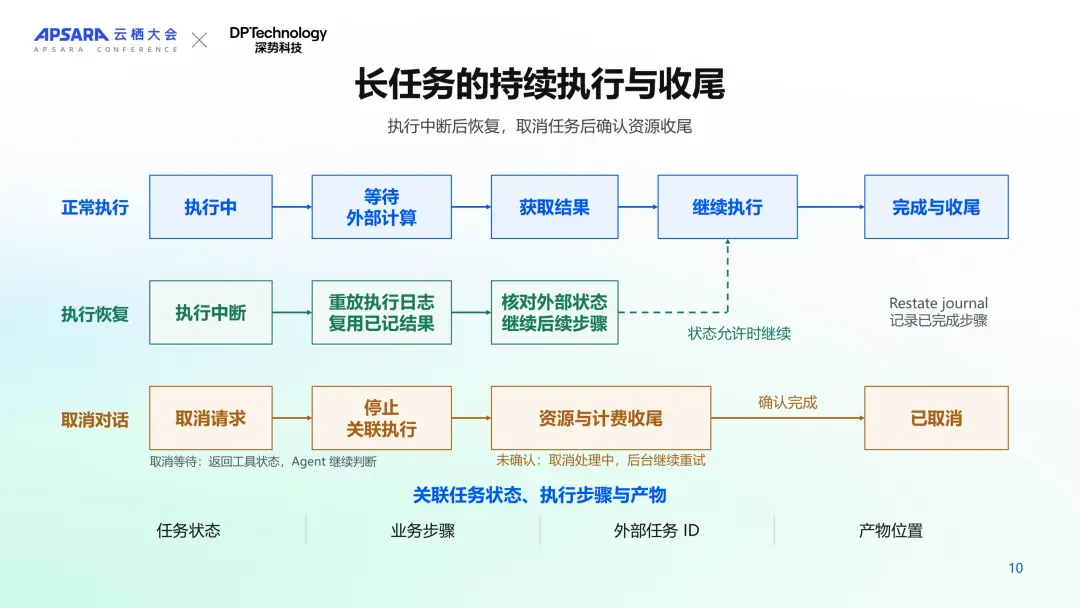
科研计算既包括需要即时反馈的在线代码执行,也包括提交后独立运行、按任务 ID 查询的离线作业。任务可能经历等待、服务中断、页面断线、恢复执行或取消收尾。对科研 Agent 而言,一次工具调用结束并不等于整项任务已经完成;外部作业状态、执行步骤和产物位置必须能够被持续核对。
▍“执行成功”不等于“科研结论可信”
科研任务对验证的要求远高于普通信息生成。命令能够运行,只能说明工具具备最小可执行性;计算是否满足数值误差与约束、最终交付物是否完成研究目标,还需要结合参数、日志、原始结果、评分项和失败反馈进一步判断。
03 Agent Infra 的落地经验
▍在既有 Agent Infra 中,接入运行观测
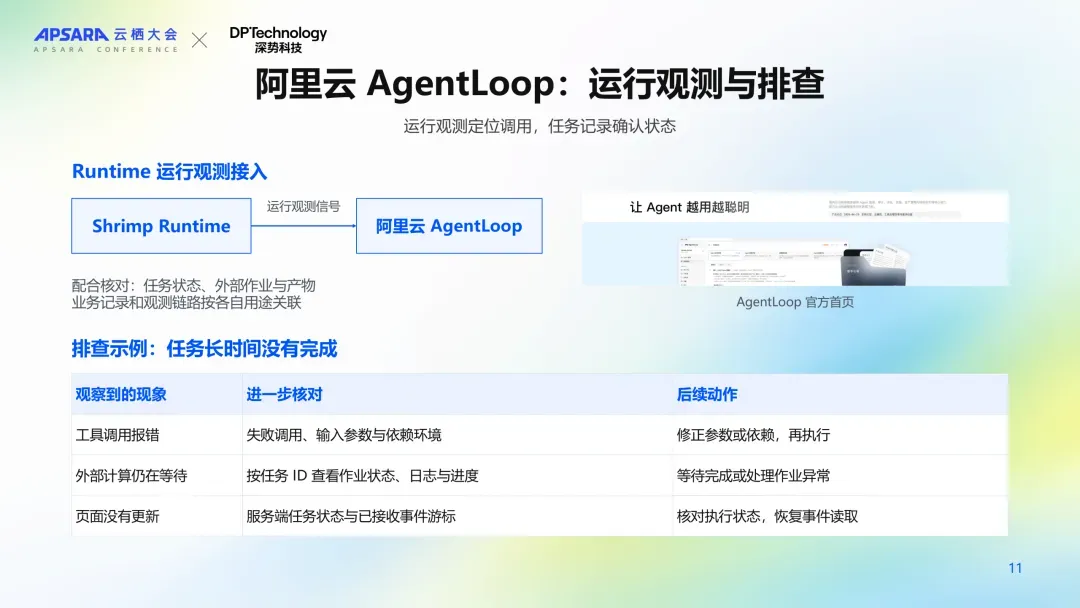
在上方这套架构中,阿里云的 AgentLoop 承担调用、耗时与 Trace 的运行观测。耐久执行、异步作业、Workspace 产物留存和科研评测,则分别由既有 Infra 的相关机制承担。团队可以先根据调用链路识别异常集中在哪一步,再结合业务任务、外部作业和产物记录确认实际状态,避免仅凭单次调用结果判断整项科研任务是否完成。
这种分工对科研场景尤其重要。运行观测回答“调用发生了什么、耗时多久、异常集中在哪里”;业务记录回答“任务和外部作业现在处于什么状态”;科学验证则回答“计算与交付物是否满足研究目标”。三者需要衔接,但不能互相替代。
在能力供给侧,文献解析、知识检索、科学计算和实验数据分析等“读、算、做”工具,与开放生态中的科研软件形成互补。在线 Sandbox 支持交互式执行和即时反馈,离线计算任务则适合长时间、批量运行;云端 Workspace 用于持久保存输入和研究产物,使文件不随临时执行环境释放而丢失。
▍接入 AgentLoop,让关键运行过程可观测
一次工具调用结束,并不等于整项科研任务完成。面对“任务长时间没有完成”,我们需要区分工具调用报错、外部计算仍在等待,还是页面没有继续更新。三种现象的核对路径并不相同,这也是我们接入 AgentLoop 的直接出发点。
针对典型现象,可采用三类排查路径:当工具调用报错时,进一步核对失败调用、输入参数和依赖环境;当外部计算长时间等待时,依据任务 ID 查看作业状态、日志与进度;当页面没有更新时,同时检查服务端任务状态与已接收的事件游标,区分任务仍在执行还是过程读取需要恢复。
提升关键运行过程的可观察性
AgentLoop 为关键调用链路提供运行观测,使研发人员能够看到任务在什么环节运行、哪里出现异常,并把调用信息与实际任务状态结合起来分析。面对工具报错、外部计算等待或前端过程未更新等不同现象,团队可以采用相应的核对路径,减少盲目排查。
为长任务状态核对与产物交付提供支撑
AgentLoop 的运行观测与深势科技既有的耐久执行、异步任务管理和 Workspace 产物留存机制协同,为跨工具、跨环境的长流程任务提供支撑。候选结构、分析报告、计算输入和结果文件等研究产物可以回到工作空间,形成可继续分析和交付的完整工作过程。
为基于证据的持续迭代提供依据
调用链路、执行步骤和研究产物共同构成问题分析的依据。团队可以按数据、工具、Agent 编排和模型等层次定位差距,再通过固定条件下的版本比较和回归测试验证改进效果,让科研 Agent 的优化从零散经验逐步转向可检查、可复现的工程过程。
对深势科技而言,Agent Infra 并不是单一工具或模型,而是一套支撑科研 Agent 持续执行、运行观测、结果验证和产品交付的公共底座。通过引入阿里云 AgentLoop,深势科技进一步完善了运行观测与排查能力,也为不同领域科研 Agent 复用基础设施、交付专业成果提供了更稳固的工程支撑。
▍面向长任务,完善恢复与收尾机制
科研任务经常需要等待外部计算返回。深势科技通过耐久执行机制记录已完成步骤,在服务中断后复用已有记录,并在继续执行前核对外部作业状态;页面断线后,则通过事件游标续读过程信息。对于取消操作,系统还需要停止关联执行并确认资源与计费收尾,再进入最终状态。
这套机制将任务状态、业务步骤、外部任务 ID 与产物位置关联起来,可用于核对长任务执行进展,并有助于降低重复执行和状态误判的风险。
04 Agent Infra 是基座,可交付才是业务目标
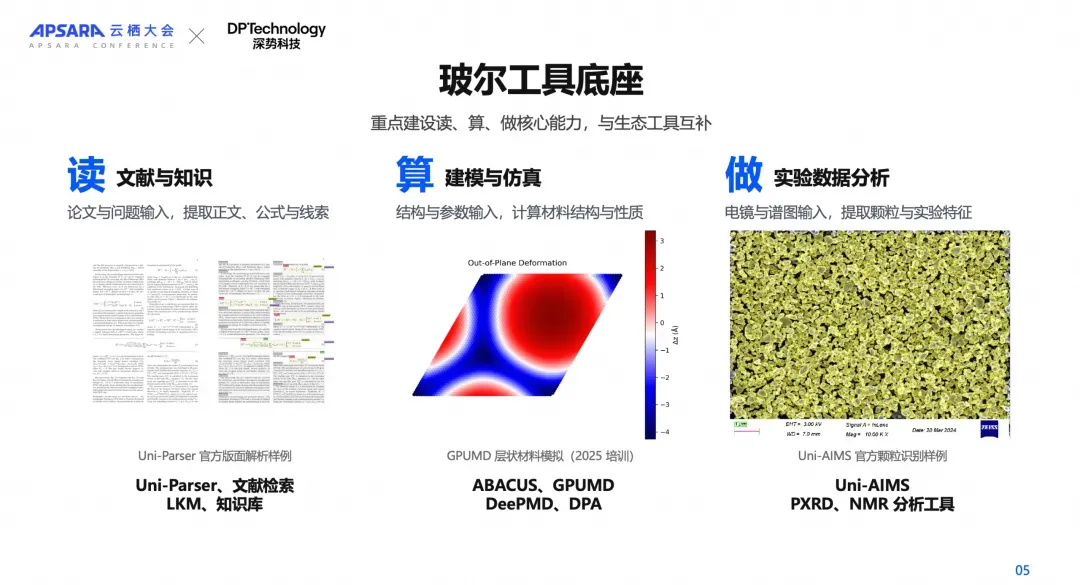
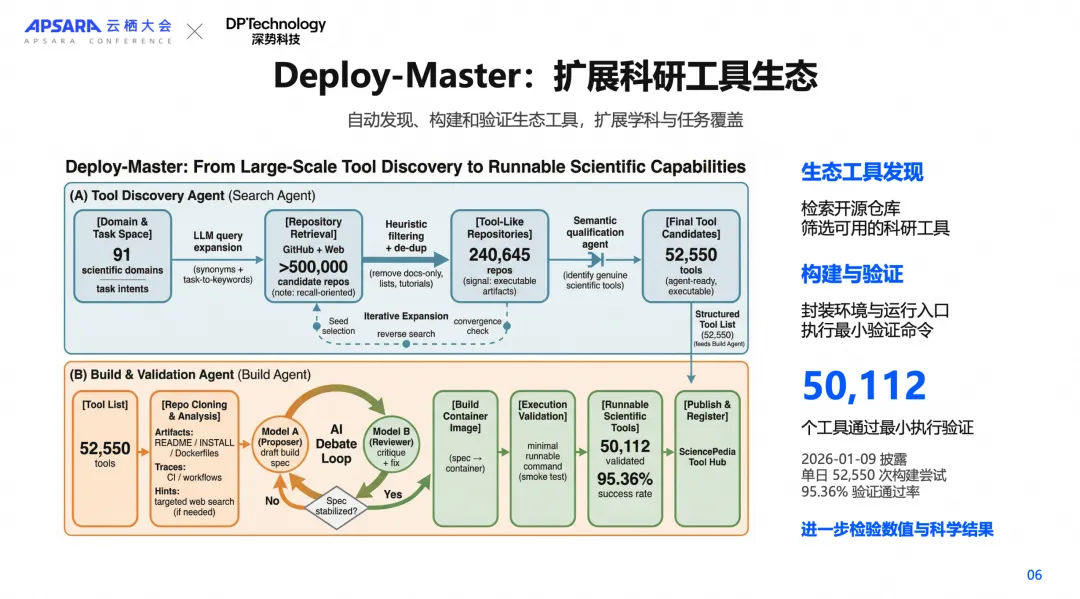
除了逐步夯实 Agent Infra,我们也在增强“玻尔工具底座”,来输出科研能力,可以概括为“读、算、做”,以及生态工具 Deploy-Master。
其中,“读”处理论文、公式与知识线索;“算”围绕结构和参数开展建模与仿真;“做”在当前阶段主要聚焦实验数据分析,如电镜颗粒识别和谱图分析。这些核心能力与开放生态中的科研工具互相补充。
Deploy-Master 作为生态工具,用于从开放生态中发现科研软件,构建运行环境、封装入口,并执行最小验证命令。2026年1月公开资料显示,在单日 52,550 次构建尝试中,有 50,112 个工具通过最小执行验证,通过率为 95.36%。这一数字说明的是当时实验条件下的最小可执行性,并不等于数值正确,也不等于科研任务已经完成。
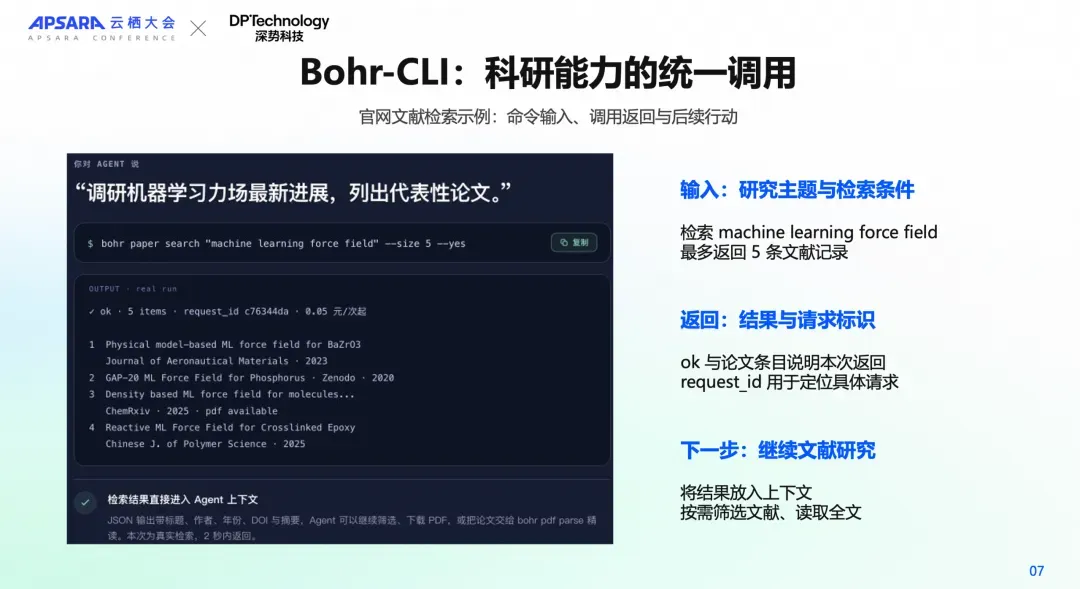
科研能力进入平台后,还需要清晰、一致的调用方式。Bohr-CLI 让开发者、脚本和 Agent 知道输入什么、返回什么,以及下一步可以采取什么行动。结构化结果和 request ID 也便于定位具体请求。统一命令入口不是唯一通道,Runtime 仍可以根据任务使用内置工具或 MCP。
这些公共能力最终通过不同产品形态进入科研工作。Bohr-CLI 面向开发者、脚本与 Agent;玻尔科学导航支持浏览器中的检索、论文阅读与调研;玻尔科学空间在桌面端组织项目、分析计算与结果文件。根据截至2026年9月15日核对的架构资料,SciMaster 本地模式仍由云端编排,工具和文件操作在用户授权目录中执行。
以 MatMaster 为例,其公开演示展示了候选结构、分析报告、计算输入和结果文件等交付形态。这些产物可以回到工作空间,形成可继续分析与交付的过程。公开动图约 9.3 秒的播放时长是剪辑效果,不代表实际计算耗时;画面说明的是交付方式,科研目标是否达成仍需进一步验证。
05 总结
对我们而言,Agent Infra 不是单一工具或模型,而是一套支撑科研 Agent 持续执行、运行观测、结果验证和产品交付的公共底座。通过引入阿里云 AgentLoop,我们进一步完善了运行观测与排查能力,也为不同领域科研 Agent 复用基础设施、交付专业成果提供了更稳固的工程支撑。