
前言:迁完之后,表"不存在"了
先说一个几乎每个从 MySQL 迁达梦的人都会踩的坑。
数据迁完,连上库,表也在,但你应用的 SQL 一跑就报:
第1行附近出现错误:
无效的表或视图名[SYS_USER]
你打开 DM 管理工具,表明明在,名字叫 sys_user,小写,一个字母不差。可 SQL 里写 select * from sys_user 就是不认。
原因不在数据,在标识符的大小写规则。
达梦(DM8)对标识符的处理规则是:
| 写法 | DM 的处理结果 |
|---|---|
select * from sys_user(不加引号) |
自动转成 SYS_USER 去匹配 |
select * from "sys_user"(加双引号) |
严格按 sys_user 匹配 |
建表时 create table sys_user(...) |
实际存成 SYS_USER |
建表时 create table "sys_user"(...) |
实际存成 sys_user |
也就是说:DM 实例默认是"大小写敏感"的(CASE_SENSITIVE=Y),不加引号的标识符一律折叠成大写。
而 MySQL 在 Linux 下默认 lower_case_table_names=0,表名原样存成小写。DTS 迁移时如果原样保留,就会建出 "sys_user" 这种带引号的小写对象。此时应用里不带引号的 sys_user 被折叠成 SYS_USER,和 "sys_user" 匹配不上 —— 于是"表不存在"。
结论只有一句话:要让应用 SQL 不加引号也能跑,迁移时就必须让对象名变成"不带引号的大写"。
下面这套流程,就是把这件事一次做对。
一、环境与迁移前准备
1.1 环境信息
| 项目 | 版本 |
|---|---|
| 源库 | MySQL 8.0.26(驱动 mysql-connector-java 8.0.x) |
| 目标库 | 达梦 DM8(JDBC 驱动 DmJdbcDriver18.jar) |
| 迁移工具 | 达梦数据迁移工具 DTS(DM 安装自带,Windows 版 DM数据迁移工具.exe) |
| 迁移规模 | 1 个库 → 1 个模式,41 张表 |
1.2 达梦侧:实例参数必须在建库前想清楚
这一步最容易被跳过,但它是后面所有麻烦的根源。DM 有两个参数建库后无法修改,只能重建实例:
| 参数 | 建议值 | 说明 |
|---|---|---|
CASE_SENSITIVE |
Y(默认,敏感) |
保持敏感 + 迁移时转大写,是与 MySQL 习惯最贴合的方案;设为 N 则完全不区分大小写,SQL 怎么写都能查到,但会失去精确控制 |
LENGTH_IN_CHAR |
1 |
强烈建议设为 1。设为 0(默认)时 VARCHAR(n) 的 n 是字节数;UTF-8 下一个汉字占 3 字节,VARCHAR(10) 只能存 3 个汉字,中文数据会被截断或报错 |
CHARSET |
1(UTF-8) |
对齐 MySQL 的 utf8mb4 |
PAGE_SIZE |
16 或 32 |
按数据量选,一般 16 够用 |
如果你用的是图形化 dbca.sh / DM 数据库配置助手,这两个选项在"初始化参数"页里就是勾选框,一定要在建实例那一步勾上。
这一条和第 1.1 节的"字符长度映射 1.0"是配套的:如果实例已经按字节算了,迁移时就得把映射系数调大(见 3.3)。
1.3 达梦侧:创建用户与模式
DM 中"用户"和"模式(Schema)"一一同名,一个用户默认拥有一个同名模式。建议先手工建好目标用户,不要让 DTS 自动建,避免权限和命名失控:
-- 用 SYSDBA 登录执行
CREATE USER "AV_CAPTURE_ADMIN" IDENTIFIED BY "Dm@12345678";
GRANT DBA TO "AV_CAPTURE_ADMIN";
命名建议:模式名尽量用下划线(
AV_CAPTURE_ADMIN),不要用中划线(AV-CAPTURE-ADMIN)。因为含-的标识符在 SQL 里必须加双引号才能用,否则被当成减号,select * from AV-CAPTURE-ADMIN.sys_user直接语法错误。这会给你后面的所有运维操作埋雷。本文示例沿用了图中的中划线写法,实际项目建议改掉。
1.4 MySQL 侧:迁移前的 4 项体检
别急着点迁移,先用这几条 SQL 把源库摸一遍。
① 找出 DM 不支持或不兼容的类型
SELECT TABLE_NAME, COLUMN_NAME, COLUMN_TYPE, DATA_TYPE, IS_NULLABLE, COLUMN_DEFAULT, EXTRA
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'av_capture_admin'
  AND DATA_TYPE IN ('enum','set','json','tinyint','mediumint','unsigned bigint','year')
ORDER BY TABLE_NAME, ORDINAL_POSITION;
重点关注 enum / set / json / unsigned —— 这几类 DM 没有等价类型,DTS 的默认映射往往会降级成 VARCHAR 或丢掉取值范围约束,需要人工确认。
② 扫一遍零日期(经典杀手)
MySQL 允许 0000-00-00 00:00:00,DM 直接拒绝写入。迁之前必须清掉:
-- 先用这个查出哪些表哪些字段有零日期
SELECT 'UPDATE `' || TABLE_NAME || '` SET `' || COLUMN_NAME || '` = NULL WHERE `' || COLUMN_NAME || '` = ''0000-00-00 00:00:00'';' AS fix_sql
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'av_capture_admin'
  AND DATA_TYPE IN ('datetime','timestamp')
  AND IS_NULLABLE = 'YES';
③ 确认字符集统一
SELECT TABLE_NAME, TABLE_COLLATION
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'av_capture_admin' AND TABLE_COLLATION NOT LIKE 'utf8mb4%';
④ 记录基线数量,迁移后要核对
SELECT TABLE_NAME, TABLE_ROWS
FROM information_schema.TABLES
WHERE TABLE_SCHEMA = 'av_capture_admin'
ORDER BY TABLE_NAME;
TABLE_ROWS是估算值,仅用于粗筛;精确值请用count(*)逐表统计,或迁移后按主键做max(id)比对。
二、DTS 迁移七步图解
打开 DM数据迁移工具,左上角新建迁移工程,选择 MySQL → DM,然后按下面的顺序走。
第 1 步:配置源库(MySQL)连接
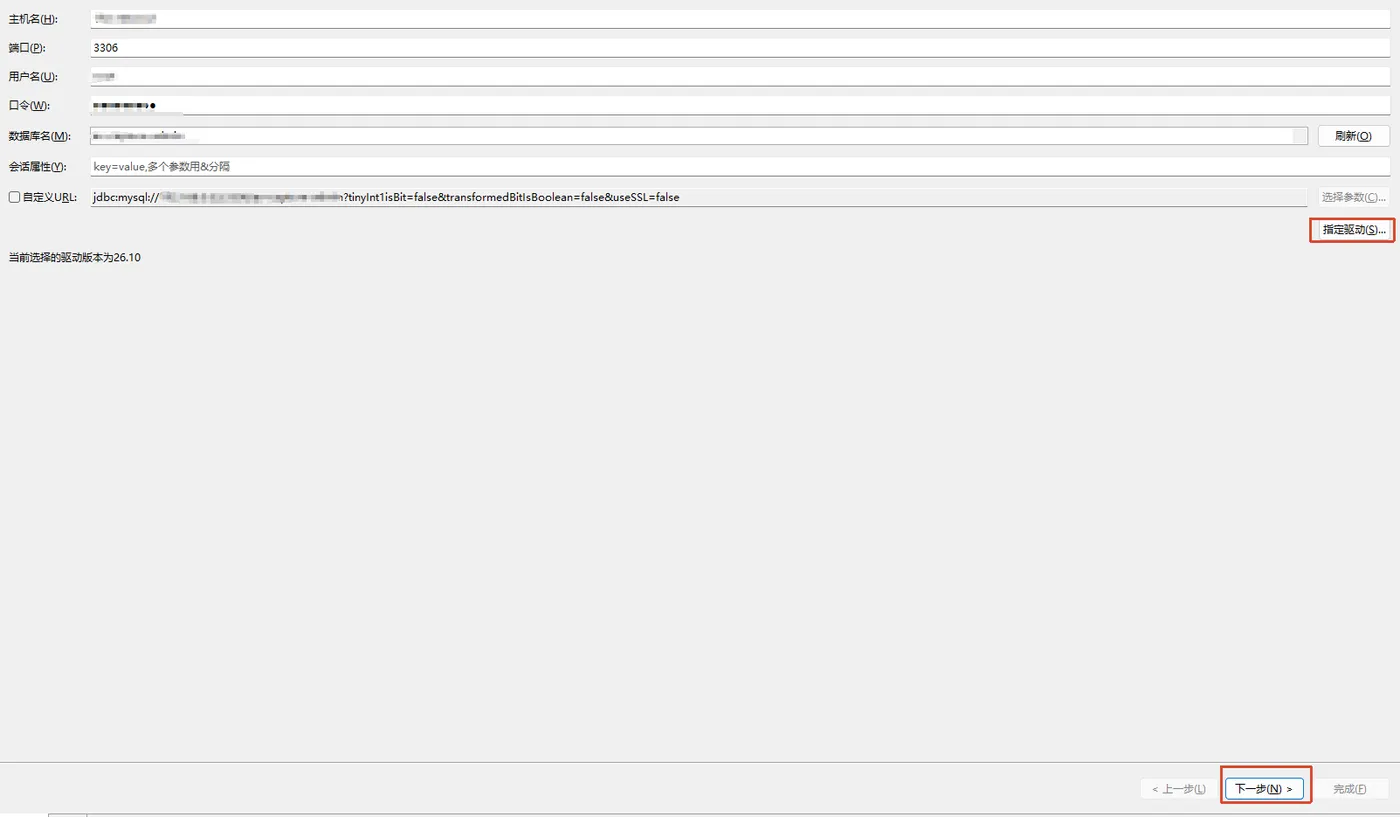
填写主机名、端口 3306、用户名、口令、数据库名即可。重点看下面那个自定义 URL,它决定了类型识别的准确度:
jdbc:mysql://192.168.32.10:3306/av_capture_admin?tinyInt1isBit=false&transformedBitIsBoolean=false&useSSL=false
三个参数的作用,以及建议补上的四个:
| 参数 | 作用 |
|---|---|
tinyInt1isBit=false |
让 tinyint(1) 不要被当成 Boolean 读出来。MySQL 里 tinyint(1) 常被用作状态位,如果映射成布尔,迁到 DM 会变成 BIT,应用里 status = 1 直接报错 |
transformedBitIsBoolean=false |
同理,禁止把 BIT 转成 Boolean |
useSSL=false |
内网迁移关掉 SSL,避免握手失败 |
allowPublicKeyRetrieval=true |
MySQL 8 建议加,否则 caching_sha2_password 认证会报 Public Key Retrieval is not allowed |
serverTimezone=Asia/Shanghai |
建议加,避免 datetime 迁移后整体偏移 8 小时 |
characterEncoding=utf8 |
建议加,防中文乱码 |
zeroDateTimeBehavior=convertToNull |
兜底:万一还有零日期,自动转 NULL 而不是中断迁移 |
如果你不确定驱动版本,点「指定驱动」手工指定本机的 mysql-connector-java-8.0.xx.jar。图中当前驱动版本为 26.10(即 8.0.26),与源库一致,最好保持匹配。
第 2 步:配置目的库(DM)连接

| 字段 | 填写 |
|---|---|
| 主机名 | localhost(或 DM 服务器 IP) |
| 端口 | 5236(DM 默认端口) |
| 验证方式 | 达梦服务器验证 |
| 用户名 | SYSDBA(先用高权限账号,避免建表建约束时权限不足) |
| 自定义 URL | jdbc:dm://localhost:5236 |
同样点「指定驱动」确认指向 DM 安装目录下的 DmJdbcDriver18.jar(一般在 DM8/drivers/jdbc/)。
第 3 步:迁移选项 —— 全文最关键的一个勾
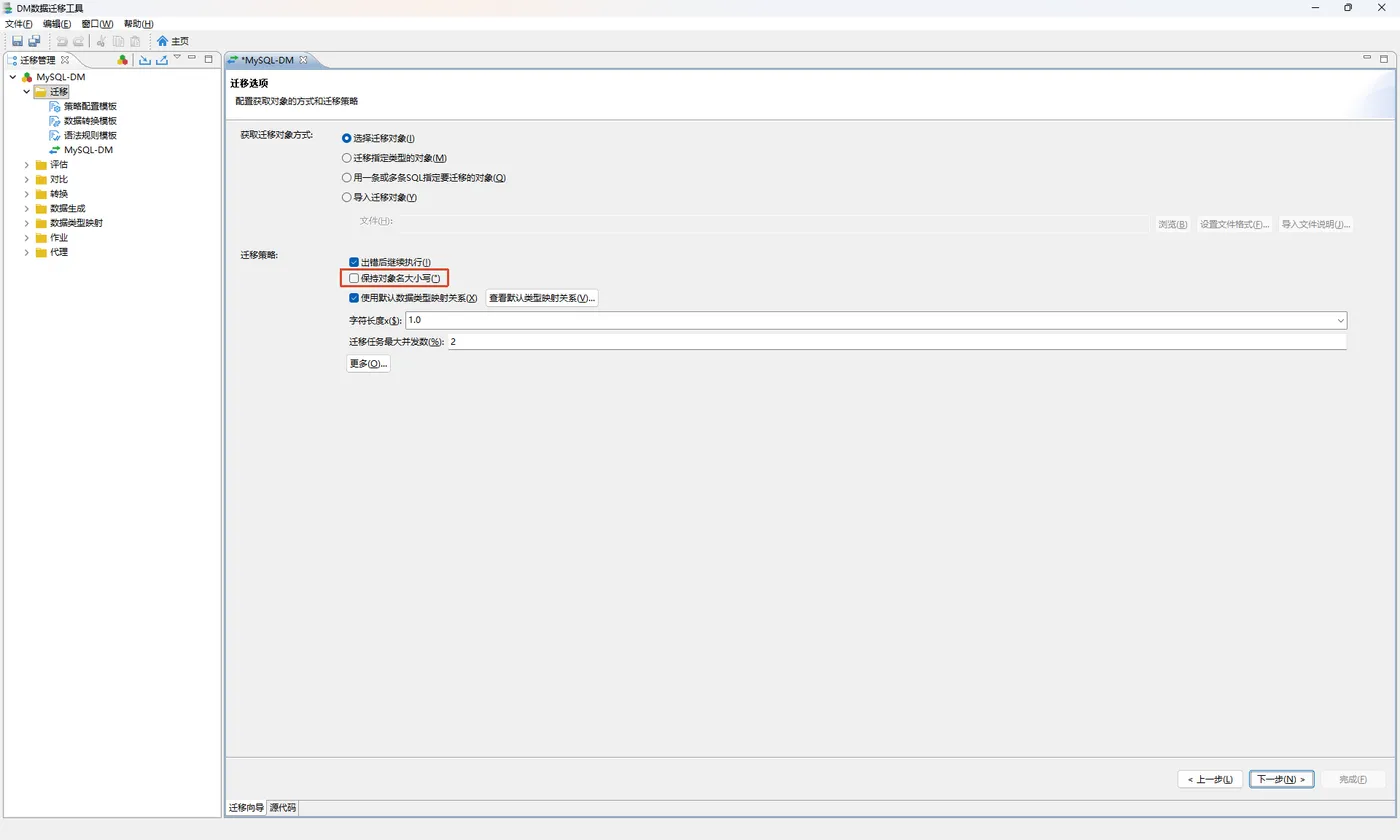
「获取迁移对象方式」选 选择迁移对象。
然后是「迁移策略」,这里有三个选项,请照着设:
| 选项 | 设置 | 原因 |
|---|---|---|
| 出错后继续执行 | ✅ 勾选 | 41 张表批量迁,个别表失败不至于中断全部;失败项会在日志里单独列出,事后补迁 |
| 保留对象名大小写 | ❌ 不勾(默认) | 这就是"转大写"的开关。不勾 → DTS 把源端小写对象名统一转成大写、并去掉引号,落库为 SYS_USER 这种形式;勾上 → 原样保留小写并加引号,落库为 "sys_user",应用 SQL 全废 |
| 使用默认数据类型映射关系 | ✅ 勾选 | 走 DM 内置映射表;如有个别类型要改,点「查看默认类型映射关系」后单独调整 |
再往下两个数值:
- 字符长度映射:图中是
1.0。这个系数的含义是"目标字符串长度 = 源长度 × 系数"。- 若 DM 实例
LENGTH_IN_CHAR=1(按字符计数)→ 保持1.0即可; - 若 DM 实例是默认的按字节计数,而你的业务有中文 → 请改成
3.0,否则varchar(50)只能装 16 个汉字,迁完就是一堆"字符串截断"。
- 若 DM 实例
- 迁移任务最大并发数:
2。表多、机器好的话可以调到 4~8,能明显加速;但并发过高时约束依赖(外键)容易报错,建议先小后大。
第 4 步:指定源模式与目的模式
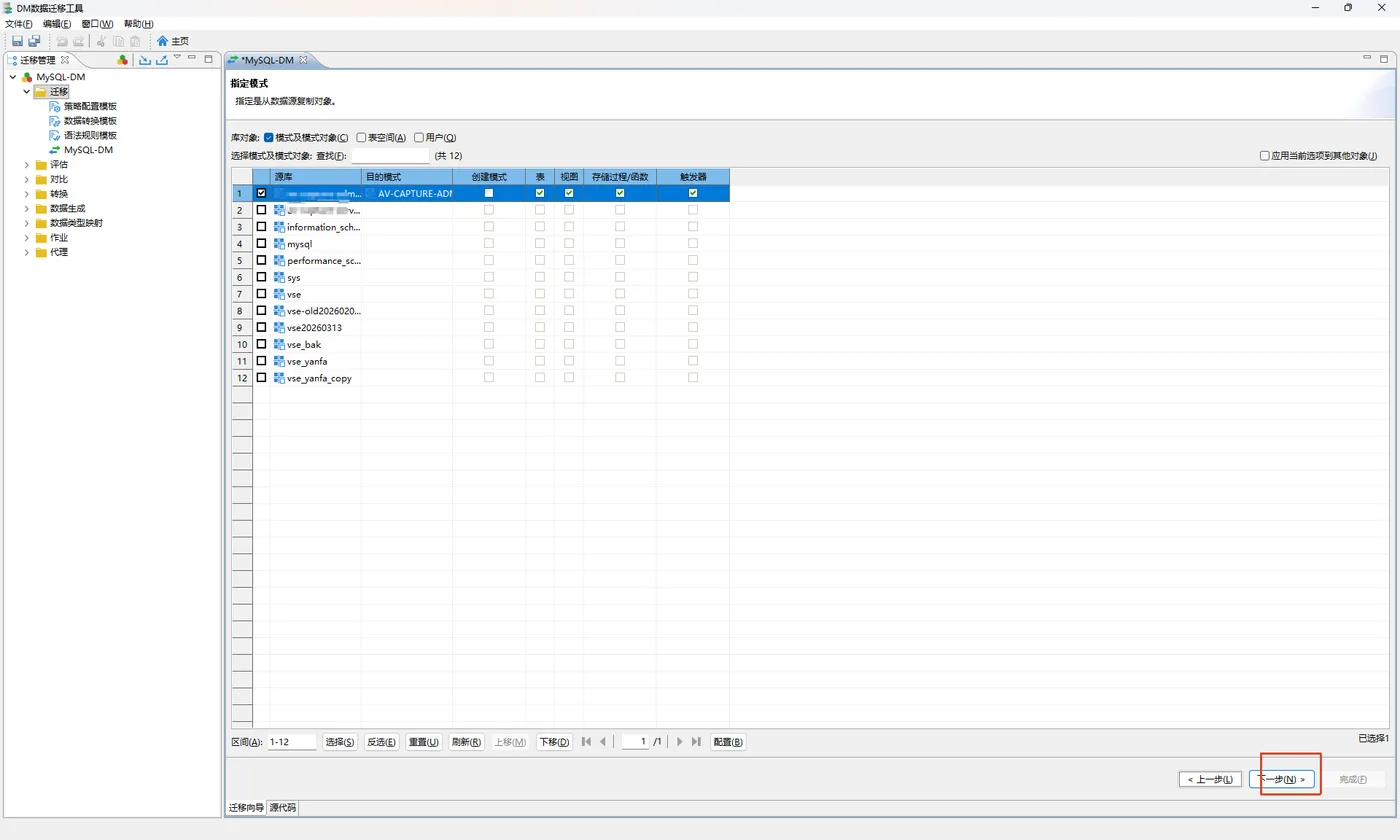
左边勾选要迁移的源模式(图中 av-capture-admin,该实例下有 12 个库,只勾这一个),右边会列出对应的目的模式。
两个注意点:
- 目的模式会跟着"转大写"一起变形。因为没勾"保留对象名大小写",目的模式名也会被写成
AV-CAPTURE-ADMIN(大写)。所以 1.3 里用CREATE USER "AV_CAPTURE_ADMIN"建出来的用户,模式名对不上,DTS 会自动再建一个模式,导致你手工建的用不上。要么目的模式名字手工改成你建好的那个,要么干脆让 DTS 建、后面再授权。 - 模式名带中划线的话,所有 SQL 都得加双引号,参考 1.3 的建议尽早改掉。
第 5 步:指定迁移对象
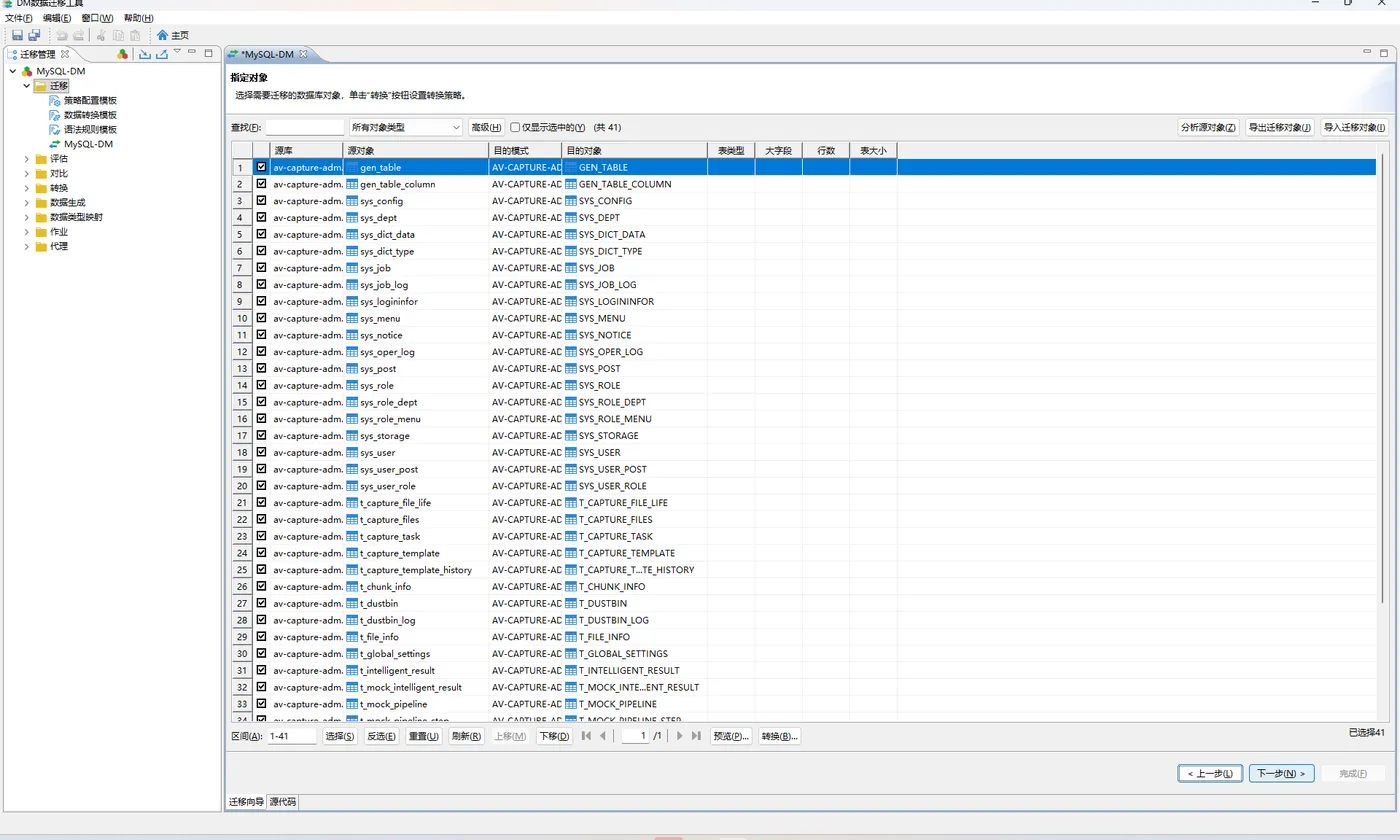
切到「所有对象类型」,逐个勾选表、视图、序列等。图中源模式有 41 张表,可以点「全选」。
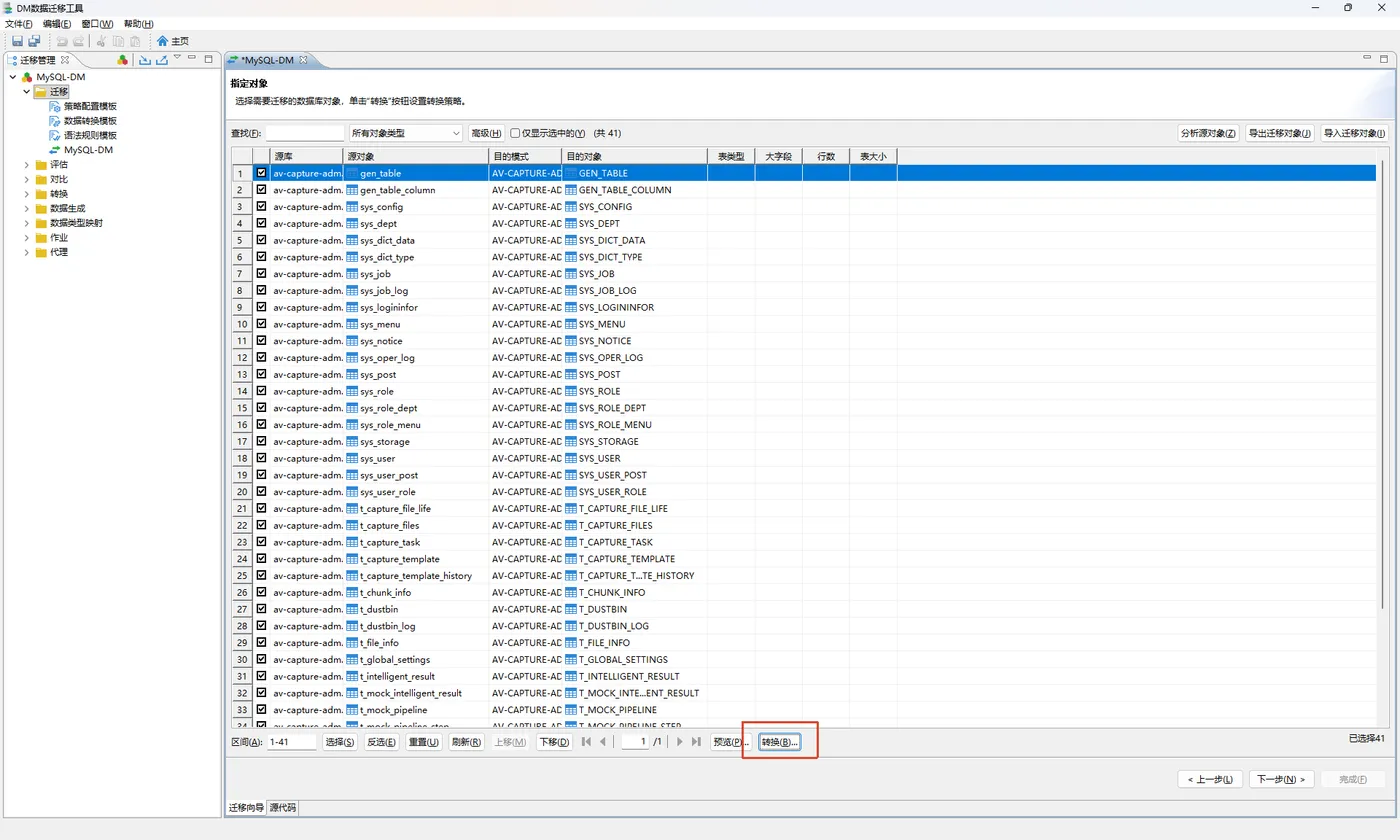
勾完确认右下角计数是 41。建议第一轮先只勾 2~3 张结构简单、有代表性的表试迁,跑通了再全量 —— 全量失败后清理现场(删模式重建)比重迁一次还费时间。
第 6 步:转换对象(设置数据转换规则)
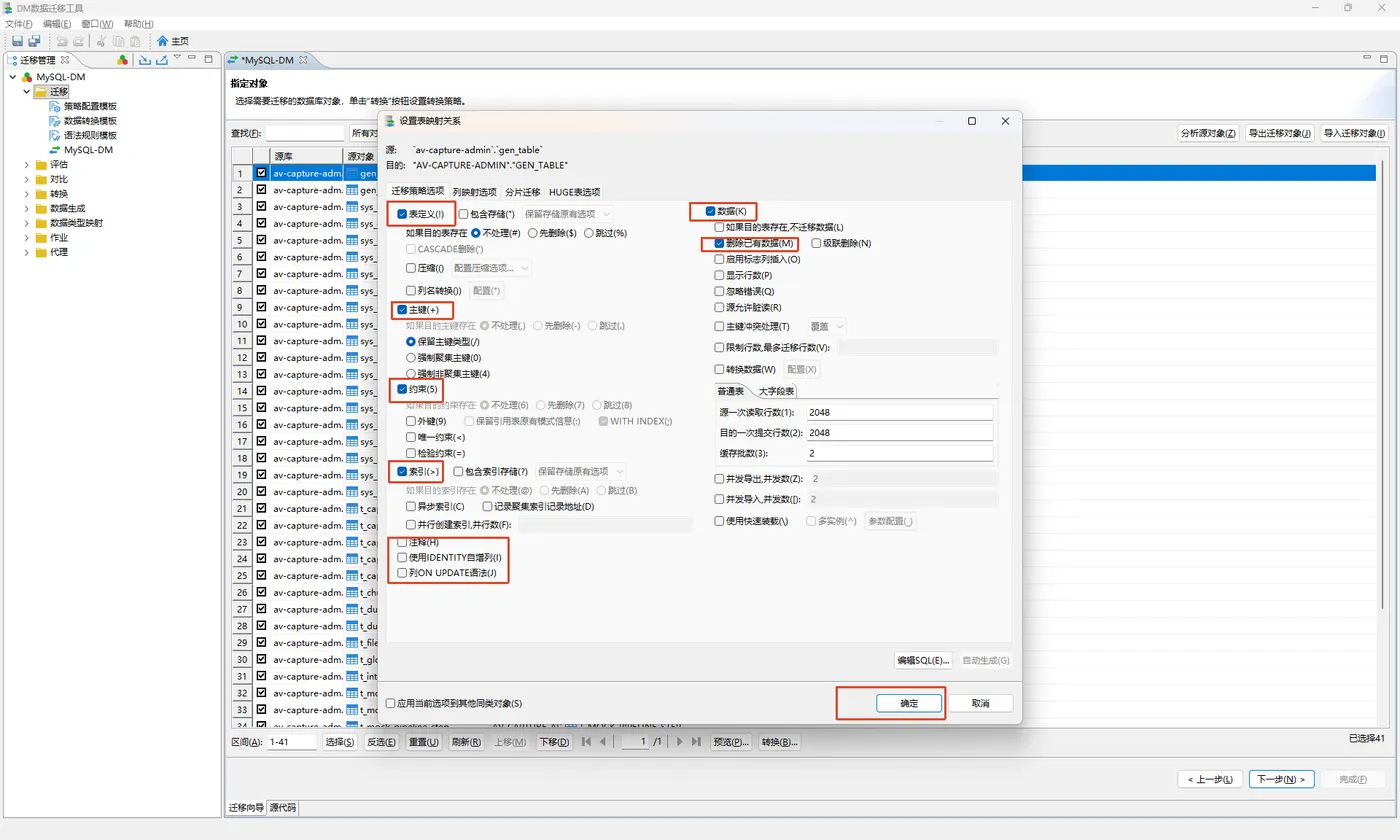
这一步决定"迁过去长什么样"。选中任意一张表点「转换」,弹出的对话框里逐项配置:
左侧分组
| 分组 | 建议 | 说明 |
|---|---|---|
| 表定义 | ✅ 勾选 | 展开后含:包含主键、包含约束、保留自增列属性、包含列注释 |
| └ 如果对象已存在 | 先删除表 | 重迁时最省心,避免"表已存在"批量失败 |
| └ 级联删除(CASCADE) | ✅ 勾选 | 有外键依赖时,删除顺序不会被卡住 |
| 数据 | ✅ 勾选 | 迁移表数据 |
| └ 如果数据已存在 | 先删除 | 防止重迁造成数据重复 |
| └ 保留主键约束 | ⚠️ 谨慎 | 数据量大时取消勾选,先迁数据再统一建主键/索引,速度能快几倍。但要注意自增列冲突,见第五节 |
| 视图 | ✅ 勾选 | DM 支持视图迁移,但 MySQL 特有函数(IFNULL、DATE_FORMAT)需迁移后改写 |
| 索引 | ✅ 勾选 | 含唯一索引、普通索引、前缀索引 |
| 约束 | ✅ 勾选 | 外键、唯一约束、CHECK |
| 触发器 / 存储过程 | 视情况 | MySQL 触发器语法与 DM 差异较大,多数场景建议不迁,迁移后按 DM 语法重写 |
| 使用 IDENTITY 自增列 | ✅ 勾选 | 把 AUTO_INCREMENT 转成 DM 的 IDENTITY(1,1),必勾 |
| ON UPDATE 触发器 | ❌ 不勾 | MySQL 的 ON UPDATE CURRENT_TIMESTAMP 在 DM 里没有原生对应,勾了会额外生成触发器,容易和业务触发器打架。改为应用层赋值或用 DEFAULT + 触发器手工实现 |
右侧「数据」分组的读写参数(每次读取行数 2048、每次插入行数 2048、合并行数 3)一般保持默认。数据量大、网络好的话,可以开启「快速加载」(多实例/批量),提速明显。
第 7 步:审阅 —— 在这里验证大写是否生效
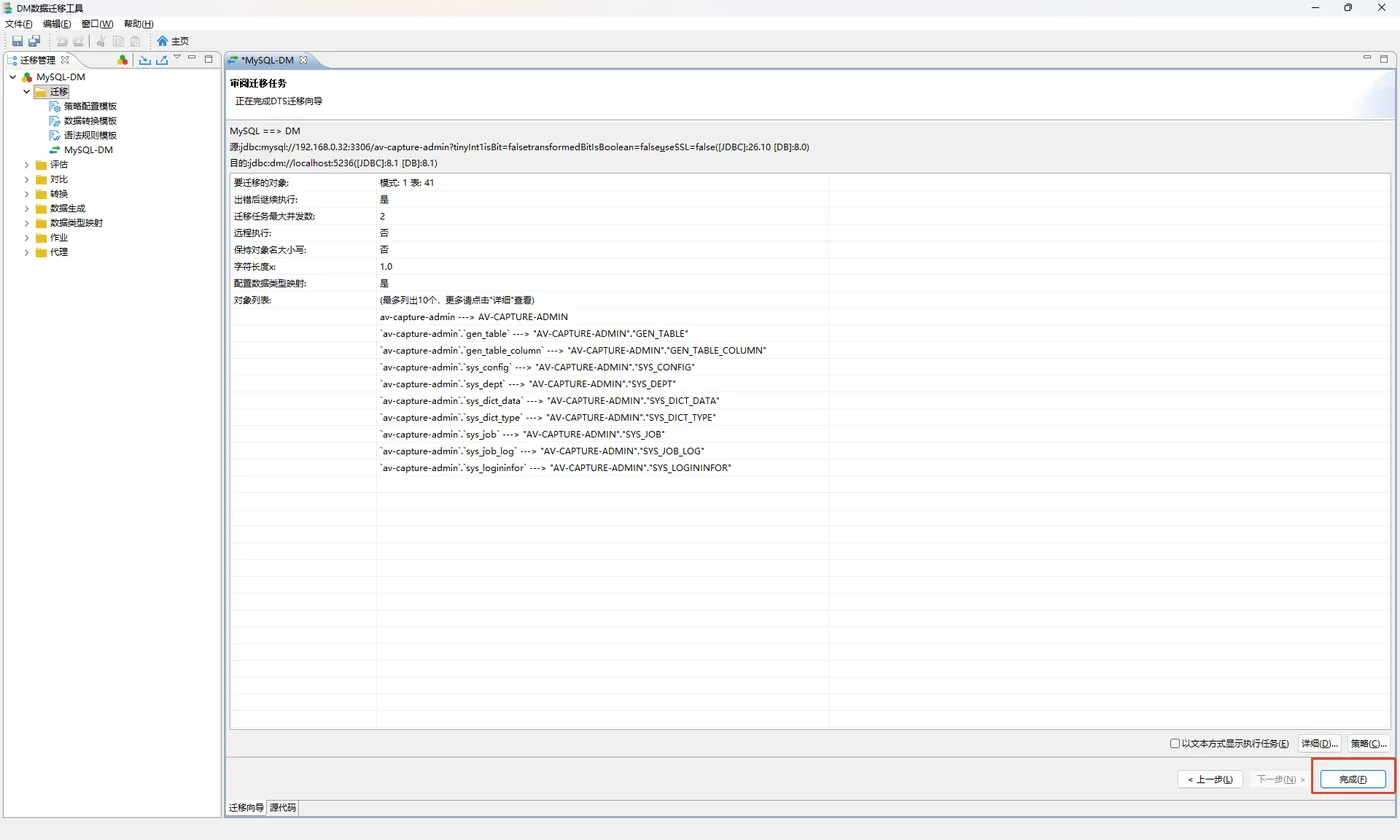
这一步是全文的"验收点",务必逐行看对象列表。
图中可以看到,任务摘要已经如实反映:
出错后继续执行:  是
迁移任务最大并发数:2
保留对象名大小写:  否          ← 关键
字符长度映射:     1.0
使用默认数据类型映射:是
而下面的对象映射列表,正是我们想要的结果:
av-capture-admin.gen_table          --> "AV-CAPTURE-ADMIN"."GEN_TABLE"
av-capture-admin.gen_table_column   --> "AV-CAPTURE-ADMIN"."GEN_TABLE_COLUMN"
av-capture-admin.sys_config         --> "AV-CAPTURE-ADMIN"."SYS_CONFIG"
av-capture-admin.sys_dict_data      --> "AV-CAPTURE-ADMIN"."SYS_DICT_DATA"
...
判断标准:箭头右侧是不是全大写。只要是大写,应用里不加引号的 select * from sys_config 就能正确命中;如果右侧是 "gen_table" 这种小写带引号的,说明第 3 步的勾没取消,回去重来。
确认无误 → 点「完成」开始执行 → 看日志。中途失败的表会被记下来但不中断,跑完后按提示补迁即可。
三、迁移后立刻做的 6 项验证
别急着改代码,先把库验一遍。
① 对象名是不是真的大写
-- 期望:全部为大写
SELECT OWNER, TABLE_NAME FROM DBA_TABLES
WHERE OWNER = 'AV-CAPTURE-ADMIN'
ORDER BY TABLE_NAME;

-- 如果有小写的,会在这条里出现
SELECT TABLE_NAME FROM DBA_TABLES
WHERE OWNER = 'AV-CAPTURE-ADMIN' AND TABLE_NAME <> UPPER(TABLE_NAME);
② 对象数量对齐
SELECT COUNT(*) FROM DBA_TABLES  WHERE OWNER = 'AV-CAPTURE-ADMIN';
SELECT COUNT(*) FROM DBA_VIEWS   WHERE OWNER = 'AV-CAPTURE-ADMIN';
SELECT COUNT(*) FROM DBA_INDEXES WHERE OWNER = 'AV-CAPTURE-ADMIN';
③ 行数逐表比对(用主键列比 max(id) 最快,比 count(*) 省时间)
-- 在 DM 侧执行,和 MySQL 侧 max(id) 对照
SELECT 'SELECT ''' || TABLE_NAME || ''' T, COUNT(*) C FROM "' || OWNER || '"."' || TABLE_NAME || '" UNION ALL'
FROM DBA_TABLES WHERE OWNER = 'AV-CAPTURE-ADMIN' AND TABLE_NAME = 'SYS_USER';
④ 中文有没有被截断
-- 建库时 LENGTH_IN_CHAR=0 的,这里会暴露问题
SELECT TABLE_NAME, COLUMN_NAME, DATA_LENGTH, CHAR_LENGTH, CHAR_USED
FROM DBA_TAB_COLUMNS
WHERE OWNER = 'AV-CAPTURE-ADMIN' AND CHAR_USED = 'B';   -- B=字节, C=字符
CHAR_USED = 'B' 表示按字节计长。如果业务有中文且已被截断,只能重建实例(LENGTH_IN_CHAR=1)后重迁 —— 这也是为什么 1.2 强调"建库前想清楚"。
⑤ 自增列是否可用
INSERT INTO "AV-CAPTURE-ADMIN"."SYS_CONFIG"(CONFIG_NAME) VALUES('__test__');
SELECT MAX(CONFIG_ID) FROM "AV-CAPTURE-ADMIN"."SYS_CONFIG";
-- 确认新插入的 ID 大于迁移数据的最大 ID,否则删掉测试数据并重置 IDENTITY 种子
⑥ 注释在不在
SELECT TABLE_NAME, COMMENTS FROM DBA_TAB_COMMENTS WHERE OWNER = 'AV-CAPTURE-ADMIN' AND ROWNUM <= 10;
SELECT TABLE_NAME, COLUMN_NAME, COMMENTS FROM DBA_COL_COMMENTS WHERE OWNER = 'AV-CAPTURE-ADMIN' AND ROWNUM <= 20;
四、如果已经迁错了:把对象名批量转大写
假设当初勾了"保留对象名大小写",现在库里全是 "gen_table" 这种小写对象,两条补救路线:
方案 A:重建实例,用不敏感模式(最彻底)
如果还在测试阶段,最快的是删掉模式重来,或者重装实例时把 CASE_SENSITIVE 设为 N。大小写不敏感后,sys_user / SYS_USER / Sys_User 都能命中同一个对象,MySQL 应用几乎零改动。
代价是:失去了对同名不同大小写对象的区分能力(实际项目基本不需要),且实例必须重建。
方案 B:用 DM 动态 SQL 批量重命名(不重建实例)
思路:从数据字典里把"名字不是大写"的对象捞出来,生成 ALTER ... RENAME 脚本,人工 review 后执行。顺序很关键:先表 → 再列 → 再索引 → 最后序列,否则会因依赖关系报错。
第一步:生成重命名表的语句
SELECT 'ALTER TABLE "' || OWNER || '"."' || TABLE_NAME
       || '" RENAME TO "' || UPPER(TABLE_NAME) || '";' AS DDL
FROM DBA_TABLES
WHERE OWNER = 'AV-CAPTURE-ADMIN'
  AND TABLE_NAME <> UPPER(TABLE_NAME);
第二步:生成重命名列的语句
SELECT 'ALTER TABLE "' || OWNER || '"."' || TABLE_NAME
       || '" RENAME COLUMN "' || COLUMN_NAME || '" TO "' || UPPER(COLUMN_NAME) || '";' AS DDL
FROM DBA_TAB_COLUMNS
WHERE OWNER = 'AV-CAPTURE-ADMIN'
  AND COLUMN_NAME <> UPPER(COLUMN_NAME)
ORDER BY TABLE_NAME, COLUMN_ID;
第三步:生成重命名索引的语句
SELECT 'ALTER INDEX "' || OWNER || '"."' || INDEX_NAME
       || '" RENAME TO "' || UPPER(INDEX_NAME) || '";' AS DDL
FROM DBA_INDEXES
WHERE OWNER = 'AV-CAPTURE-ADMIN'
  AND INDEX_NAME <> UPPER(INDEX_NAME);
第四步:生成重命名序列的语句(用了 IDENTITY 或其他序列的话)
SELECT 'ALTER SEQUENCE "' || SEQUENCE_OWNER || '"."' || SEQUENCE_NAME
       || '" RENAME TO "' || UPPER(SEQUENCE_NAME) || '";' AS DDL
FROM DBA_SEQUENCES
WHERE SEQUENCE_OWNER = 'AV-CAPTURE-ADMIN'
  AND SEQUENCE_NAME <> UPPER(SEQUENCE_NAME);
把四段输出复制到一个 .sql 文件里,先备份库(dexp 逻辑导出整个模式),再按 表→列→索引→序列 的顺序执行。
提示:如果你的 DM 版本报
RENAME COLUMN语法不支持,改用ALTER TABLE "S"."T" ALTER COLUMN "a" RENAME TO "A";,或者直接在 DM 管理工具里右键对象重命名(适合少量表)。约束名无法直接重命名,一般也不影响业务,忽略即可。
方案 C:应用层加双引号(不推荐)
理论上可以在所有 SQL 里把 sys_user 改成 "sys_user"。实际上这是灾难:MyBatis 的 @Select、JPA 的自动建表、分页插件、动态表名全都要改,改完还绑死了"必须小写"这个前提。只在极少数无法重迁的应急场景考虑。
五、应用侧适配清单(12 类高频差异)
大写的坑填平了,还有一批语法和类型差异在等着。按出现频率排序:
1. 驱动与连接串
# 旧(MySQL)
spring.datasource.url=jdbc:mysql://127.0.0.1:3306/av_capture_admin?useSSL=false&serverTimezone=Asia/Shanghai
spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver

# 新(DM8)
spring.datasource.url=jdbc:dm://127.0.0.1:5236?schema=AV_CAPTURE_ADMIN
spring.datasource.driver-class-name=dm.jdbc.driver.DmDriver
依赖换成:
<dependency>
    <groupId>com.dameng</groupId>
    <artifactId>DmJdbcDriver18</artifactId>
    <version>8.1.3.140</version>
</dependency>
schema=参数建议显式指定,避免因用户默认模式不一致导致的"表找不到"。注意这里填的是大小写敏感环境下真实的模式名,和你迁移后的模式保持一致。
2. 反引号 ` 必须处理
MySQL 用反引号包标识符,DM 用双引号(或不要引号)。若代码里有:
select `name`, `status` from `sys_user`
DM 里会报语法错误(把 ` 当非法字符)。批量替换成无引号形式(前提是对象名已大写且不是关键字),或统一换成双引号。
3. 关键字冲突
MySQL 里能直接当列名的,DM 里可能是保留字。常见踩雷列名:
TYPE LEVEL SIZE COMMENT VALUE STATUS ORDER GROUP USER PASSWORD PATH ROLE KEY
处理方式二选一:加双引号(代码全部要改),或迁移时把列名改成 USER_TYPE、ORDER_NO 之类(推荐,一次性解决)。
4. 函数映射
| MySQL | 达梦 |
|---|---|
IFNULL(a,b) |
NVL(a,b)(DM 也兼容 IFNULL) |
NOW() / SYSDATE() |
SYSDATE / NOW() |
DATE_FORMAT(d,'%Y-%m-%d') |
TO_CHAR(d,'YYYY-MM-DD') |
STR_TO_DATE(s,'%Y-%m-%d') |
TO_DATE(s,'YYYY-MM-DD') |
GROUP_CONCAT(x) |
WM_CONCAT(x) / LISTAGG(x,',') |
SUBSTRING_INDEX |
SUBSTR + INSTR 组合 |
LIMIT 10 OFFSET 20 |
LIMIT 10 OFFSET 20(DM 兼容模式支持)或 ROWNUM / OFFSET ... FETCH |
ON DUPLICATE KEY UPDATE |
MERGE INTO |
INSERT IGNORE |
先查后插,或 MERGE INTO |
5. 自增列
AUTO_INCREMENT → IDENTITY(1,1)。取刚插入的自增 ID:
-- MySQL
SELECT LAST_INSERT_ID();
-- DM
SELECT IDENT_CURRENT('SYS_USER');   -- 或使用 SCOPE_IDENTITY() / JDBC getGeneratedKeys
MyBatis 的 useGeneratedKeys="true" keyProperty="id" 在 DM 下通常可直接用,但建议实测;不行就显式 SELECT IDENT_CURRENT(...)。
6. 类型映射速查
| MySQL | 达梦 | 注意 |
|---|---|---|
tinyint(1) |
TINYINT |
一定要配 tinyInt1isBit=false,否则变成 BIT |
int unsigned |
INT / BIGINT |
DM 无 unsigned,要评估上限,必要时升 BIGINT |
bigint unsigned |
BIGINT / DECIMAL(20) |
同上 |
varchar(n) |
VARCHAR(n) |
见 LENGTH_IN_CHAR 说明 |
text |
TEXT / CLOB |
大文本建议 CLOB |
blob / longblob |
BLOB / IMAGE |
图片流注意驱动 |
datetime |
TIMESTAMP |
检查时区,见第 1 步 serverTimezone |
decimal(m,n) |
DECIMAL(m,n) |
一致 |
enum('a','b') |
VARCHAR(n) + CHECK |
需手工转换,DTS 一般降级为 VARCHAR |
set('a','b') |
VARCHAR(n) |
同上 |
json |
TEXT / CLOB |
DM8 对 JSON 支持有限,应用侧做序列化 |
year |
SMALLINT |
少见 |
7. ON UPDATE CURRENT_TIMESTAMP
DM 没有这个语法。三个替代方案:
- 应用层统一在
update时赋值(最推荐,逻辑透明); - 建
BEFORE UPDATE触发器; - 表中保留字段,由 MyBatis 拦截器填充。
8. 分页
LIMIT ?,? 在 DM 的 MySQL 兼容模式下可用。如果报错,改写成:
SELECT * FROM (
    SELECT t.*, ROWNUM rn FROM (原始SQL) t WHERE ROWNUM <= 20
) WHERE rn > 10;
或者用 PageHelper 的 helperDialect=dm。
9. 事务与隔离级别
DM 默认隔离级别是读提交(READ COMMITTED),与 MySQL InnoDB 默认的可重复读(REPEATABLE READ)不同。如果业务依赖"同一事务内多次读结果一致",需要显式设置:
SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
10. 视图与存储过程
MySQL 视图里的 IFNULL、DATE_FORMAT、LIMIT,以及存储过程的 DECLARE ... CURSOR、DELIMITER 语法,都无法直接迁。建议视图手工重写(数量通常不多),存储过程按 DM 的 PL/SQL 语法重构。
11. GROUP BY 严格模式
MySQL 8 默认开启 ONLY_FULL_GROUP_BY,DM 行为类似但报错信息不同。若原来靠"宽松模式"跑的非标准 GROUP BY,迁过去会直接失败 —— 这其实是好事,顺手把 SQL 写规范。
12. 大小写混用(再次提醒)
即使对象名已大写,如果代码里有用双引号包小写标识符的地方,同样会失效。全局搜一遍代码里的 " 包裹的 SQL 标识符,统一清理。
六、报错速查表
| 报错信息 | 原因 | 解决 |
|---|---|---|
无效的表或视图名[XXX] |
对象名大小写不匹配 | 检查第 3 步是否取消了"保留对象名大小写";或按第四节补救 |
无效的列名[XXX] |
列名未转大写 | 同上,用 DBA_TAB_COLUMNS 核对 |
字符串截断 |
VARCHAR 按字节计长,中文超长 |
实例 LENGTH_IN_CHAR=1,或迁移时字符长度映射调 3.0 |
Public Key Retrieval is not allowed |
MySQL 8 认证插件 | URL 加 allowPublicKeyRetrieval=true |
无法解析的日期/时间 |
零日期 0000-00-00 |
迁前 UPDATE 成 NULL,或加 zeroDateTimeBehavior=convertToNull |
语法分析出错 在反引号位置 |
` 不支持 |
反引号换双引号或去掉 |
第N行附近出现错误: 无效的列名[type] |
关键字冲突 | 列名加双引号或改名 |
违反唯一性约束 |
重迁时数据重复 | 转换对象里勾"数据存在时先删除" |
表已存在 |
重迁未清理 | 勾"如果对象已存在→先删除表"+"级联删除" |
| 中文乱码 | 字符集不一致 | 实例 CHARSET=1,URL 加 characterEncoding=utf8 |
| 自增 ID 冲突 | IDENTITY 种子未对齐 | 迁完数据后 SET IDENTITY_INSERT 或重建 IDENTITY 起点 |
| 时间差 8 小时 | 时区未指定 | URL 加 serverTimezone=Asia/Shanghai,或迁后统一校正 |
七、一张图看懂决策路径
迁移前
  │
  ├─ DM 实例已建? ──否──> 建实例时设 CASE_SENSITIVE / LENGTH_IN_CHAR / CHARSET
  │                         (建后不可改,务必想清楚)
  └─ 是
        │
        ├─ 目标:MySQL 应用尽量不改?
        │     ├─ 是 → 迁移时【不勾】"保留对象名大小写" → 对象全大写
        │     │       (推荐,与默认敏感实例匹配)
        │     └─ 否 → 实例 CASE_SENSITIVE=N,怎么写都能查到
        │
        ├─ 是否需要重迁?
        │     ├─ 是 → 第四节方案 B,批量 RENAME(先备份)
        │     └─ 否 → 进入验证
        │
        └─ 验证六项 → 应用改造(驱动/反引号/函数/自增/事务)
结语
回看这次迁移,真正花时间的不是 DTS 那七步点击 —— 工具本身足够成熟,图形化流程也很顺。真正消耗时间的是两类事:
第一类是"不可逆的初始化决策"。 CASE_SENSITIVE、LENGTH_IN_CHAR、CHARSET 这三个参数在实例建好那一刻就定型了。LENGTH_IN_CHAR 判断错的代价是中文数据批量截断,只能推倒重来。
第二类是"沉默的语义漂移"。 迁移工具按部就班地跑完,日志一路绿色,但 tinyint(1) 悄悄变成了 BIT,ON UPDATE CURRENT_TIMESTAMP 悄悄消失了,自增种子悄悄没对齐 —— 这些都不会在迁移时报错,只会在上线第三天以"数据莫名其妙不对"的形式暴露出来。
所以那份"迁移前体检 + 迁移后验证"的清单,比任何一个操作步骤都值钱。工具能帮你搬数据,搬不了语义。
最后留一句话给正在准备迁移的同学:先在测试环境把 41 张表完整跑两遍,第二遍故意勾错"保留对象名大小写"看它怎么坏 —— 见过它怎么坏,你才知道该怎么防。
