一、问题从哪来
前段时间做 GEO 相关的内容可见性监测,需要批量比对一批 AI 回答,遇到一个当时没想通的现象。
两句话,人读起来意思基本一致:
A: HTTP 状态码 429 代表请求过多,服务端做了限流,建议退避后重试。
B: HTTP 429 表示请求过于频繁,服务器已限流,应等待一段时间再重试。
用字符 3-gram 的 Jaccard 系数算,得分 0.0755。
一开始我以为是模型输出不稳定,换了几个采样角度重跑,分数依旧这个量级。后来才反应过来:问题不在模型,在度量本身。是这把尺子量不了这个长度。
于是把这类指标单独拎出来测一遍——不掺模型、不涉及任何外部服务,纯本地跑,把 n 从 1 调到 3,看这把尺子到底在哪一档准。
二、同一套表示,三种打分
三种指标共用一套文本表示:先归一化(转小写、去掉标点和空白),再切成字符 n-gram。区别只在怎么打分。
Jaccard:两个 n-gram 集合的交集除以并集。只看“有没有”,不看“出现几次”。
J(A, B) = |A ∩ B| / |A ∪ B|
Dice:同样是集合运算,但分母是两个集合大小之和,比并集小,所以对短文本更宽松。
D(A, B) = 2|A ∩ B| / (|A| + |B|)
TF-IDF 余弦:把 n-gram 当词项,用文内频次做 TF,用全部语料算 IDF,再求向量夹角余弦。它同时看“有没有”“多不多”“稀不稀有”。
三者里,Jaccard 和 Dice 是纯集合运算,TF-IDF 引入了频次和全局权重。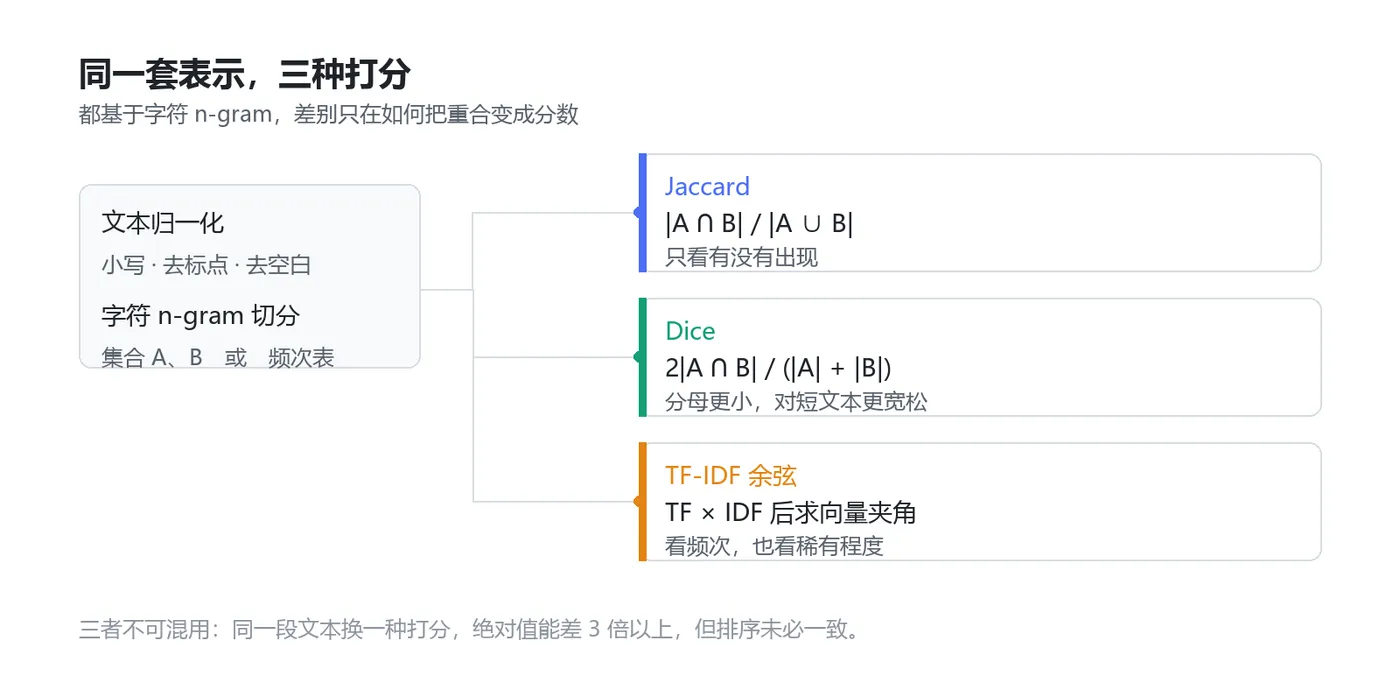
三、代码
纯标准库,不需要 numpy,也不需要分词器。
import math, re
from collections import Counter

def norm(text):
    """转小写,去掉标点与空白,只保留中英文和数字"""
    return re.sub(r"[^\u4e00-\u9fffa-z0-9]+", "", text.lower())

def ngram_list(text, n):
    """返回字符 n-gram 列表,保留重复(TF 需要频次)"""
    s = norm(text)
    if len(s) < n:
        return [s] if s else []
    return [s[i:i + n] for i in range(len(s) - n + 1)]

def jaccard(a, b, n):
    A, B = set(ngram_list(a, n)), set(ngram_list(b, n))
    if not A or not B:
        return 0.0
    return len(A & B) / len(A | B)

def dice(a, b, n):
    A, B = set(ngram_list(a, n)), set(ngram_list(b, n))
    if not A or not B:
        return 0.0
    return 2 * len(A & B) / (len(A) + len(B))

def build_idf(pairs, n):
    """用全部句子作语料计算 IDF"""
    docs = []
    for _, a, b in pairs:
        docs.append(set(ngram_list(a, n)))
        docs.append(set(ngram_list(b, n)))
    df = Counter()
    for d in docs:
        df.update(d)
    total = len(docs)
    return {
   t: math.log((1 + total) / (1 + c)) + 1.0 for t, c in df.items()}

def cosine(a, b, n, idf):
    def vec(text):
        grams = ngram_list(text, n)
        if not grams:
            return {
   }
        tf = Counter(grams)
        total = len(grams)
        return {
   t: (c / total) * idf.get(t, 1.0) for t, c in tf.items()}

    va, vb = vec(a), vec(b)
    if not va or not vb:
        return 0.0
    dot = sum(v * vb.get(k, 0.0) for k, v in va.items())
    na = math.sqrt(sum(v * v for v in va.values()))
    nb = math.sqrt(sum(v * v for v in vb.values()))
    return dot / (na * nb) if na and nb else 0.0
三个函数都不长,关键在于先把归一化规则定死。全角半角、英文大小写、标点处理方式只要不一致,后面所有分数都不可比。
运行方式
不需要安装任何依赖,标准库直接跑:
python sim_metrics.py
数据集就是一个三元组列表,第一项是分组标签,后两项是待比较的文本:
PAIRS = [
    ("same", "服务器返回 429 表示请求过多", "HTTP 状态码 429 意味着客户端发送请求过于频繁"),
    ("diff", "服务器的限流策略需要按业务调整", "他昨天在超市买了两斤苹果"),
    ("copy", "深圳夏季的湿度常年偏高", "深圳夏季的湿度常年偏高"),
]
脚本会按 n=1、2、3 各算一遍三种指标,输出汇总表。实际运行的开头几行是:
文本对总数: 28

| n | 指标 | copy | same | partial | diff | 区分度 | 可分性 |
| --- | --- | --- | --- | --- | --- | --- | --- |
| 1 | Jaccard | 1.0000 | 0.4032 | 0.1581 | 0.0204 | 0.3828 | 0.1102 |
| 1 | Dice | 1.0000 | 0.5514 | 0.2701 | 0.0384 | 0.5130 | 0.1705 |
copy 组一列全部为 1.0000,这是实现正确性的自检——如果这里有任何一个不是 1,说明归一化或切分逻辑写错了,后面的数据都不用看。
四、数据集与判据
数据集由我手工构造,共 28 对中文短文本,按人读起来的语义关系分四组:
| 组 | 对数 | 含义 | 期望 |
|---|---|---|---|
copy |
4 | 完全相同的副本 | 所有指标应为 1.0,用来验证实现没写错 |
same |
10 | 同义改写,说法不同意思相同 | 应高分 |
partial |
6 | 同一话题,但侧重不同 | 应中分 |
diff |
8 | 完全无关 | 应低分 |
判据不看单个分数,看两个派生量:
区分度 = mean(same) - mean(diff)。它衡量指标能不能把“意思相同”和“意思无关”拉开。
可分性 = min(same) - max(diff)。这是更硬的条件:只有大于 0,才存在一个固定阈值把两类完全分开。小于等于 0 意味着无论阈值定在哪,都必然误判其中一类。
五、实测结果
28 对,n 分别取 1、2、3,三种打分方式,共 9 组结果:
| n | 指标 | copy | same | partial | diff | 区分度 | 可分性 |
|---|---|---|---|---|---|---|---|
| 1 | Jaccard | 1.0000 | 0.4032 | 0.1581 | 0.0204 | 0.3828 | 0.1102 |
| 1 | Dice | 1.0000 | 0.5514 | 0.2701 | 0.0384 | 0.5130 | 0.1705 |
| 1 | TF-IDF 余弦 | 1.0000 | 0.5361 | 0.2341 | 0.0241 | 0.5120 | 0.2000 |
| 2 | Jaccard | 1.0000 | 0.1693 | 0.0904 | 0.0000 | 0.1693 | 0.0476 |
| 2 | Dice | 1.0000 | 0.2712 | 0.1635 | 0.0000 | 0.2712 | 0.0909 |
| 2 | TF-IDF 余弦 | 1.0000 | 0.2401 | 0.1281 | 0.0000 | 0.2401 | 0.0779 |
| 3 | Jaccard | 1.0000 | 0.0761 | 0.0391 | 0.0000 | 0.0761 | 0.0000 |
| 3 | Dice | 1.0000 | 0.1296 | 0.0717 | 0.0000 | 0.1296 | 0.0000 |
| 3 | TF-IDF 余弦 | 1.0000 | 0.1137 | 0.0553 | 0.0000 | 0.1137 | 0.0000 |
copy 组全部 1.0000,说明实现没问题。真正值得看的是最后三行的可分性。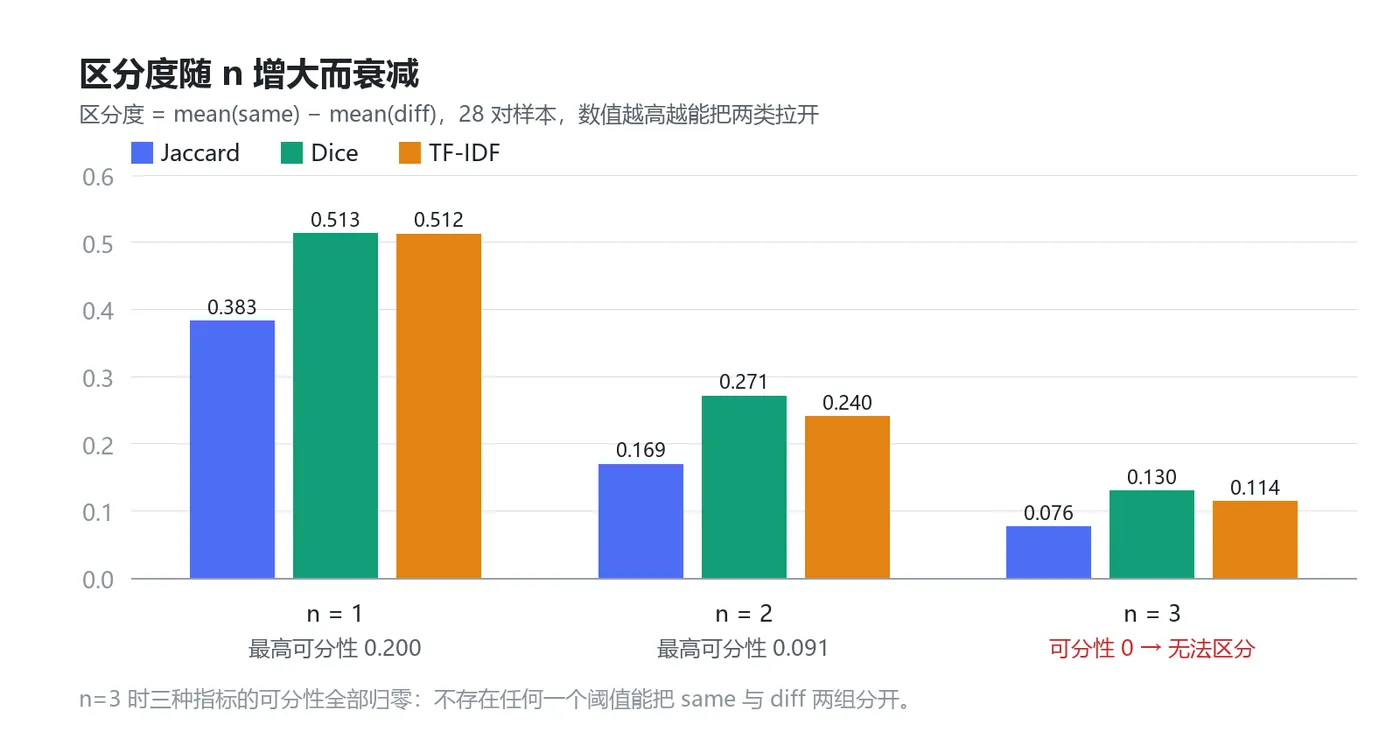
六、四条结论
1. n 越大不是越严格,是越失真
n=3 时,三种指标的可分性全部归零。原因是 same 组里出现了 0.0000:
10 对同义改写,有 4 对得分为 0,与无关文本完全无法区分。
其中一对是:
A: 深圳的夏天又闷又热
B: 深圳夏季天气闷热
B 句可以说是 A 句的压缩版本,人读起来毫无歧义。但在字符 3-gram 下,“深圳的”“夏天又”“天又闷”与“深圳夏”“圳夏季”“季天气”没有一个连续三字重合,交集为空。
结论:在短句场景下把 n 从 1 加到 3,不是提高了严格性,而是把有效信号一起删掉了。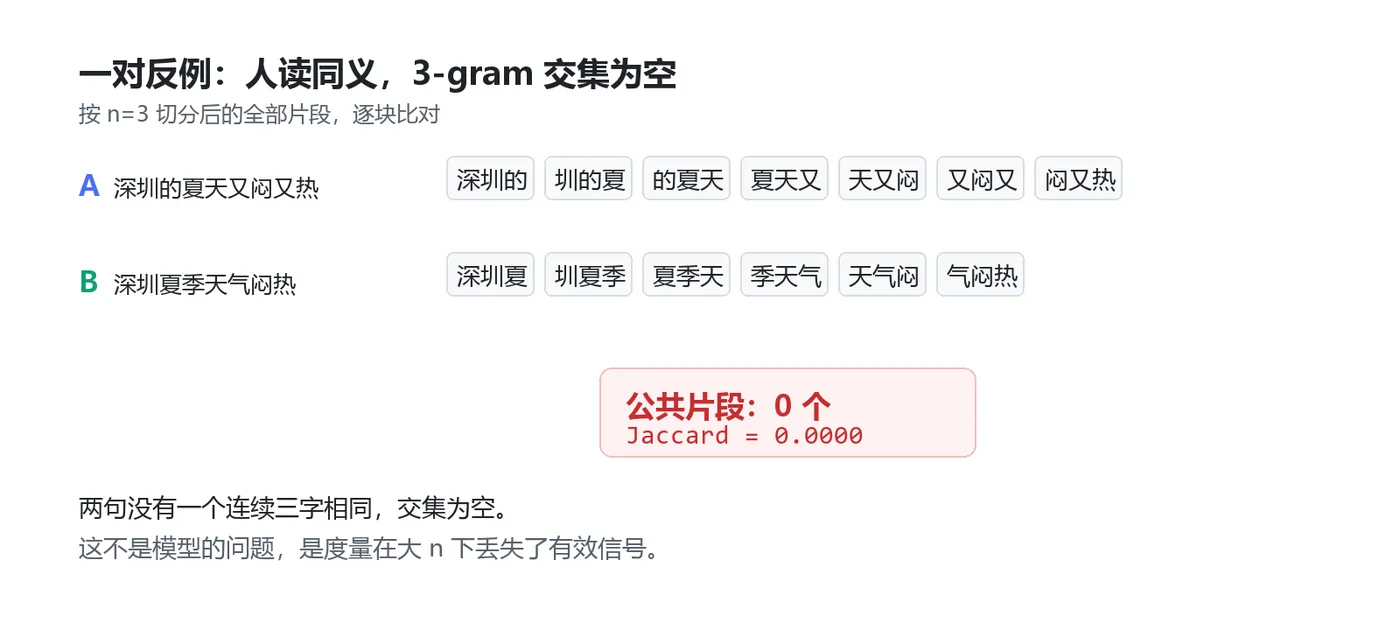
2. n=1 反而是最优档
n=1 时 Jaccard 可分性 0.1102、Dice 0.1705、TF-IDF 0.2000,三者都远高于 n=2 和 n=3。
原因不复杂:短文本里凑齐 3 个连续相同字符的概率太低。单字虽然携带的语义信息少,但重合概率高,反而形成了稳定信号。
这一点和“中文 n-gram 一般取 2 或 3”的常见建议相反。那个建议通常来自长文本场景,直接搬到短句上就失效了。
3. 同一 n 下,Dice 恒定优于 Jaccard
| n | Jaccard 区分度 | Dice 区分度 | 提升 |
|---|---|---|---|
| 1 | 0.3828 | 0.5130 | +34% |
| 2 | 0.1693 | 0.2712 | +60% |
| 3 | 0.0761 | 0.1296 | +70% |
三档全部 Dice 更高。原因是 Dice 的分母是两边集合大小之和,比并集小,在交集相同的情况下天然给出更高的分数,对短文本更友好。
如果只改一处,就把 Jaccard 换成 Dice,成本为零。
4. TF-IDF 余弦只在 n=1 时才最好
n=1 时它的可分性 0.2000,是九组里最高的。但 n=2 掉到 0.0779,低于 Dice 的 0.0909;n=3 同样低于 Dice。
原因在 IDF:短文本里每个 n-gram 都接近只出现一次,IDF 权重拉不开差距,反而把频次噪声放大了。n=1 时常用字多、DF 高、IDF 低,恰好起到了抑制高频字的平滑作用。
七、文本变长会好转,但排序不变
上面的数据都是 20 字以内的短句。补一组 40 字左右的段落做对照:
| n | 同主题段落得分 | 无关段落得分 | 区分度 |
|---|---|---|---|
| 1 | 0.3651 | 0.0441 | 0.3210 |
| 2 | 0.2647 | 0.0000 | 0.2647 |
| 3 | 0.1667 | 0.0000 | 0.1667 |
文本变长后 n=3 从完全失效恢复到了 0.1667,但仍低于 n=1 的 0.3210。排序没变。
所以 n 的选择要跟文本长度挂钩:短句用 1,长段落用 1 到 2,n=3 只在“文本够长且结构高度同构”的场景才有意义。
八、这套实验测不到什么
数据集规模小。 28 对是手工构造的,够看出方向,不够做统计显著性判断。要下强结论得上千对。
分组带主观性。 same 和 partial 的界限由我判断,换个人标注会有出入。
全部指标都停在字面层面。 同义改写得分天然偏低是这类指标的固有特征,不是实现 bug。这也是第一节那个 0.0755 的来源——它没有错,只是被用在了不合适的长度上。
不测语义。 真要判断两段话意思是否等价,得上 embedding 余弦。但 embedding 有自己的问题:向量相似度高,不代表论证结构相似。
九、下一步
值得做的下一个对照,是把 embedding 余弦加进这张表做三方对比。
重点看一类样本:字面分低但语义分高的那些。它们代表模型在换说法而不是换结论,而这批样本恰好是做内容优化时最该研究的对象——它揭示了同一个事实可以被组织成多少种不同的表述。
这部分涉及向量化和阈值标定,比本篇复杂,放到下一篇。向量表示我打算用百炼的文本嵌入接口来做,算完之后把字面指标和语义指标放在同一张表上对照,看它们在哪类样本上分歧最大。
作者:GEO优化阿文
用 Python 做生成式引擎(GEO)检索实测,十二年实体门店运营经验。