
2026年阿里云双十一从11月1日持续到11月30日,主题是"智惠就在11.11,AI就用阿里云"。百炼作为模型服务平台,这轮的定位不只是"卖算力",而是把模型调用、应用编排、知识库、工具链打包成一套按量计费的服务。对刚接触的人来说,最容易困惑的是三件事:这个平台到底能干什么、免费额度能不能真跑起来、Token Plan的Credits怎么换算成实际成本。这篇就按功能、优惠、实测、价格四个维度讲清楚。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、百炼是什么,六类能力构成
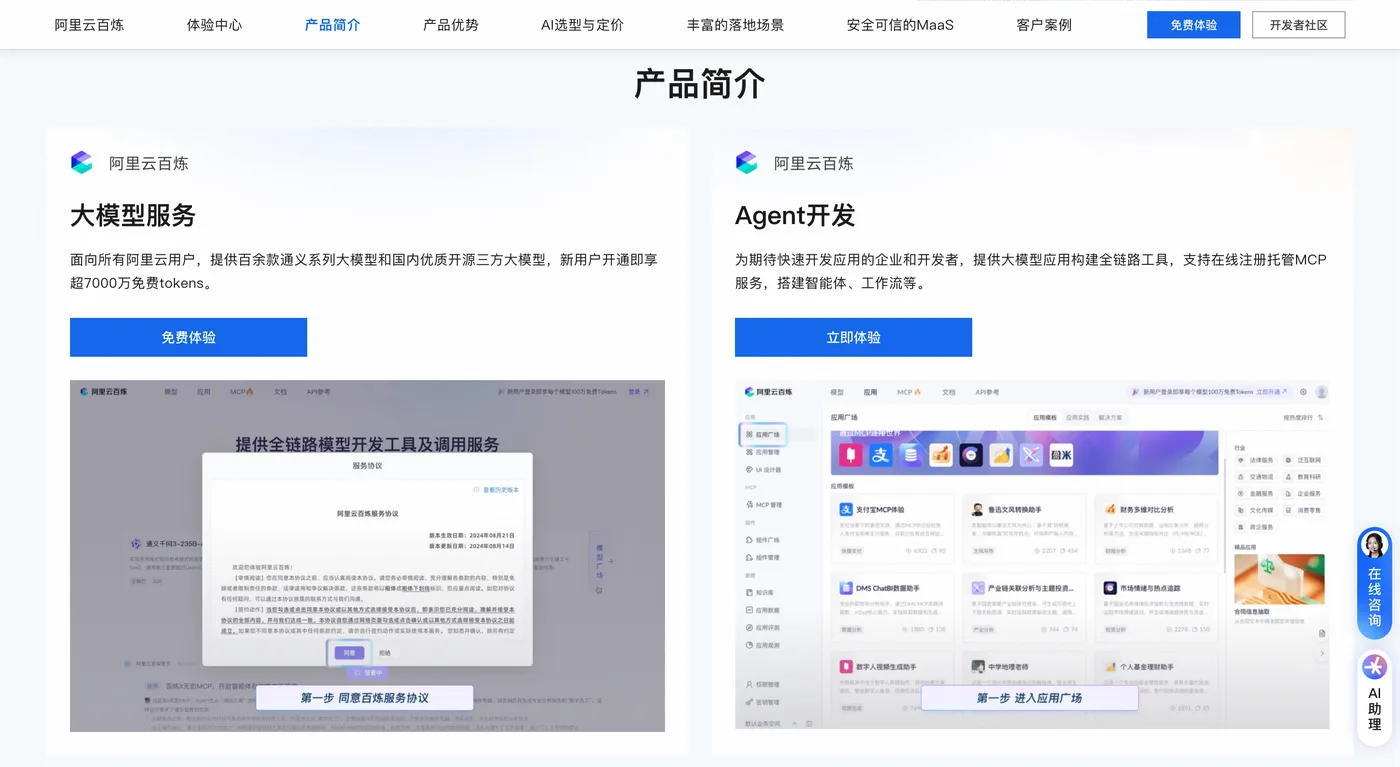
百炼是模型服务平台,核心作用是把大模型能力变成可调用的接口和可编排的应用,而不是单纯的模型托管。它的六类能力可以这样理解:
模型服务。提供通义千问系列的多个版本,包括Qwen3.8-Max、Qwen3.8-Flash、Qwen3.7-Plus等,也接入第三方开源模型。调用方式以OpenAI兼容协议为主,改一行Base URL就能从其他框架切过来。
应用开发。支持搭建Agent、应用编排、工作流,把模型调用、检索、工具串联成一个完整业务流程,不需要自己写调度代码。
知识库与检索增强。上传文档构建私有知识库,提问时先检索再生成,适合企业内部资料问答、产品手册助手这类场景。
模型训练与微调。支持在平台上做微调和参数高效训练,用自己的数据把通用模型调成专用模型。
模型评测。内置评测集与打分能力,能在同一批测试样本上横向比较不同模型的表现,是选型时最实用的功能。
部署与托管。训好的模型可以部署成独立服务,也可以走托管Agent,把接口暴露给业务系统调用。
配套还有MCP协议开放,让外部工具以标准方式接入Agent,扩展性比纯粹的对话接口高一个层级。
二、功能实测:不同模型该用在哪
实测中最直接的感受是模型分层很清楚,用错档位要么浪费钱,要么效果不够。
Qwen3.8-Flash响应快、单价低,适合高并发的常规问答、内容分类、结构化抽取、摘要生成。实测中做批量文档摘要,Flash的吞吐明显高于Max,质量在结构化任务上差距不大,是性价比最高的一档。
Qwen3.8-Max推理深度更强,适合复杂逻辑、多步推理、长文本分析、代码理解。实测中做长文档多跳问答和代码审查,Max的准确率优势明显,但延迟和消耗也更高,不适合放在高频接口上。
Qwen3.7-Plus位置居中,适合作为均衡档。夜间22点到次日8点调用时按4折计费(这条是模型调用Credits的折扣,不是订阅费折扣),把批处理任务排到夜间是省钱的有效手段。
一个实测结论:不要把所有任务都塞给Max。先用Flash跑一遍,把明显答不好的样本挑出来单独走Max,成本能降一半以上而效果几乎不掉。
三、优惠活动:免费额度与订阅套餐
免费额度。新用户实名后,每款主流模型约有100万Token、90天有效,合计超过7000万Token,仅限华北2(北京)。抵扣顺序是免费额度优先,其次资源包、节省计划、按量付费。这里有个关键提示:用专属密钥(sk-sp开头)调用不消耗免费额度,所以想用免费额度试模型,必须用通用密钥。
Token Plan个人版四档。Lite 39元每月(新客19.5),20,000 Credits每月,并发1到2;Essential 79元(新客39.5),45,000 Credits,并发2到3;Standard 139元,80,000 Credits,并发3到4,附赠Harness;Pro 312元,200,000 Credits,并发6到8,附赠Harness。新客限时价有效至11月30日23:59:59,仅限从未购买过个人版的账号,同一实名主体限购一份,不支持退订,额度按月重置不结转,仅支持华北2。详情👉访问阿里云百炼大模型服务平台页面 了解。
用量包。超出套餐后按用量包补,100元一个、含20,000 Credits、最多叠加5个,比溢出后按量付费便宜。
Harness权益。Standard及以上附赠Harness,其中12项能力不消耗Credits:联网搜索、网页解析、图像生成、语音合成、语音识别、实时语音对话、代码解释器、知识库、记忆库、沙箱、托管Agent、MCP协议开放。这一项对成本影响很大——把检索、解析、语音这类活儿走Harness,Credits只留给纯模型推理。
四、配置价格怎么换算
Credits是这套体系的计量单位,不同模型、不同调用类型的消耗系数不同,官方在计费页会给出换算表。选档的思路是按并发和月度调用量反推,而不是按价格排序。
只做个人测试、偶尔跑脚本,Lite够用,20,000 Credits配1到2并发适合单人低强度使用。
小团队共用一个账号,Essential的45,000 Credits和2到3并发更稳,多人同时调不会频繁排队。
有稳定业务接口、需要较高并发,直接上Standard,80,000 Credits加3到4并发,还附带Harness,性价比拐点在这里。
跑批量任务、Agent集群、需要6到8并发,选Pro,200,000 Credits是唯一能撑住高频调用的档位。
一个必须提前算清的点:并发限制是硬上限,不是软提醒。超出并发的请求会被排队或拒绝,高峰期表现比单价更重要,选档时优先看并发而不是Credits总量。
五、接入与核验命令
先用兼容接口打一次调用,确认密钥类型和额度扣减是否正常:
curl [https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/chat/completions](https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/chat/completions) \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3.8-flash","messages":[{"role":"user","content":"ping"}]}'
Python侧跑一次流式调用,验证长文本输出是否稳定:
pip install openai dashscope -U
python - <<'PY'
from openai import OpenAI
c = OpenAI(api_key="你的密钥", base_url="[https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1](https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1)")
r = c.chat.completions.create(model="qwen3.8-flash", messages=[{"role":"user","content":"写一段100字产品说明"}])
print(r.choices[0].message.content)
PY
批量任务加一层重试与限速,避免触发并发上限:
python - <<'PY'
import time
from openai import OpenAI
c = OpenAI(api_key="你的密钥", base_url="[https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1](https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1)")
for i, q in enumerate(["问题一","问题二","问题三"]):
    try:
        r = c.chat.completions.create(model="qwen3.8-flash", messages=[{"role":"user","content":q}])
        print(i, r.choices[0].message.content[:60])
    except Exception as e:
        print(i, "err", e)
    time.sleep(1)
PY
在控制台侧,用命令行查账号资源与用量,确认额度消耗与预期一致:
aliyun configure
aliyun bssopenapi QueryAccountBill --BillingCycle 2026-11 --Granularity MONTH
六、避坑清单
Token Plan的专属Key前缀是sk-sp,Base URL是 https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1,与通用sk密钥、Coding Plan均不通用。混用会走按量计费、不消耗套餐额度,等于交了订阅费还在额外掏钱。详情👉访问阿里云百炼大模型服务平台页面 了解。
sk-sp密钥不消耗免费额度,想用7000万Token试模型必须换成通用密钥。
免费额度仅限华北2(北京),其他地域不适用,跨地域调用会直接按量计费。
新客限时价只对从未购买过个人版的账号有效,同一实名主体限购一份,不支持退订,额度按月重置不结转,用不完不累积。
默认不开启"额度用尽即停止调用"开关,额度耗尽后会转为按量计费继续扣费,建议在控制台打开这个开关。订阅费折扣和模型调用折扣是两件事,夜间4折说的是调用Credits,不是订阅月费打折。
总结
百炼这轮的价值不在"便宜多少",而在于把模型能力、工具链和计费口径统一到一套Credits体系里。选档的关键两个参数是并发和月度调用量,不是Credits总量;省钱的关键是分层用模型加Harness分流,而不是一味降档。先用免费额度把Flash和Max都跑一遍,找到自己业务的实际分层线,再决定买哪一档,比照着价格表猜更准。
