
阿里云百炼AI模型平台的吞吐预留是什么意思?百炼平台的吞吐预留(原TPM预留)是为指定模型锁定专属推理吞吐量(TPM)的功能,确保业务高峰期调用不受公共资源限流影响。详细参考阿里云百炼官网说明 👉️ https://www.aliyun.com/product/bailian 如下图:
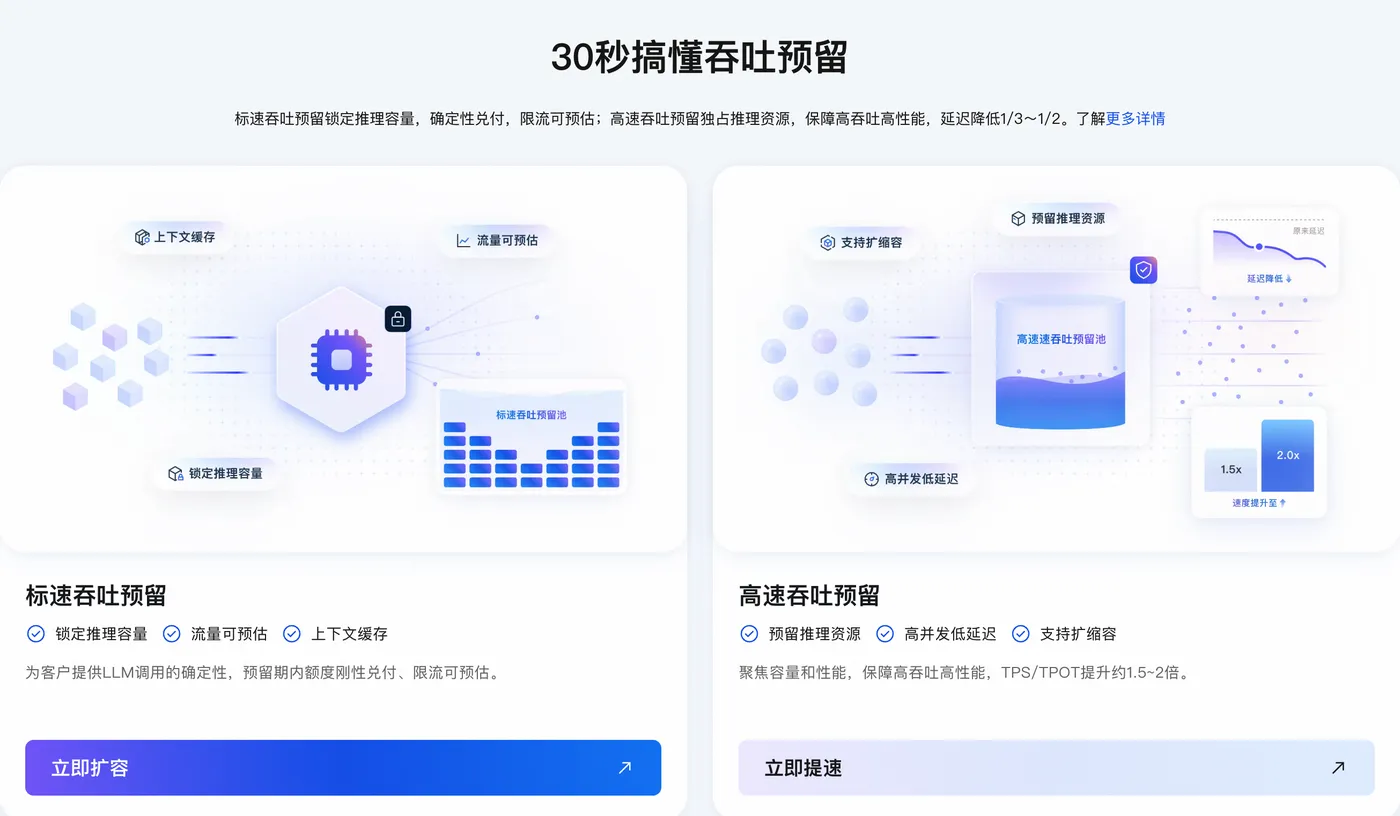
吞吐预留(原TPM预留)核心特性
- 容量保障:预留的 TPM 容量为业务专属,不与其他用户共享。
- 专属模型 Code:创建后系统自动生成专属模型 Code,需将 API 请求中的
model参数替换为该 Code 才能使用预留容量。 - 溢出策略:支持“自动溢出至按量计费”(默认,业务不中断)或“仅使用预留容量”(超出返回 429,无额外费用)。
- 性能模式:提供标准模式(与标准 API 相同 TPS)和高速模式(即 PTU 模型部署,TPS 提升 1.5~2 倍)。
计费规则
- 生效即计费:创建成功即开始计费,容量费用按购买量一次性支付,与是否实际调用无关,不因用量减免。
- 付费周期:支持按天预付费、按 8 小时时段预付费(仅标准模式,享 9 折)、以及高速模式的后付费(按小时)。
- 到期生命周期:按天预留到期后 2 小时内仍可续费,2~14 小时已停止但可续费,14 小时后释放且不可恢复;8 小时时段预留到期后容量自动失效,不适用宽限期。
创建与接入
- 登录 百炼控制台,单击创建 吞吐预留。
- 填写预留名称、选择模型、性能模式、付费周期、输入/输出 TPM、购买时长及溢出策略等参数。
- 确认支付后,在详情页概览页签复制专属模型 Code。
- 将 API 请求中的
model参数替换为该专属模型 Code 即可调用。
支持模型
目前查到华北2(北京)地域支持 Qwen3.8-Max、Qwen3.7-Flash-2026-07-15、GLM-5.3、DeepSeek-v4.1-Flash、Kimi-K2.6 等模型;新加坡地域支持 Qwen3.8-Max、GLM-5.3、DeepSeek-v4-Pro 等模型。具体支持列表及价格请以 💰 阿里云百炼官网 实时展示为准。
管理操作
支持叠加容量包(沿用同一专属模型 Code)、扩缩容、续费及退订。退订后专属模型 Code 失效,已使用部分按 1.2 倍系数结算退费。
