
很多人第一次用 virtualenv 或 venv,都会有一种错觉:终于不用跟系统 Python 打架了,项目 A 用 Django 3,项目 B 用 Django 5,各跑各的,世界清净了。
大部分时候,确实清净了。
但只要项目开始碰到带 C 扩展的包、多套插件、GPU、系统动态库、桌面应用、数据目录,或者你要把它交给另一个人双击运行,virtualenv 的边界就开始露出来了。
它隔离了不少东西,但没有隔离到“应用”这一层。
这就是 Python 到今天也没有真正意义上 Flatpak 式依赖隔离的原因。
先把几个概念掰开
Python 生态里经常把“装在不同目录里”直接等同于“隔离”。这两个不是一回事。
virtualenv 做的核心事情很明确:
- 给项目准备独立的 Python 解释器入口;
- 把第三方包装进独立的
site-packages; - 让
pip install尽量只影响当前环境; - 用
PATH、sys.path和环境变量,把当前进程导向这套依赖。
这已经解决了 Python 世界里最常见的一类冲突:同一个包,不同版本,不能同时满足。
比如一个老项目锁死在:
requests==2.25
urllib3==1.26
另一个项目已经升级到:
requests==2.32
urllib3==2.x
两个虚拟环境各装一套,基本就没事了。
问题是,Python 应用真正依赖的从来不只是 site-packages。
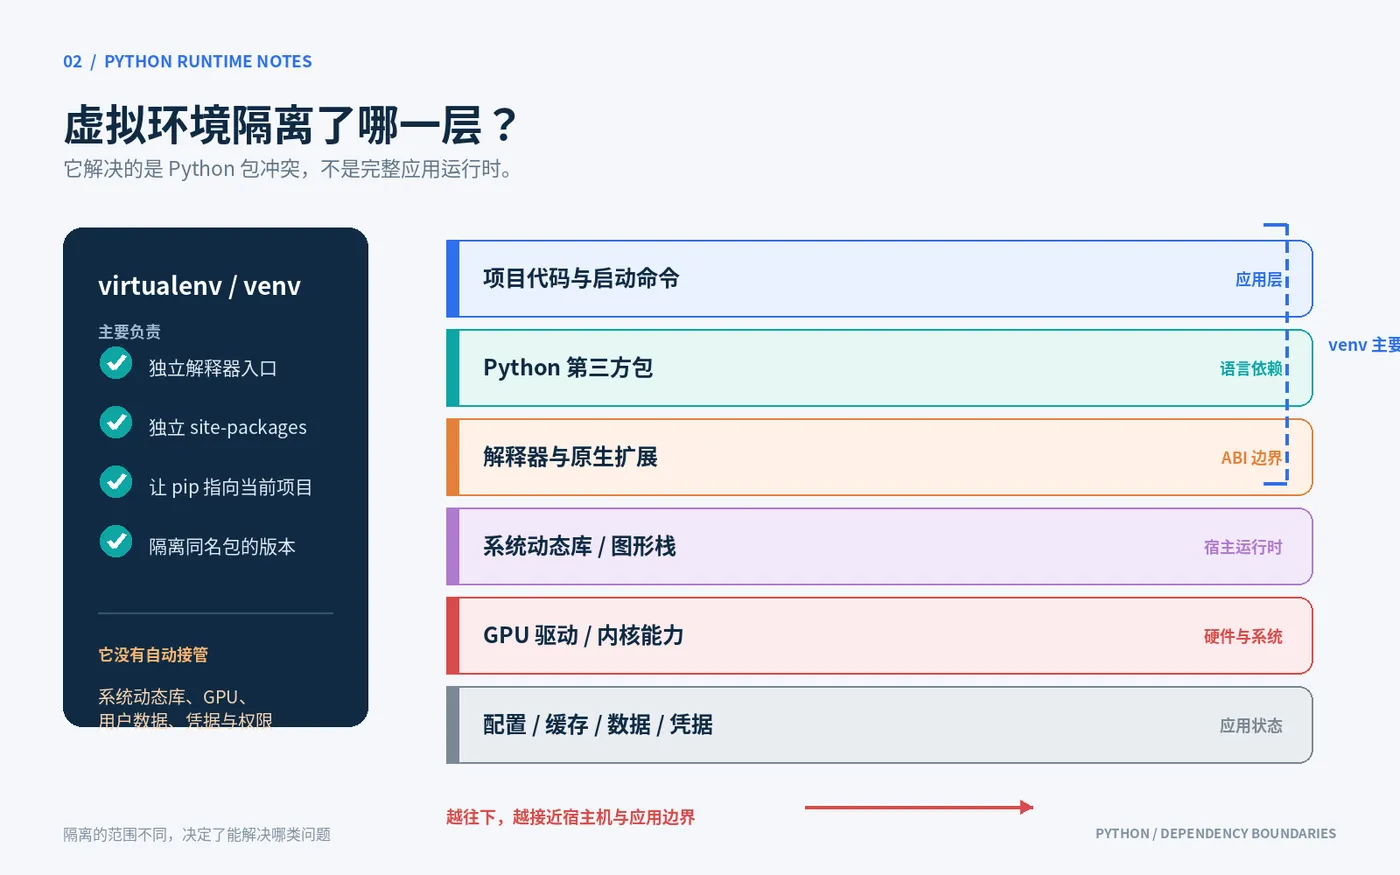
往下拆一层看,一个看起来普通的 Python 程序,实际可能还依赖:
- Python 解释器本身的版本和编译方式;
glibc、OpenSSL、libstdc++这类系统动态库;- NumPy、PyTorch、Pandas 里带的原生二进制扩展;
- 浏览器、字体、图形库、音视频编解码器;
- CUDA 驱动、显卡运行时、系统内核能力;
- 数据库、Redis、模型文件、缓存目录;
- 插件发现机制、子进程、命令行工具;
- 用户目录里的配置、凭据和历史数据。
virtualenv 管住的,只是其中一块。
而且是相对靠上的一块。
一个虚拟环境,为什么还会“环境不对”
我以前碰到过一类问题,最烦。
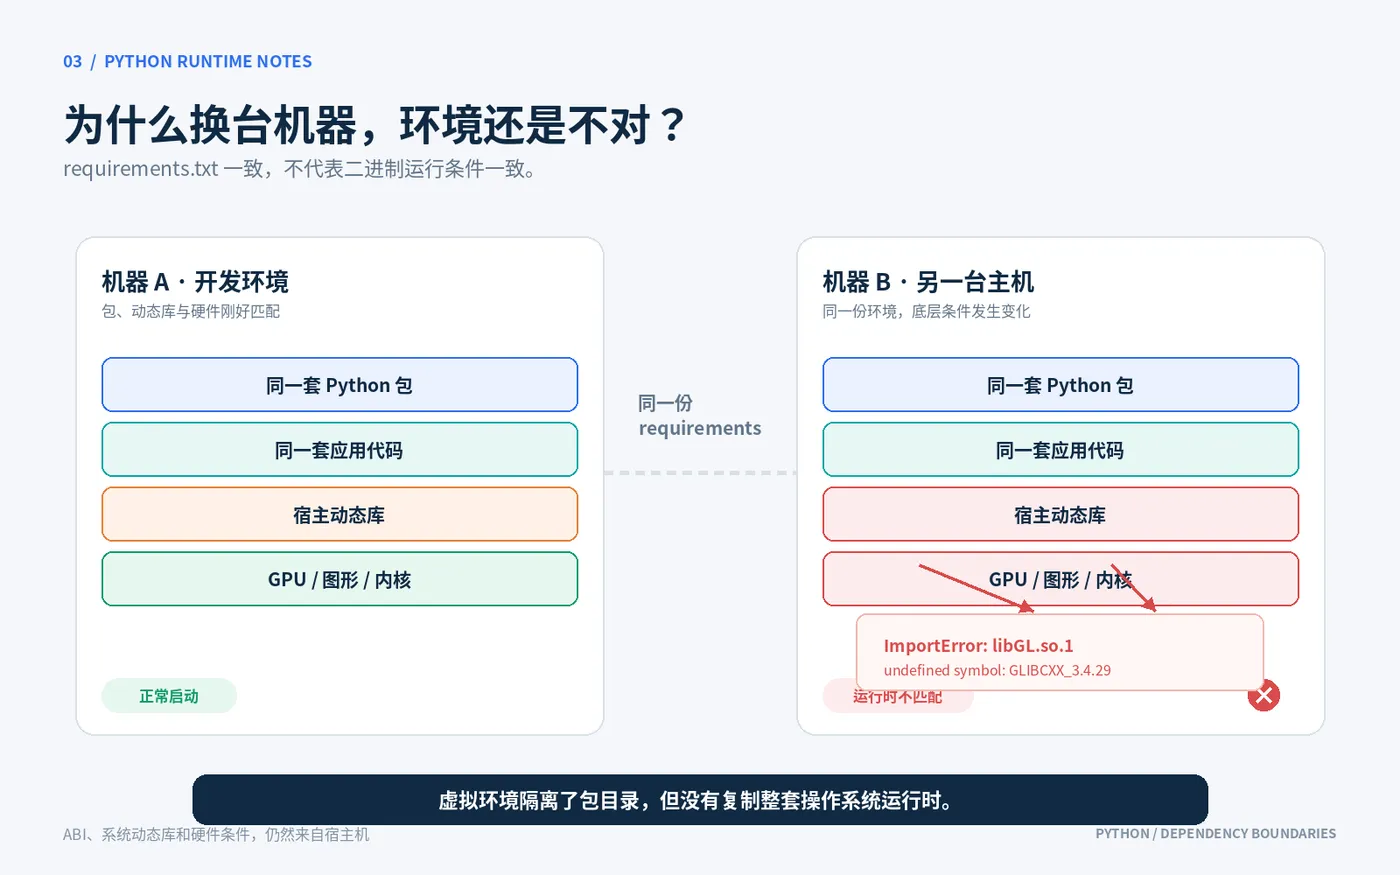
本地跑得好好的项目,换一台机器,先是 pip install 没报错,启动时也没报错,直到某个不常走的功能被点到,突然来一句:
ImportError: libGL.so.1: cannot open shared object file
或者:
undefined symbol: GLIBCXX_3.4.29
再或者,PyTorch 能导入,模型一上 GPU 就炸。
这时候很多人的第一反应是:“是不是虚拟环境没激活?”
一般不是。
虚拟环境确实激活了,只不过它没有,也不打算替你复制整套操作系统运行时。它默认相信宿主机提供的底层能力是可用的。
问题恰恰出在这儿。
pip 管的是 Python 包,Linux 发行版的包管理器管的是系统库,显卡驱动跟内核、硬件又绑得更紧。三套东西各自有边界,但真实应用会同时踩进去。
所以你会看到一种很别扭的状态:
Python 依赖明明隔离了,应用却还是不能稳定运行。
不是 Python 包冲突了,是应用边界没闭合。
Flatpak 隔离的,根本不只是包版本
拿 Flatpak 做对比,容易把事情看得更清楚。
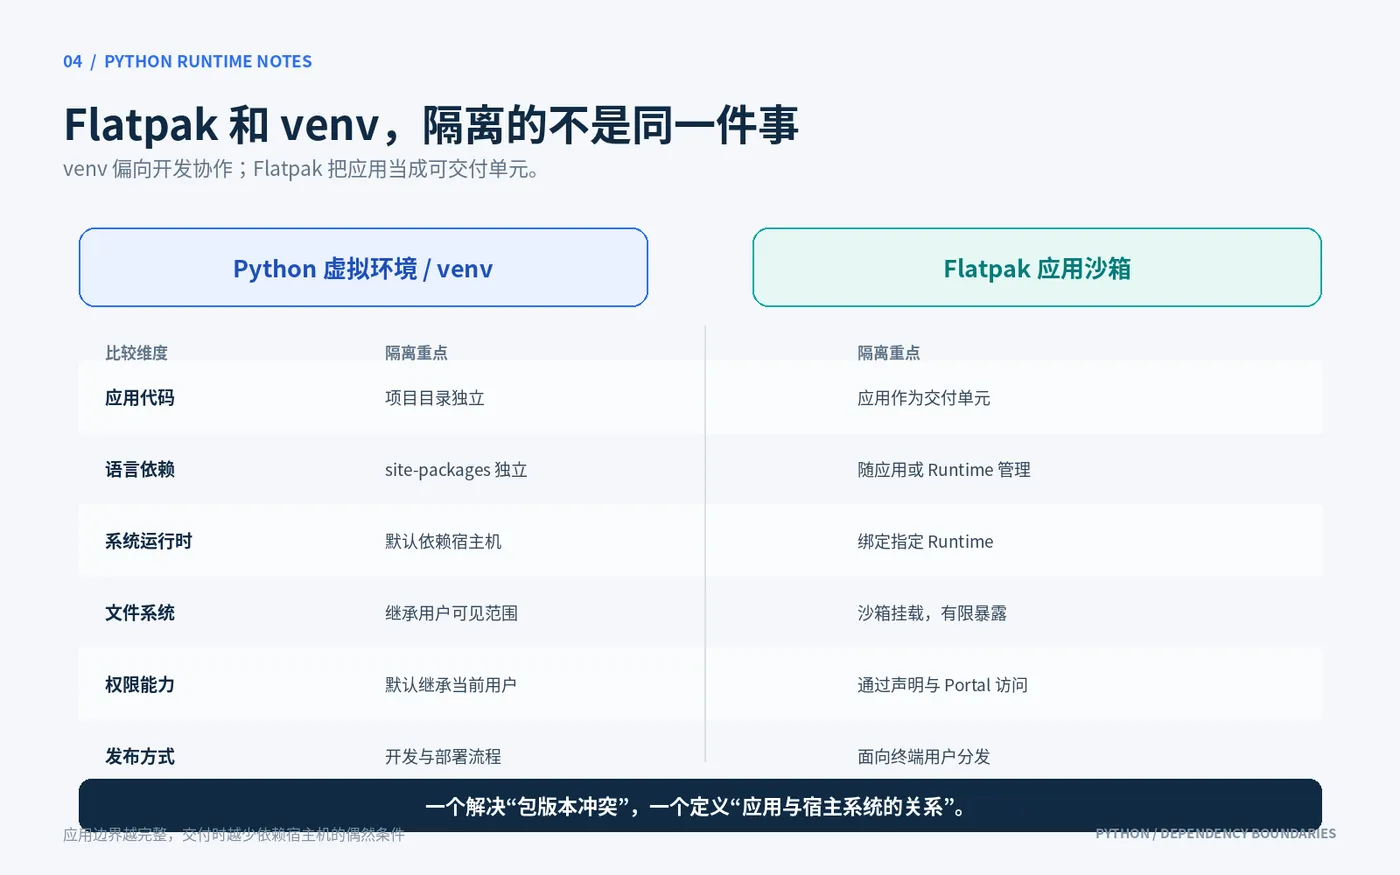
Flatpak 的目标不是“让一个应用装自己的 Python 包”,而是让一个图形应用在相对完整、相对稳定的运行时里活下来。
它大致把东西拆成了几层:
| 层级 | Flatpak 的思路 | Python 虚拟环境的思路 |
|---|---|---|
| 应用代码 | 独立封装 | 项目目录独立 |
| 语言依赖 | 随应用或运行时管理 | site-packages 独立 |
| 系统运行时 | 绑定指定 Runtime | 依赖宿主机 |
| 桌面能力 | 通过 Portal 按权限访问 | 默认继承宿主环境 |
| 文件系统 | 沙箱挂载,有限暴露 | 默认能看到用户权限范围内的大量目录 |
| 应用发布 | 面向最终用户的可运行包 | 更多面向开发和部署流程 |
这里最关键的一点是:Flatpak 明确把“应用”当成一个交付单元。
这个单元里不只有代码和第三方库,还包括:
- 它信赖哪套基础运行时;
- 它能访问哪些文件;
- 它能不能调摄像头、麦克风、网络;
- 它如何接入桌面系统;
- 它出问题时,应该优先怀疑自己的包,还是宿主机。
venv 没有这个野心。
它更像是 Python 开发者之间的协作协议:大家约好,一个项目一套依赖,别往全局 Python 里乱塞东西。
这已经很好了,但离“一个独立应用”还差很远。
ABI 才是很多依赖冲突真正的底牌
Python 里最容易被低估的东西叫 ABI,Application Binary Interface,应用二进制接口。
通俗说,Python 源码包看起来像一堆 .py 文件,换个版本解释器大多数还能读;但很多高性能库并不是纯 Python 写的。
像 NumPy、Pandas、PyTorch、OpenCV、cryptography、lxml,背后都有 C、C++、Rust 或 CUDA 编译出来的部分。
这些二进制部分会偷偷依赖很多条件:
- CPython 的具体版本;
- CPU 架构;
- 编译器版本;
- C++ 标准库版本;
- OpenSSL 版本;
glibc版本;- GPU 驱动和 CUDA 版本;
- 其他原生扩展暴露出来的 ABI。
这也是为什么你有时候明明看到包版本完全一致,requirements.txt 一字不差,换台机器还是跑不起来。
因为 requirements.txt 描述的是“我想要哪些 Python 包”,不是“这台机器必须具备怎样的二进制运行条件”。
锁文件也解决不了全部问题。
poetry.lock、uv.lock、requirements.txt 加哈希,可以把 Python 包的解析结果钉得更牢;但它们通常无法替你冻结宿主机的内核、显卡驱动、动态链接器和系统图形栈。
不对。
严格讲,它们不是做不到,而是不适合单靠 Python 包管理器做。
Conda 已经往前走了一步,但还是没到 Flatpak
Conda 比 venv + pip 更接近“完整环境”的思路。
它不只管 Python 包,也能管一部分原生库,例如:
- OpenSSL;
- BLAS;
- MKL;
libpng;- 某些编译工具;
- 一部分 CUDA 运行时组件。
所以做科学计算、机器学习的人,会更愿意用 Conda 或 Mamba。不是因为它命令多酷,是因为它愿意把更多底层依赖也装进环境里。
这能消掉不少“我 Python 包没问题,但原生库对不上”的坑。
只不过,Conda 的隔离边界依然更像“开发运行环境”,不是桌面应用沙箱。
它通常仍然会:
- 依赖宿主机内核;
- 使用宿主机显卡驱动;
- 读取宿主机环境变量;
- 访问用户目录;
- 跟系统浏览器、系统证书、系统工具交互;
- 在权限上跟当前用户绑定。
所以 Conda 比虚拟环境厚,但不是 Flatpak。
它解决的是“依赖包和原生库怎么一起装”,不是“这个应用在系统里到底应该看到什么、能做什么”。
容器才更接近“完整边界”,但它也不是桌面应用方案
如果你的 Python 应用是服务端程序,Docker、Podman 这类容器其实已经非常接近你想要的效果。
你可以把下面这些放进镜像:
Python 版本
系统基础镜像
操作系统依赖
Python 依赖
应用代码
启动命令
默认配置
然后交付成一个镜像。
换机器时,只要容器运行时、内核能力和硬件条件没踩雷,应用运行结果就会稳定很多。
这也是为什么后端团队说“本地能跑、线上不能跑”时,最后往往都会走到容器。
但容器的强项是服务端和批处理任务,不是桌面应用分发。
把一个带 GUI、文件选择器、摄像头、通知、系统主题、打印机权限的 Python 应用塞进容器里,你会重新遇到一堆问题:显示服务怎么转发,用户文件怎么挂载,权限怎么管,桌面集成怎么做。
Flatpak 对这些事情有专门的回答,Docker 没有。
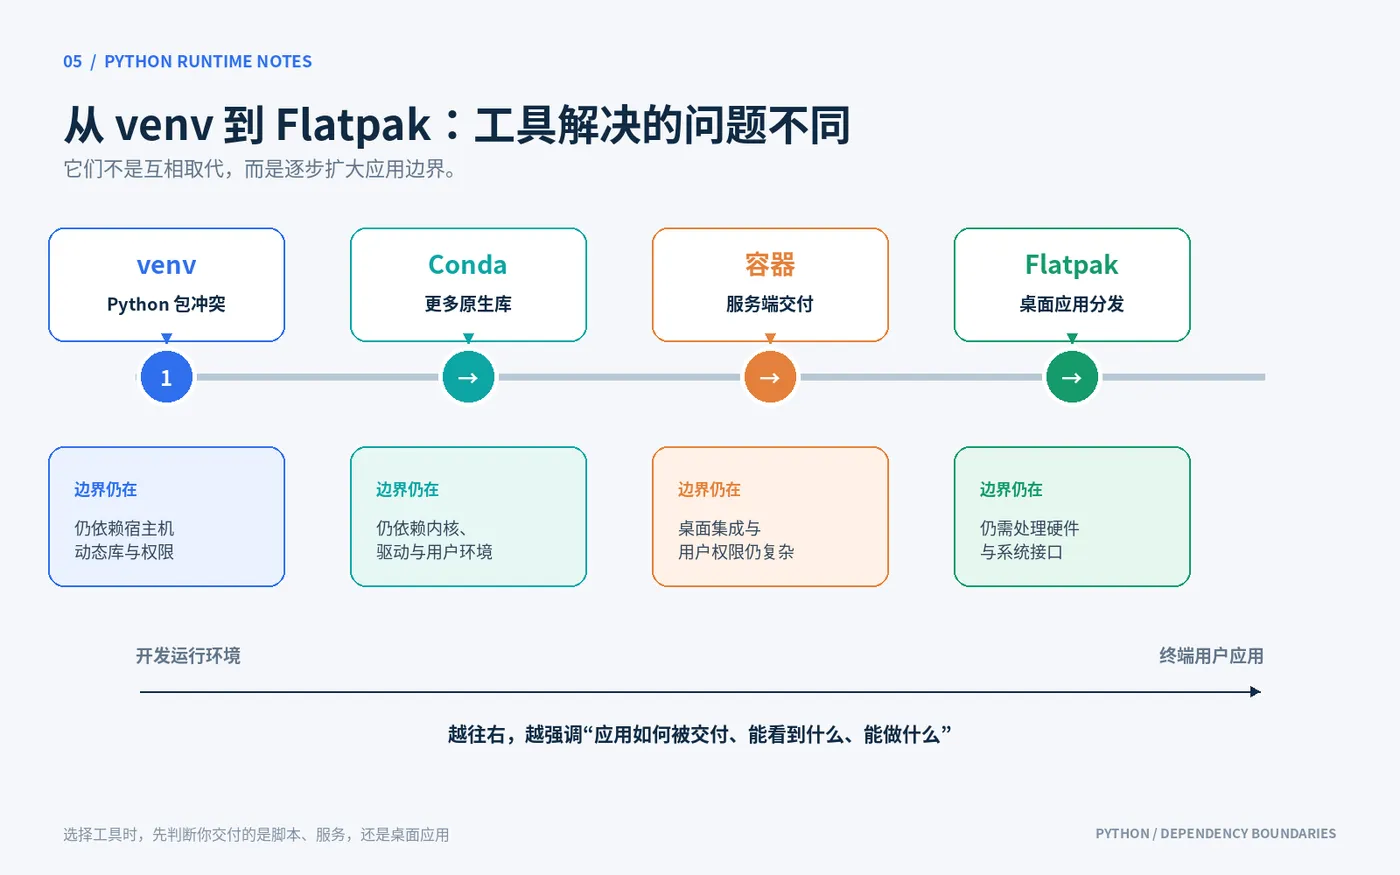
所以三者不是谁取代谁:
venv:解决开发期的 Python 包冲突;- Conda:补齐更多原生运行时依赖;
- 容器:交付服务端或任务型应用;
- Flatpak:交付桌面应用,并约束它与宿主系统的关系。
Python 还有一个更麻烦的问题:插件不等于依赖
依赖隔离谈到最后,迟早会撞上插件。
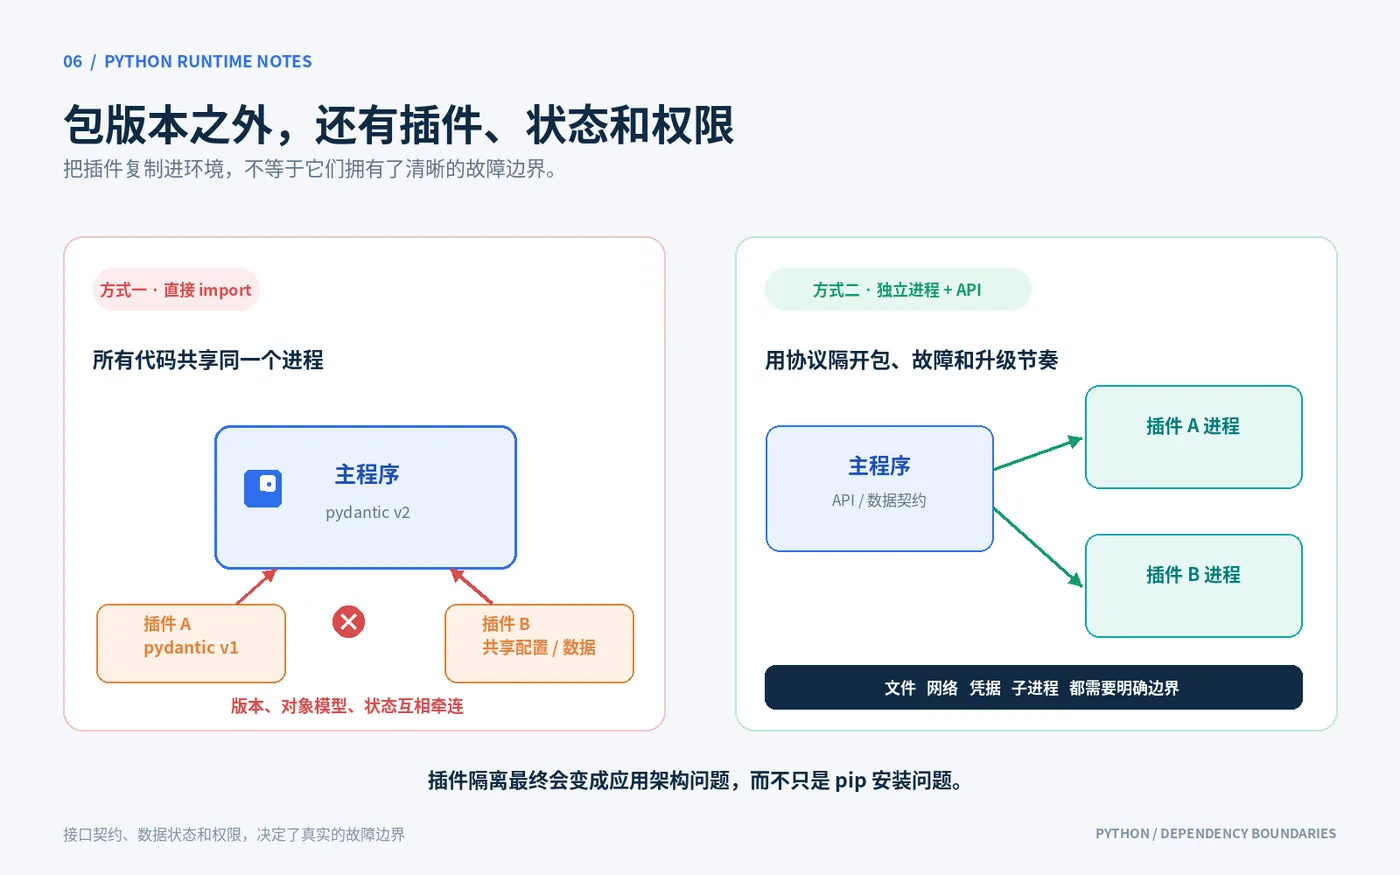
一个普通 Python 程序的依赖关系,大致是树状的:应用依赖 A,A 依赖 B,B 依赖 C。包管理器虽然会头疼,至少还有机会算清楚版本。
插件系统不是。
插件往往意味着:
- 主程序在运行时发现并加载第三方代码;
- 插件和主程序要共享接口定义;
- 多个插件可能依赖不同版本的同一个库;
- 插件可能注册命令、模型、文件格式、数据库迁移;
- 插件可能启动自己的子进程,甚至把数据写到主程序目录。
这时候,即使每个插件都有自己的虚拟环境,也不代表它们能安全地装进同一个宿主程序。
因为冲突不只在“包版本”。
还可能在:
- Python 对象模型;
- 插件 API 版本;
- 数据库 schema;
- 配置文件格式;
- 缓存结构;
- 命令名;
- 进程端口;
- 文件读写权限。
举个简单例子。
某个插件需要 pydantic v1,主程序已经迁到 pydantic v2。你可以尝试让插件跑在独立进程里,用 HTTP 或 gRPC 通信,这确实能把 Python 包隔开。
但新问题立刻来了:两边的数据模型怎么对齐?错误怎么传递?版本怎么协商?升级时谁先升级?
这已经不是依赖管理,而是应用架构。
说白了,把包复制得再多,也不能自动消除接口契约。
数据格式和状态,往往比版本冲突更难隔离
Python 开发者很容易把“环境问题”理解成安装问题,因为报错通常发生在 pip install 或 import 的时候。
但生产环境里更棘手的,常常是状态问题。
比如:
- 老版本程序写出的缓存,新版本读不出来;
- 插件升级后改了 SQLite schema,主程序回滚不了了;
- 模型文件被新版本转换过,旧版本加载失败;
- 同一份配置被两个工具按不同语义解释;
- 一个 CLI 工具把默认目录写进了
~/.config,另一个版本沿用旧格式; - 两个应用共用了一个浏览器 profile,登录态和扩展互相污染。
这些事,虚拟环境基本帮不上忙。
因为它隔离的是 Python 解释器和包目录,不会自动替你隔离:
用户数据
缓存
数据库
配置
凭据
端口
外部服务
文件格式
而 Flatpak、移动端应用沙箱、甚至 macOS 的 App Sandbox,关注的恰恰是这些东西。
它们不是只问“你带了什么库”,还问“你默认能碰什么”。
安全隔离和依赖隔离,也不是一回事
这里还有一个经常被忽略的点。
venv 不是安全沙箱。
激活虚拟环境后,一个 Python 程序通常仍然可以:
- 读取当前用户有权限读取的文件;
- 发起网络请求;
- 执行子进程;
- 读取环境变量;
- 访问 SSH Key、云平台凭据、浏览器数据目录;
- 把数据写进用户目录;
- 下载并执行额外代码。
所以,哪怕你的依赖版本全锁住了,也不能说明应用是安全的。
Python 的供应链风险,很多时候不是“装错了版本”,而是:
- 装进了恶意包;
- 依赖被投毒;
- 构建阶段执行了不可信脚本;
- 应用拿到了过大的文件和网络权限;
- 开发环境里的密钥被顺手读取了。
Flatpak 这类方案至少试图把权限显式化:应用默认看不到什么,想访问什么,再通过受控机制申请。
Python 的默认模型则更偏开发效率:你启动一个脚本,它基本继承当前用户的能力。
两套价值观不一样。
那 Python 为什么不直接做一个 Flatpak
技术上当然可以做。
事实上,Python 生态已经有不少接近这个方向的工具:
pipx:把命令行应用放进各自独立环境;- PyInstaller、Nuitka:把 Python 程序和解释器、部分依赖一起打包;
- Shiv、PEX、zipapp:把应用做成可分发的执行包;
- Conda-pack:把 Conda 环境整体搬走;
- Docker:把服务端运行时打包;
- Briefcase:尝试把 Python 应用打成更接近原生平台应用的形态。
它们各自解决了一段问题,但没有谁能统一接管全部边界。
因为要做真正的 Flatpak 式隔离,Python 需要的不只是一个更强的 pip,而是一整套应用分发规范:
稳定的应用 Runtime 定义
不只是 Python 版本,还要描述原生库、运行时、系统接口和硬件能力。统一的权限模型
文件、网络、摄像头、剪贴板、凭据、子进程,哪些默认允许,哪些需要声明。应用数据的隔离规则
配置、缓存、日志、数据库、模型文件,怎么迁移,怎么回滚,怎么避免不同版本互相踩。插件的跨进程协议
不再假设插件能直接import到主进程,而是明确数据格式、版本协商和故障边界。跨平台的一致性
Linux、macOS、Windows 的系统库、权限机制、图形栈差别很大。Python 本身跨平台,不代表完整应用运行时天然跨平台。
这不是一个包管理器升级一下就能解决的事。
它更像重新定义“Python 应用”是什么。
最后说个不那么讨喜的结论
Python 没有真正的 Flatpak 式依赖隔离,不是因为 Python 开发者还不会复制包,也不是因为 venv 不够努力。
真正的原因是,Python 长期把自己定位成一种嵌入式、脚本式、服务端优先的开发语言。它擅长进入别人的系统、调用别人的库、编排别人的工具。
这种灵活性很值钱。
但灵活的反面,就是边界不够硬。
virtualenv 适合项目开发,Conda 适合复杂计算环境,容器适合服务端交付,Flatpak 适合桌面应用分发。硬把任何一个工具当成万能隔离方案,最后都会被 ABI、插件、数据状态和权限问题教育一遍。
依赖隔离的本质,不是复制更多包。
是明确应用边界:哪些东西属于应用,哪些东西属于系统,哪些状态可以共享,哪些能力必须拒绝默认继承。
这块怎么权衡,得看你们的应用到底是一个脚本、一个服务,还是一个真正要交付给终端用户的软件。
