Layer normalization 篇

简介: LayerNorm是稳定LLM训练的核心技术,含Layer Norm、轻量RMS Norm(去均值/平移)及Deep Norm(残差缩放+参数初始化优化);位置上分Pre/Post/Sandwich-LN,影响收敛与稳定性;各模型依需求选用。

Layer normalization 篇

Layer normalization-方法篇

Layer Norm 篇

Layer Norm 的计算公式写一下?
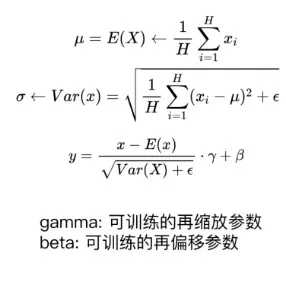
微信截图_20230920223231

RMS Norm 篇 (均方根 Norm)

RMS Norm 的计算公式写一下?
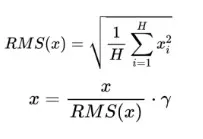
微信截图_20230920223408

RMS Norm 相比于 Layer Norm 有什么特点?

RMS Norm 简化了 Layer Norm ,去除掉计算均值进行平移的部分。

对比LN,RMS Norm的计算速度更快。效果基本相当,甚至略有提升。

Deep Norm 篇

Deep Norm 思路?

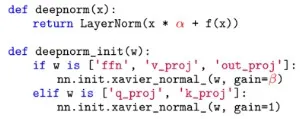
Deep Norm方法在执行Layer Norm之前,up-scale了残差连接 (alpha>1);另外,在初始化阶段down-scale了模型参数(beta<1)。

写一下 Deep Norm 代码实现?
微信截图_20230920223752

Deep Norm 有什么优点?

Deep Norm可以缓解爆炸式模型更新的问题,把模型更新限制在常数,使得模型训练过程更稳定。

Layer normalization-位置篇

1 LN 在 LLMs 中的不同位置 有什么区别么?如果有,能介绍一下区别么?

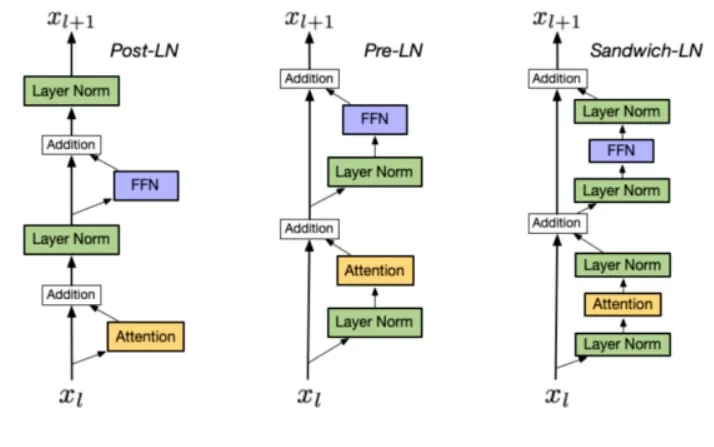
回答:有,LN 在 LLMs 位置有以下几种:
微信截图_20230920220637

  1. Post LN:
    1. 位置:layer norm在残差链接之后
    2. 缺点:Post LN 在深层的梯度范式逐渐增大,导致使用post-LN的深层transformer容易出现训练不稳定的问题
  2. Pre-LN:
    1. 位置:layer norm在残差链接中
    2. 优点:相比于Post-LN,Pre LN 在深层的梯度范式近似相等,所以使用Pre-LN的深层transformer训练更稳定,可以缓解训练不稳定问题
    3. 缺点:相比于Post-LN,Pre-LN的模型效果略差
  3. Sandwich-LN:
    1. 位置:在pre-LN的基础上,额外插入了一个layer norm
    2. 优点:Cogview用来避免值爆炸的问题
    3. 缺点:训练不稳定,可能会导致训练崩溃。
      微信截图_20230920223020

      Layer normalization 对比篇

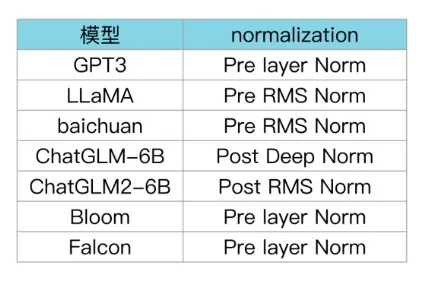
      LLMs 各模型分别用了 哪种 Layer normalization?
      微信截图_20230920224011
      BLOOM在embedding层后添加layer normalization,有利于提升训练稳定性:但可能会带来很大的性能损失

目录
相关文章
|
7天前
|
存储 人工智能 安全
理解 Harness 工程:从 Agent 循环到上下文、沙箱、验证与长时运行
这是一本面向AI工程师的精要手册,系统解析Agent核心机制:从最小循环、工具接口与上下文管理,到沙箱隔离、结果验证及超长时运行架构,直击harness工程本质。(239字)
212 0
|
Shell 网络安全 文件存储
Tailscale:随时随地远程和使用服务器
|
4天前
|
运维 监控 安全
大模型 Agent 面经:沙箱与自进化,这 7 题答出安全思维才算顶尖
本文聚焦Agent自进化沙箱的核心挑战:如何在支持Agent自主改写代码、安装插件、调整配置的同时,严防其“改死自己”——涵盖动态权限管控、四阶插件验证、试错隔离机制、逃逸行为检测、恶意代码防御、权责平衡策略及快照+Revertible Effects双层恢复体系,直击高阶面试关键能力。
75 3
|
3天前
|
机器学习/深度学习 自然语言处理 算法
大模型(LLMs)基础面:相似度函数面试篇
问题不在记性,在于答成了词典。面试官问"除了 cosine 还有哪些",他不想听你把距离公式默写一遍,他想知道你在什么场景下会换掉 cosine,换掉之后踩过什么坑。
40 0
大模型(LLMs)基础面:相似度函数面试篇
|
8天前
|
机器学习/深度学习 中间件 Shell
字节 HarnessDev:当 Agent 开始成为自己的 Harness Engineer
《HarnessDev》论文揭示:Agent能力=模型×执行框架(Harness)。实验表明,LLM已能自主设计、迭代Harness,但易过拟合测试集;Harness与模型深度耦合,换模型需重调整;当前最大短板非“修改力”,而是缺乏评估泛化性的“选择能力”。
86 0
字节 HarnessDev:当 Agent 开始成为自己的 Harness Engineer
|
2天前
|
存储 自然语言处理 测试技术
大模型 Agent 面试高频题:Agent 记忆基础概念
本文用12道高频面试题,系统拆解Agent记忆的**形成—管理—访问**全生命周期,厘清与RAG的本质区别,详解五种记忆形态、四类认知记忆、评测协议及“最终一致”工程实践。拒绝“聊天记录”或“向量库”式误解,直击面试官真正考察的系统思维。(239字)
29 0
|
22天前
|
人工智能 API
深度研究在百炼能力栈里的位置:不是 RAG,也不是搜索摘要
阿里云百炼「深度研究」(qwen-deep-research)是面向专业场景的第三层查资料能力:不依赖私有知识库,也不止于网页摘要,而是通过反问澄清→多步规划→自主检索→结构化成文,交付带章节与引用编号的6909字报告,适用于行业扫盲、方案底稿等任务。(239字)
|
机器学习/深度学习 数据处理
大语言模型中的归一化技术:LayerNorm与RMSNorm的深入研究
本文分析了大规模Transformer架构(如LLama)中归一化技术的关键作用,重点探讨了LayerNorm被RMSNorm替代的原因。归一化通过调整数据量纲保持分布形态不变,提升计算稳定性和收敛速度。LayerNorm通过均值和方差归一化确保数值稳定,适用于序列模型;而RMSNorm仅使用均方根归一化,省略均值计算,降低计算成本并缓解梯度消失问题。RMSNorm在深层网络中表现出更高的训练稳定性和效率,为复杂模型性能提升做出重要贡献。
3974 14
大语言模型中的归一化技术:LayerNorm与RMSNorm的深入研究
|
自然语言处理 关系型数据库 数据库
2017深圳云栖TechInsight活动回顾:创新金融
在本次深圳云栖TechInsight大会上,来自蚂蚁金服和阿里金融云的技术专家们通过创新金融专场,同大家交流分享我们在探索数字普惠金融技术道路上的一些经验和沉淀,抛砖引玉,希望加深互相交流彼此都能有所收获。
3804 0

热门文章

最新文章