
大家开始意识到,决定 Agent 能力的并不只是底层大模型。
ByteDance Seed 等机构发布的论文 《HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?》,把这个问题又往前推了一步。
同一个模型,放进不同的 Agent Loop,配上不同的工具、上下文管理、重试机制、状态保存和验证策略,最后表现可能完全不同。换句话说,真正运行起来的 Agent,更接近于:Model × Harness。
但这篇论文不再只是研究"哪一种 Harness 更好",而是直接问:如果把 Harness 工程本身交给 LLM,它能不能自己设计一个 Agent,然后根据执行结果继续修改自己的 Harness?
答案是:可以,而且已经做得相当不错。不过 LLM 很会修改自己,但却还不太会判断自己是不是真的变强了。
一、LLM 已经开始成为自己的 Harness Engineer
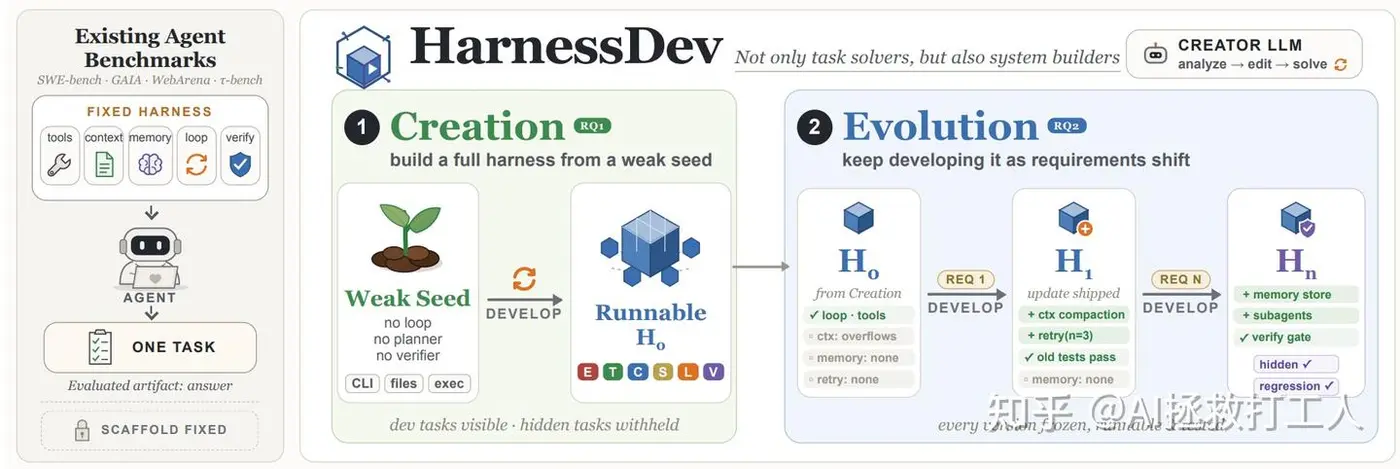
论文先把 Harness 拆成了六部分:Execution、Tools、Context、State、Lifecycle 和 Verification。
换成更容易理解的话,就是一个 Agent 到底如何循环执行、怎样使用工具、上下文怎么组织、状态怎么保存、失败后如何重试,以及最终怎样判断任务是否真的完成。
这基本覆盖了今天一个成熟 Agent Runtime 的核心结构。
研究者没有让模型简单写一份架构设计文档,而是只提供一个非常基础的 Seed,包括命令行、文件操作和 Shell 等原始能力,然后要求 LLM 真正实现一套可以运行的 Harness。
Agent Loop 怎么设计,是否需要 Planner,Context 太长以后怎么办,什么时候 Retry,什么时候停止,要不要做 Memory,最终结果怎么验证,全部由模型自己决定。
研究覆盖 SWE-bench Pro、Terminal-Bench、MLE-bench、EQ-Bench3 和 BrowseComp 等多个任务,共 2207 个测试样本。
结果证明,前沿模型已经具备相当强的 Harness Engineering 能力。
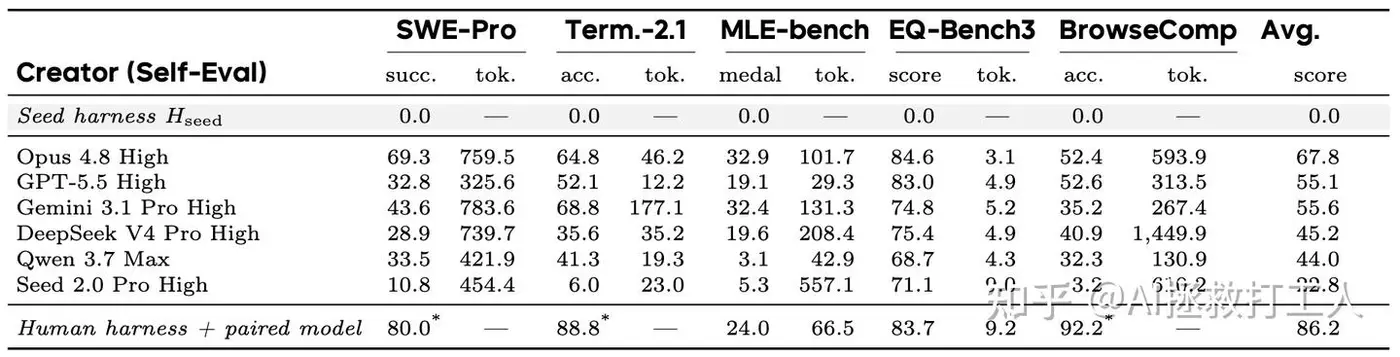
其中 Opus 4.8 自己生成的 Harness,在 Writing 和部分机器学习实验任务上已经可以达到甚至超过人工参考 Harness;但在 Coding、Terminal 和 Search 这类长链路任务上,与成熟的人工 Harness 仍然存在明显差距。
这个差异本身就很值得注意。
写作任务通常是从输入到输出的相对直接映射,但 Coding 和 Search 的过程更像一个不断反馈的闭环:搜索信息、判断质量、发现缺口、继续搜索;或者阅读代码、定位问题、修改、执行测试、读取错误、继续修改。
任务越依赖中间状态和环境反馈,Harness 本身就越重要。
所以很多时候,我们所谓的"模型不够聪明",实际上可能是执行系统没有把模型能力正确释放出来。
二、Harness 并不是一个真正 Model-Agnostic 的中间件
论文里我认为重要的发现,并不是 LLM 可以自己写 Harness,而是另一个更容易被忽略的问题:Harness 和 Model 之间存在明显的耦合。
研究者做了两种测试。
第一种叫 Self-Eval,也就是哪个模型写出的 Harness,就继续由哪个模型作为 Runtime 来执行。
第二种则把所有 Harness 的 Runtime Model 统一替换成 Gemini 3.1 Pro,再测试一次。
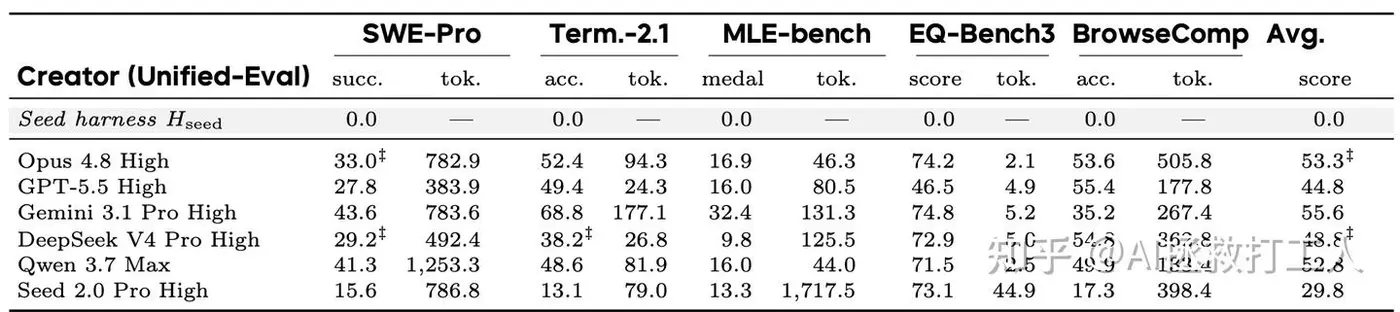
理论上,如果 Harness 真的是一套与模型无关的通用工程框架,那么换一个能力相近甚至更强的模型,不应该出现特别大的性能变化。
但结果并非如此。例如 Opus 自己构建的 SWE-Pro Harness,在自己的 Runtime 上得分达到 69.3,换成 Gemini 后却下降到了 33.0。
另一个搜索任务中,某套 Harness 使用 Opus 时重复搜索率只有 10.1%,换成 Gemini 后却飙升到了 88.2%。
Harness 里的去重、停止条件、Review 机制和上下文策略,在设计过程中已经不知不觉适应了原模型的行为模式。
这意味着,在真实企业系统里,"换模型"很可能并不是把 API Endpoint 从 Claude 换成 DeepSeek、Qwen 或 GLM 就结束了。
你可能还要重新调整 Context Strategy、Tool Protocol、Max Steps、Retry、Stop Condition、Verification 甚至 Prompt。
真正应该被评测的单位,很可能从来就不是单独的 Model,而是 Model × Harness。
三、一个发现:模型喜欢写 Memory,但基本不用
论文里还有一个特别有意思的实验结果。
模型在设计 Harness 时,非常喜欢增加各种看起来"高级"的架构组件。
例如在 18 个 Coding Harness 中,11 个实现了 State Class,看起来已经具备状态管理能力。
但真正实现 State Saving 的只有 1 个,真正实现 Periodic Checkpoint 的也只有 1 个。
更夸张的是,在研究者分析的 26679 条真实执行轨迹中,一次 Checkpoint Event 都没有发生。
也就是说,代码里虽然存在 Memory、State、Checkpoint 等模块,但 Agent 的真实执行路径根本没有使用它们。
这是一个非常典型的 Agent 工程问题:Architecture exists,不代表 Mechanism works。
今天很多 Agent 产品介绍都会列出类似的 Feature Checklist:有 Memory、有 Planner、有 Reflection、有 Verifier、有 Retry。
但真正应该问的是:
- Memory 在什么条件下被调用?
- 调用之后有没有改变行为?
- Checkpoint 在失败时有没有恢复?
- Verifier 有没有真的拦截错误结果?
- 这些机制到底给成功率贡献了多少?
对于 Harness 来说,静态架构检查的意义越来越有限。
真正有价值的,是 Runtime Evidence。
四、最精彩的部分,是让 Agent 自己"进化"
论文真正激进的实验出现在第二阶段:Evolution。
研究者首先让模型创建 Harness,然后不断让它运行 Benchmark、观察失败、修改 Harness,再重新测试。
模型可以修改 Agent Loop、Context Compression、Retry、Tool、Recovery、State、Memory、Verification 等任意组件。
这已经非常接近今天大家想象中的 Self-Improving Agent:
Agent 执行任务,发现自己的问题,然后修改自己的执行系统,下一轮变得更强。
从可见测试集来看,效果非常漂亮。
Qwen 的 Harness 从 41.8 提升到 55.7,增加了 13.9 分;DeepSeek 从 47.2 提升到 60.6;Gemini 也从 59.9 提升到了 68.7。
如果实验做到这里,很容易得到一个很令人兴奋的结论:Self-Evolving Agent 已经来了。
但作者随后拿出了一个模型无法看到的 Held-out Test,故事立刻变了。
Qwen 在可见 Feedback 上提升 13.9 分,在隐藏测试集上只提高 1.43 分;DeepSeek 的 13.4 分变成了 3.17;Gemini 的 8.8 分也只剩 2.7。
当研究者进一步把 Runtime Model 换掉以后,甚至开始出现负优化。
模型明明不断看到 Benchmark Score 上升,却并没有真正学到更加通用的 Harness,它只是越来越适应眼前的反馈环境。
五、Self-Improving Agent 最大的问题,可能不是"Improve"
论文中有一个数字,研究者统计 64 次 Harness 版本更新后发现:Feedback Score 和 Held-out Score 只有 53.1% 的时候会朝同一个方向变化。差不多相当于抛硬币。
模型认为自己在变好,但放到真正看不见的数据里,这种判断接近随机。
更进一步,当模型自己决定"哪一个版本是我最好的 Harness"时,9 次实验里只有 2 次真正选中了 Held-out 表现最好的版本。
这揭示出了 Self-Improving Agent 中一个容易被忽略的问题。
我们通常把自我进化想象成:执行 → 反思 → 修改 → 变强。
但现实可能更接近:执行 → 获得局部反馈 → 修改 Harness → 当前分数提高 → 对当前环境过拟合 → 换任务以后性能下降。
Self-Improving Agent 最大的问题可能从来不是模型有没有能力修改自己,而是缺少一种更重要的能力:Selection Capability。
也就是它必须知道,哪些变化是真正提高了自己的通用能力,哪些只是让自己在眼前这几个 Case 上表现得更好。
六、Agent 可以提出改变,但不应该自己决定什么能够留下
未来所谓的 Self-Evolving Agent,不应该是一个可以随时修改 Prompt、Skill、Tool 和 Agent Loop,然后直接部署到生产环境中的 Agent。
它反而应该越来越像软件工程里的 CI/CD。
一次经验首先产生 Candidate Change,然后经过 Regression Eval、Protected Held-out Test、Executor Swap、成本评估和 Canary,最终才能决定 Promote 还是 Rollback。
也就是说:Agent 可以负责提出修改,但最好不要拥有"批准自己修改"的最终权力。
模型非常擅长想:
- "是不是再加一个 Tool?"
- "是不是 Loop 再多跑几轮?"
- "是不是调整一下 Context?"
但它很少主动追问另一个更加根本的问题:我用来判断自己是否变好的 Evaluation,本身靠谱吗?
七、从 Harness 到 Self-Evolving Runtime
如果说过去两年 Agent 的核心讨论是 Planner、Memory、Multi-Agent 和 Tool Calling,那么 HarnessDev 代表了一个明显的新阶段。
我们开始不再把 Harness 视为模型外面的一层固定胶水代码,而是把它当成 Agent 能力本身的一部分。
甚至下一步,它还可能成为一个能够由 Agent 自己持续修改的软件系统。
但这篇论文同时提醒我们:"能够修改自己"和"能够持续进化"之间,还有一道很宽的鸿沟。
现在的前沿模型已经表现出了不错的 Creation Capability,也具备初步的 Evolution Capability。
真正不足的是 Selection Capability。
哪个版本值得保留,哪个机制真的提高了能力,哪个优化只是针对当前 Benchmark 的过拟合,这些问题最终都指向同一个基础设施:Trace → Eval → Version → Rollback。
我越来越觉得,下一代 Agent Harness 最重要的组件,未必是再增加一个 Planner,再做一种 Memory,或者堆更多 Multi-Agent。
反而可能是四个看起来非常"传统软件工程"的东西:可观测、可评测、可版本化、可回滚。
HarnessDev 真正有价值的地方,也正在这里。它证明了 Agent 已经开始能够成为自己的 Harness Engineer。
但未来真正稀缺的,不是一个会不断改变自己的 Agent,而是一个知道哪些改变值得留下的 Agent。
