
本文是对 arXiv:2506.23749v3(ACM TOSEM)A Survey of LLM-based Software Repair: Taxonomies, Design Paradigms, and Applications 的精读笔记。原论文把 66 个「用大语言模型做软件修复」的系统按「修复能力与控制权落在哪里」分成四类,并对全领域做了一次评估协议层面的可比性审计。核心结论很硬:66 个系统两两配对共 2145 对,只有 1 对真正可比,因此「哪个范式更强」在当前证据下是一个无法回答的问题。
读前先问(综述版)
带着问题读综述,读完后把答案整理成结构化总结。后文已详细回答的,这里只留结论。
- 这是一篇什么类型的综述? 系统性文献综述(systematic survey):先把检索与筛选方案写死,再按方案把文献找全、筛干净、逐篇编码,每一步都留痕、别人可复算;不是「我读过很多论文所以我来总结」的叙述性综述。它借了两套现成方法:
- GQM(Goal–Question–Metric,目标—问题—度量):先声明「我要回答哪几个研究问题」,再规定「每个问题用哪些可统计的字段来回答」,防止想到哪写到哪。
- Kitchenham 系统综述流程:软件工程领域公认的综述标准做法(由 Barbara Kitchenham 提出)——定方案 → 多库检索 → 按纳排标准筛选 → 逐篇抽取字段 → 汇总,并把每一步的数字记录下来,别人能照着重算。
- 另加反向引文滚雪球:沿已收录论文的参考文献往回追,补上关键词检索漏掉的文献。
- 范围与时间窗? 2022 年 1 月 – 2026 年 4 月;主要收软件工程(SE)、人工智能与自然语言处理(AI-NLP)、安全(Security)三块的顶会顶刊,最终 66 个系统。这里的「顶会顶刊」用的是 CCF-A 类这个口径——中国计算机学会推荐的 A 类会议与期刊,是国内外最常用的一把「什么算顶会」的可复现尺子。
它要解决前人留下的哪三个 gap? ① 没有把微调 / 提示 / 流程 / 智能体当成一等范式;② 没有把检索与程序分析当作可叠加的证据层;③ 前人只汇总技术与分数,没有做协议级可比性审计。后文第三章对应 gap 1、第四章对应 gap 2、第五章对应 gap 3。
但先记住一个前提:这三条都默认「这 66 个系统在做同一个任务」,而论文从头到尾没有给出 program repair 的任务定义——输入输出是什么、改的粒度是函数 / 文件还是整个仓库、是否包含故障定位,全都没写。这是它最大的裂缝,见第零章。
分类法的判据是什么? 一条 primary-locus rule(主落点规则):先看修复能力是否主要来自参数适配,再看修复循环由谁控制。
- 它的「实验结果」是什么? 三类发现:四类范式各自的设计要点与四轴权衡;五类辅助证据在语料里怎么分布;三个有界可比窗口 + 一套评估可靠性风险编码。
- 对实践有什么指导? 四类做法在任务对齐、部署成本、可控性、多 hunk(一次要改多处代码块)/ 跨文件修复上的权衡,以及五类开放挑战。
- 读完最该记住的一句质疑是什么?「输入输出都不一样,为什么要放在同一个框架里讨论?」——这是 2026-10-20 讨论会上对这篇综述最核心的批评,也是下面第零章存在的理由。
术语表(读之前先扫一眼)
| 术语 | 一句话解释 |
|---|---|
| 范式 paradigm | 一类系统的「做法类型」。本文只按两件事分:修复能力主要落在哪、修复循环由谁控制。 |
| 微调式 / 提示式 / 流程式 / 智能体式 | 四类做法,判定顺序见 3.1 节的四个问题,各类数量见 3.2 节。 |
| 基准 benchmark | 用来考算法的标准题库,如 Defects4J(Java 缺陷)、SWE-bench(真实仓库 issue)。 |
| 基准变体 variant | 同一题库的不同「用法」:只取子集、只改单函数、换过滤条件等。名字相同 ≠ 考的内容相同。 |
| pass@k | 给系统 k 次机会,只要有 1 次通过就算成功。k 越大分数越好看,所以必须同一个 k 才能比。 |
| 基模型 base model | 系统底层用的大模型(如 GPT-4、CodeLlama-13B)。同样的方法换个模型,分数就变了。 |
| 归一化基模型 | 把各论文里五花八门的模型写法(「CodeLlama-13B-Instruct」、「codellama/CodeLlama-13b-hf」……)折算成一个统一标签,再判断两边是不是同一族、同一规模。 |
| 故障定位 FL | 先找出 bug 在哪一行 / 哪个函数。很多论文直接假设「位置已知」,这类分数只反映写补丁的能力,不是端到端成功率。 |
| oracle | 判定补丁对错的依据,修复任务里通常就是单元测试是否通过。测试越弱,「通过」越不等于「修对」。 |
| hunk | 一段连续的代码改动块。多 hunk = 一次要改好几处,难度远高于单点修改。 |
| 辅助证据层 | 检索、程序分析、测试反馈、人工反馈、领域知识这五类信息。它们不改变范式归属,可以叠加在任何一类上。 |
| 检索增强(RAG) | 先从外部库检索相关代码 / 文档 / 历史修复,再塞进提示里给模型看。 |
| 协议对齐窗口 | 一组「同一基准变体 + 同一指标与候选预算」的结果。只有落进同一个窗口的结果,才有资格互相比。 |
| 模型受控 model-controlled | 在协议对齐之上再对齐基模型(同族同规模)与定位 / 判定假设,这时两边才算「只差方法、其余条件相同」。 |
| 同族快照组 | 同一个大基准家族下、但协议对不齐的那些结果。只能用来观察「同一个基准里的口径有多碎」,不参与排名。 |
| 系统对(配对) | 把两个系统的结果配成一对来比。66 个系统两两配对 = 66×65÷2 = 2145 对。 |
| Cohen's κ | 衡量两人判断一致程度的统计量,会扣掉「碰巧一致」的部分,比单纯算一致率严格。 |
| 任务定义(圈地) | program repair 的输入 = 故障代码 + 上下文,输出 = 修复后的代码。用它来检查「这些系统到底是不是在解同一道题」。 |
| 任务粒度 | 改动作用的范围:函数级 / 文件级 / 仓库级。粒度不同,输入规模与难度都不同。语料 66 个系统里真正做仓库级的只有 13 个。 |
| 已知 / 未知故障位置 | 是否事先告诉模型 bug 在哪。已知位置只考「写补丁」,未知位置考「定位 + 修复」,属于两个子任务(语料 10/66 假设完美定位)。 |
| 控制变量对比 | 只让一个因素不同(例如同骨架下一个多了沙箱、一个多了联网搜索),这样比出来的差距才能归因到那个因素上。 |
再补一个表里没列的高频词:artifact = 论文配套发布的可复现材料包,包含代码、数据、脚本与抽取结果。
综述画像
- 标题:A Survey of LLM-based Software Repair: Taxonomies, Design Paradigms, and Applications
- 版本:arXiv:2506.23749 v3(2026-08-27),期刊版 ACM TOSEM
- 作者:Boyang Yang、Zijian Cai(燕山大学)、Fengling Liu(中国矿业大学)、Xuan Bach D. Le(墨尔本大学)、Lingming Zhang(UIUC)、Tegawendé F. Bissyandé(卢森堡大学 SnT)、Yang Liu(南洋理工)、Haoye Tian(阿尔托大学,通讯作者)
- 语料:66 个 LLM 修复系统,时间窗 2022-01 – 2026-04
- 方法:GQM 目标定义 + Kitchenham 系统综述流程 + 反向引文滚雪球 + 双人独立编码与一致性审计
- 产物:GLEAM-Lab/ProgramRepair(MIT,脚本化检索 / 筛选 / 编码流水线 + 全部抽取元数据)
- 一句话定位:不是又一个「谁分数高」的排行榜,而是对「谁跟谁其实没法比」的一次清算。
版本坑(重要):v1(2025-06)标题是 LLM-based Automated Program Repair、语料 62 个系统;v3 已扩到 66 个系统、改名为 Software Repair、并把分类规则重写为「主落点规则」。网上大量二手解读(各类论文速读站、Emergent Mind 等)仍停留在 62 系统的 v1/v2,数字与范式归属都对不上。读之前务必确认版本。
零、先把任务定义钉死(圈地)
这块是读这篇综述之前必须自己补上的——论文自己没给。2026-10-20 与黄晨讨论后补入,标注为读者补充,非论文内容。
讨论会上对齐出来的定义只有一句:program repair 的输入 = 故障代码 + 上下文,输出 = 修复后的代码。
但只写这一句不够,往下拆会立刻分出三个必须声明、而论文恰恰全都没声明的维度:
- 作用粒度:改的是单个函数、单个文件,还是整个仓库?语料里大部分工作仍停留在单函数 / 单文件这种「局部」,真正做仓库级(给你一个完整仓库 + 一个问题,自己去改)的只有 13 个(见 3.2)。
- 是否包含故障定位:有的方法一开始就被告知 bug 在哪一行 / 哪个文件,有的要自己先定位再修。这两类考的能力根本不同——前者只考「写补丁」,后者考「定位 + 修复」。语料里 10/66 假设完美定位(见 5.5)。
- 输入里额外带了什么:是否额外喂了检索结果、编译器输出、测试反馈、人工反馈、领域知识——也就是第四章那五类证据。
为什么必须先圈这块地:输入输出不同 = 不同的子任务。不同子任务的系统放在一起排名、放在一起说「这类范式更强」,结论就不成立。会上最直接的质疑是——「输入输出都不一样,为什么要放在同一个框架里讨论?」
论文把「是否已知故障位置」当成评估协议的一个假设字段来对齐(5.2 第 4 卡),但它本质上不是协议细节,而是任务本身的分野:知道了位置考的是补丁生成,不知道位置考的是定位加修复,这是两道题。同理,「收窄到单函数」也会把一道仓库级题变成一道函数级题。
一句话:这篇综述先分了方法,再统计了输入,唯独没先定义任务。后面三章的所有结论,都要带着「任务边界没划清」这个前提去读——把范式与证据分类当现状地图,把任何跨系统的强弱结论当待验证假设,只有 Gap 3 的协议审计是可以直接引用的。
一、为什么要再写一篇综述
作者把前人不足归纳成三条,这三条也正对应本文的三条贡献:
- Gap 1|范式不成体系。 已有综述按「使用方式」(怎么用 LLM)或「修复场景」(修什么 bug)组织,没有把微调、提示、流程、智能体当成由「修复能力落在哪 + 控制权在谁手里」定义的一等范式(一等范式 = 直接当一级分类用,而不是挂在别人底下的附属标签)。
- Gap 2|证据层被埋没。 检索增强(RAG:先从外部库检索相关代码、文档或历史修复,再塞进提示里)、程序分析证据(AAG:把编译器诊断、故障定位分数、约束等分析结果喂给模型)、测试反馈、人工反馈、领域知识,在前人工作里要么被当成独立范式、要么被忽略;本文主张它们是可叠加到任何范式上的正交标签(正交 = 互不排斥,可以同时具备)。
- Gap 3|协议层面没人管。 前人只汇总技术、基准与头条分数,但同一个基准名底下可能藏着不同的基准变体、基模型、pass@k 预算、故障定位假设、oracle 强度与污染控制,跨论文比分数在多数情况下是无效的。
点评:Gap 3 是这篇综述真正的价值所在。前两条属于「整理得更好」,第三条属于「指出整个领域的比较方式有问题」——这类贡献才撑得起 TOSEM。
再尖锐一点:Gap 1 的分类「可以这样分,但分出来没意义」。按「修复能力落在哪 + 控制权在谁手里」把 66 个系统分成四类,技术维度上没毛病;但分类的前提是这些系统在解同一道题,而论文没定义任务(见第零章)。任务层面没控制住,分类再整齐也推不出「哪一类更强」——它能告诉你的只有「这个领域长什么样」,不能告诉你「该选哪一类」。Gap 2 反而不同:五类证据本质都是「给大模型的输入」,是全文唯一天然适合做控制变量对比的一层(见 4.5)。
作者还点名比较了 12 篇前人综述(Table 1),其中与本文最像的是 Zhang et al. 2026(同样 TOSEM),但那篇按「LLM 使用方式 + 修复场景」组织,而本文用全语料统一的主落点规则,并把适配、控制、证据编码成独立维度。
二、论文从哪来:检索、筛选与编码
综述没有自己的实验台,可信度全靠「文献是怎么挑出来的」。一句话讲完:从 ACM DL、IEEE Xplore、DBLP、arXiv 四个库检索,关键词是「修复术语 × 模型名 × 基准名 × 工具名」四类交叉,只收 2022-01 至 2026-04 的 CCF-A 类会议与期刊(CCF-A = 中国计算机学会推荐的 A 类,最常用的一把「什么算顶会」的尺子),再用反向引文滚雪球补漏,逐篇人工全文筛选,最后留下 66 个系统。
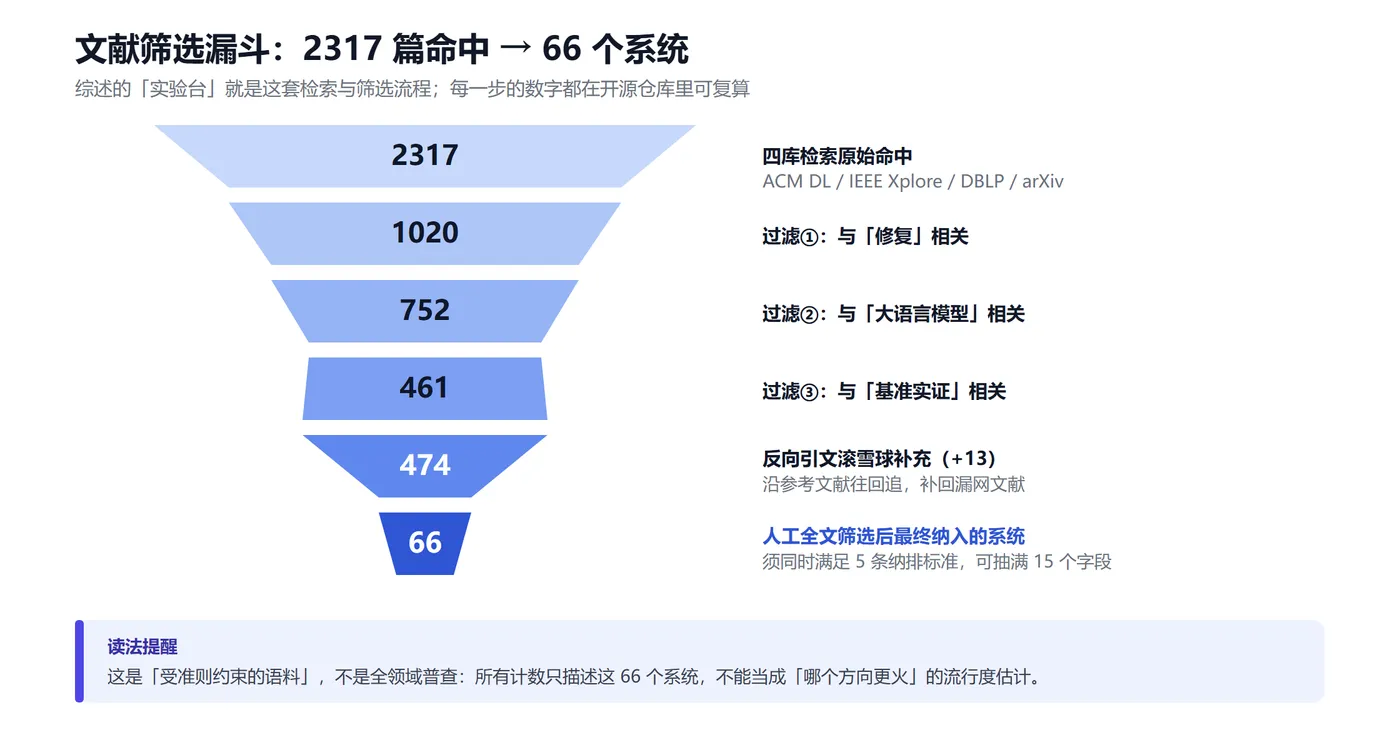
注意:作者反复强调这是 criteria-bounded corpus(受准则约束的语料),不是全领域普查。所有计数只能描述这个语料,不能当成领域流行度估计——这一点作者自己在 11.2 节外部效度里也承认了。
留下要同时满足三条:① 主贡献是修复,且包含具体修复任务(不能只做检测、定位或代码理解);② 推理时 LLM 是修复流水线里的实质角色(生成、排序、评审或编排多步修复),而不是只用来造数据、标注或写评语;③ 在可复现基准上有量化结果。
编码:两位作者先在一批「代表性 + 边界性」论文上校准,提炼出编码簿,再各自独立重编码。一致性:主范式标签 65/66、控制子类型 64/66、检索与分析场景标签 66/66。
三、Gap 1|范式不成体系:一条「主落点规则」把 66 个系统分成四类
这一章回答第一个 gap。顺序是:先说分类规则(3.1)→ 再说 66 个系统在这套规则下怎么分布(3.2)→ 四类各自长什么样(3.3)→ 它们之间怎么权衡(3.4)。
3.1 分类规则:按顺序问四个问题,第一个答「是」就定类
分类不是靠感觉,而是有序判定的一条规则:
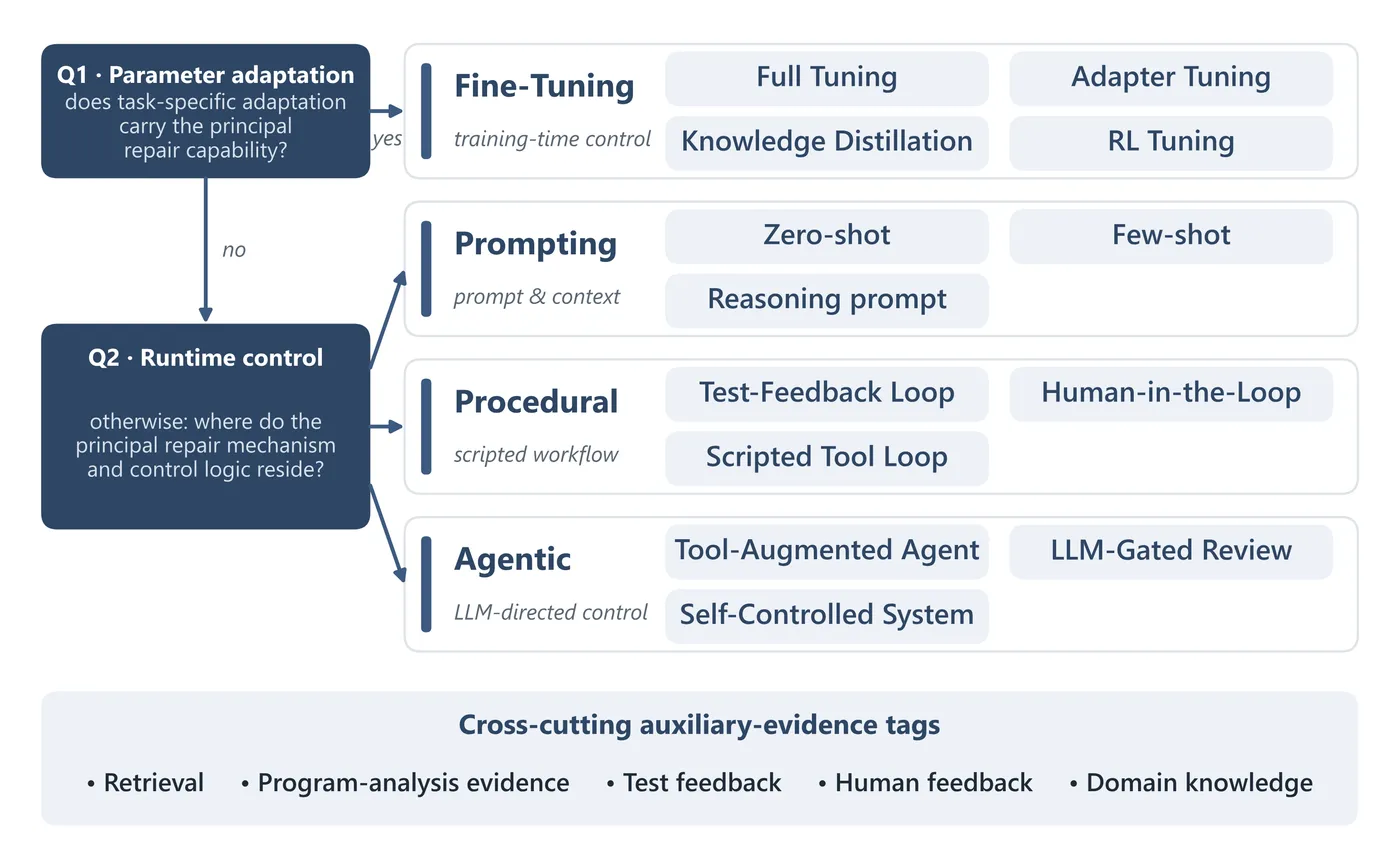
第 1 问:修复能力是否主要来自「为这个任务调过的模型参数」?换句话说:论文主打的分数(头条结果 = 论文在标题、摘要里重点宣传的那个数字,不是系统输出的第一个结果),是不是靠这些调过的参数才拿到的?
- 是 → 微调式(Fine-Tuning)(含全量微调 / 适配器微调 Adapter-PEFT / 知识蒸馏 / 强化学习微调)。注意:仅仅在一个更大的工作流里调用一个微调过的模型存档(checkpoint),不足以算微调式。
第 2 问(其余系统):提示与上下文是否承载主要修复机制,且既没有设计者指定的多阶段轨迹、也没有 LLM 导向的控制器?
- 是 → 提示式(Prompting)(零样本 Zero-shot / 少样本 Few-shot;思维链这类推理提示只记为提示的一个属性,不单列子类型)。
第 3 问:设计者指定的工作流是否承载主要运行时控制?(阶段顺序、可用工具、重试策略、停止预算都被写死,即使阶段内部 LLM 在做诊断、打补丁或有界评审)
- 是 → 流程式(Procedural)(测试反馈循环 / 人在环 / 脚本化工具循环)。
第 4 问:LLM 导向的动作 / 工具选择、分支、再生成或终止,是否是主要运行时控制器?
- 是 → 智能体式(Agentic)(工具增强智能体 / 模型门控评审 / 自控制系统)。
最反直觉的一条:Agentless、ChatRepair、Repilot 在「使用方式」上都可以被描述为 zero-shot 或 few-shot,但在本规则下全部归为流程式,因为设计者写死的编排承载了它们的主要修复逻辑。「用了几次 LLM」不等于「谁在控制修复循环」——这正是本文要纠正的行业习惯说法。反过来说,SWE-RL 外形是个智能体式流水线,但分数来自被调过的参数,所以算微调式:范式归属看能力来源,不看系统外形。
3.2 这份语料里,66 个系统怎么分布
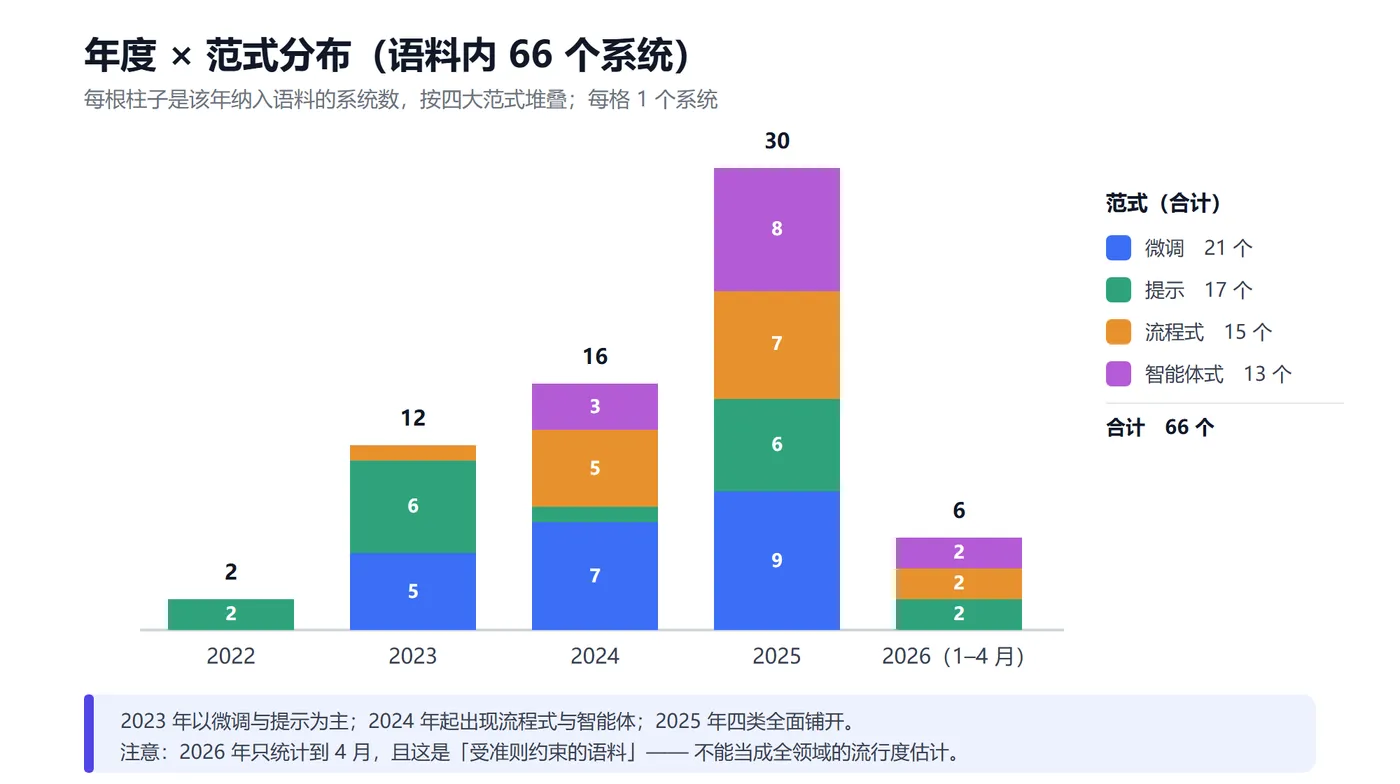
- 2022:微调 0 / 提示 2 / 流程 0 / 智能体 0 → 合计 2
- 2023:5 / 6 / 1 / 0 → 12
- 2024:7 / 1 / 5 / 3 → 16
- 2025:9 / 6 / 7 / 8 → 30
- 2026(1–4 月):0 / 2 / 2 / 2 → 6
- 合计:21 / 17 / 15 / 13 → 66
读法:2023 年以微调与提示为主;2024 年开始出现流程式与智能体;2025 年四类同时铺开。这是语料描述,不是领域流行度——2026 只统计到 4 月,语料边界本身也会影响分布。
按部署场景看(原文 Table 9):本地化基准修复 39 个(微调 17 / 提示 13 / 流程 6 / 智能体 3)、仓库级 issue 13 个(1 / 1 / 3 / 8)、漏洞修复 10 个(3 / 3 / 3 / 1)、工业流程 3 个、教学辅导 1 个。一句话:语料主体仍是「小范围基准上修 bug」;仓库级任务集中在流程式与智能体式——因为它们能搜文件、取上下文、跑工具、多步验证。
3.3 四大范式逐个看
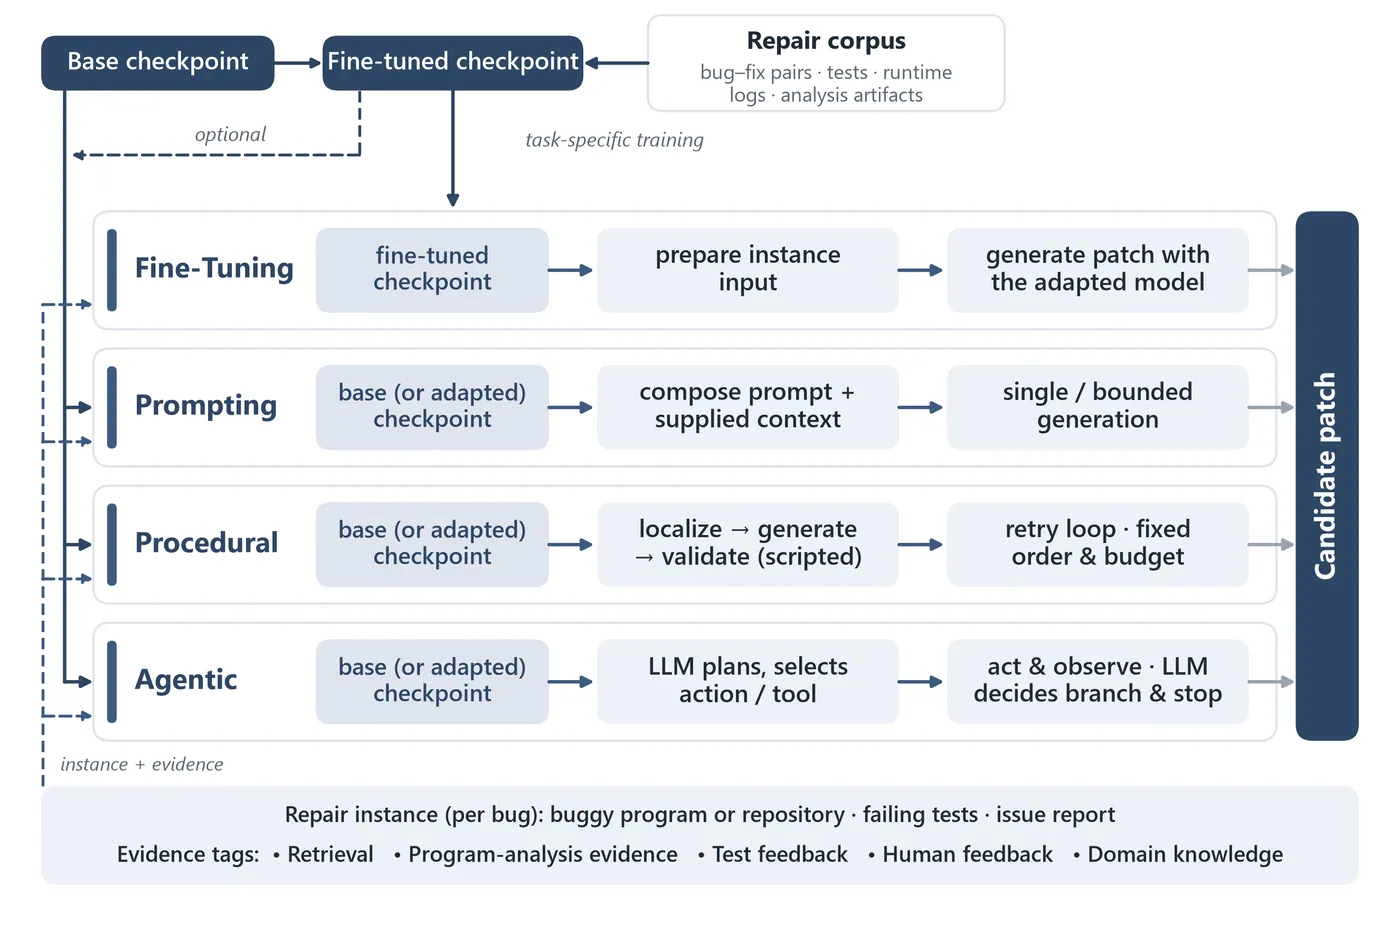
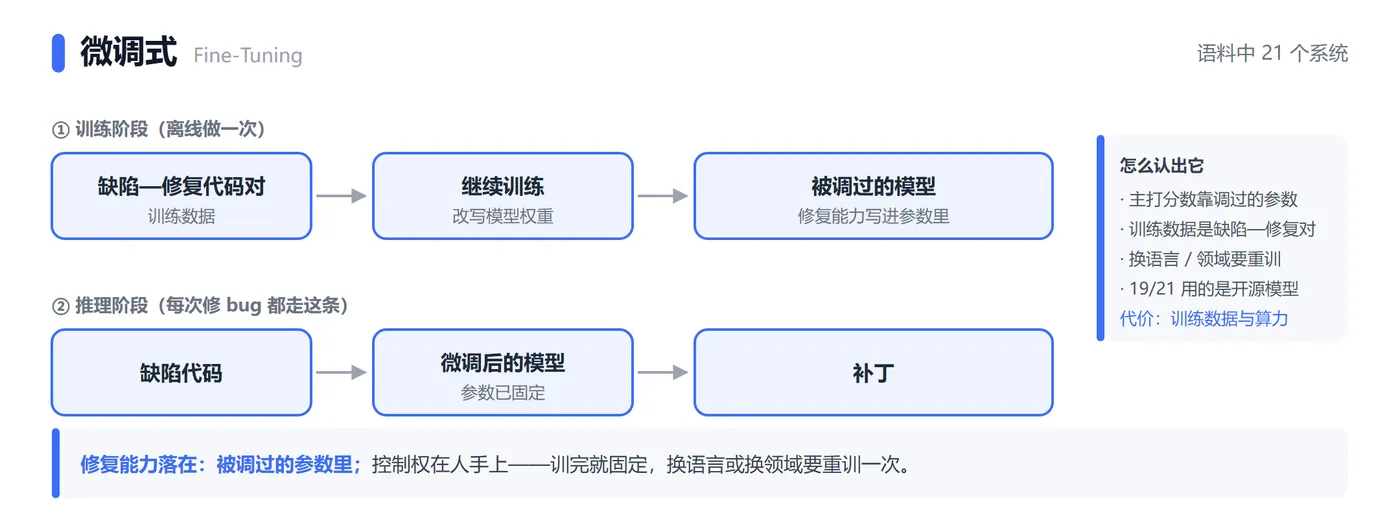
微调式(Fine-Tuning,21 个):用「缺陷—修复」代码对继续训练模型权重(bug-fix 数据 = 修好前后的代码对)。四条路线——全量微调(精度强、成本高)、PEFT/LoRA(冻结主干训小适配器,成本大幅下降)、知识蒸馏(大模型或小模型互蒸,降推理延迟)、RL 微调(用执行 / 安全奖励优化,直接对齐「能不能跑通」而非「像不像正确代码」,代表:SWE-RL、SecRepair、Vul-R2)。另有部分系统把静态分析结果、执行轨迹、检索补丁或模板提示注入训练输入,记为辅助证据。
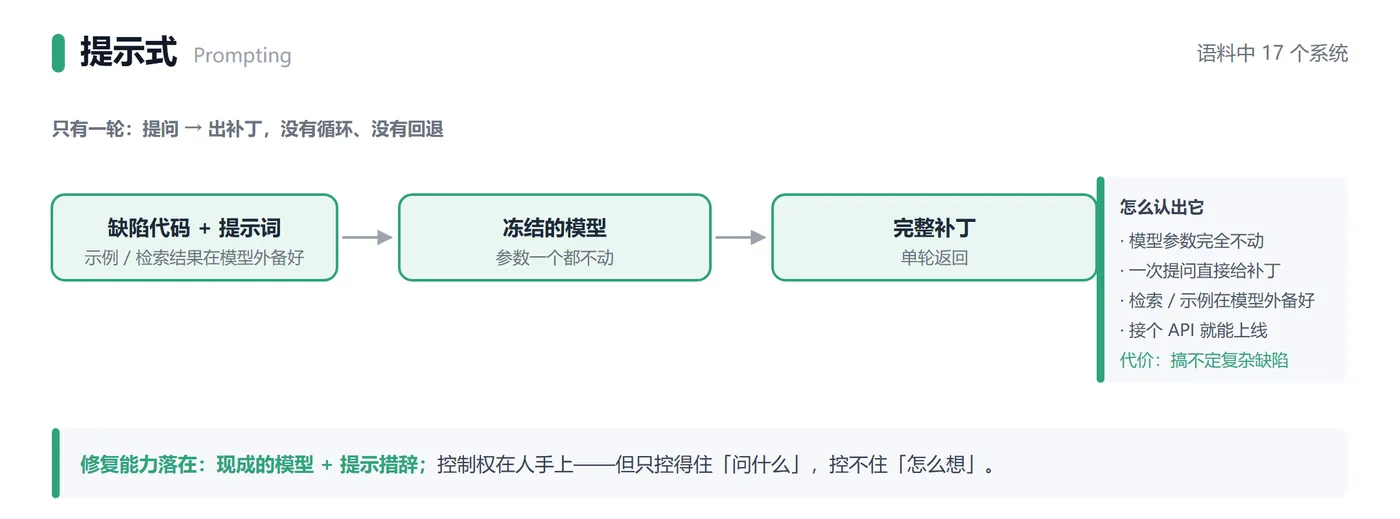
提示式(Prompting,17 个):模型冻结,单次查询返回完整补丁,检索 / 示例整理 / 验证全在模型外。Zero-shot 只给缺陷代码 + 一句修复指令;Few-shot 前面挂若干 bug-fix 示例对;检索增强型挂外部代码片段、模板或知识图谱事实;分析增强型注入失败测试日志或语义切片。共同点是单轮交互,差异在准备成本、token 预算与修复精度之间的取舍。
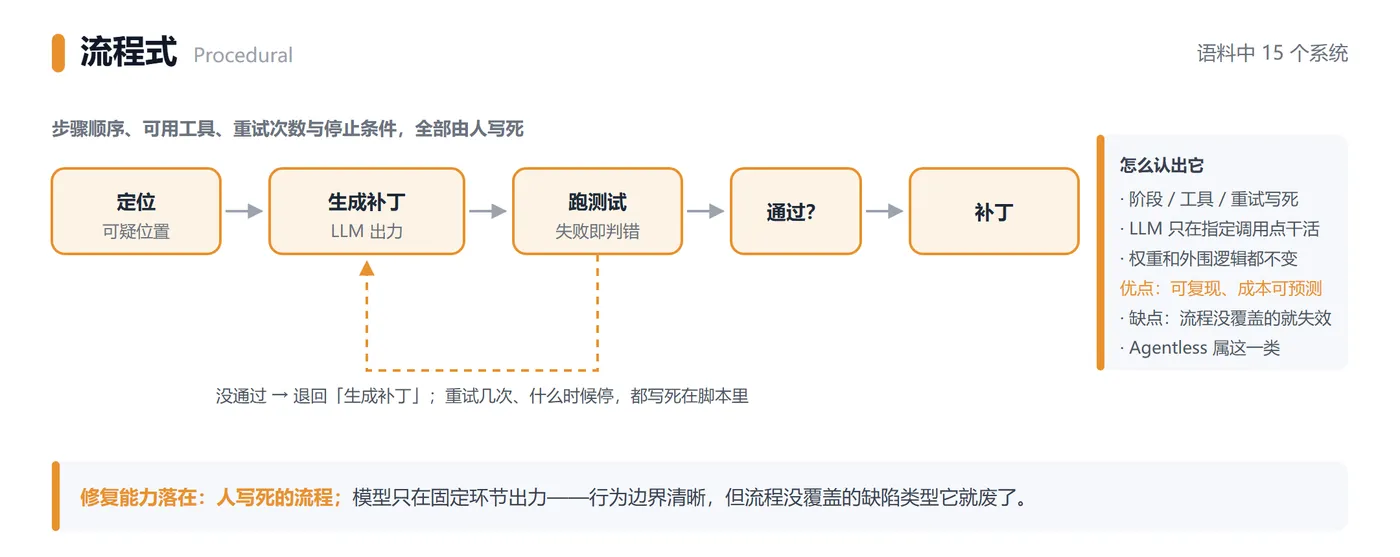
流程式(Procedural,15 个):修复被写成一个固定流水线,LLM 只在脚本指定的调用点执行,权重和外围逻辑都不变。四类驱动源——测试反馈循环(生成 ↔ 单元测试交替,失败即 oracle,代表 ChatRepair)、人在环(开发者提示 / 计划 / 评审插入循环)、检索增强脚本循环(静态规则取证据插在调用之间,代表 Agentless)、分析增强脚本循环(调编译器、调试器、安全分析器,代表 SAN2PATCH、PredicateFix)。优点是可复现、成本可预测。
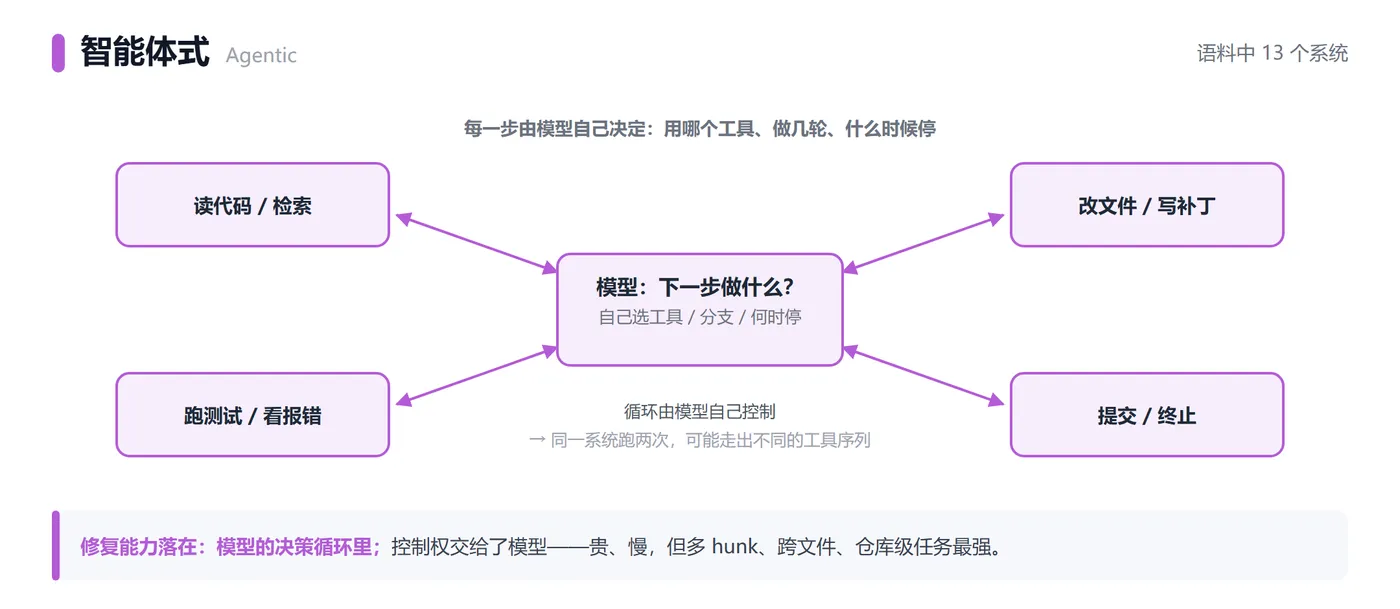
智能体式(Agentic,13 个):把「下一步做什么」交给模型。三个自主层级——工具增强智能体(固定 perceive-think-act 骨架内由 LLM 选工具,代表 SWE-agent、AutoCodeRover、RepairAgent、OpenHands)、LLM 门控评审(生成与评估分离,评审模型决定候选 / 分支去留,代表 SpecRover)、自控制系统(一个或多个 LLM 掌握规划、分派与终止,代表 MAGIS、SWE-Search)。
3.4 范式权衡(本文对实践最直接的输出)
作者沿四个轴比较:任务对齐(task alignment)、部署成本、可控性、多 hunk / 跨文件修复能力。按语料证据归纳如下:
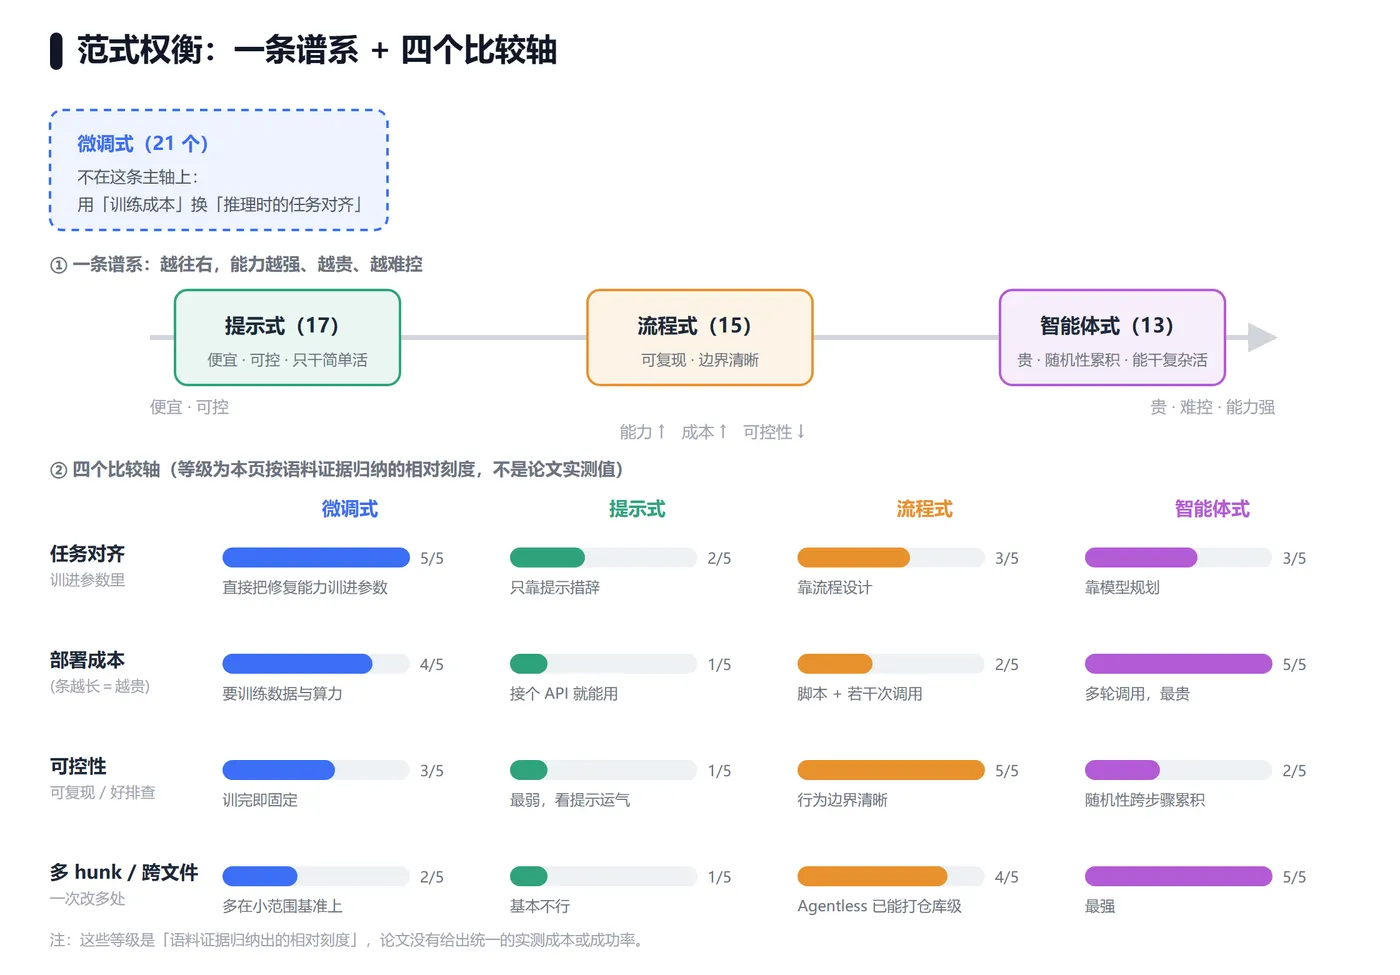
- 微调式:任务对齐最强(直接把修复能力训进参数),单次推理成本可控;但需要训练数据与算力,换领域 / 换语言就得重训,且对仓库级多文件修改帮助有限(多数微调系统仍在小范围基准上评估)。语料里 19/21 个微调系统用开源 / 学术模型——这既是成本优势也是能力上限。
- 提示式:部署成本最低、最容易接入;但可控性最弱、对复杂缺陷几乎无能为力,且高度依赖提示措辞。适合「小而明确」的缺陷。
- 流程式:可复现性与成本可预测性最好,行为边界清晰,出问题好排查;但泛化能力受限于设计者写死的流程,遇到流程没覆盖的缺陷类型就失效。Agentless 的成功说明「写死的定位—修复—验证三段式」在仓库级任务上依然极有竞争力。
- 智能体式:多 hunk、跨文件、仓库级任务能力最强,能动态规划;但成本与延迟最高(每次修复多轮 LLM 调用),且随机性会在步骤间累积,同一系统两次运行可能走不同工具序列、得到不同结果。
一句话:越往右(智能体式)能力越强、越不可控、越贵;越往左(提示式)越便宜、越可控、越只能干简单活。微调式是个特殊分支——它不在这条轴的延长线上,而是用「训练成本」换「推理时的任务对齐」。
把这张权衡表变成一条决策规则(工程判断,不是论文结论):先看修复流程是否固定。
- 路径清晰、可枚举的场景(例如网络配置、协议类问题,排查路径基本固定)→ 流程式更划算:成本可预测、可复现、出问题好排查;
- 探索性强、路径未知、要跨文件改多处(例如仓库级 issue)→ 智能体式更合适:能动态规划,代价是成本与随机性;
- 小而明确的缺陷、追求最快接入 → 提示式;
- 有充足「缺陷—修复」数据且场景稳定 → 微调式,但换领域 / 换语言就得重训。
也就是说:不是「越往右越好」,而是「流程越固定越该往左」——在流程已知的场景里硬上智能体,多花的成本换不来等价的收益。注意这条规则是工程判断,论文只统计了分布,没有做可比实验(见 5.4)。
四、Gap 2|证据层被埋没:五类可以叠在任意范式上的辅助证据
这一章回答第二个 gap。前人要么把「检索增强」当成一个独立范式,要么干脆不提;作者的主张是:它们是标签,不是门类。
4.1 五类证据分别是什么
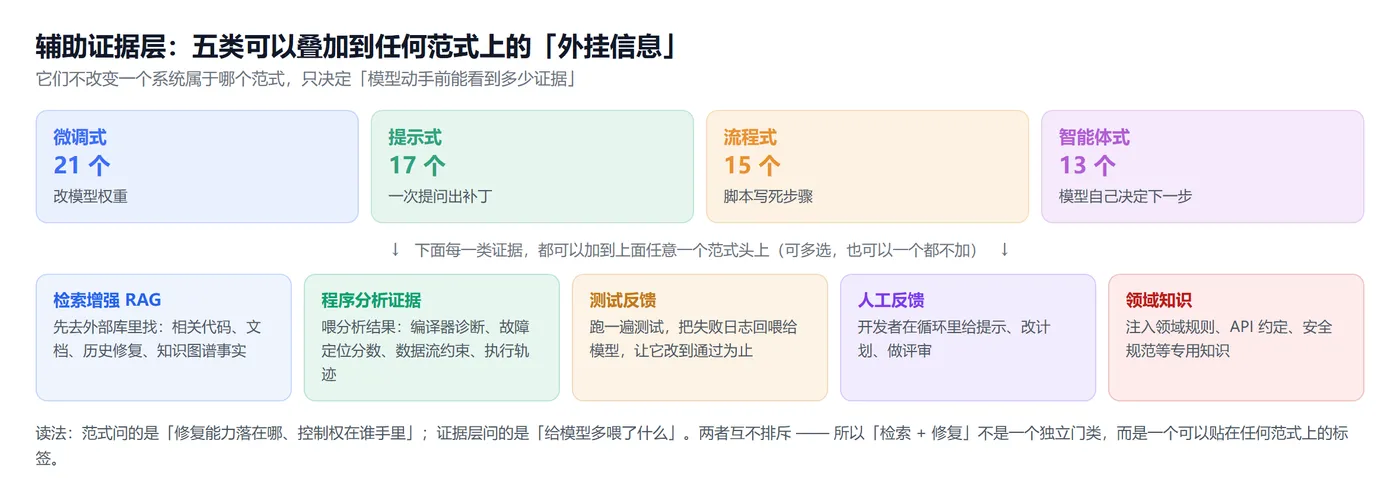
- 检索增强(RAG):先去外部库里找东西——相关代码、文档、历史修复、知识图谱事实,再塞进上下文。
- 程序分析证据(AAG):把分析结果喂给模型——编译器诊断、故障定位分数、数据流约束、失败测试日志、执行轨迹。
- 测试反馈:把单元测试当裁判,失败日志回喂给模型,让它改到通过为止。
- 人工反馈:开发者在循环里给提示、改计划、做评审。
- 领域知识:注入领域规则、API 约定、安全规范这类专用知识。
一个系统可以同时打多个标签:Agentless = 流程式 + 检索;ACFix = 提示式 + 分析增强;SWE-RL = 微调式 + 脚本化流水线(流程式的编排在这里只当辅助证据)。
4.2 它们在语料里怎么分布
把原文 Table 7 的「辅助标签」列按范式拆开看:
- 微调式:21 个里有 4 个把静态分析报告、执行轨迹、历史补丁注入训练输入(TraceFixer、InferFix、PyTy、NTR)。注意这里是训练时喂,不是推理时喂。
- 提示式:17 个里分成两派——检索增强 4 个(Ehsani et al.、RLCE、DSrepair、PailGen),分析增强 5 个(D4C、APPATCH、TracePrompt、ACFix、Dr.Fix)。
- 流程式:15 个里测试反馈 4 个(ChatRepair、ThinkRepair、REx、ContrastRepair)、人在环 3 个(CREF、HULA、DRCodePilot)、检索增强脚本 3 个(Agentless、PATCH、KGCompass)、分析增强脚本 5 个(Repilot、SAN2PATCH、LLM4CVE、PredicateFix、IntDiagSolver)。
- 智能体式:13 个的标签最杂(工具、检索、测试都有,随实现而异),另有一类带独立的评审模块(TSAPR、SpecRover、Abstain and Validate)。
一个更有意思的统计:29 个带检索标签的系统里,有 15 个瞄准仓库级或工业场景;37 个不带检索标签的系统里,只有 1 个。这是作者跑的 21 项探索性关联检验里,唯一在多重比较校正(Benjamini–Hochberg)后仍然显著的一项。作者特意声明:这是相关,不是因果(范式、场景、任务、年份全缠在一起)。
4.3 为什么作者坚持不把证据层当第五类范式
好处有两个:
- 能回答具体问题:「检索在不同范式上分别带来什么」——如果把「RAG + 修复」做成一个孤立门类,这个问题就没法问了。
- 混合系统能被准确描述:SWE-RL 可以同时是「微调式 + 流程式编排」,Agentless 可以同时是「流程式 + 检索」,不用因为加了个检索就被迫改名。
一句话概括:范式回答「能力与控制权落在哪」,证据层回答「模型动手前看到多少信息」。两者正交,互不排斥。
4.4 证据层的三个坑
- 检索没有召回保证:可能漏掉关键文件或函数;即使召回了,塞进上下文也可能把窗口撑爆。
- 结构化证据被压成文本:10 个分析增强系统里,调用图、约束、执行轨迹大多被序列化成提示文本,模型未必能用上其结构。
- 人工反馈不可规模化:人在环只有 3 个系统,成本高、不可复现。
作者点名的方向是 A-MEM 这类自适应记忆:把每次交互存成结构化笔记、维护链接图、只给紧凑的 top-k 上下文。
点评:Gap 2 是全文最「软」的一章。证据层的价值主要是描述性的(谁用了什么、和什么场景相关),作者没有、也无法给出「加了检索能涨多少分」的因果结论——因为那就需要本页第五章那种可控实验,而全领域恰恰没有。
4.5 证据层其实是最容易做「因果对比」的一层(讨论补充)
这一节是读者补充,不是论文内容。
论文没有给出、也承认给不出「加了检索能涨多少分」的结论。但从分类学角度看,五类证据是全文唯一天然适合做控制变量实验的维度:它们都是「给大模型的输入」,彼此之间只差「喂进去的是什么」,其余条件原则上可以全部钉死。
要让它可比,只需对齐两件事:① 任务定义一致(第零章那三条);② 同一基准变体、同一指标与 k、同一基模型。会上给的例子很直观——两个系统都用同一个 react 式骨架,A 多挂一个沙箱能跑代码,B 多挂一个 web search 能搜 Stack Overflow,这样比出来的差才叫「工具的增益」。反过来,如果两个系统骨架不同、输入不同、其中一个还被告知了 bug 位置,那比出来的差异无法归因到任何单一因素。
这也正是论文的遗憾:它只统计了「谁用了哪类证据」(4.2),没做「同一框架下加 / 不加某类证据」的对照分析——而后者才是证据层这套分类法真正能兑现的价值。同理,拿方法论论文之间的分数互比(例如编译器输出 vs 联网搜索)是不合适的,但在综述层面,只要基准与任务对齐,把「不同输入带来的增益」拿出来讨论是合理的。
五、Gap 3|协议层面没人管:一次评估协议审计
这一章回答第三个 gap,也是全文最值得读的部分。核心不是「谁分数高」,而是「哪些分数根本不能放在一起比」。
5.1 核心命题:基准同名 ≠ 结果可比
作者把分析单位从「基准数据集」换成「一条被报告的结果」:某个系统、在某个基准变体上、用某个指标报出来的那个数。
为什么必须这么换:同一个 Defects4J,可能有人报 pass@1、有人报 pass@1000,有人假设 bug 位置已知、有人自己定位,有人只在单函数上测——这些数字长得像,含义完全不同。
于是问题变成:什么时候两条已发表的结果可以放在一起比,而不改变分数的含义?
5.2 什么才算「能比」:四道卡
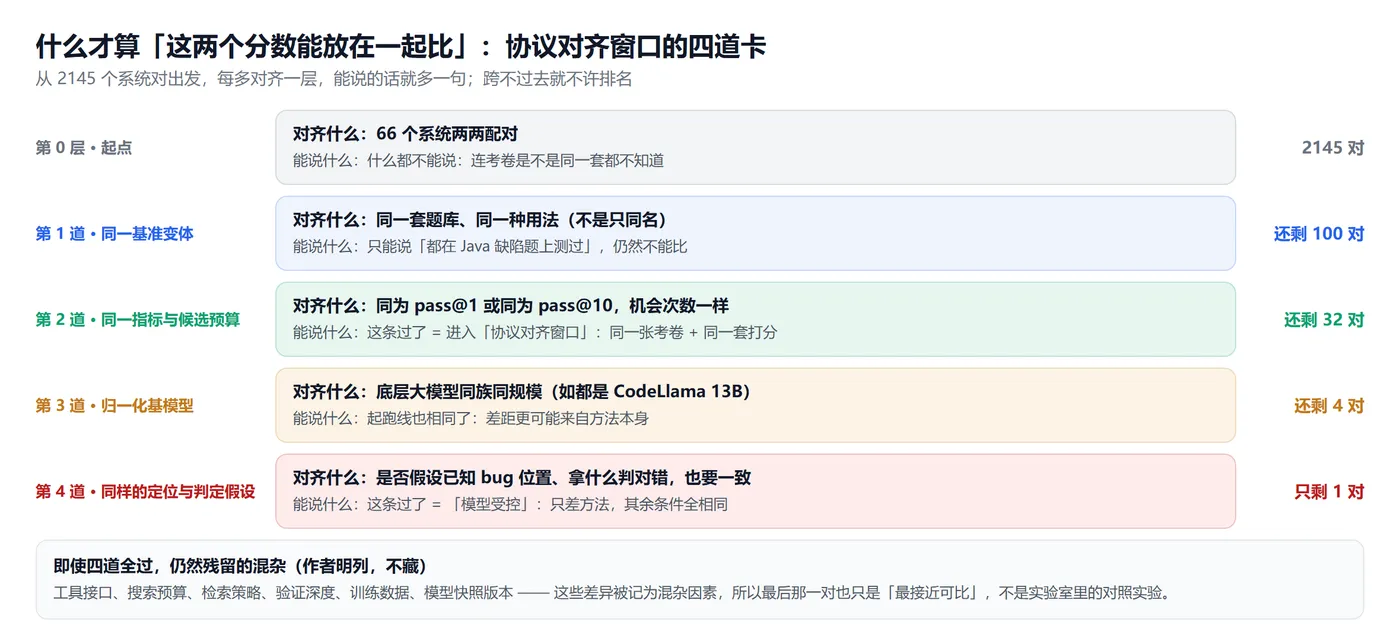
- 同一基准变体:不只是同名,而是同一套题库、同一种用法(是否只取子集?是否只改单函数?过滤条件一致吗?)。
- 同一指标与候选预算:pass@1 和 pass@10 不是一个东西——k 越大越容易过。
- 归一化基模型:把模型名统一折算(CodeLlama-13B、GPT-4 级……),同族同规模才算同一条起跑线。
- 同样的定位与判定假设:是否假设 bug 位置已知、oracle 用公开测试还是隐藏测试。
前两道过了 = 进入协议对齐窗口(同一张考卷 + 同一套打分);四道全过 = 模型受控(只差方法)。
但就算四道全过,窗口内仍有残留差异(工具接口、搜索预算、检索策略、验证深度、训练数据、模型快照)——作者把它们明列为混杂因素,而不是藏起来。所以即便是最后那一对,也只是「最接近可比」,不是实验室里的对照实验。
5.3 三个被认可的对比窗口(原文 Table 10)
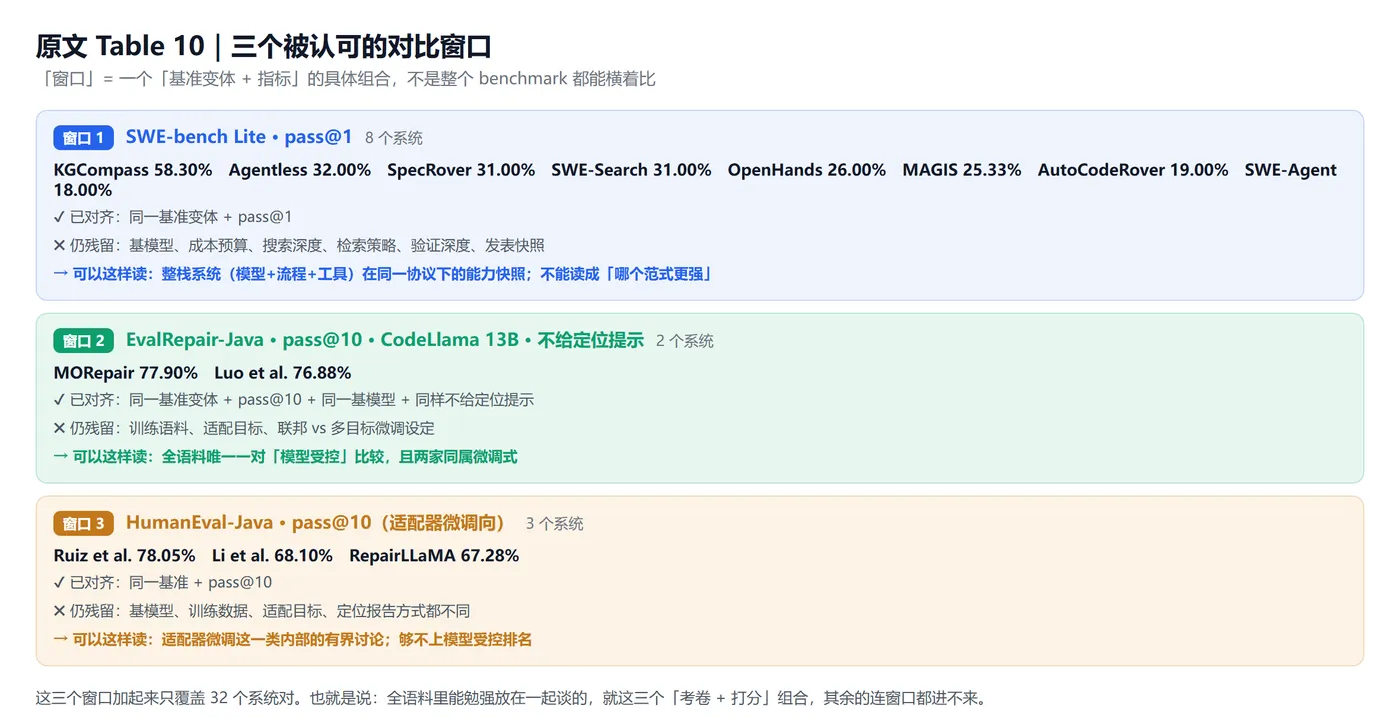
先把「窗口」这个词固定住:它不是「三个 benchmark」,而是三个具体的(基准变体 + 指标)组合。也就是说,作者只在这三种考法下承认分数可以放在一起谈,而不是「整个 SWE-bench 都能横着比」。
- SWE-bench Lite · pass@1:8 个系统(KGCompass 58.30、Agentless 32.00、SpecRover 31.00、SWE-Search 31.00、OpenHands 26.00、MAGIS 25.33、AutoCodeRover 19.00、SWE-Agent 18.00)。这是语料里最拥挤的整栈窗口,也是唯一能看出仓库级能力分布的地方。
- EvalRepair-Java · pass@10 · CodeLlama 13B · 不给定位提示:只有两个系统(MORepair 77.90、Luo et al. 76.88)。这是全语料唯一一对模型受控比较,而且两家同属微调式。
- HumanEval-Java · pass@10(适配器微调向):三个系统(Ruiz et al. 78.05、Li et al. 68.10、RepairLLaMA 67.28)。只能做「适配器微调这一类内部」的有界讨论,够不上模型受控排名。
三个窗口加起来只覆盖 32 个系统对;其余结果被放进「同族快照组」,只用于观察协议碎片化,不参与排名。
5.4 从 2145 到 1:漏斗
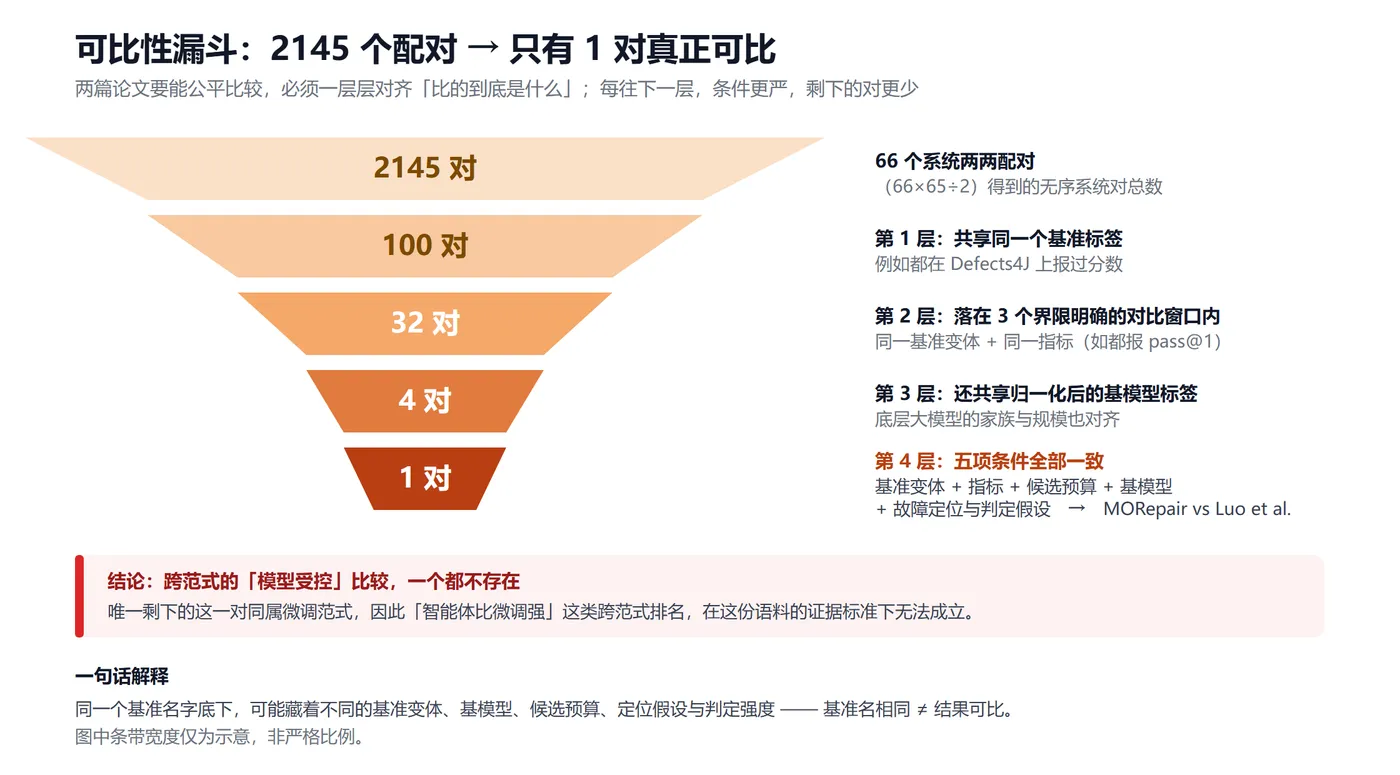
「共享归一化基模型标签」是什么意思:各论文写模型名的方式五花八门(「CodeLlama-13B-Instruct」、「codellama/CodeLlama-13b-hf」、「CodeLlama 13B」),先按同族同规模折算成一个统一标签,再看两边是否一样。这一步把 32 对砍到 4 对。
人话版:66 个系统两两配成 2145 对「谁跟谁」。要说「A 比 B 强」,得先保证两边是同一张考卷(同一基准变体)、同一套打分(同一指标与 k)、同一条起跑线(同一基模型)、同一套假设(是否已知 bug 位置、拿什么判对错)。一条条卡下来只剩 1 对合格——MORepair 与 Luo et al. 在 EvalRepair-Java 上的一次同条件对比,而且两家都走微调路线。
跨范式的模型受控比较,一个都不存在。
这意味着:把智能体式系统的 SWE-bench 分数和微调式系统的 Defects4J 分数放在一起说「智能体比微调强」,在这份语料的证据标准下是站不住的。作者的原话是:基准名重叠并不能支撑一张范式排行榜(benchmark-name overlap does not support a paradigm leaderboard)。
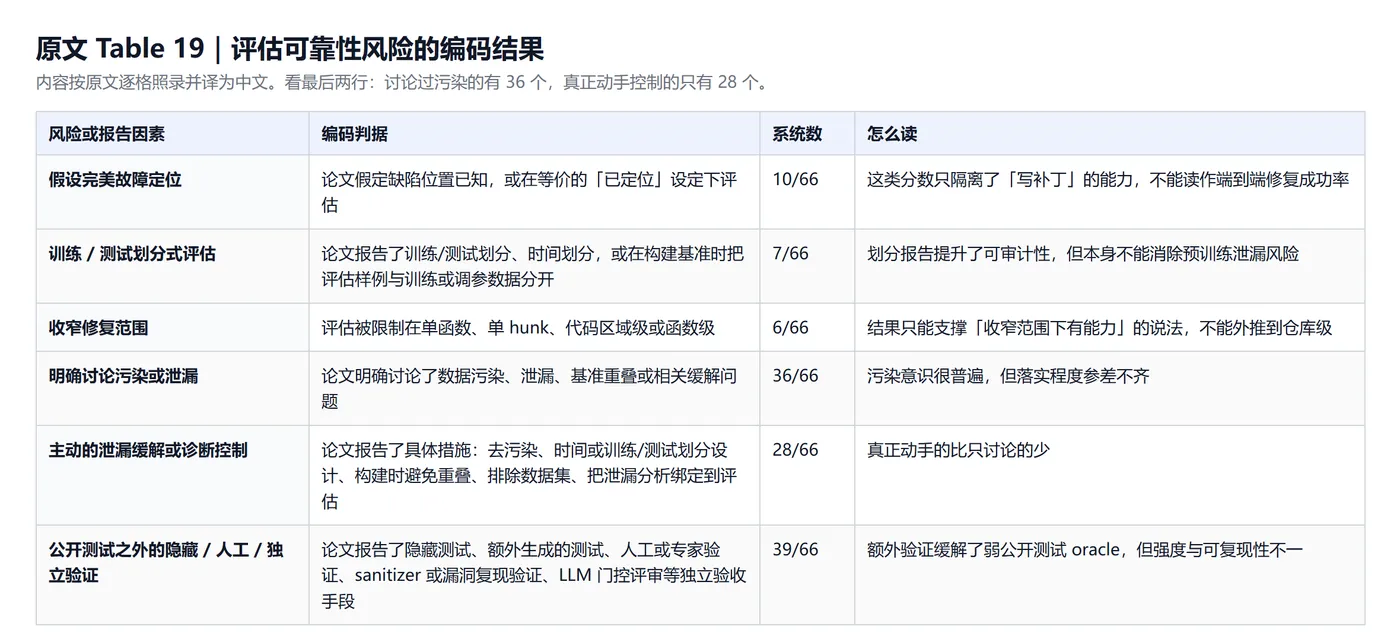
5.5 可靠性风险编码:六个会让分数虚高的开关(原文 Table 19)
先说这个标题是什么意思:它不是给系统打质量分,而是逐篇检查「这篇的评估设置里,有没有哪个环节会让分数看起来比实际好」,一共六项开关,统计每项有多少系统触发。计数是语料属性,不是质量评分。
- 假设完美故障定位(10/66):直接告诉模型 bug 在哪一行 / 哪个函数。这类分数度量的是「给定位置后写补丁的能力」,不能当端到端修复成功率。
- 训练 / 测试划分式评估(7/66):报告了按时间或按项目切分的训练 / 测试集。能提高可审计性,但不等于消除了预训练数据泄漏。
- 收窄修复范围(6/66):只评单函数、单 hunk、代码区域级。结论只在「小范围」成立,不能外推到仓库级。
- 讨论过污染 / 泄漏(36/66):只是「在论文里提到了」这个风险。
- 真的做了控制(28/66):去污染、时间切分、构建基准时避免重叠、排除数据集等具体措施。
- 公开测试之外的额外验证(39/66):隐藏测试、生成测试、人工 / 专家评审、sanitizer / 漏洞复现、LLM 门控评审。
把上面六项里最「立竿见影」的三条翻成人话,就是三种把分数搞高的手段(讨论会上的总结,括号内是论文对应的编码计数):
- 直接告诉模型 bug 在哪:已知故障位置,分数只反映「给定位置后写补丁」的能力(假设完美故障定位 10/66)。同样是 Defects4J,告知位置的行与不告知的行不是同一道题。
- 把修复范围收窄:只评单函数 / 单 hunk / 代码区域级(6/66)。范围越小越好修,分数自然高,但不能外推到仓库级。
- 训练 / 测试污染:基准与预训练语料重叠(36/66 只是「提到」这个风险,28/66 真正做了控制)。HumanEval 这类题库被反复刷,分数膨胀最明显。
读法:36 与 28 的差距说明「意识到 ≠ 解决」;39 的额外验证虽能缓解弱公开测试 oracle,但形式各异、强度参差,本身也缺标准化,只能当协议属性看,不能当可比分数看。三条刷分手段的共同点是——它们都在改任务,而不是在改方法,所以对应的分数不属于「方法更好」,只属于「题更简单」。
5.6 指标与预算的碎片化(原文 Table 12 / Table 13)
- pass@1:21 / 66(2023 年 1/12 → 2024 年 5/16 → 2025 年 13/30,报告比例在上升)
- 更大的 pass@k 预算:28 / 66
- 单候选或非 pass@k 的任务特定指标:17 / 66
- 只有 13 / 66 落在模型受控 / 协议对齐 / 有限同基准比较层级;53 / 66 是纯快照行
Defects4J 的例子最能说明问题:pass@k 从 1 到 5000 不等,分母从 109 到 837,若干行假设完美定位。所以同一基准下,「74/109」「99/255」「116/273」「122/837」这些数字彼此之间根本不是一回事。
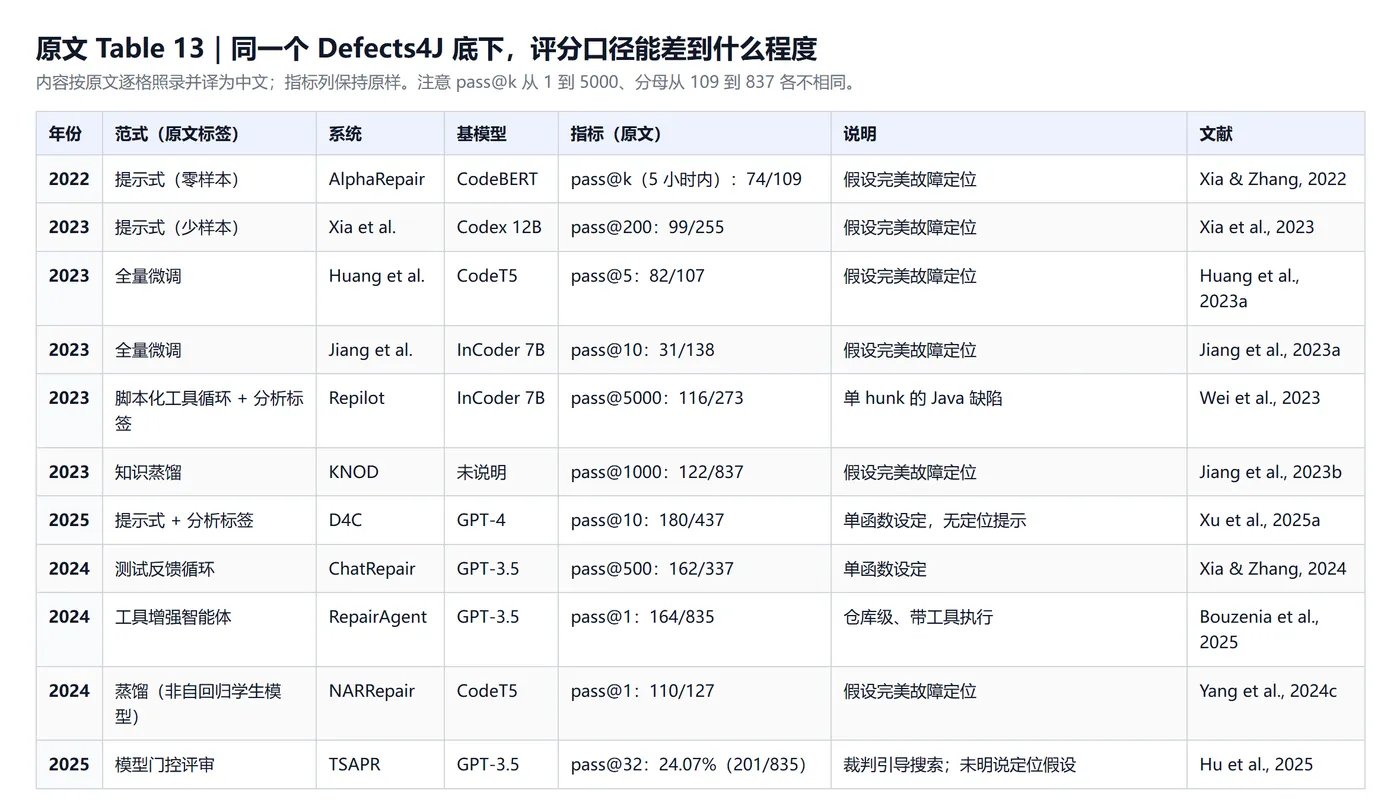
顺带一个实用提醒:Defects4J 上 NARRepair 报 pass@1: 110/127 看着极高,但那是在完美故障定位 + 非自回归学生模型的设定下;RepairAgent 报 pass@1: 164/835 看着低,却是仓库级带工具的端到端执行。分母不同,不可比。
六、五类开放挑战(RQ4,都有语料证据支撑)
作者明确说这些挑战来自语料中反复暴露的局限,而不是对 LLM 的泛泛而谈。每条都给了计数:
1. 训练与部署成本
- 模型可得性:38 / 66 用专有 / API 模型,27 / 66 用开源或学术模型,1 个未说明。而且分布随范式严重偏斜:19 / 21 的微调系统用开源模型,37 / 45 的提示 / 流程 / 智能体系统用专有 API 模型。
- 迭代推理预算:28 / 66 是流程式或智能体式(8 个脚本工具循环、7 个工具增强智能体、4 个测试反馈循环、3 个自控制系统),每多一轮就多一次 token / 工具 / 测试执行开销。
- 实践含义:报告模型来源、模型快照、token 预算、重复调用预算、延迟与「每单位成本的成功率」,而不是只报最终准确率。
2. 评估可靠性
- 完美定位、训练测试划分、收窄范围都会让分数虚高;基准与预训练数据重叠导致泄漏与 pass@k 膨胀。
- 弱测试套件导致「补丁过拟合(patch overfitting)」:补丁通过了所有可得测试,但逻辑上仍有缺陷。这个问题在 LLM 训练语料与仓库级基准都只有部分透明时更难审计(这是 APR 的老问题,LLM 时代被放大)。
3. 工作流鲁棒性
- 提示措辞、采样温度、随机种子的微小变化就能改变生成的补丁,把成功变失败;在智能体工作流里,随机性会跨步骤累积,两次运行可能走出不同工具序列。
- 模型还可能产出非法命令、忽略给定规则、陷入过长循环,导致总耗时不可预测。
4. 检索与上下文管理
- 语料中 7 个检索增强的提示 / 流程系统,依赖检索到的代码、补丁、模式或图谱上下文,但检索可能漏掉关键文件或函数,且没有召回保证;即便召回,加入的上下文也可能把提示撑爆上下文窗口。
- 10 个分析增强系统中,结构化数据仍普遍被序列化成提示文本,模型未必能充分利用其逻辑结构。
- 作者点名 A-MEM 这类自适应记忆系统(把每次交互存成结构化笔记、维护链接图、只提供紧凑 top-k 上下文)是一个可能方向。
5. 补丁保证与部署信任
- 安全 / API 误用 / 崩溃修复共 11 个系统,但数据集与指标完全不相交(EM、F1、CodeBLEU、correct repairs、success rate、repair accuracy 各说各话),比通用基准更难积累保证证据。
- 只有 10 / 66 的系统把测试反馈、人工反馈或 LLM 门控评审作为记录的控制子类型,其余 56 / 66 没有把任何「验收闸门」暴露为主要修复控制机制。
- 核心开放问题:如何在部署前报告补丁验收证据——用可比数据集、明确 oracle、轻量静态 / 动态检查,而不是泛泛的信任声明。
作者给的三个方向:① 建面向大规模多 hunk 修改的基准,配更强 oracle、隐藏测试、污染感知划分与明确标注的定位假设;② 设计成本感知的修复策略,把「每单位预算的成功」当目标(报告模型来源与 token 预算、复用中间分析结果、给 LLM 调用次数设上限、简单 bug 回退到脚本流水线);③ 把生成与验收更彻底地分离,用独立验证信号(更强的测试、静态 / 动态分析、sanitizer / 漏洞复现、人工评审、经过校准的 LLM 门控)支撑最终补丁决策。
七、作者自述的效度威胁
- 内部效度:研究识别、选择与编码的偏差。缓解手段是多库检索、明确纳排、独立筛选 + 编码 + 边界裁定,脚本与结果全部公开可重算。
- 外部效度:语料边界与人工评估设定。作者主动声明这是 criteria-bounded corpus,不是全领域普查;换一套排名体系(例如用 CORE 而非 CCF)就可能改变外围的归档集合。另外没有做联合重评(joint reevaluation),也不归一化不同的 k、模型快照、检索预算、定位假设与墙钟预算——这保证了忠于原工作,但限制了跨论文可比性。作者举了个例子:Prometheus 因为不产生新的协议对齐窗口,被记为边界案例而不计入 66 个系统。
- 构造效度:定义与测量的模糊性。缓解手段是五维编码簿 + 有序主落点规则 + 全语料一致执行 + 逐系统编码公开。
点评:肯把自己语料的边界讲这么清楚,是这篇综述可信的地方。反过来也提醒读者——任何引用本文计数的说法,都必须带上「在这 66 个系统的语料内」这个限定语。
读后回顾
动机
LLM 修复这个方向在两年多里从「给一段代码让模型改」迅速长成「微调 / 提示 / 脚本流水线 / 自主智能体」四种完全不同形态,论文数量爆炸但术语混乱、分数满天飞却无法比较。作者要做的不是再列一遍技术,而是给这个领域一套能被一致执行的坐标系,并说清楚哪些分数其实不能比。
创新点
- 创新点在哪? 提出「主落点规则(primary-locus rule)」,用「修复能力落在哪 + 控制权在谁手里」而不是「怎么用 LLM」来做全语料统一的一级分类;把检索 / 分析降为正交证据标签;并把分析单位下沉到「一次被报告的修复结果」,做协议级可比性审计。
- 作者可能是怎么想到的? (以下为推测,与论文明确陈述分开)大概率是先做了编码、发现「按使用方式分类」在混合系统上处处打架(Agentless 到底是提示还是流程?SWE-RL 是微调还是智能体?),于是倒逼出一条有序判定规则;而协议审计则很可能是他们在整理 Table 13 时发现「同一个 Defects4J 底下 pass@k 从 1 到 5000 都有」,才意识到碎片化比分数本身更值得写。
- 为什么能上 TOSEM? 从审稿人视角看:问题重要性(领域正在快速膨胀且比较方式失效)、技术新意(分类规则可执行 + 一致性审计)、证据完整性(κ 值、假阴性审计、408 条排除分解、全 artifact 开源)、可复现性(脚本化流水线)四项都到位。尤其是「可复现」这条——他们把检索、筛选、编码全部脚本化并发布,这在综述类工作里是稀缺品。
有意思的 Finding(5 个)
- 「2145 对里只有 1 对真正可比」。这是全文最有杀伤力的数字。它意味着当前绝大多数「A 方法优于 B 方法」的说法,在协议层面是无证据的。对做工程选型的人来说,这比任何排行榜都重要。
- 范式与模型来源强相关:19/21 的微调系统用开源模型,37/45 的提示 / 流程 / 智能体系统用专有 API 模型。这不只是巧合——微调需要拿得到权重,所以只能开源;不微调就得靠最强的闭源模型补能力。这直接决定了两类系统的可复现性与成本结构完全不同。
- Agentless 是最有力的反例。它只是「定位—修复—验证」的脚本三段式(流程式),却在 SWE-bench Lite pass@1 上拿到 32%,超过多数工具增强智能体。说明在仓库级任务上,「写死的流程 + 强模型」可能比「让模型自己规划」更划算——这对所有正在做智能体的人都是一记提醒。
- 意识到污染 ≠ 处理污染:36/66 讨论泄漏风险,只有 28/66 真正采取控制措施。而 39/66 用了公开测试之外的额外验证,但形式各异、强度参差——「额外验证」本身也需要标准化。
- 56/66 的系统没有任何显性验收闸门。修复系统普遍把「生成补丁」当终点,而不是把「证明补丁该被接受」当终点。这是从「能修」走到「敢用」之间最大的缺口。
一句话结论(含任务定义缺失这一前提)
这篇综述证明:LLM 软件修复已经有四类清晰的设计范式(微调 / 提示 / 流程 / 智能体),但这个领域目前积累的分数大多数彼此不可比——66 个系统 2145 个配对中只有 1 对满足模型受控比较,因此「哪个范式更强」在当前证据下是一个无法回答的问题;在此之前,任何范式优越性的主张都只是局部进展的证据,而不是普遍结论。
再往前推一层(第零章):不只是分数不可比,连「这 66 个系统是不是在解同一道题」本身都没定论——论文没定义输入输出、粒度与是否含故障定位。所以这篇能给的是一张现状地图 + 一次协议审计,给不了的是方法层面的强弱排序。
不足与 limitation(分三类写)
论文作者明确承认的局限
- 语料是 criteria-bounded 的,不是全领域普查;计数不能当流行度估计。
- 未做联合重评,也不归一化 k 值、模型快照、检索预算、定位假设与墙钟预算——忠于原设定,但牺牲了跨论文可比性(作者用「协议对齐窗口 + 同族快照」来缓解)。
- 会议边界以 CCF-A 为操作透镜,换一套排名体系可能改变外围归档集合。
- 论文自己在 Table 1 里也写了本工作的局限:聚焦 66 系统语料,没有在统一协议下重跑所有系统。
实验 / 语料能够暴露的不足
- 66 个系统里 53 个是纯快照行,协议审计的覆盖面其实很薄——审计结论很强,但能支撑结论的样本很少。
- 安全 / API / 崩溃修复 11 个系统的指标完全不相交,这块几乎无法形成任何聚合结论。
- 2026 只统计到 4 月,时间窗右端被截断,年度趋势容易被误读。
结合工程视角的风险(这是我的判断,不是论文事实)
- 最根本的一条:没有任务定义。论文没说清 program repair 的输入输出、作用粒度(函数 / 文件 / 仓库)、是否包含故障定位,就把 66 个系统放进同一个框架分类与比较(见第零章)。这不是「没写清楚」的小瑕疵——任务边界不定,后面所有「哪类更强」的讨论就没有落点,连「告知 bug 位置」这种实质是换了子任务的操作,都被当成评估协议的一个字段来对齐。读它的正确姿势:分类当现状地图,对比结论当待验证假设,只有 Gap 3 的审计可以直接引用。
- 「主落点规则」虽然可执行,但仍依赖对论文自述贡献的判断;当作者把系统包装成智能体式而实质是脚本流程时,编码会跟随自述,可能系统性高估智能体式占比。
- 分类是静态快照:一个 2024 年的流程式系统到 2026 年可能已演化为智能体式,语料没有版本演化追踪。
- 对成本只做了「有没有报告」的编码,没有实际测 token / 延迟——所以「智能体式更贵」这个结论是结构性的推断,不是测量值。
- Artifact 仓库最后更新 2026-08-03、29 stars,说明社区复用度还很低,脚本流水线未经第三方验证。
参考资料
- 论文(v3,2026-08-27):https://arxiv.org/abs/2506.23749
- Reproduction artifact:https://github.com/GLEAM-Lab/ProgramRepair (MIT,29 stars,最近更新 2026-08-03)
- 本文提到的可对照阅读的代表性系统:Agentless、SWE-agent、AutoCodeRover、OpenHands、RepairAgent(智能体 / 流程);RepairLLaMA、MORepair、SWE-RL(微调);ChatRepair、ContrastRepair(测试反馈循环);SpecRover(LLM 门控评审)
- 阅读本页时的版本提醒:网上二手解读多为 v1(62 系统),与本页数字不一致时以 v3 为准
- 审稿意见:本文为 ACM TOSEM 期刊论文,未走 OpenReview 公开评审,公开渠道检索不到审稿意见;本页未引用任何审稿内容
- 本页修订记录:2026-10-20 下午与黄晨讨论两场(腾讯会议录制 17:13–18:04、18:57–19:06)后增补——新增「第零章 任务定义(圈地)」、术语表 4 条、读前先问第 7 条与第 3 条前提、3.4 范式选择决策规则、4.5 证据层的控制变量对比、5.5 三种刷分手段,以及「不足」里的任务定义缺失一条。以上增补均为读者补充,已在各处标注。
本页所有数字均来自 arXiv v3 全文(2026-08-27)逐节核对;标注为「点评 / 推测 / 工程视角 / 读者补充」的内容为读者判断,已与论文事实分开。

