一座寺庙,从一张图开始
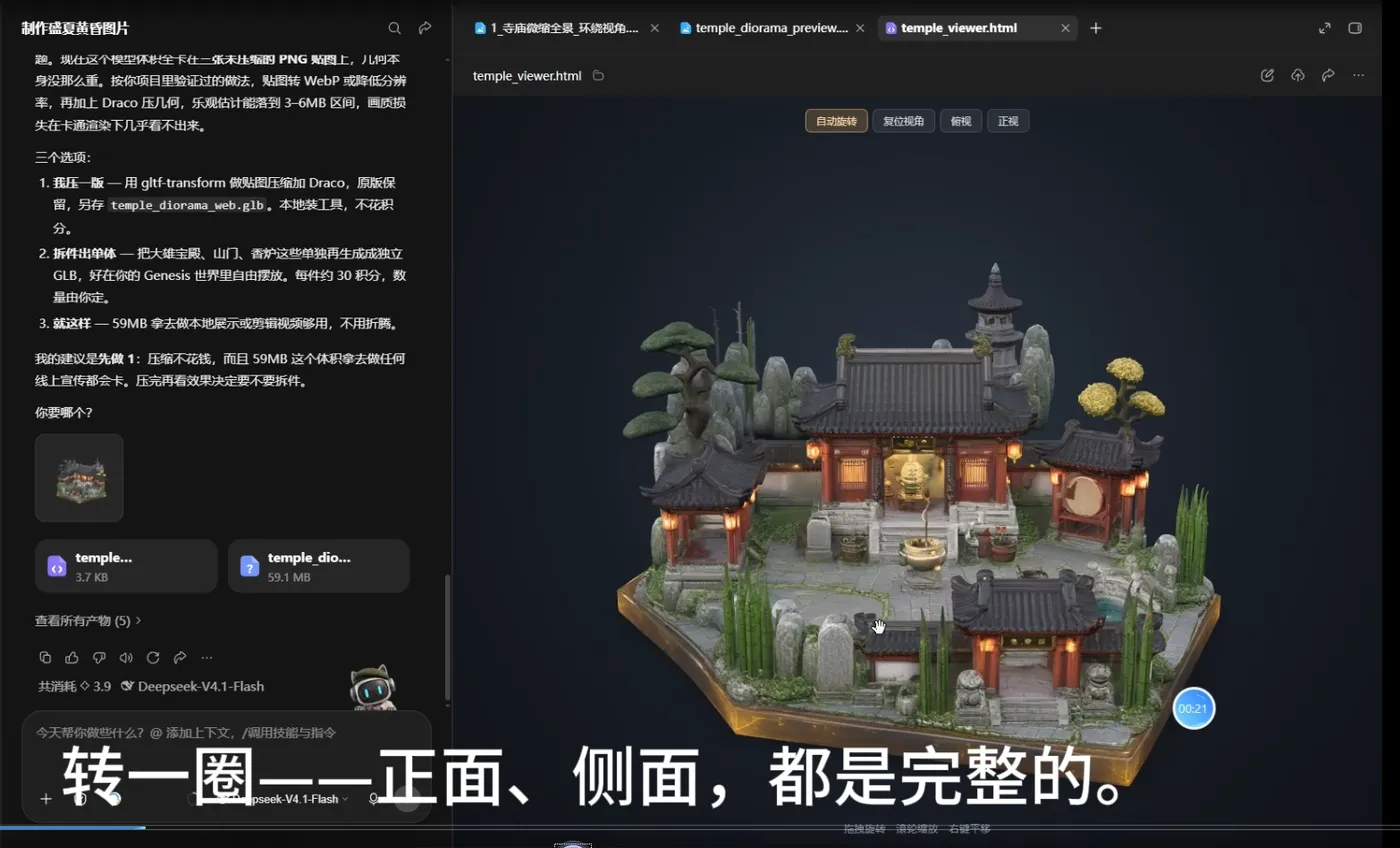
这座寺庙不是建模出来的。它由 AI 生成,从一张图开始,最后变成一个可以在浏览器里走进去的场景。
中间没有打开 3D 建模软件,也没有把模型外包出去。
这件事的意义不在于"能生成一个模型"——生成模型现在很多人都在做。真正的问题是:生成出来的东西,能不能在一个实时运行的 3D 世界里用起来。模型好看,塞进场景卡到没法用,等于没用。
下面把完整流程拆成九步。每一步说清它解决什么,也说明哪些环节目前还是人工的。
为什么"能生成模型"不等于"世界能跑起来"
3D 场景在浏览器里卡顿,多数时候原因不在渲染管线,而在两件事:要让浏览器下载多少字节,以及每帧要提交多少次 draw call。
这两件事和"模型生成得好不好看"没有关系。一个面数漂亮、材质精致的模型,贴图可能有几十 MB,在移动网络上光是下载就要十几秒。这十几秒里用户看到的是空白页,渲染再快也没有意义。
所以整条流程里,真正花时间的是模型生成之后的资产处理,不是生成本身。
完整流程:九步
第一步:生成——从提示词到图片
输入是文字,输出先是图片。
这一步的门槛不高。真正决定后面能不能用的是判断标准:这张图能不能落成一个结构完整的 3D 模型。图上看着对的屋顶,做成模型可能缺一半内壁,从别的角度看就塌了。
所以看生成结果时,要看的不是"像不像",而是从多个角度是否都成立。
第二步:图片之后是模型
图片确认之后转到 3D 模型。
这里出现第一个必须处理的问题:从图片生成的模型,多边形数量通常过量。一个能在实时场景里用的模型,和一个用来展示的模型,中间差的是面数、贴图尺寸,以及有没有不必要的内部空腔。
处理方式很朴素:压缩贴图。单个模型的贴图重新压缩后,体积可以减少 68% 到 92%,整个场景的资产集可以从 3.1GB 降到 390MB。
这一步技术含量不高,但它是后面所有优化的前提。资产总量决定下载时间,下载时间决定用户会不会等到场景出现。
第三步:导入——把模型拖进世界
打开项目,把模型拖进去。
看起来是一个拖拽动作,实际发生的是:模型文件被登记进世界的资产表,与场景数据建立引用关系。之后编辑端和访问端读取的是同一份世界数据,而不是各自的副本。
需要区分两个概念:模型进入资产库,和模型被放进场景。前者只是文件到位,后者才涉及位置、朝向、碰撞和性能预算。导入成功不代表能用。
第四步:部署——跑在自己的服务器上
模型导入之后需要部署。
创世 Genesis 这一类系统采用自部署方式:装在自己的服务器上,不依赖外部平台的账号和额度。
这里有一个架构选择值得说明:服务端不做任何渲染。它只负责发送数据和静态资源,所有画面计算都在浏览器里完成。因此服务器不需要 GPU,一台普通 VPS 就能承载,真正占用资源的是资产存储和带宽,不是算力。
这个选择直接决定了成本结构和数据归属:世界数据在自己的数据库里,资产在自己的磁盘上。
第五步:编辑端——位置、大小、朝向
部署完成后打开编辑端,刚导入的寺庙已经出现在地图上。
位置、大小、朝向都在同一个界面里调整。地形、建筑、人物、模型也在同一套界面里摆放,不需要在多个工具之间导出导入。
这一步的关键不在操作,而在保存:改动必须写回世界数据,访问端读到的就是新位置。如果改动只存在于编辑器的会话里,下次启动被重置,那这个编辑器就只是预览器。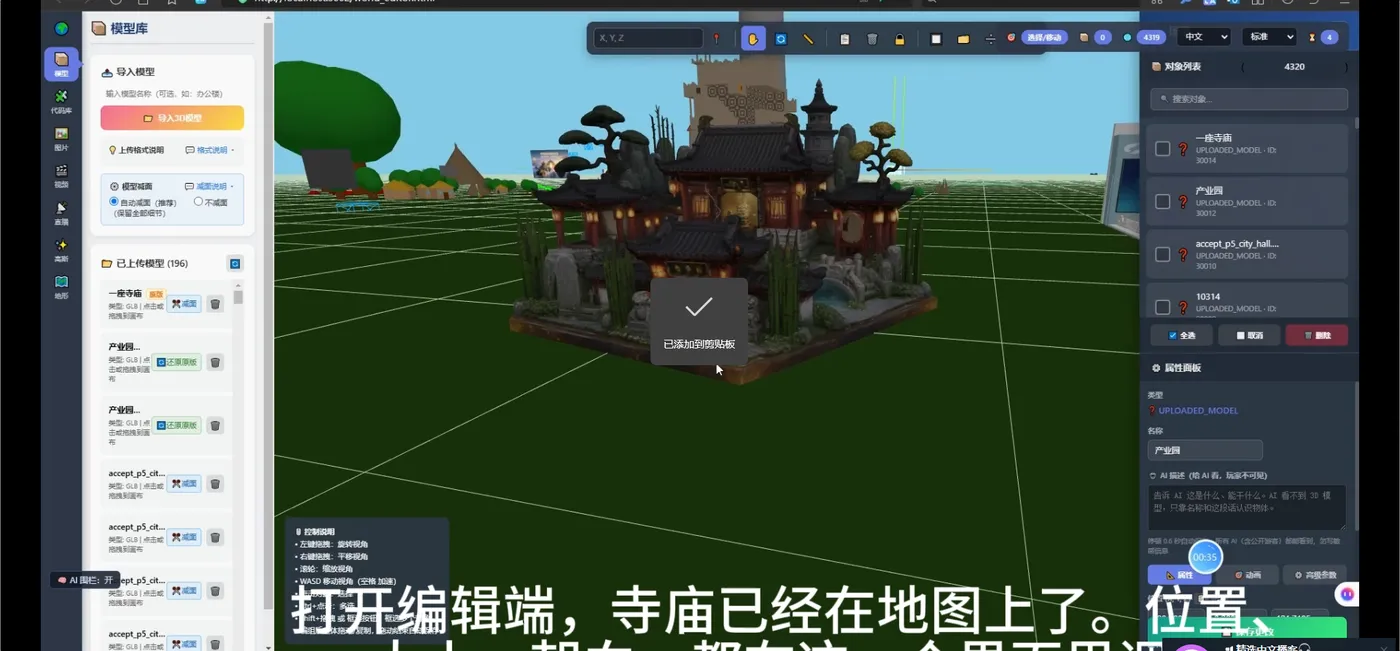
第六步:保存,换到访问端
摆好位置,保存,退出编辑端。
然后换一个界面进入:访问端,以普通用户的身份走进去。
编辑端和访问端是两套界面、一份数据。管理员身份能修改世界,普通身份进来只能看和走。这个分离如果做得不彻底,很容易退化成两套互不同步的数据。
第七步:世界里——寺庙就在这儿
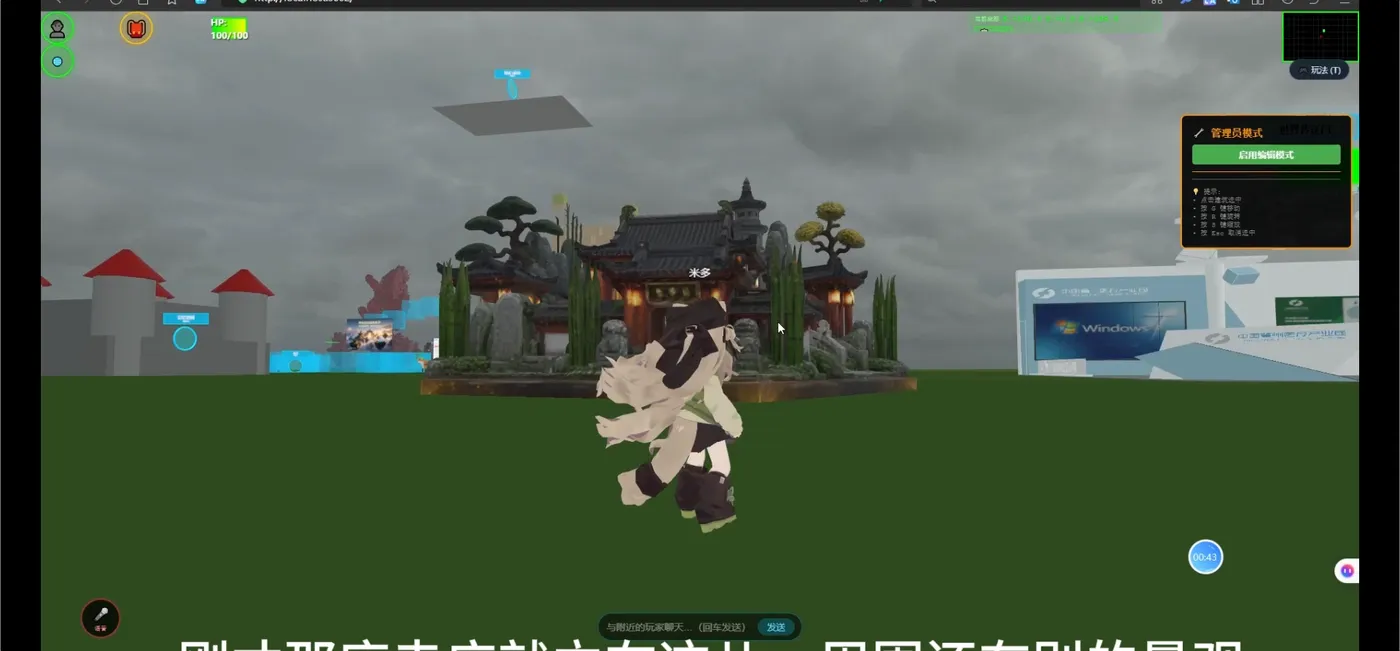
进入世界之后,刚才那座寺庙就立在场景里,周围还有别的景观。
这一步是整条流程的验收点:在编辑器里摆放的东西,真实存在于那个空间中,不是一个渲染出来的预览图。位置、比例、和周围地形的关系,都要在走进去之后依然成立。
第八步:多场景——同一个世界,不止一个地方
同一个世界里可以有多个场景。除了寺庙所在的区域,还可以有一个展厅,走进去就能看。
技术上的区别在于:多场景不等于多份世界。如果场景切换靠加载一个新世界,体验会中断,内存也会翻倍;如果共享同一份世界数据,按范围加载,加载时间和内存才是可控的。
第九步:管理端——改一次,下次还是这样
用管理员身份进入世界,点任何一个模型,可以放大、缩小,然后保存。
退出,重新进入,模型还是修改后的大小。
这一步看着小,但它是整条流程的落点:修改可以持久化,世界是活的。无法做到这一点的演示,本质上只是模型查看器。
现在能做什么
- 场景里的模型可以替换为自己的资产,例如企业展厅的展台、产品模型、样板间
- 世界里可以聊天
- 可以接入一个 AI 智能体,作为在世界中移动的讲解员
- 编辑端与管理端分离,权限不同看到的能力不同
- 多场景共存于同一个世界
还没做什么
有一件事需要明确说明:让 AI 自己搭建一整个世界,目前尚未实现,也尚未开始。
生成单个模型,现在已经可行。但把几百个模型摆成一个在空间上说得通、走进去不别扭的世界,是另一个问题。它涉及布局逻辑、动线设计、尺度一致性,以及"什么物体该出现在什么位置"的判断。这部分仍然需要人来做。
所以在这类演示里,模型是 AI 生成的,世界是人摆放的。这个边界值得在使用前弄清楚。
适合谁用
| 场景 | 为什么合适 |
|---|---|
| 企业 3D 展厅 | 模型可替换为真实产品,客户用浏览器直接进入,不需要安装客户端 |
| 工业设备演示 | 设备模型放进场景,销售在客户现场用浏览器打开讲解 |
| 职业教育教学 | 老师搭建场景,学生以普通身份进入,权限分离清晰 |
| 私有化演示环境 | 数据与资产都在自己服务器上,适合对数据归属有要求的机构 |
常见问题
需要 3D 建模基础吗?
模型可以来自 AI 生成,也可以来自外部采购或已有资产。流程本身不需要建模能力,但需要判断模型是否适合实时场景:面数、贴图尺寸、是否有多余内部结构。
需要什么配置的服务器?
服务端不渲染画面,不做图形计算,因此不需要 GPU。一台普通 VPS 可承载,主要成本在资产存储和带宽。
支持什么模型格式?
以 GLB 为主,这是目前浏览器端实时 3D 的通用格式。
能商用吗?
创世 Genesis 采用订阅许可,源码开放但并非开源软件。本地非商用使用免费,联网和商用需要授权。具体条款以仓库中的许可文件为准。
AI 能自己搭出一整个世界吗?
目前无法做到。AI 目前能生成单个模型,把大量模型组织成一个空间上合理的世界,仍然需要人工完成。这一部分尚未开始。