Agent 的能力除了受底层模型影响,也取决于模型外部的 Harness。同一个模型,在不同的系统提示词、记忆、Skill、工具和任务编排下,执行结果可能存在明显差异,一般可以用 Agent = Model + Harness 来描述二者的关系。
Northwestern University 与 Google Cloud AI Research 团队在论文《Harness²: Recursive Agent Harnessing for an Open World》里研究的,就是模型参数保持冻结时,Harness 能不能在任务执行过程中持续改进。
放到开放任务里,这件事会遇到两个问题:新任务通常没有标准答案或可靠验证器,系统很难判断一次 Harness 修改到底有没有起作用;而针对当前任务调出来的 Harness 又可能带有很强的任务特征,直接交给下一个任务未必合适。
Harness² 把问题拆成两层递归:任务级递归负责改当前任务的执行 Harness,改进级递归负责把这次修改过程中得到的经验带到后续任务。下面就沿着这两层递归来看 Harness² 是怎么做的。
Harness 的 8 类可编辑组件
作者把 Harness 的可修改部分拆成 8 类组件,每一类都对应运行时中的具体文件,因此一次 Harness 修改可以直接表现为文件差异。
其中,系统提示词、约束规则、长期记忆和工具使用说明会在每次模型调用时生效;Skill 按需加载;脚本通过 Bash 执行确定性操作;子 Agent 在独立上下文中处理被委派的任务;插件则运行在工具调用循环中,通过代码介入工具调用和执行轮次。
Harness² 的修改对象不只有提示词,流程知识可以写入 Skill,确定性操作可以交给脚本,需要独立上下文的工作可以交给子 Agent,运行时约束也可以通过插件实现。后面的任务级递归,就是在这组可编辑组件上提出、试跑和组合修改。
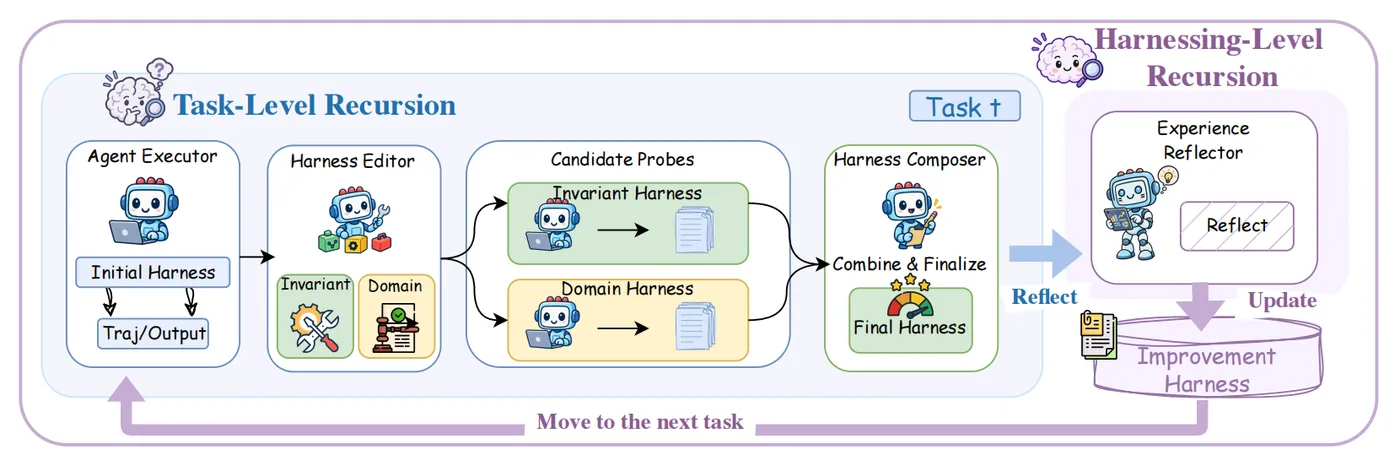
图 1:Harness² 的两层递归。
用行为对照观察修改效果
任务级递归的基本单元是“提出修改—试跑候选—组合修改”(Propose–Probe–Compose)。
系统先用当前 Harness 执行任务,得到一条参考执行,记录执行轨迹和交付结果。随后,Harness 编辑器从两个方向提出候选:通用流程候选负责规划、工具使用、上下文管理、任务委派等跨领域执行问题;领域候选负责当前领域的知识、流程和约束。
候选 Harness 会在相同模型和环境下重新执行同一任务,再与参考执行比较轨迹和交付结果,观察原有问题是否缓解、行为是否保持不变,或者是否引入新的回退。论文把这种修改前后的差异称为行为对照。它只能为 Harness 修改提供执行证据,不能验证任务结果是否正确,因为不同执行仍存在随机性,也可能共享相同的模型偏差。
完成试跑后,组合器会结合候选 Harness、文件差异和执行证据,选择性合并或调整修改,也可以直接保留当前 Harness。由此形成下一版执行 Harness。
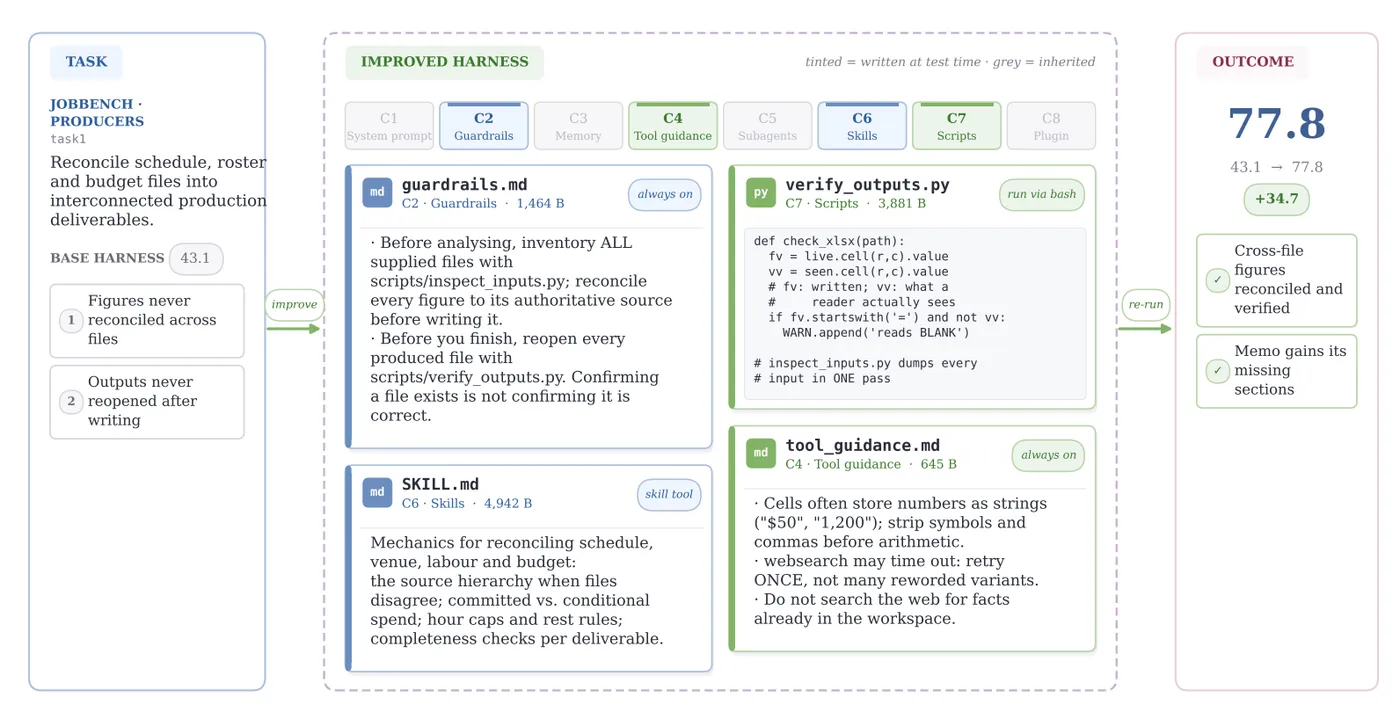
图 2:从执行缺陷定位到 Harness 修改。
上图展示了一次完整过程。在一个 JobBench 任务中,基础 Harness 得分为 43.1。执行轨迹显示,Agent 没有核对不同源文件中的数据,输出写完后也没有重新打开验证。通用流程方向加入了输入核对规则和验证脚本,领域方向加入数据核对 Skill 和针对特定数字格式的工具使用说明。组合器保留四项修改,重新执行后得分提高到 77.8。
通过并行和顺序递归扩大任务内探索
完成一轮“提出修改—试跑候选—组合修改”后,Harness² 还可以通过并行递归和顺序递归继续扩大任务内探索。
并行递归增加搜索宽度。系统同时生成并执行多组通用流程候选和领域候选,再由多个组合会话读取完整候选池,生成新的执行 Harness。当前实现只进行一次种群更新,因此 k 控制的是并行探索宽度。顺序递归则连续执行 k 轮修改,每一轮都继承上一轮的 Harness 和累计执行证据,后续步骤可以保留、调整或撤回已有修改。
两种方式都不只比较最终输出,还会继续利用候选 Harness 及其执行记录。k 大于 1 时,流程最后由匿名选择器从已有交付结果中选择最终输出。选择器看不到结果对应的 Harness,也不会生成新的内容;论文中的 H★ 只表示“被采用”,不代表经过验证的最优结果。
论文在 WB-Code 和 WB-Office 上测试了 k=1 到 5。并行递归和顺序递归在这一区间内都随预算增加而提高,而 Harness Scaling 和 ReasoningBank 的表现更不稳定。这个结果只对应测试范围,并不意味着递归预算增加后性能一定单调提升。
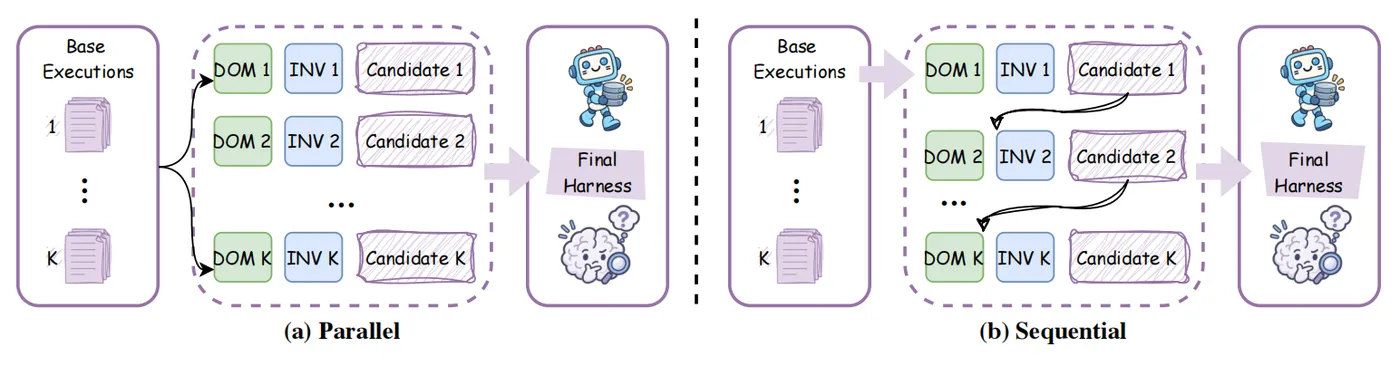
图 3:两种任务级递归方式。
结束后把修改经验写入改进经验库
任务完成后,Harness² 会回看整个修改过程,包括参考执行、候选 Harness、候选试跑、组合决策和最终选择结果,再判断哪些修改有足够证据支持,可以留给后续任务。
经验反思器会逐项检查组件修改,并标记为有帮助、有负面影响、未观察到效果或无法归因。最终被选中的候选不代表其中所有修改都有效;如果一个候选同时修改多个组件、现有执行结果又无法区分各项修改的作用,就会标记为“无法归因”,避免把没有证据支持的因果关系写入经验库。
一次任务最多写入一条长期经验,记录适用场景、可迁移的修改方法、执行证据和置信度;如果没有形成可复用的行为对照,则直接输出 NO_ENTRY。经验库同时保存完整的已采用 Harness 和 EXPERIENCE.md,因此后续任务既可以读取修改经验,也可以复用或调整过去生成的 Skill、脚本等组件。
下一项任务仍从 H0 开始,不直接继承上一项任务的执行 Harness。新的修改过程会读取经验库,并在提出候选、试跑和组合阶段使用这些历史信息。持续更新的是经验库,模型参数、修改阶段的指令、决策规则和改进算法保持固定。
过去积累的经验能否帮助后续 Harness 修改?
作者先测试了当前任务上的修改效果。只进行一次 k=1 的改进步骤,Harness² 在三个 Benchmark 和四种“执行模型—初始 Harness”配置上都高于对应的基础 Harness。最大提升分别为 WorkBuddy-Bench +11.5、JobBench +4.5,以及 LAB 的部分通过率 +11.8 个百分点。
随后,作者通过消融实验检查改进经验库、双方向编辑和组合步骤的作用。在 Gemini 3.5 Flash + OpenCode、k=1 的设置下,完整 Harness² 在 WorkBuddy-Bench 和 JobBench 上分别为 77.5 和 36.0。去掉经验库后降到 74.4 和 34.2;去掉通用流程与领域两个编辑范围后为 74.6 和 32.3;跳过组合步骤后为 75.9 和 34.1。三个组成部分被移除后,两个 Benchmark 的结果都下降。
作者进一步测试经验库对后续修改的帮助,作者使用不同任务级递归预算积累经验库,再把这些经验用于后续 Harness 修改。在这项实验中,当前任务不再运行新的参考执行和候选试跑,编辑过程直接利用已有经验库。没有参考执行、候选试跑和经验库的直接修改,会让 Code 从 73.4 降到 63.2,Web 从 69.9 降到 65.0;使用 k=1 积累的经验库后,表现基本恢复到基础 Harness 附近;使用 k=5 积累的经验库后,相比基础 Harness,Code、Web 和 Office 分别提高 0.9、4.4 和 5.1 分。
这组结果对应第二层递归假设:当前任务里增加 Harness 探索,可以产生更多执行记录和组合决策,这些记录被写入经验库后,能够支持之后的 Harness 修改。
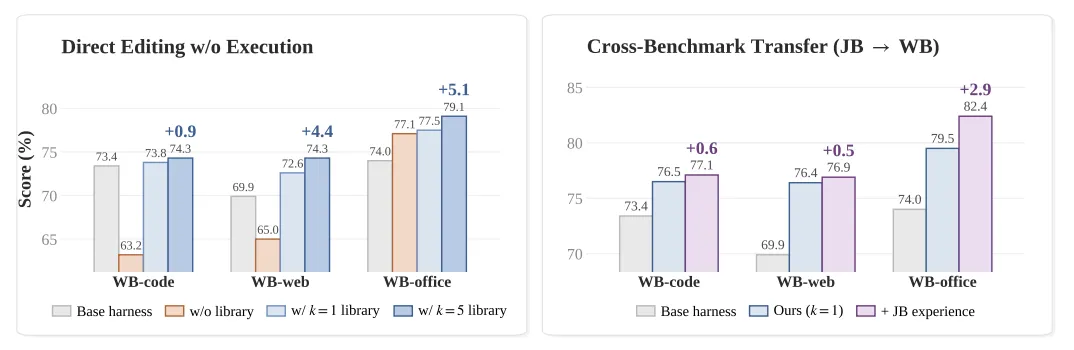
图 4:任务级探索对后续 Harness 修改的影响。
论文还测试了经验和 Harness 的迁移能力:
跨 Benchmark 实验中,在 WorkBuddy-Bench 已有的一步 Harness² 修改基础上加入 JobBench 经验库后,Code、Web 和 Office 分别再提高 0.6、0.5 和 2.9 分。
跨模型实验中,作者把针对 Gemini 3.5 Flash + OpenCode 修改出的 Harness 原样部署给 GLM-5、Gemini 3.7 Flash 和 Claude Opus 4.8,三个模型在 WorkBuddy-Bench 的 Code 和 Office 上都获得提升,其中 GLM-5 的 Code 从 58.5 提高到 75.8。
不同模型和任务领域的收益幅度差异较大。
作者还在 OpenCode、k=2 的设置下,让同一个模型同时承担执行和 Harness 编辑。从 GLM-5 到 Claude Opus 5,测试的五个模型在三个 Benchmark 上都高于各自的基础 Harness,说明这套修改流程在论文测试条件下不依赖一个能力更强的外部编辑模型。
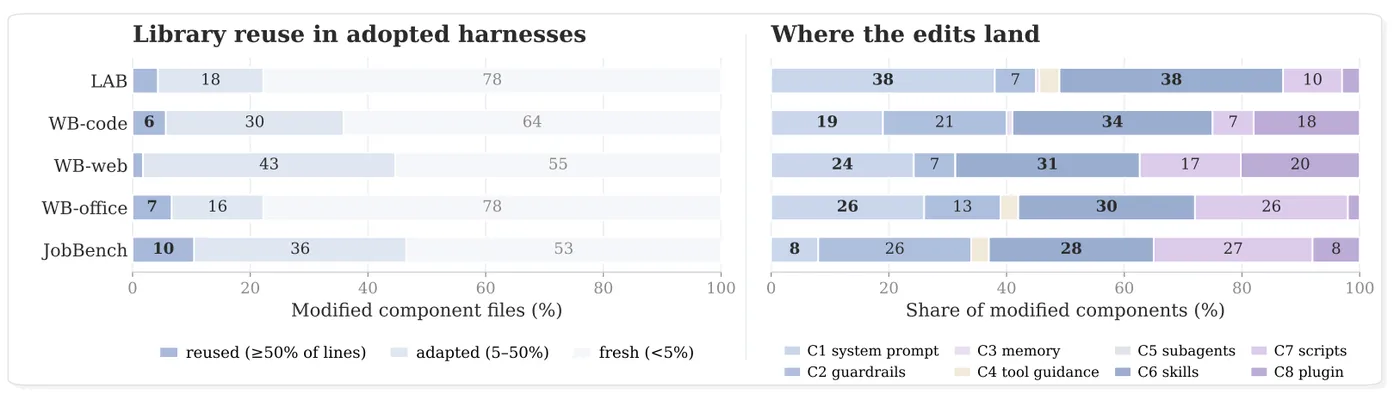
图 5:经验库组件的复用与修改分布。
上图进一步统计了历史组件的复用方式。只有 2%~10% 的修改文件会从某个经验库条目中保留至少一半的代码行,说明后续 Harness 更多是在已有组件基础上继续调整,而不是直接复制。Skill 和脚本合计约占各 Benchmark 一半的组件修改。
行为对照仍然存在判断误差
Harness² 依赖执行结果和模型判断来指导 Harness 修改,因此仍然会出现错误归因和错误选择。下图中汇总了 9 个退化案例,主要包括选择器选错结果、错误前提在候选中传播,以及执行和评测波动带来的归因困难。
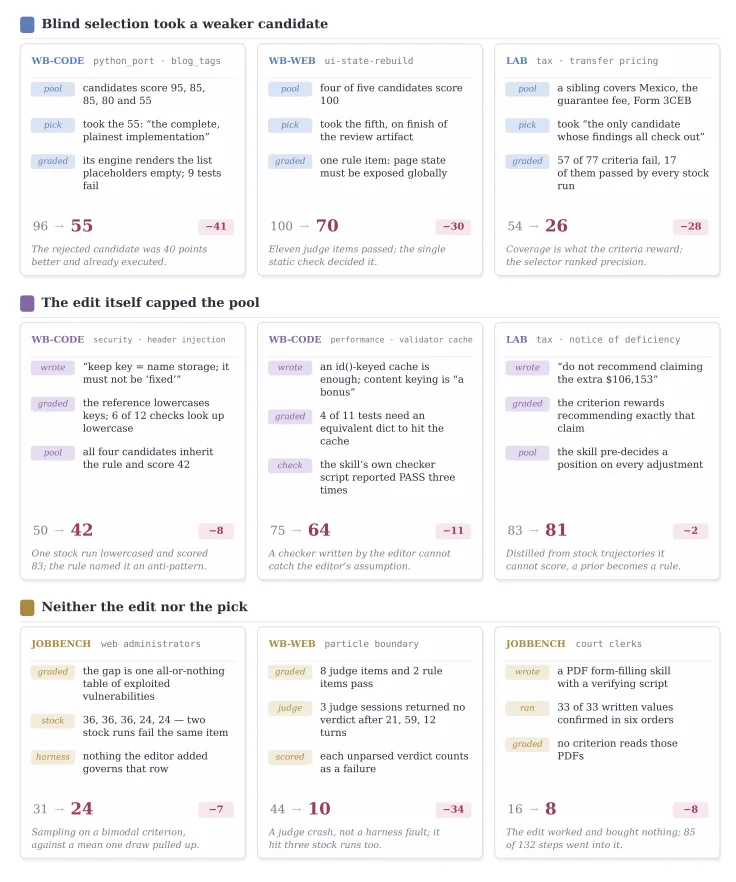
图 6:Harness 修改中的退化案例。
一个 WorkBuddy-Code 案例中,候选池已经包含 95 分的结果,匿名选择器最后却选中了 55 分的版本,并将其判断为“实现最完整、最简洁”。实际测试中,这个版本有 9 项测试失败。候选池最好结果与最终结果相差 40 分;图中标出的 −41,则是参考执行从 96 分降到最终的 55 分。
另一类问题来自错误前提传播。在 Validator Cache 案例中,编辑器根据执行过程形成了错误的缓存键规则,并据此修改 Harness。随后生成的检查脚本连续三次判断通过,但真实评测要求不同的键值策略,最终得分从 75 降到 64。只要参考执行、候选修改和检查逻辑共享同一个错误假设,行为对照仍可能为错误修改提供正向信号。
论文还记录了执行结果波动、缺失评审结果,以及修改没有覆盖实际评测要求等情况。作者在局限性中明确指出,没有标准答案时,行为对照和模型判断会受到执行随机性与共享模型偏差影响,不能保证任务正确,也不能保证已经采用的 Harness 修改能够迁移到其他任务。
递归改进还需要额外计算和经验库维护
Harness² 的每轮修改都需要额外的候选生成、执行和编辑会话,因此递归预算增加时,推理成本也会继续上升。并行执行可以缩短等待时间,但不会减少总计算量。论文只在有限预算范围内分析了性能与计算成本的关系,没有给出统一适用的递归预算。
当前的改进经验库也只是简单的索引结构。随着经验增加,重叠组件合并、过期经验更新、检索优化,以及根据任务难度和已有经验动态分配递归预算,都被作者列为后续工作。
从当前 Harness 修改到跨任务积累修改经验
Harness² 的两层递归对应两类状态更新。任务级递归处理当前任务:从参考执行中发现问题,提出不同方向的候选 Harness,通过试跑形成行为对照,再根据执行证据组合新的 Harness。并行和顺序递归可以继续扩大当前任务中的修改搜索。
改进级递归处理任务之间的信息积累。任务结束后,经验反思器重新检查各项 Harness 修改和执行结果,把有证据支持的组件与经验写入经验库。下一项任务依然从 H0 开始,但新的 Harness 修改过程可以读取此前保存的组件、适用场景和执行证据。
实验表明,在作者测试的任务流中,这些积累下来的经验能够改善后续 Harness 修改,并出现了跨 Benchmark 和跨执行模型的复用结果。同时,研究保留了几个明确边界:行为对照不能替代标准答案,选择器仍然可能选错,错误前提可能多个候选中传播,经验迁移也没有稳定保证。
Harness² 因此给出了一种 Harness 层面的递归改进方式:模型参数保持冻结,当前任务修改执行 Harness,任务结束后再把修改过程中的可执行组件和有证据支持的经验留给后续任务。
参考资料
Harness²: Recursive Agent Harnessing for an Open World; arxiv.org/abs/2610.14224 Github 地址:github.com/google-research/harness2