这期的「周一上线」,一边是模型继续向多模态和机器人延伸,另一边是 Agent 开始从“会写代码”走向长期协作、完整交付和自我改进。
DeepSeek 把 V4-Flash 接进 Codex,MiniMax H3 把文本、图像、视频和音频放进同一条创作链路;OpenAI 新模型 Astra 浮出水面、Lilian Weng 负责的 RSI 团队,以及贾扬清的 Intent Lab,则都在探索如何让 AI 持续工作,并真正交付生产系统。
行业里,AlphaFold 明星团队被拆分,字节也重新整合飞书、豆包和火山引擎。模型在升级,围绕 AI 的产品边界和组织方式也在跟着重排。
下面,开始一周回顾。
有点新鲜
「有点新鲜」收录本周 AI / 开发者圈里那些不算大新闻,但挺值得看一眼的新鲜事。
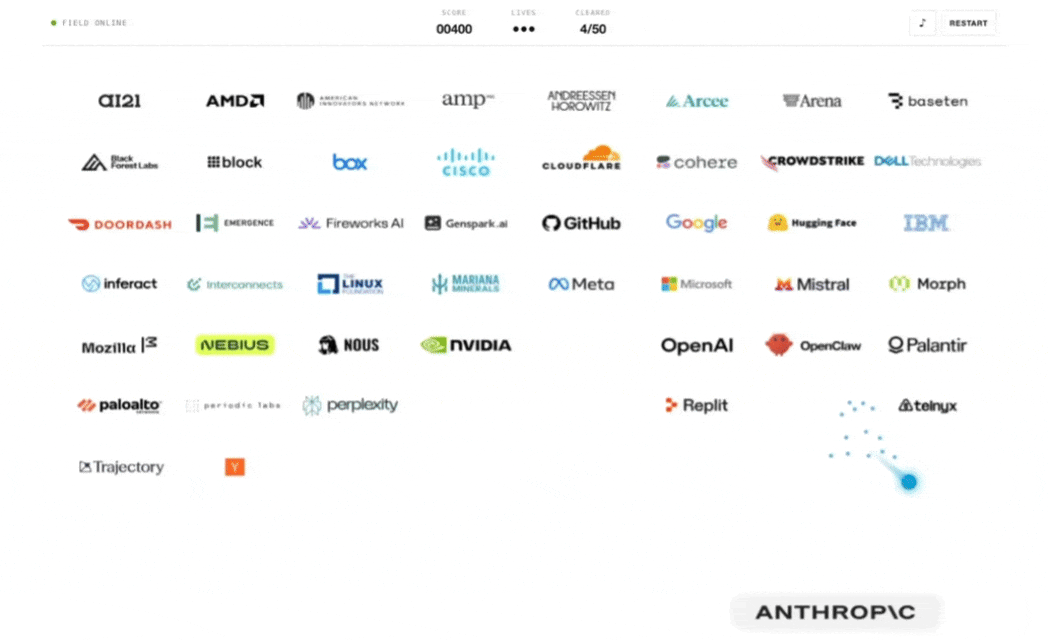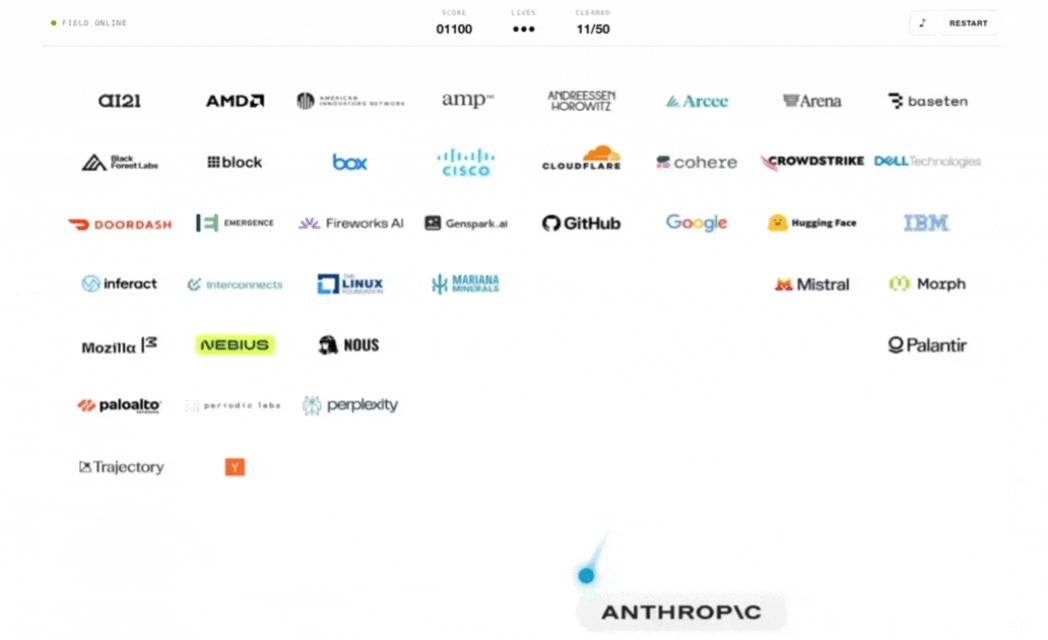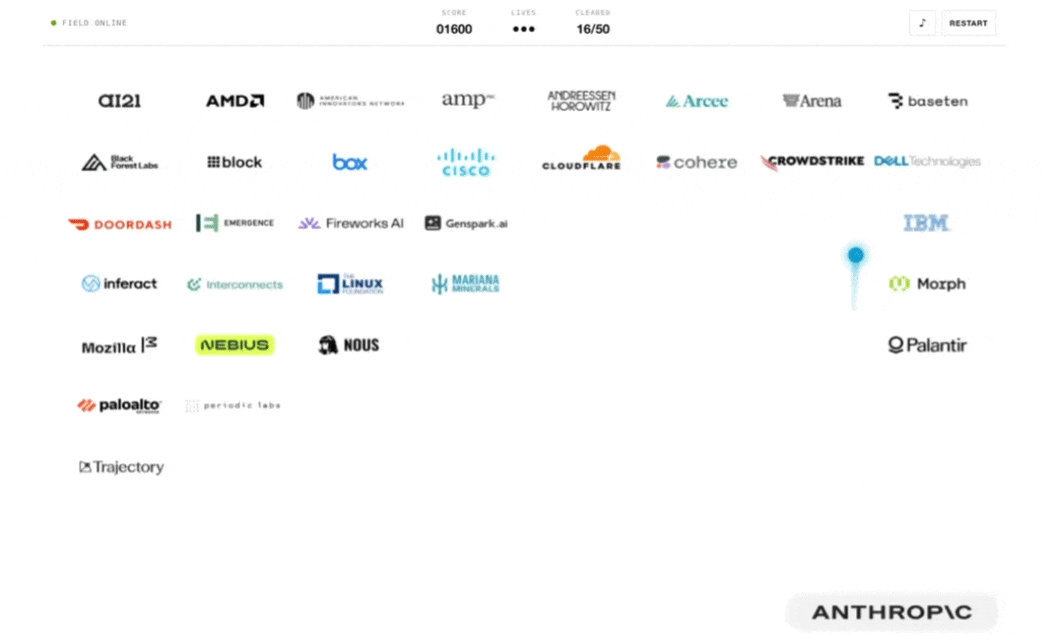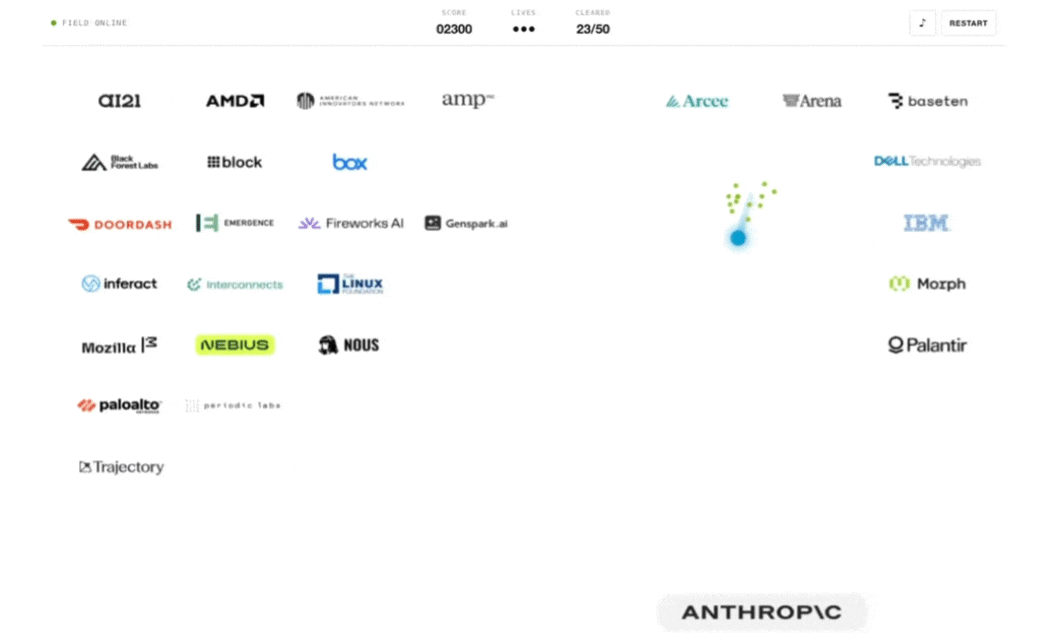
Anthropic:我就不签~
别人负责支持开放权重,Anthropic 负责把大家逐个“打掉”。
DeepSeek: The real “Open AI”?
7 月 31 日,DeepSeek 上线 V4-Flash-0731 正式版。网友 @Jen Zhu 惊呼:The real “Open AI” of the world!
在 Artificial Analysis Intelligence Index v4.1 的测评图中,V4-Flash-0731 位于约 0.03 美元/任务、约 50 分的位置。网友又在这张图上标出 V4 Pro 正式版的预期位置,并划出 DeepSeek 版“斩杀线”范围。


另外,DeepSeek Harness 团队负责人 Tianyi Cui(崔添翼)也在 X 上公开征集内测开发者:做过 Agent Harness 相关开源项目的开发者,可以带上 GitHub ID 和代表作,报名参与 DeepSeek Harness 内测。

Head-controlled cursor:把光标交给脑袋
@Marcin 用 Replit 和 Higgsfield 做了一个头控光标:脑袋往哪动,光标就往哪走。为了更适合日常使用,他还给 Claude、Webflow 等工具加上了毛茸茸的 Logo,操作起来像是在用头顶宠物。

双手继续敲键盘,光标以后就靠点头控制了。
Biiiig bug 更容易被发现
@Itsvishal 分享了一位开发小哥古法编程界面,你猜他是忘记关倍镜还是忘了带眼镜?

周五发版
「周五发版」是一个程序梗:一旦版本上线,我们就要开始祈祷一切如期运行。这个模块寓意,所有模型、产品版本更新,都能大吉大利。
DeepSeek V4-Flash 正式版发布:Agent 能力大幅提升
7 月的最后一天,DeepSeek V4-Flash 正式版上线,官方 API 同步公测。新版本重点强化 Agent 能力,在 Terminal Bench 2.1、Cybergym、DeepSWE 等评测中明显超过 Preview 版。

模型原生支持 Responses API,并适配 Codex CLI、ChatGPT 桌面端和 VS Code Codex 扩展。模型支持 1M 上下文和最高 384K 输出。当前缓存命中输入价格为 0.02 元/百万 tokens,缓存未命中输入为 1 元/百万 tokens,输出为 2 元/百万 tokens。
MiniMax H3 发布:统一理解文本、图像、视频和音频
同一天,稍早于 DeepSeek V4-Flash 正式版,MiniMax 发布了通用多模态生成模型 H3。该模型可统一理解文本、图像、视频和音频组成的上下文,并生成带原生双声道音频的视频,最高支持 15 秒、2K 分辨率及原生多镜头建模。

在模型能力层面,H3 将文生图、文生视频、文生音频和广义参考编辑纳入同一套训练体系。当前面向开发者开放的是 Video Generation V2 接口:指定 MiniMax-H3 后,可完成文生视频、首尾帧图生视频和多模态参考生视频,输入可包含文本、图片、视频和音频,输出支持 768P、2K,生成时长为 4~15 秒。
Dreamina Seedance 2.5 上线:单次生成 30 秒,长视频可达 3 分钟
Dreamina AI 全球上线 Seedance 2.5。新模型原生支持单次生成最长 30 秒视频,长视频模式最长可扩展至 3 分钟,并强化了人物、光影和动作在长镜头中的一致性。

Seedance 2.5 支持局部交互式编辑和精确到 1 秒的时间点控制,最多可输入 50 份图片、视频、音频等多模态参考,并新增 3D 白模和绿幕素材支持。Dreamina 还提供 Maya、Blender 插件,进一步面向影视制作流程。
Gemini Robotics 2 发布:让机器人具备全身智能
7 月 30 日,Google DeepMind 发布 Gemini Robotics 2 系列,包括负责动作控制的 Gemini Robotics 2、负责任务规划与多机器人协作的 ER 2,以及可在设备端运行的 On-Device 2。

新模型可以控制人形机器人完成行走、弯腰、抓取和整理等全身任务,也支持更精细的手部操作与多机器人协作。Gemini Robotics ER 2 已上线 Google AI Studio,其余模型目前主要面向早期合作伙伴开放。
Grok Voice Think Fast 2.0 发布:边说边想,首段音频延迟约 0.7 秒
7 月 29 日,xAI 发布 Grok Voice Think Fast 2.0,重点提升语音推理、转写准确率、对话自然度和工具调用能力。模型能够在生成语音的同时进行推理,在 Artificial Analysis 的 Speech-to-Speech Quality Index 中得分 82.9%,首段音频延迟约为 0.7 秒,表现大幅领先其前代模型。

价格为 0.08 美元/分钟音频。官方称 8 月 5 日起,grok-voice-latest 将自动切换至 2.0;需要继续使用旧版本的开发者需固定模型版本。
微软开源 Mage-VL:直接利用视频编码信息理解画面
近日,微软开源 4B 多模态模型 Mage-VL。它不再只依赖均匀抽帧,而是保留 I 帧信息,并结合运动向量和残差能量,从 P 帧中筛选更重要的视觉区域。相较均匀抽帧方案,官方测试中视觉 Token 减少 75% 以上,wall-clock 推理速度最高提升 3.5 倍。

Mage-VL 支持图片、长视频和实时视频理解,还加入了主动流式响应机制:日常画面保持沉默,在检测到值得回应的事件后再生成解说。模型以 Apache 2.0 协议开放。
另外,早些时候微软还发布了轻量语音识别模型 VibeVoice-ASR-BitNet,面向边缘设备 CPU 推理,无需 GPU。模型通过混合量化从 4.62GB 压缩至 1.58GB;在官方测试环境中,使用 3 个 CPU 线程即可达到实时转写,推理速度约为 Whisper.cpp 的 1.6~2.3 倍。

模型支持英语、中文、法语、意大利语、韩语、葡萄牙语和越南语等语言,采用 MIT 协议开放,并可通过 llama.cpp、Ollama 等工具本地运行。
开源雷达
周榜速递
周榜主要根据新增 Star 数进行排名,下面的单项目讲解则偏向新晋项目、实用老项目,标星并非单项目讲解的唯一指标:

Cognee:给 Coding Agent 加上长期记忆
Cognee 是一个开源 AI Memory 平台,可将文档和其他数据转换为自托管知识图谱,并结合向量检索与图关系推理,让 Agent 跨会话保存、检索和更新上下文。

项目提供 Codex CLI 和 Claude Code 插件,可自动记录 Prompt、工具调用和回答,在后续任务中召回相关信息,并将会话记忆同步为长期知识。
Codex Security:用 Agent 扫描代码安全漏洞
OpenAI 开放了 Codex Security 的 CLI 和 TypeScript SDK,可用于发现、验证并修复代码中的安全漏洞。它支持扫描本地项目、保存和对比多次扫描结果,也可接入 CI 或通过容器批量扫描仓库。

项目目前需要 Codex Security 访问权限,并建议账号先完成 Trusted Access 验证。
Mole:在终端里清理和维护 Mac
Mole 是一款面向 macOS 的终端维护工具,集成系统清理、应用卸载、磁盘分析、性能监控和开发产物清理等功能。它不仅删除应用本体,还会查找缓存、配置、启动项等残留文件。

涉及删除操作的命令支持 --dry-run 预览,并提供路径保护、操作记录和白名单机制,降低误删风险。
text-to-cad:给 Agent 补上 CAD 与机器人设计能力
text-to-cad 已扩展为一套面向 CAD、机器人和硬件设计的 Agent Skills。Agent 可以根据自然语言或图片创建、修改和预览 CAD 模型,并输出 STEP、STL、3MF、GLB 等格式。

项目还提供 DXF、G-code、URDF、SDF、SRDF 和零件检索等 Skills,可作为插件接入 Codex 和 Claude Code,将建模、仿真和制造交接串进 Agent 工作流。
LobeHub:把多个 Agent 组织成一支 AI 团队
LobeHub 是一个多 Agent 工作平台,可集中创建、调度和管理不同 Agent,并通过 Agent Groups 让它们并行协作。平台还提供定时任务、项目空间、共享上下文和可编辑的个人记忆。

它支持多模型、MCP 插件和上万种 Skills,也可通过 Docker、Vercel 等方式自行部署,适合搭建持续运行的个人或团队 Agent 工作台。
这周有事
「这周有事」收录本周值得记一下的行业动态、事故、融资、人员流动和基础设施变化。
OpenAI 下一代模型 Astra 浮出水面
据 The Information 报道,OpenAI 正在测试代号为 Astra 的新模型,并已向华盛顿的政策制定者和监管人员进行演示。知情人士称,它重点强化长时间任务执行和多 Agent 协作,可用于项目级工作及高难数学问题;最终名称和发布时间尚未确定。

8 月 1 日,OpenAI 随后在官方文章中正式使用了 Astra 这一名称,并将其称为“下一代主要模型”。OpenAI 表示,Astra 的内部版本已完成 10 项数学与理论计算机科学新结果,但尚未公布其产品形态、正式名称和上线时间。
AlphaFold 独立团队被拆,成员分流至多个项目
据《金融时报》报道,Google DeepMind 的 AlphaFold 团队已不再作为独立团队存在,成员被分流至 Gemini、AI Coding、基因组研究、蛋白质与酶设计、核聚变及 Isomorphic Labs 等项目;AlphaFold 2 负责人、诺贝尔化学奖得主 John Jumper 也已加入 Anthropic。

Google 方面回应称,这并不意味着放弃 AlphaFold 或 AI for Science,而是将原团队积累的能力扩展到更多科学问题。更准确地说,AlphaFold 没被“砍掉”,但那支围绕单一难题长期攻坚的明星团队,确实已经被拆开了。
Lilian Weng 重返 OpenAI,负责递归自我改进
因健康原因离开 Thinking Machines 后不久,联合创始人 Lilian Weng 重返 OpenAI。OpenAI 向 Business Insider 证实,她将领导一个聚焦“递归自我改进”(RSI)的团队,探索如何用 AI 加速模型研究、训练和评估。

值得注意的是,Lilian Weng 7 月初刚发布《Harness Engineering for Self-Improvement》,提出当前更现实的自我改进入口,可能不是让模型直接修改权重,而是持续优化规划、上下文、工具调用和工作流等 Harness。不到一个月,这个研究方向变成了她的新岗位。
贾扬清启动 Intent Lab,组建自主 Agent「舰队」
7 月 29 日,贾扬清宣布启动 Intent Lab,计划组建一支名为「Fleet」的自主 Agent 团队,把用户意图转化为可投入生产的软件系统。

团队同步展示了首批早期成果,包括其宣称的最快 GLM-5.2 推理引擎、一次完成数据库搭建,以及经过完整验证的 Agent 文件系统。Intent Lab 希望让多个 Agent 接管从开发、测试到验证的工程流程,而不只是单独生成代码。
目前项目仍处于早期阶段,“最快推理引擎”等结论来自团队自身,仍需等待更完整的技术资料与第三方测试。
字节整合飞书、豆包与火山引擎,AI ToB 再提级
据《科创板日报》报道,字节跳动于 7 月 30 日启动 AI 业务组织调整:飞书产品团队与豆包产品团队在组织层面整合,成立新的豆包产品团队,由赵祺负责;原有飞书产品和服务保持不变,后续将与豆包加强生产力场景协作。
与此同时,飞书 GTM 团队与火山引擎团队整合,成立新的 ToB GTM 组织,统一负责 MaaS、SaaS 等云服务的市场、销售和客户服务。这次调整主要发生在组织与商业化体系层面,核心方向是加强豆包、飞书和火山引擎之间的协同。