Open WebUI:给团队一个只在自己机房里说话的 AI 助手

简介: Open WebUI 把模型、文档、账号和权限包成一个浏览器页面,装在你自己的服务器上,团队聊什么、传什么都在自己机房里。通过阿里云计算巢部署,实例通过控制台安全代理访问,不用自己配 TLS、反向代理和网关认证。
Open WebUI · 自己服务器上的 AI 聊天与知识库

想给团队开 AI,法务只问了一句"资料存哪儿"

你是十几个人的技术团队负责人。大家早就在用大模型写周报、查接口、读合同,但用的是公网聊天框,客户资料和内部接口文档就这么贴进去了。法务问了一句"资料存哪",你才发现这问题没有答案。你需要的是一个自己的入口:账号你来开、模型你来选、对话记录留在自己的机器上。

一个装在自己服务器上的 AI 前台

Open WebUI 接手的是「人怎么用上模型」这一段:把模型、文档、账号和权限包成一个浏览器页面,装在你自己的服务器上。

它同时对接 Ollama 本地模型和任何 OpenAI 兼容接口,内置文档知识库(RAG)、联网搜索、图像生成、多模型切换和分组权限。模型本身仍由你指定的服务提供,界面、会话和知识库数据都留在实例里。

边界也说清楚:

  • 它做:聊天界面、多模型接入与切换、文档知识库、成员与分组权限、插件扩展。
  • 它不做:不自带模型,得填 OpenAI 兼容地址或 Ollama 地址;不是向量数据库,也不是训练和微调平台。
  • 对话与知识库数据落在自己的实例里,不会因为部署被带到别处。

通过阿里云计算巢部署,实例通过控制台安全代理访问,不用自己配 TLS、反向代理和网关认证。

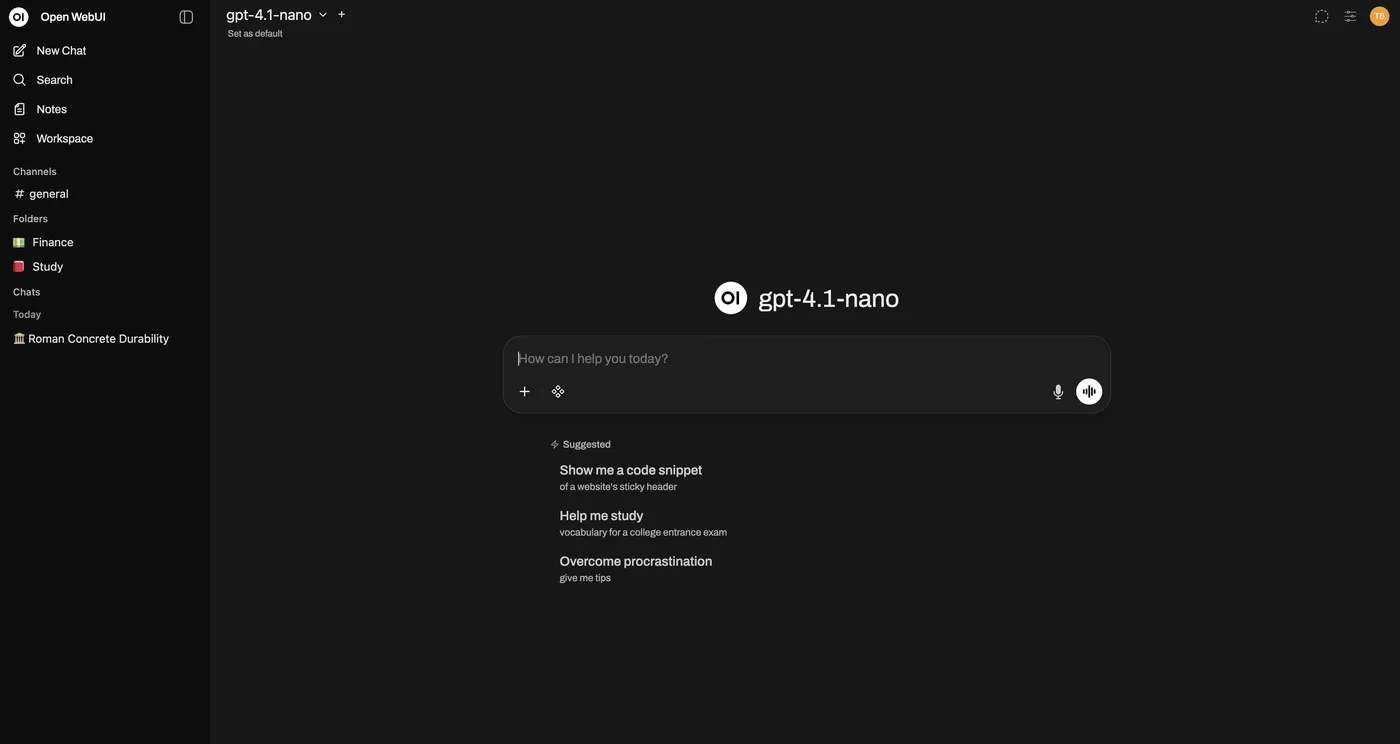
Open WebUI 主界面:左边是会话、笔记和工作区,中间选好模型就能开聊

它解决了什么问题

你原来怎么干 代价 用它之后
员工各自用公网 AI 工具 资料出域,事后无法审计 统一私有入口,谁能用哪些模型你说了算
直接调模型 API 没有界面,非技术同事用不上 打开浏览器就能用的聊天页
想让 AI 读内部文档 自己拼切片、嵌入、检索那一套 文档传上去就成了可引用的知识库
新人来了开权限 一个个手动配,容易漏 分组与角色,按组一次性授权

回到那天下午:你部署好实例,把模型地址填进管理后台,拉一个"研发"分组,再把这批接口文档传进知识库。第二天团队在同一个入口里问同一份资料,数据一直没出过自己的机房。

而更深一层的变化是:能安全用 AI 的范围,从"敢贴的人"扩大到了整个团队。以前合规敏感的活只能靠自觉绕开 AI,现在这些活也能放进同一个对话里做。

核心能力

一个入口接住所有模型

  • 本地与云端并存 —— Ollama 和 OpenAI 兼容接口可以同时挂着,对话里直接换。
  • 模型级权限 —— 管理员决定哪个分组能看见哪些模型,不用为了管权限再换一套系统。
  • 填地址就接上 —— 各家兼容接口填 URL 和 Key 即可,换一家不动前端。
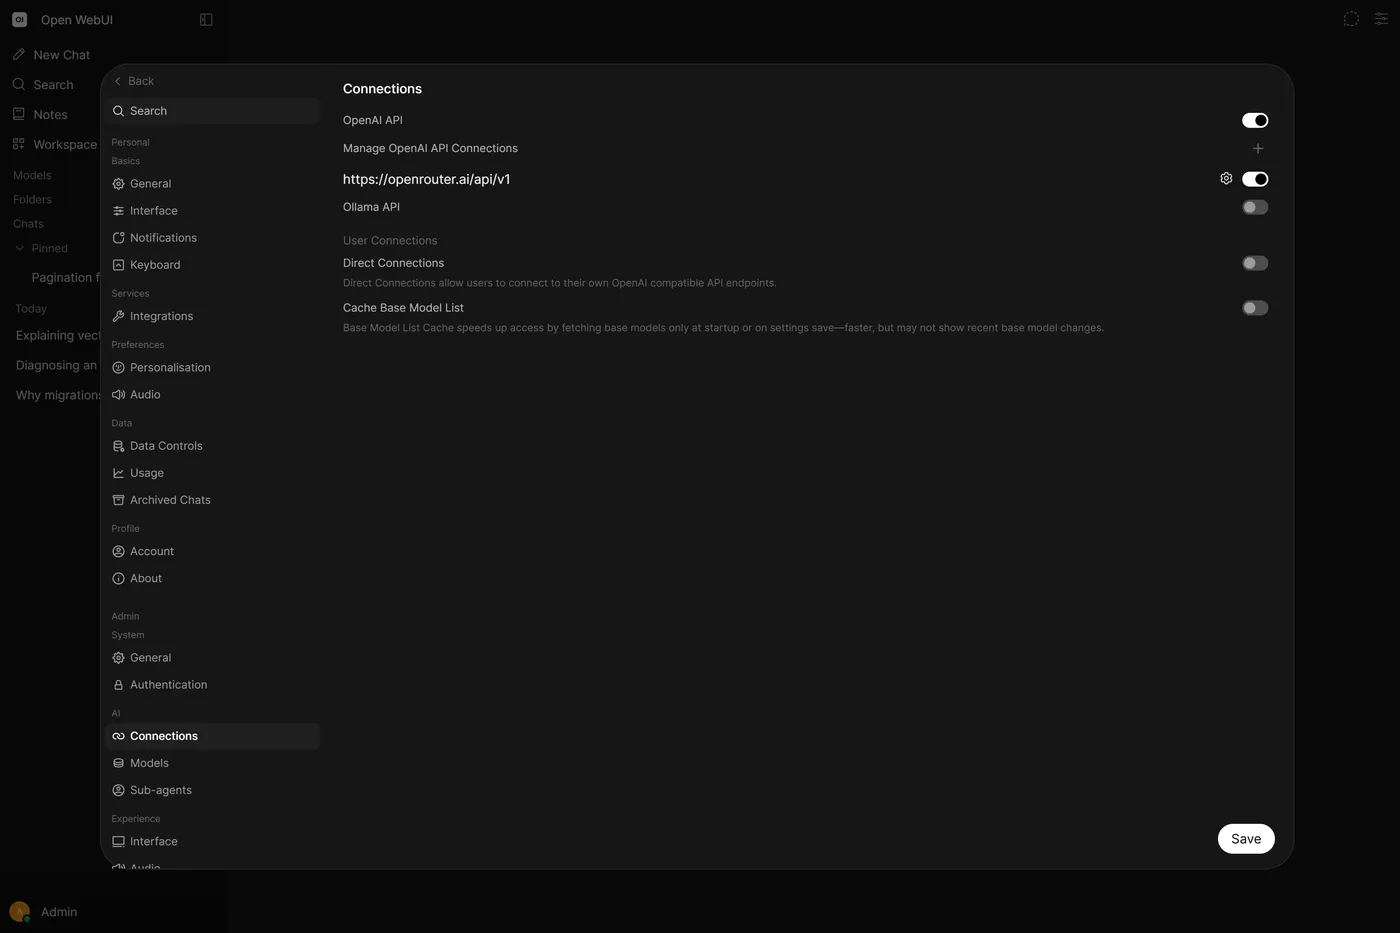
管理后台的模型连接页:OpenAI 兼容接口与 Ollama 各一个开关,地址填在下面

让内部文档变成能问的

  • 上传即成库 —— PDF、Word、Markdown 传上去,对话时引用原文作答。
  • 联网可选 —— 需要公开信息时打开搜索,私有资料和公开信息分开用。

团队里有人管得住

  • 账号与分组 —— 注册开关、角色、成员组,按组分配能力。
  • 用量看得见 —— 谁在用、用的什么模型,管理员在后台能看到。

需要更多时自己加

  • 插件体系 —— 过滤器、工具、动作按需装,接内部系统不必改源码。
  • 频道与笔记 —— 团队共享的空间和对话外的草稿都在同一个界面里,不用另开文档工具。

谁最该用

用户类型 典型场景 用它拿到什么
对数据合规敏感的技术负责人 客户资料不能贴进公网 AI 数据留在自己实例里的团队聊天平台
想让全员用上模型的公司 员工各用各的,没人管 一个带账号和权限的统一入口
自己跑了 Ollama 的开发者 模型有,缺一个好用的前端 现成的多模型管理界面

技术支持


🚀 立即体验

→ 一键部署 Open WebUI

部署完成后从实例详情页的安全代理地址进入,第一件事是在管理员设置的「连接」里填上你的模型地址,随后就能建账号、拉分组。
相关文章
|
26天前
|
人工智能 移动开发 自然语言处理
千问办公QwenWork指南:介绍、能力、官网、使用、版本及价格说明
千问办公(QwenWork)是阿里巴巴推出的一站式AI Agent生产力平台,支持“对话即交付”:用户用自然语言描述需求,即可自动生成PPT、Excel、网页、报告等可落地成果;深度集成钉钉,覆盖多端,赋能个人与企业高效办公。阿里千问办公QwenWork官网:https://t.aliyun.com/U/0VCTGt
|
25天前
|
监控 Java 关系型数据库
SpringCloud Alibaba完整使用
SpringCloud Alibaba 微服务全栈实战教程,从零带你搭建 Nacos 注册配置中心、Gateway 网关、Sentinel 限流熔断、Seata 分布式事务、OpenFeign 远程调用等完整微服务组件。配套全套视频教程 + 保姆级搭建文档,手把手教你跑通微服务项目,适合在校生、转行及 1-3 年后端开发者学习练手、简历加分,文末可领学习资料与技术交流群。
|
28天前
|
人工智能 安全 测试技术
Agent 也要被测试:如何评测一个 Agent 的 Skills?
本文探讨AI Agent中Skill评测的核心挑战与实践方法:指出Skill失效常表现为“行为漂移”而非报错;提出三层评测体系——静态校验(结构/安全/去重)、轨迹评估(步骤与序列合理性)、端到端配对测试(A/B对照测Skill Lift);强调需兼顾结果有效性、路径合理性、副作用与退化风险,并倡导将评测嵌入CI门禁,用最小可行方案启动防退化机制。
|
26天前
|
存储 缓存 安全
阿里云2核2G99元和2核4G199元云服务器活动,最长4年续费周期,个人建站首选
本文梳理阿里云99元经济型e实例(2核2G/3M/40G)与199元u1实例(2核4G/5M/80G)的适用场景、参与资格、续费规则与成本结构。二者面向个人开发者、学生、小微团队等入门上云用户,在活动延期至2029年3月31日的规则下,符合条件者经多次续费可接近4年低价持有。文章提醒用户关注配置一致性、续费窗口、保有数量与截止时间,并按项目生命周期选型,做好域名、备案、存储与备份等完整成本规划。
|
27天前
|
缓存 前端开发 程序员
DeepSeek-V4.1-Flash-1017 上手实测:3D 直出,效果到底如何
DeepSeek-V4.1-Flash-1017 上手实测:3D 飞行特斯拉、千里江山、折叠掌机一次直出,跑分 77%、最高档单任务 1.3 元
DeepSeek-V4.1-Flash-1017 上手实测:3D 直出,效果到底如何
|
26天前
|
弹性计算 网络安全 API
阿里云服务器199元1年购买与使用常见问题:2核4G5M带宽,续费同价,企业用户专享
阿里云企业专享轻量服务器:2核4G+5M带宽,仅199元/年!需企业实名认证,支持续费同价与专票。5M带宽(0.625MB/s)适合博客、API、管理系统等,搭配CDN更佳。含安全组配置、宝塔/Docker一键部署、快照备份及免费SSL指南,是初创团队高性价比之选。(239字)
220 0
|
26天前
|
弹性计算 人工智能 安全
真香啊!DeepSeek Harness保姆级教程:基于阿里云计算巢已部署安装Deepseek-Harness社区版
本方案介绍如何通过阿里云计算巢,一键部署开源智能体框架 DeepSeek Harness(基于 Cordis 引擎、“一切皆插件”架构),支持快速接入 DeepSeek/兼容大模型,构建专属 AI Agent 平台。阿里云计算巢官网:https://t.aliyun.com/U/PEl9rE
|
26天前
|
人工智能 API 调度
阿里云百炼 Token Plan 深度解析:统一额度计费,底层架构与 API 接入指南
Token Plan通过统一Credits抵扣、多协议网关适配、多模型资源池调度的架构,解决了传统多模型开发中计费复杂、工具集成繁琐、账单管理困难的痛点。一份订阅,即可调用文本、图像、视频、语音等多模态模型,搭配联网检索、代码解释器等Agent工具,并且兼容市面上主流AI编程客户端,大幅降低AI应用开发成本。
206 0
|
26天前
|
弹性计算 人工智能 安全
从 0 到 1 玩转 DeepSeek Harness 保姆级教程:阿里云计算巢 + ECS 一键部署,含百炼 API Key 配置与代码命令+避坑教程
综合来看,基于阿里云计算巢 + ECS 搭建 DeepSeek Harness 智能体平台,门槛低、上手快。先获取百炼 API Key(注意地域隔离与密钥保存),再通过计算巢一键部署,最后通过 Nginx 反向代理与计算巢安全代理安全访问 Web UI,即可投入使用。开发者也可以不依赖计算巢,直接使用 npx 命令或源码安装方式在本地或 ECS 上运行。部署时重点关注 API Key 只显示一次、地域不能混用、13080 与 3080 端口分工等要点,即可快速搭建一套功能完整、安全可控、可灵活扩展的 AI Agent 平台,支撑各类智能体应用的开发与落地。
199 0
|
27天前
|
人工智能 缓存 测试技术
阿里云Qwen3.8-Max和Qwen3.8-flash模型选型指南:场景、成本与优惠全解析‌
本文重点拆解阿里云千问热门模型Qwen3.8-Max和Qwen3.8-flash的区别,并帮助新手用户判断应该怎么选、怎么用、怎么买更便宜。简单说:Qwen3.8-Max适合复杂任务、长上下文、高价值推理;Qwen3.8-flash适合高频轻量、低成本、快速响应。新手用户不要一开始就盲目选择旗舰模型,也不要为了省钱而让轻量模型处理复杂任务。正确做法是根据任务复杂度分层调用,并结合免费试用、夜间活动、Token Plan订阅等方式控制成本。

热门文章

最新文章