一、一次「优化」的完整时间线
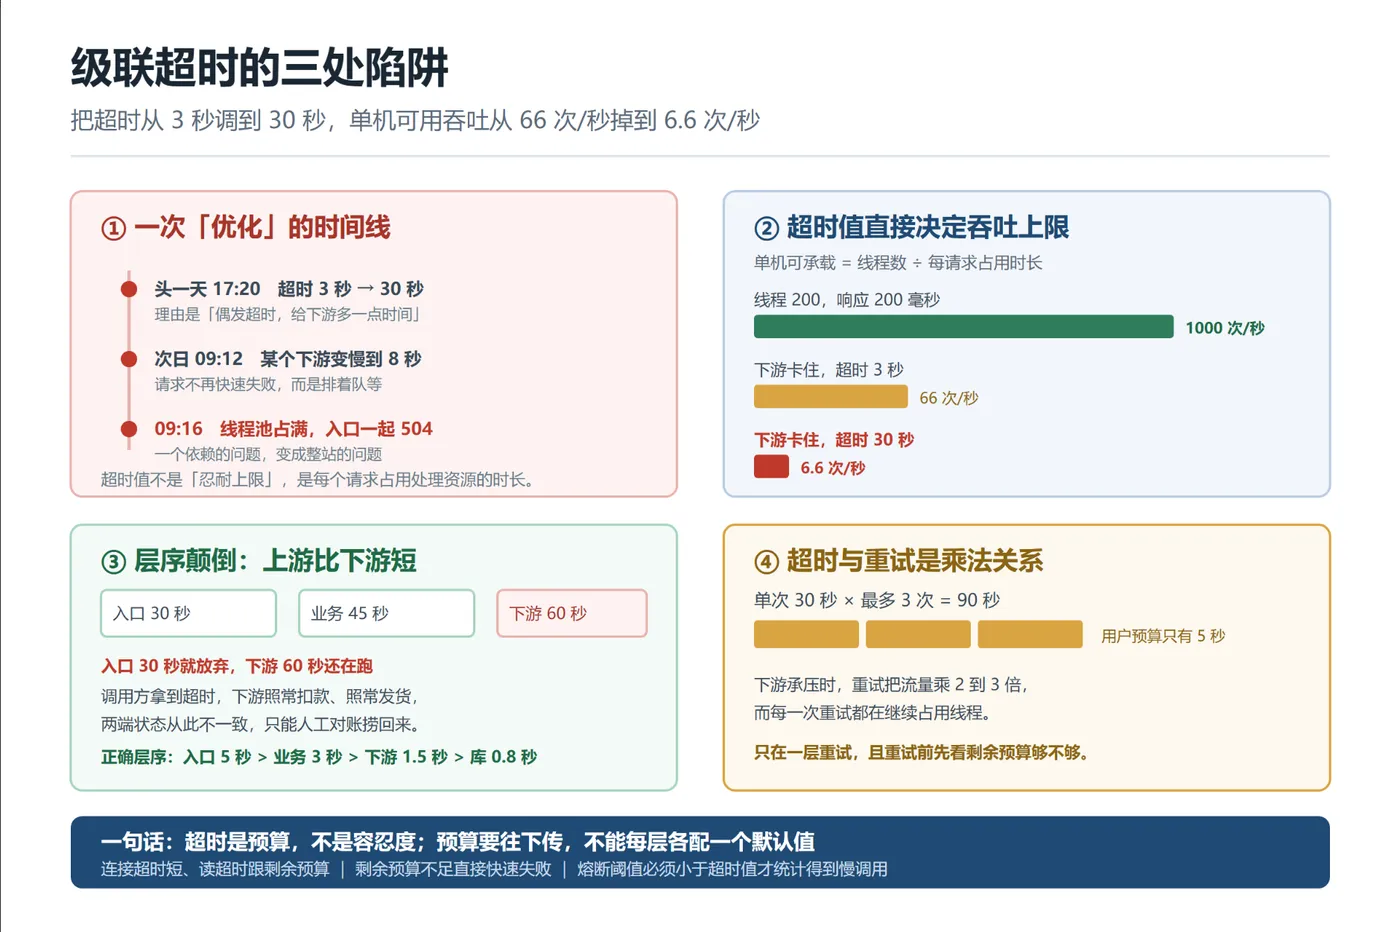
头一天下午,值班同事提了个改动:对接开放平台的订单查询接口偶发超时,「把超时从 3 秒调到 30 秒,给下游多一点时间」。改动本身一行代码,评审很快就过了。
次日上午 09:12,那个下游接口因为慢查询整体变慢,单次响应要 8 秒。接下来的四分钟里发生了这些事:
- 09:12,请求不再快速失败,全部开始等;
- 09:14,线程池 200 个线程全部挂在等待上,新请求进不来;
- 09:16,入口所有接口一起 504——包括那些根本不依赖这个下游的接口。
一个依赖的局部问题,四分钟变成整站问题。而这次扩散的加速器,恰恰是前一天那行「优化」。
二、陷阱一:超时值决定吞吐上限,不只是「等多久」
大多数人对超时的理解是「最长等多久」。换个角度:在同步调用里,超时值就是每个请求占用线程的时长上限。
单机能扛多少并发,取决于线程池大小;每秒能处理多少请求,等于线程数除以每个请求占住线程的时间。下面这张表按这个算式推算(示意量级,不是生产实测,换成你自己的池大小和耗时重算即可):
| 场景 | 每请求占用线程 | 200 线程的吞吐上限 |
| 下游正常,响应 200 毫秒 | 0.2 秒 | 约 1000 次/秒 |
| 下游卡住,超时 3 秒 | 3 秒 | 约 66 次/秒 |
| 下游卡住,超时 30 秒 | 30 秒 | 约 6.6 次/秒 |
看清楚这组数字的含义:下游正常时,超时值不影响任何东西;下游一卡,超时值就是你的存活时间。 把 3 秒改成 30 秒,等于把单机在故障下的承载能力砍到十分之一。调大超时不是「更宽容」,是「更脆」。
这也是为什么服务端日志看起来一切正常、CPU 和内存都健康,调用方却大面积超时——请求根本没排上队,线程全被前面的等待占着。
三、陷阱二:层序颠倒,上游先放弃
第二处陷阱在层与层之间。典型的错误配置长这样:
# 错误写法:每一层各配一个「默认值」,谁也不知道总共花多久
resp = gateway.forward(url, timeout=30)     # 入口层:30 秒
resp = inner_call(url, timeout=60)          # 内部下游:60 秒
入口 30 秒就放弃了,内部下游 60 秒还在跑。结果是:调用方拿到超时报错,下游照常扣款、照常发货,两端状态从此不一致,只能靠人工对账把差异单捞回来。
正确的层序只有一条规则:越靠近用户,预算越长;越靠近底层,预算越短。
入口 5 秒 > 业务层 3 秒 > 单次下游 1.5 秒 > 数据库 0.8 秒
这样任何一层超时,都意味着它下面的层早就该结束了,不存在「上层先断、下层还在跑」的窗口。
四、陷阱三:超时和重试是乘法,不是加法
超时设 30 秒、重试 3 次,最坏情况是 90 秒——而用户对页面预算的耐受通常只有 5 秒。更糟的是流量放大:下游承压时,重试把请求量乘 2 到 3 倍,每一次重试都继续占着线程。这两个效应叠加,就是「越重试,故障越大」。
治理方式是把预算当成一个对象,从入口一路往下传:
import time, random
import requests
class BudgetExhausted(Exception):
    pass
class Budget:
    """一次请求的总时间预算,从入口创建,随调用链往下传。"""
    __slots__ = ("deadline",)
    def __init__(self, total_ms: int):
        self.deadline = time.monotonic() + total_ms / 1000
    def left(self) -> float:
        return max(0.0, self.deadline - time.monotonic())
def call(url: str, budget: Budget, reserve_ms: int = 150) -> dict:
    # 给后续环节留一点余量,不把预算吃干净
    left = budget.left() - reserve_ms / 1000
    if left <= 0:
        raise BudgetExhausted(url)
    resp = requests.get(url, timeout=(0.3, left))  # 连接超时短;读超时跟随剩余预算
    resp.raise_for_status()
    return resp.json()
def call_with_retry(url: str, budget: Budget, max_try: int = 2) -> dict:
    last = None
    for attempt in range(max_try):
        try:
            return call(url, budget)
        except (requests.Timeout, requests.ConnectionError) as e:
            last = e
            wait = 0.2 * (2 ** attempt) * (0.5 + random.random())  # 指数退避 + 抖动
            if wait >= budget.left() - 0.3:   # 等完就没预算了,不如直接失败
                break
            time.sleep(wait)
    raise BudgetExhausted(f"{url}: {last}")
三个要点:
读超时跟随剩余预算,不是固定值。 上游剩多少,下游最多用多少,天然满足层序递减。
重试前先看剩余预算。 剩 0.5 秒预算时安排 4 秒退避,等回来预算早没了,这次重试纯属浪费线程——不如立刻快速失败。
只在业务层重试。 网关不知道这个操作能不能重做,业务层知道;把重试收敛在一层,放大倍数就可控。
五、检查清单
- 每个外部调用都设了超时,连接超时单独设且远小于读超时
- 用「线程数 ÷ 占用时长」算过故障下的吞吐下限,确认能接受
- 层序递减:入口 > 业务 > 单次下游 > 数据库,无颠倒
- 预算从入口往下传,下游读超时跟随剩余预算
- 只在一层重试,重试前检查剩余预算够不够
- 退避带随机抖动,且受总预算约束
- 参数错误、鉴权失败不进重试循环
- 熔断的慢调用阈值小于接口超时,否则慢调用永远统计不到
- 有监控区分「执行慢」和「排队久」,排队耗时单独画线
- 改超时值走评审:这个数字决定故障时的存活时间,不是随手填的默认值
六、一句总结
那次事故的根因,是把超时当成了「容忍度」——以为调大就是更稳。超时其实是预算:调大它,等于承诺每个请求在故障时占用更久的资源,等于把单机吞吐砍掉一个量级。
正确的姿势是算三笔账:故障下还能扛多少吞吐、层序有没有颠倒、重试会把流量放大几倍。三笔账算清,超时才从隐患变成防线。