上一篇讲了 Table 分组与聚合——groupBy 和聚合函数,这是 Flink SQL 中最常用的多对一转换操作。但内置聚合函数(sum/count/avg/min/max)只能覆盖常见的统计需求,遇到中位数、百分位、复杂业务逻辑、一行拆多行、TopN 这些场景,内置函数就不够用了。这时候就需要自定义 UDF。
UDF(User Defined Function,用户自定义函数)是 Flink SQL 扩展性的核心。几乎所有复杂业务逻辑都需要通过自定义 UDF 实现——比如手机号脱敏、身份证解析、JSON 数组展开、中位数计算、每组 TopN。但很多同学对 UDF 的四大分类(Scalar/Table/Aggregate/TableAggregate)搞不清楚,不知道什么时候用哪种,也不了解 UDF 的内部执行机制和性能优化要点。
这篇从 UDF 本质定义、四大类对比与选择决策、ScalarFunction 标量函数、TableFunction 表函数(LATERAL TABLE)、AggregateFunction 聚合函数、TableAggregateFunction 表聚合函数(TopN)、UDF 内部执行机制、函数注册方式、性能优化、完整代码实现、六个常见坑、八条最佳实践,把自定义 UDF 一次性讲透。
一、UDF 本质定义与四大类分类
UDF 的本质一句话概括:用户自定义函数,用于扩展 Flink SQL 内置函数的能力,实现内置函数不支持的业务逻辑。
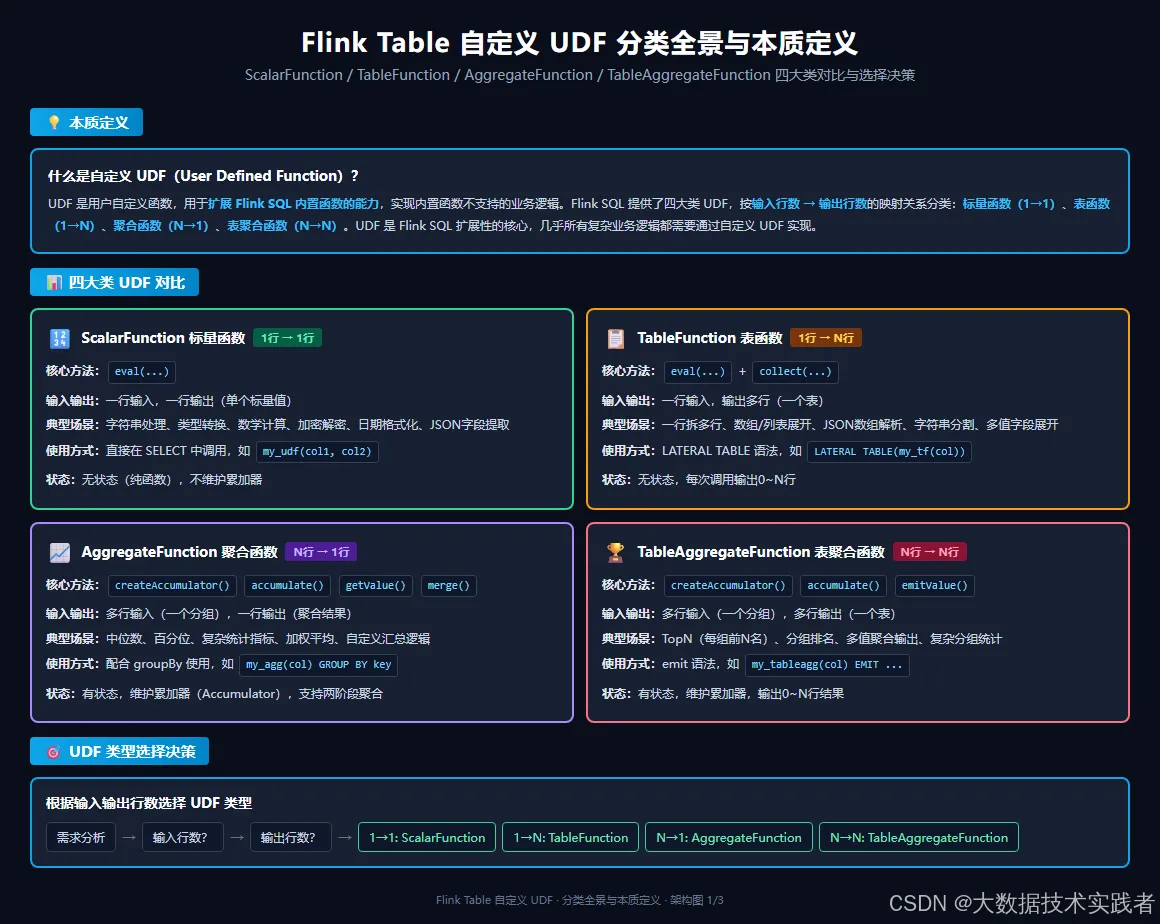
Flink SQL 提供了四大类 UDF,按输入行数 → 输出行数的映射关系分类。下面这张图把 UDF 本质定义、四大类对比、类型选择决策放在一起展示。
1.1 四大类 UDF 对比
| 类型 | 输入→输出 | 核心方法 | 典型场景 | 状态 |
|---|---|---|---|---|
| ScalarFunction 标量函数 | 1行→1行 | eval() | 字符串处理、类型转换、数学计算、加密解密 | 无状态 |
| TableFunction 表函数 | 1行→N行 | eval()+collect() | 一行拆多行、数组展开、JSON数组解析 | 无状态 |
| AggregateFunction 聚合函数 | N行→1行 | accumulate()+getValue()+merge() | 中位数、百分位、复杂统计指标 | 有状态 |
| TableAggregateFunction 表聚合函数 | N行→N行 | accumulate()+emitValue() | TopN、分组排名、多值聚合输出 | 有状态 |
1.2 类型选择决策
选择 UDF 类型的核心判断依据是输入行数和输出行数:
- 一行输入,一行输出(单个标量值)→ ScalarFunction
- 一行输入,多行输出(一个表)→ TableFunction
- 多行输入(一个分组),一行输出 → AggregateFunction
- 多行输入(一个分组),多行输出 → TableAggregateFunction
这个决策逻辑很简单,但很多同学在 TableFunction 和 TableAggregateFunction 上容易混淆——TableFunction 是一行输入拆多行(无状态),TableAggregateFunction 是多行输入聚合后输出多行(有状态,如 TopN)。
二、ScalarFunction 标量函数
ScalarFunction 是最简单也最常用的 UDF,将一行输入映射为一个标量值输出。
2.1 核心方法:eval()
ScalarFunction 的核心是实现一个或多个 eval() 方法。方法名必须是 eval,参数是输入值,返回值是输出结果。可以重载多个 eval 方法支持不同的参数类型。
import org.apache.flink.table.functions.ScalarFunction;

public class PhoneMaskFunction extends ScalarFunction {


    // 手机号脱敏:138****5678
    public String eval(String phone) {

        if (phone == null || phone.length() != 11) {

            return null;
        }
        return phone.substring(0, 3) + "****" + phone.substring(7);
    }

    // 重载:支持自定义脱敏起始位置和长度
    public String eval(String phone, int start, int length) {

        if (phone == null || start < 0 || start + length > phone.length()) {

            return null;
        }
        StringBuilder sb = new StringBuilder(phone.substring(0, start));
        for (int i = 0; i < length; i++) {

            sb.append("*");
        }
        sb.append(phone.substring(start + length));
        return sb.toString();
    }
}
2.2 使用方式
注册后直接在 SELECT 中调用,和内置函数用法一样:
-- 注册函数
CREATE TEMPORARY SYSTEM FUNCTION phone_mask AS 'com.example.PhoneMaskFunction';

-- 使用
SELECT user_id, phone_mask(phone) AS masked_phone FROM users;
SELECT user_id, phone_mask(phone, 3, 4) AS masked_phone FROM users;
2.3 关键要点
- 方法名必须是 eval:Flink 通过反射查找 eval 方法,方法名错误会导致函数注册失败。
- 支持重载:多个 eval 方法支持不同参数类型,运行时按参数类型匹配。
- null 处理:eval 方法必须处理 null 输入,Flink 不会自动跳过 null。
- 无状态:ScalarFunction 是纯函数,不维护状态,不参与 Checkpoint。
- 确定性:相同输入永远产生相同输出的函数是确定性函数,优化器可以做常量折叠和结果缓存。
三、TableFunction 表函数
TableFunction 将一行输入映射为多行输出(一个表),是一行拆多行场景的核心工具。
3.1 核心方法:eval() + collect()
TableFunction 的核心是实现 eval() 方法,在方法内部通过 collect() 输出多行结果。每次调用 collect 输出一行,可以输出 0~N 行。
import org.apache.flink.table.annotation.DataTypeHint;
import org.apache.flink.table.annotation.FunctionHint;
import org.apache.flink.table.functions.TableFunction;
import org.apache.flink.types.Row;

@FunctionHint(output = @DataTypeHint("ROW<item STRING, idx INT>"))
public class SplitFunction extends TableFunction<Row> {


    // 按分隔符拆分字符串,输出每行(元素,索引)
    public void eval(String str, String separator) {

        if (str == null || separator == null) {

            return; // 输出0行
        }
        String[] items = str.split(separator);
        for (int i = 0; i < items.length; i++) {

            collect(Row.of(items[i], i));
        }
    }
}
3.2 使用方式:LATERAL TABLE
TableFunction 必须通过 LATERAL TABLE 语法使用,不能直接在 SELECT 中调用。有两种 join 方式:
-- 注册函数
CREATE TEMPORARY SYSTEM FUNCTION split_str AS 'com.example.SplitFunction';

-- CROSS JOIN LATERAL:输入行有输出才保留(类似 INNER JOIN)
SELECT t.order_id, s.item, s.idx
FROM orders t,
LATERAL TABLE(split_str(t.items, ',')) AS s(item, idx);

-- LEFT JOIN LATERAL:输入行无输出也保留(类似 LEFT JOIN,输出列补 null)
SELECT t.order_id, s.item, s.idx
FROM orders t
LEFT JOIN LATERAL TABLE(split_str(t.items, ',')) AS s(item, idx) ON TRUE;
3.3 关键要点
- collect() 输出多行:每次 collect 输出一行,可以输出 0~N 行。输出 0 行时,CROSS JOIN 会丢弃输入行,LEFT JOIN 会保留并补 null。
- 必须用 LATERAL TABLE:直接在 SELECT 中调用 TableFunction 会报语法错误。
- 输出类型声明:复杂输出类型(Row)需要用 @FunctionHint 显式声明,避免类型推导失败。
- 无状态:TableFunction 也是无状态的,每次 eval 独立执行。
- 别名定义:LATERAL TABLE 后必须定义表别名和列别名,如
AS s(item, idx)。
四、AggregateFunction 聚合函数
AggregateFunction 将多行输入(一个分组)聚合为一行输出,是自定义聚合逻辑的核心。上一篇分组与聚合中详细讲过,这里简要回顾核心要点。
4.1 四个核心方法
createAccumulator():创建累加器,每个新 key 第一次到达时调用。accumulate(acc, value...):每来一条数据更新累加器,调用最频繁,性能关键。getValue(acc):从累加器提取最终结果,纯计算不修改累加器。merge(acc, accs):合并多个累加器,两阶段聚合的必要条件,生产环境必须实现。
4.2 完整示例:中位数聚合函数
import org.apache.flink.table.functions.AggregateFunction;
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

public class MedianFunction extends AggregateFunction<Double, MedianFunction.MedianAccumulator> {


    // 累加器:存储所有值
    public static class MedianAccumulator {

        public List<Double> values = new ArrayList<>();
    }

    @Override
    public MedianAccumulator createAccumulator() {

        return new MedianAccumulator();
    }

    @Override
    public void accumulate(MedianAccumulator acc, Double value) {

        if (value != null) {

            acc.values.add(value);
        }
    }

    @Override
    public Double getValue(MedianAccumulator acc) {

        if (acc.values.isEmpty()) return null;
        Collections.sort(acc.values);
        int size = acc.values.size();
        if (size % 2 == 0) {

            return (acc.values.get(size / 2 - 1) + acc.values.get(size / 2)) / 2.0;
        } else {

            return acc.values.get(size / 2);
        }
    }

    @Override
    public void merge(MedianAccumulator acc, Iterable<MedianAccumulator> it) {

        for (MedianAccumulator other : it) {

            acc.values.addAll(other.values);
        }
    }
}
注意:这个中位数实现的累加器存储了所有值,状态大小 = key 基数 × 每个 key 的值数量。大数据量场景下状态会很大,生产环境建议用近似中位数(如 t-digest 算法)减少状态。
五、TableAggregateFunction 表聚合函数
TableAggregateFunction 将多行输入(一个分组)聚合为多行输出,是四大类 UDF 中最复杂也最强大的一类。最典型的应用场景是 TopN(每组前 N 名)。
5.1 核心方法:accumulate() + emitValue()
createAccumulator():创建累加器,存储聚合的中间状态。accumulate(acc, value...):每来一条数据更新累加器。emitValue(acc, out):从累加器提取结果,通过out.collect()输出多行结果。
5.2 完整示例:TopN 表聚合函数
import org.apache.flink.table.functions.TableAggregateFunction;
import org.apache.flink.util.Collector;
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;

public class TopNFunction extends TableAggregateFunction<TopNFunction.TopNResult, TopNFunction.TopNAccumulator> {


    private final int n;

    public TopNFunction(int n) {

        this.n = n;
    }

    // 累加器:维护 TopN 列表
    public static class TopNAccumulator {

        public List<TopNResult> topList = new ArrayList<>();
    }

    // 输出结果:值 + 排名
    public static class TopNResult {

        public Double value;
        public Integer rank;

        public TopNResult() {
   }

        public TopNResult(Double value, Integer rank) {

            this.value = value;
            this.rank = rank;
        }
    }

    @Override
    public TopNAccumulator createAccumulator() {

        return new TopNAccumulator();
    }

    @Override
    public void accumulate(TopNAccumulator acc, Double value) {

        if (value == null) return;
        // 插入到有序列表(降序)
        int insertPos = 0;
        while (insertPos < acc.topList.size() && acc.topList.get(insertPos).value >= value) {

            insertPos++;
        }
        acc.topList.add(insertPos, new TopNResult(value, null));
        // 只保留前 N 个
        if (acc.topList.size() > n) {

            acc.topList.remove(acc.topList.size() - 1);
        }
    }

    @Override
    public void emitValue(TopNAccumulator acc, Collector<TopNResult> out) {

        for (int i = 0; i < acc.topList.size(); i++) {

            TopNResult r = acc.topList.get(i);
            out.collect(new TopNResult(r.value, i + 1));
        }
    }
}
5.3 使用方式:EMIT 语法
TableAggregateFunction 使用 EMIT 语法调用:
-- 注册函数(带参数 n=3)
CREATE TEMPORARY SYSTEM FUNCTION top3 AS 'com.example.TopNFunction';

-- 按用户分组,取每个用户金额最高的3笔订单
SELECT user_id, value, rank
FROM orders
GROUP BY user_id
EMIT top3(amount) AS (value, rank);
5.4 关键要点
- 有状态:TableAggregateFunction 维护累加器状态,参与 Checkpoint。
- 输出多行:emitValue 中通过 out.collect() 输出 0~N 行结果。
- TopN 是最典型场景:每组前 N 名、分组排名都用 TableAggregateFunction 实现。
- 累加器优化:TopN 的累加器只需要维护前 N 个元素,不需要存储所有值,状态大小 = key 基数 × N,比中位数聚合小很多。
- 流处理注意:流处理 TableAggregateFunction 可能产生回撤消息,下游需要支持回撤。
六、UDF 内部机制与执行原理
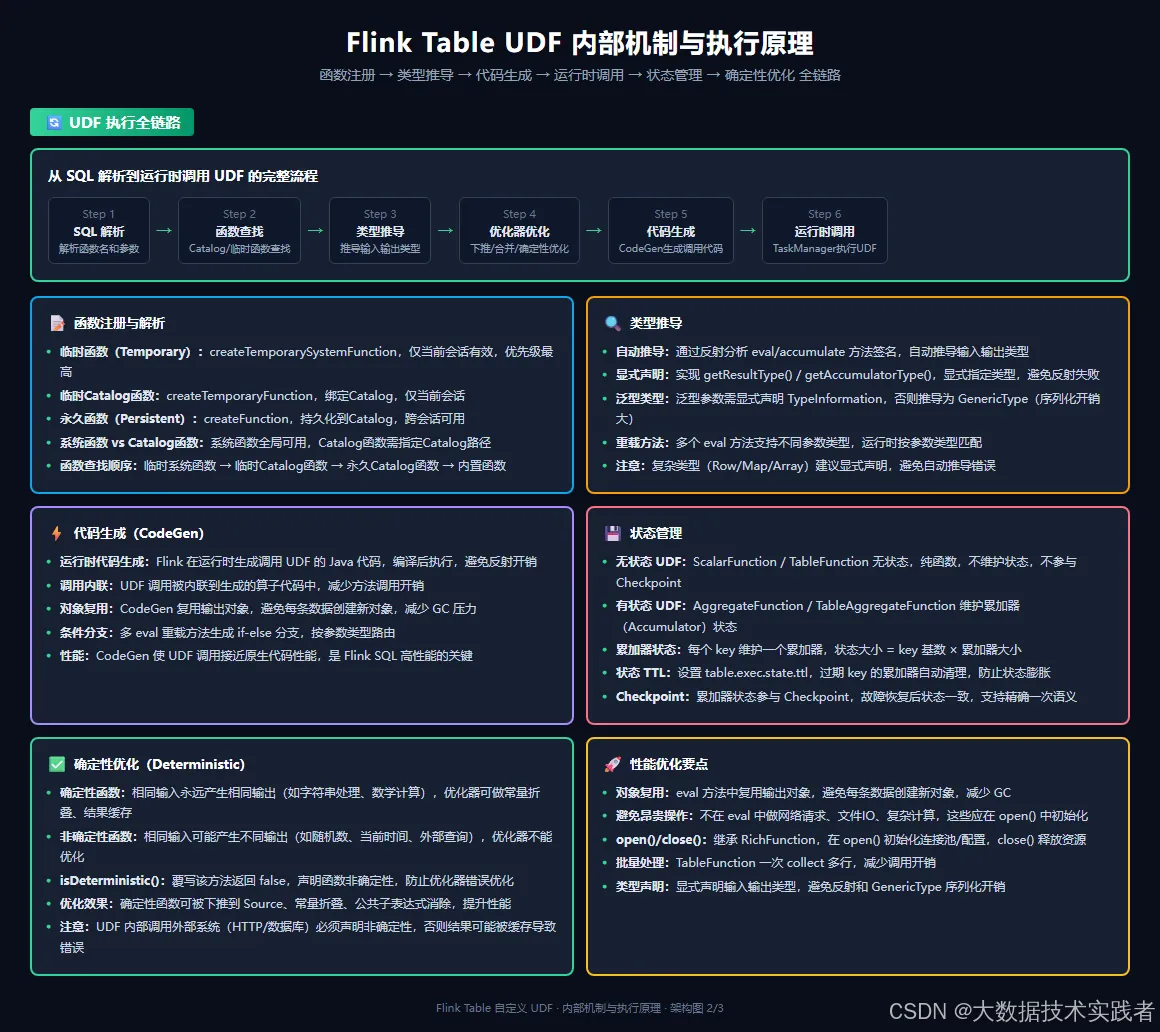
理解 UDF 的内部执行机制,才能写出高性能、稳定的自定义函数。下面这张图把 UDF 执行全链路、六大核心机制放在一起展示。
6.1 执行全链路六步
从 SQL 解析到运行时调用 UDF,完整流程分为六步:
- SQL 解析:解析 SQL 中的函数名和参数,生成抽象语法树(AST)。
- 函数查找:按优先级查找函数定义——临时系统函数 → 临时 Catalog 函数 → 永久 Catalog 函数 → 内置函数。
- 类型推导:通过反射分析 eval/accumulate 方法签名,推导输入输出类型。复杂类型需要显式声明。
- 优化器优化:确定性函数可做常量折叠、公共子表达式消除、算子下推。
- 代码生成(CodeGen):运行时生成调用 UDF 的 Java 代码,编译后执行,避免反射开销。
- 运行时调用:TaskManager 执行生成的代码,调用 UDF 的 eval/accumulate 方法。
6.2 代码生成(CodeGen)
CodeGen 是 Flink SQL 高性能的关键。Flink 在运行时生成调用 UDF 的 Java 代码,编译后执行,而不是通过反射调用。这带来三个性能优势:
- 调用内联:UDF 调用被内联到生成的算子代码中,减少方法调用开销。
- 对象复用:CodeGen 复用输出对象,避免每条数据创建新对象,减少 GC 压力。
- 条件分支:多 eval 重载方法生成 if-else 分支,按参数类型路由,运行时直接匹配。
这就是为什么 Flink SQL 的 UDF 调用性能接近原生代码,而不是像某些引擎那样通过反射调用导致性能差。
6.3 确定性优化(Deterministic)
确定性函数是指相同输入永远产生相同输出的函数(如字符串处理、数学计算)。对于确定性函数,优化器可以做以下优化:
- 常量折叠:函数参数是常量时,编译期直接计算结果,运行时不需要调用。
- 公共子表达式消除:相同参数的多次函数调用只计算一次,结果复用。
- 算子下推:确定性函数可以下推到 Source 端,提前过滤或转换数据。
非确定性函数(如随机数、当前时间、外部系统调用)不能做这些优化。UDF 内部调用外部系统(HTTP/数据库/Redis)时,必须覆写 isDeterministic() 返回 false,否则优化器可能将其当作确定性函数做结果缓存,导致外部调用不执行、结果错误。
6.4 状态管理
- 无状态 UDF:ScalarFunction 和 TableFunction 是无状态的纯函数,不维护状态,不参与 Checkpoint。
- 有状态 UDF:AggregateFunction 和 TableAggregateFunction 维护累加器(Accumulator)状态,每个 key 一个累加器。状态大小 = key 基数 × 累加器大小,需要设置状态 TTL 防止状态膨胀。
七、UDF 注册方式
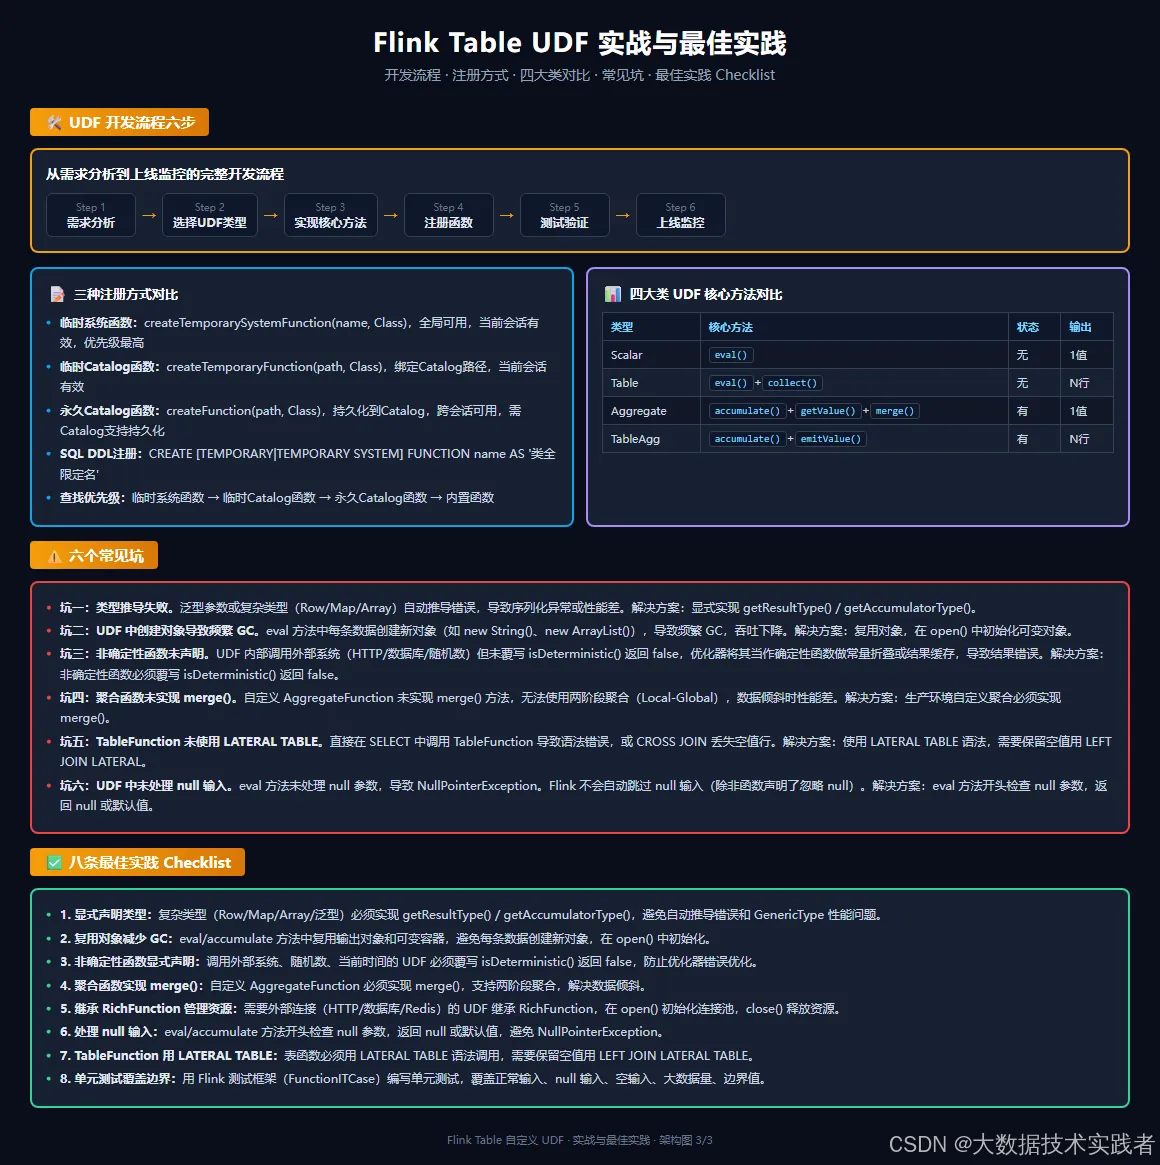
Flink SQL 支持三种注册方式,按作用域和持久化分类:
7.1 临时系统函数(Temporary System Function)
tableEnv.createTemporarySystemFunction("phone_mask", PhoneMaskFunction.class);
- 全局可用,不需要指定 Catalog 路径。
- 仅当前会话有效,会话结束后消失。
- 优先级最高,会覆盖同名内置函数和 Catalog 函数。
- 适合开发测试和临时使用。
7.2 临时 Catalog 函数(Temporary Function)
tableEnv.createTemporaryFunction("my_catalog.my_db.phone_mask", PhoneMaskFunction.class);
- 绑定 Catalog 路径,需要指定完整路径调用。
- 仅当前会话有效。
- 适合多 Catalog 环境下的函数隔离。
7.3 永久 Catalog 函数(Persistent Function)
tableEnv.createFunction("my_catalog.my_db.phone_mask", PhoneMaskFunction.class);
- 持久化到 Catalog,跨会话可用。
- 需要 Catalog 支持持久化(如 Hive Catalog、JDBC Catalog)。
- 适合生产环境的函数管理和共享。
7.4 SQL DDL 注册
-- 临时系统函数
CREATE TEMPORARY SYSTEM FUNCTION phone_mask AS 'com.example.PhoneMaskFunction';

-- 临时Catalog函数
CREATE TEMPORARY FUNCTION my_db.phone_mask AS 'com.example.PhoneMaskFunction';

-- 永久Catalog函数
CREATE FUNCTION my_db.phone_mask AS 'com.example.PhoneMaskFunction';
7.5 函数查找优先级
调用函数时,Flink 按以下优先级查找:
- 临时系统函数(createTemporarySystemFunction)
- 临时 Catalog 函数(createTemporaryFunction)
- 永久 Catalog 函数(createFunction)
- 内置函数
同名函数按优先级覆盖,临时系统函数优先级最高。
八、UDF 性能优化要点
8.1 对象复用减少 GC
eval/accumulate 方法中每条数据创建新对象(如 new String()、new ArrayList()、new Row())会导致频繁 GC,吞吐下降。优化方式:
- 继承 RichFunction,在 open() 中初始化可变对象,eval 中复用。
- 输出对象复用:eval 中修改同一个对象的字段后返回,避免每条创建新对象。
- 注意:对象复用时要确保下游不会持有引用导致数据覆盖,Flink CodeGen 会处理这个问题。
8.2 继承 RichFunction 管理资源
需要外部连接(HTTP/数据库/Redis/连接池)的 UDF,继承 RichFunction(RichScalarFunction/RichTableFunction/RichAggregateFunction),在 open() 初始化资源,close() 释放资源:
import org.apache.flink.configuration.Configuration;
import org.apache.flink.table.functions.RichScalarFunction;

public class ExternalLookupFunction extends RichScalarFunction {

    private transient HttpClient httpClient;

    @Override
    public void open(Configuration parameters) {

        // 初始化HTTP客户端(只执行一次)
        this.httpClient = HttpClient.newBuilder()
            .connectTimeout(Duration.ofSeconds(5))
            .build();
    }

    @Override
    public void close() {

        // 释放资源
        if (httpClient != null) {

            // 关闭客户端
        }
    }

    public String eval(String key) {

        // 调用外部接口
        // ...
        return result;
    }

    @Override
    public boolean isDeterministic() {

        return false; // 外部调用是非确定性的
    }
}
8.3 显式声明类型
复杂类型(Row/Map/Array/泛型)自动推导可能失败或推导为 GenericType(序列化开销大)。显式实现 getResultType() / getAccumulatorType() 或使用 @DataTypeHint / @FunctionHint 注解声明类型。
8.4 避免 eval 中的昂贵操作
eval/accumulate 是调用最频繁的方法(每条数据调用一次),不要在其中做:
- 网络请求(HTTP/数据库查询)——应在 open() 中初始化连接池,eval 中用连接池查询
- 文件 IO
- 复杂计算(如排序)——应在累加器中维护有序数据结构,避免每次排序
- 创建大量临时对象
8.5 非确定性函数显式声明
调用外部系统、随机数、当前时间的 UDF 必须覆写 isDeterministic() 返回 false,防止优化器错误优化(常量折叠、结果缓存)。
九、完整代码实现
下面是一个完整的 UDF 使用示例,包含创建环境、DDL 建表、注册四种 UDF、使用四种 UDF、输出执行。
下面这张图把开发流程、注册方式、四大类对比、六个常见坑、八条最佳实践放在一起展示。
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.table.functions.ScalarFunction;
import org.apache.flink.table.functions.TableFunction;
import org.apache.flink.table.functions.AggregateFunction;
import org.apache.flink.table.functions.TableAggregateFunction;
import org.apache.flink.util.Collector;
import org.apache.flink.types.Row;
import java.time.ZoneId;
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import static org.apache.flink.table.api.Expressions.*;

public class UdfExample {


    // ========== 1. 标量函数:手机号脱敏 ==========
    public static class PhoneMask extends ScalarFunction {

        public String eval(String phone) {

            if (phone == null || phone.length() != 11) return null;
            return phone.substring(0, 3) + "****" + phone.substring(7);
        }
    }

    // ========== 2. 表函数:JSON数组展开 ==========
    public static class JsonArraySplit extends TableFunction<Row> {

        public void eval(String jsonArray) {

            if (jsonArray == null || jsonArray.isEmpty()) return;
            // 简单解析(生产环境用Jackson/Gson)
            String content = jsonArray.replaceAll("[\\[\\]\"]", "");
            String[] items = content.split(",");
            for (int i = 0; i < items.length; i++) {

                collect(Row.of(items[i].trim(), i));
            }
        }
    }

    // ========== 3. 聚合函数:中位数 ==========
    public static class MedianAgg extends AggregateFunction<Double, MedianAgg.MedianAcc> {

        public static class MedianAcc {

            public List<Double> values = new ArrayList<>();
        }

        @Override
        public MedianAcc createAccumulator() {
    return new MedianAcc(); }

        @Override
        public void accumulate(MedianAcc acc, Double value) {

            if (value != null) acc.values.add(value);
        }

        @Override
        public Double getValue(MedianAcc acc) {

            if (acc.values.isEmpty()) return null;
            Collections.sort(acc.values);
            int size = acc.values.size();
            return size % 2 == 0
                ? (acc.values.get(size/2-1) + acc.values.get(size/2)) / 2.0
                : acc.values.get(size/2);
        }

        @Override
        public void merge(MedianAcc acc, Iterable<MedianAcc> it) {

            for (MedianAcc other : it) acc.values.addAll(other.values);
        }
    }

    // ========== 4. 表聚合函数:Top2 ==========
    public static class Top2Agg extends TableAggregateFunction<Top2Agg.Top2Result, Top2Agg.Top2Acc> {

        public static class Top2Acc {

            public List<Double> topList = new ArrayList<>();
        }
        public static class Top2Result {

            public Double value;
            public Integer rank;
            public Top2Result() {
   }
            public Top2Result(Double value, Integer rank) {

                this.value = value; this.rank = rank;
            }
        }

        @Override
        public Top2Acc createAccumulator() {
    return new Top2Acc(); }

        @Override
        public void accumulate(Top2Acc acc, Double value) {

            if (value == null) return;
            int pos = 0;
            while (pos < acc.topList.size() && acc.topList.get(pos) >= value) pos++;
            acc.topList.add(pos, value);
            if (acc.topList.size() > 2) acc.topList.remove(acc.topList.size() - 1);
        }

        @Override
        public void emitValue(Top2Acc acc, Collector<Top2Result> out) {

            for (int i = 0; i < acc.topList.size(); i++) {

                out.collect(new Top2Result(acc.topList.get(i), i + 1));
            }
        }
    }

    public static void main(String[] args) throws Exception {

        // 1. 创建执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.enableCheckpointing(60000);
        StreamTableEnvironment tableEnv = StreamTableEnvironment.create(env);
        tableEnv.getConfig().setLocalTimeZone(ZoneId.of("Asia/Shanghai"));

        // 2. 注册四种UDF
        tableEnv.createTemporarySystemFunction("phone_mask", PhoneMask.class);
        tableEnv.createTemporarySystemFunction("json_split", JsonArraySplit.class);
        tableEnv.createTemporarySystemFunction("median_agg", MedianAgg.class);
        tableEnv.createTemporarySystemFunction("top2_agg", Top2Agg.class);

        // 3. DDL创建Kafka源表
        tableEnv.executeSql("""
            CREATE TABLE orders (
                order_id BIGINT,
                user_id BIGINT,
                phone STRING,
                amount DECIMAL(10,2),
                tags STRING,
                order_time TIMESTAMP(3),
                WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
            ) WITH (
                'connector' = 'kafka',
                'topic' = 'orders',
                'properties.bootstrap.servers' = 'localhost:9092',
                'format' = 'json'
            )
        """);

        // 4. 标量函数:手机号脱敏
        Table masked = tableEnv.from("orders")
            .select($("order_id"), $("user_id"),
                    call("phone_mask", $("phone")).as("masked_phone"),
                    $("amount"));

        // 5. 表函数:JSON数组展开(LATERAL TABLE)
        Table exploded = tableEnv.sqlQuery("""
            SELECT t.order_id, t.user_id, s.item, s.idx
            FROM orders t,
            LATERAL TABLE(json_split(t.tags)) AS s(item, idx)
        """);

        // 6. 聚合函数:按用户计算金额中位数
        Table userMedian = tableEnv.from("orders")
            .groupBy($("user_id"))
            .select($("user_id"),
                    call("median_agg", $("amount").cast("DOUBLE")).as("median_amount"));

        // 7. 表聚合函数:按用户取金额Top2
        Table userTop2 = tableEnv.sqlQuery("""
            SELECT user_id, value, rank
            FROM orders
            GROUP BY user_id
            EMIT top2_agg(CAST(amount AS DOUBLE)) AS (value, rank)
        """);

        // 8. 执行(示例:输出Top2结果到控制台)
        TableResult result = userTop2.execute();
        result.print();

        env.execute("UDF Example");
    }
}
代码关键点:
- 四种 UDF 全覆盖:ScalarFunction(手机号脱敏)、TableFunction(JSON 数组展开)、AggregateFunction(中位数)、TableAggregateFunction(Top2),每种都有完整实现。
- 注册方式:用 createTemporarySystemFunction 注册,全局可用,当前会话有效。
- TableFunction 用 LATERAL TABLE:JSON 数组展开必须用 LATERAL TABLE 语法,定义表别名和列别名。
- AggregateFunction 实现 merge():中位数聚合函数实现了 merge(),支持两阶段聚合。
- TableAggregateFunction 用 EMIT 语法:Top2 用 EMIT 语法调用,输出值和排名两列。
- null 处理:每个 eval/accumulate 方法都检查 null 输入,避免 NullPointerException。
十、六个常见坑
10.1 坑一:类型推导失败
现象: UDF 注册成功,但运行时报序列化异常、类型不匹配,或性能很差(GenericType 序列化)。
根因: 泛型参数或复杂类型(Row/Map/Array)自动推导错误,或推导为 GenericType(Kryo 序列化,性能差)。
解决方案: 显式实现 getResultType() / getAccumulatorType(),或使用 @DataTypeHint / @FunctionHint 注解声明类型。复杂类型必须显式声明。
10.2 坑二:eval 中创建对象导致频繁 GC
现象: UDF 吞吐上不去,TaskManager GC 频繁,CPU 使用率高。
根因: eval/accumulate 方法中每条数据创建新对象(new String()、new ArrayList()、new Row()、new StringBuilder()),导致频繁 Young GC。
解决方案: 继承 RichFunction,在 open() 中初始化可变对象,eval 中复用。输出对象复用,避免每条创建新对象。StringBuilder 复用而不是每次 new。
10.3 坑三:非确定性函数未声明
现象: UDF 内部调用外部系统(HTTP/数据库/Redis),但结果被缓存,外部调用不执行,结果错误。或使用随机数/当前时间的 UDF 结果不变。
根因: 优化器将非确定性函数当作确定性函数,做了常量折叠或结果缓存,导致函数只执行一次或不执行。
解决方案: 非确定性函数必须覆写 isDeterministic() 返回 false。调用外部系统、随机数、当前时间的函数都是非确定性的。
10.4 坑四:聚合函数未实现 merge()
现象: 自定义 AggregateFunction 的数据倾斜严重,开启两阶段聚合后没有效果。
根因: 自定义聚合函数没有实现 merge() 方法,优化器无法将其用于两阶段聚合的全局 merge 阶段,只能单阶段聚合。
解决方案: 实现 merge(acc, accs) 方法,将多个累加器合并为一个。merge 是两阶段聚合的必要条件,生产环境自定义聚合必须实现。
10.5 坑五:TableFunction 未使用 LATERAL TABLE
现象: 直接在 SELECT 中调用 TableFunction 报语法错误,或 CROSS JOIN 丢失了无输出的输入行。
根因: TableFunction 必须通过 LATERAL TABLE 语法使用,直接调用不支持。CROSS JOIN LATERAL 在表函数输出 0 行时会丢弃输入行(类似 INNER JOIN)。
解决方案: 使用 LATERAL TABLE 语法。需要保留无输出的输入行时,用 LEFT JOIN LATERAL TABLE ... ON TRUE(类似 LEFT JOIN,输出列补 null)。
10.6 坑六:UDF 中未处理 null 输入
现象: UDF 运行时报 NullPointerException,作业失败。
根因: eval/accumulate 方法未处理 null 参数,直接调用方法或访问字段导致 NPE。Flink 不会自动跳过 null 输入(除非函数声明了忽略 null)。
解决方案: eval/accumulate 方法开头检查 null 参数,返回 null 或默认值。每个参数都要检查,特别是字符串、集合、自定义对象类型。
十一、八条最佳实践 Checklist
上线前逐条检查:
显式声明类型:复杂类型(Row/Map/Array/泛型)必须实现 getResultType() / getAccumulatorType() 或使用注解声明,避免自动推导错误和 GenericType 性能问题。
复用对象减少 GC:eval/accumulate 方法中复用输出对象和可变容器,避免每条数据创建新对象,在 open() 中初始化。StringBuilder、List 等可变对象复用。
非确定性函数显式声明:调用外部系统、随机数、当前时间的 UDF 必须覆写 isDeterministic() 返回 false,防止优化器错误优化(常量折叠、结果缓存)。
聚合函数实现 merge():自定义 AggregateFunction 必须实现 merge(),支持两阶段聚合,解决数据倾斜。不实现 merge 的聚合函数在生产环境性能差。
继承 RichFunction 管理资源:需要外部连接(HTTP/数据库/Redis/连接池)的 UDF 继承 RichFunction,在 open() 初始化连接池,close() 释放资源。不要在 eval 中创建连接。
处理 null 输入:eval/accumulate 方法开头检查所有 null 参数,返回 null 或默认值,避免 NullPointerException。每个参数都要检查。
TableFunction 用 LATERAL TABLE:表函数必须用 LATERAL TABLE 语法调用,需要保留空值用 LEFT JOIN LATERAL TABLE ... ON TRUE。定义表别名和列别名。
单元测试覆盖边界:用 Flink 测试框架编写单元测试,覆盖正常输入、null 输入、空输入、大数据量、边界值、重载方法。UDF 是核心业务逻辑,必须有测试覆盖。
十二、总结与下一篇预告
Table 自定义 UDF 原理及代码实现要点回顾:
第一,本质:UDF 是用户自定义函数,用于扩展 Flink SQL 内置函数的能力,实现内置函数不支持的业务逻辑。按输入行数→输出行数分为四大类:ScalarFunction(1→1)、TableFunction(1→N)、AggregateFunction(N→1)、TableAggregateFunction(N→N)。
第二,ScalarFunction 标量函数:核心方法 eval(),一行输入一行输出,直接在 SELECT 中调用。支持重载,无状态,是最简单最常用的 UDF。
第三,TableFunction 表函数:核心方法 eval()+collect(),一行输入多行输出,必须用 LATERAL TABLE 语法调用。CROSS JOIN 丢弃无输出行,LEFT JOIN 保留并补 null。典型场景是一行拆多行、数组展开。
第四,AggregateFunction 聚合函数:四个核心方法——createAccumulator(创建累加器)、accumulate(更新累加器)、getValue(提取结果)、merge(合并累加器,两阶段聚合必要条件)。多行输入一行输出,有状态,典型场景是中位数、百分位。
第五,TableAggregateFunction 表聚合函数:核心方法 accumulate()+emitValue(),多行输入多行输出,有状态。最典型的应用场景是 TopN(每组前 N 名)。累加器只维护前 N 个元素,状态大小 = key 基数 × N。
第六,内部执行机制:SQL 解析→函数查找→类型推导→优化器优化→代码生成(CodeGen)→运行时调用六步全链路。CodeGen 使 UDF 调用接近原生代码性能。确定性函数可被优化器做常量折叠、公共子表达式消除、算子下推。非确定性函数必须覆写 isDeterministic()=false。
第七,注册方式:临时系统函数(全局可用,当前会话,优先级最高)、临时 Catalog 函数(绑定 Catalog,当前会话)、永久 Catalog 函数(持久化,跨会话)。查找优先级:临时系统→临时 Catalog→永久 Catalog→内置。
第八,性能优化:对象复用减少 GC、继承 RichFunction 管理资源、显式声明类型、避免 eval 中昂贵操作、非确定性函数显式声明。
第九,六个常见坑:类型推导失败、eval 中创建对象频繁 GC、非确定性函数未声明、聚合函数未实现 merge()、TableFunction 未用 LATERAL TABLE、未处理 null 输入。
第十,八条最佳实践:显式声明类型、复用对象减少 GC、非确定性函数显式声明、聚合函数实现 merge()、继承 RichFunction 管理资源、处理 null 输入、TableFunction 用 LATERAL TABLE、单元测试覆盖边界。
UDF 是 Flink SQL 扩展性的核心,掌握四大类 UDF 的原理和使用场景,理解内部执行机制和性能优化要点,就能写出高性能、稳定的自定义函数,应对各种复杂业务需求。