一、配额 1000 的那天,我们实际发出了 1780
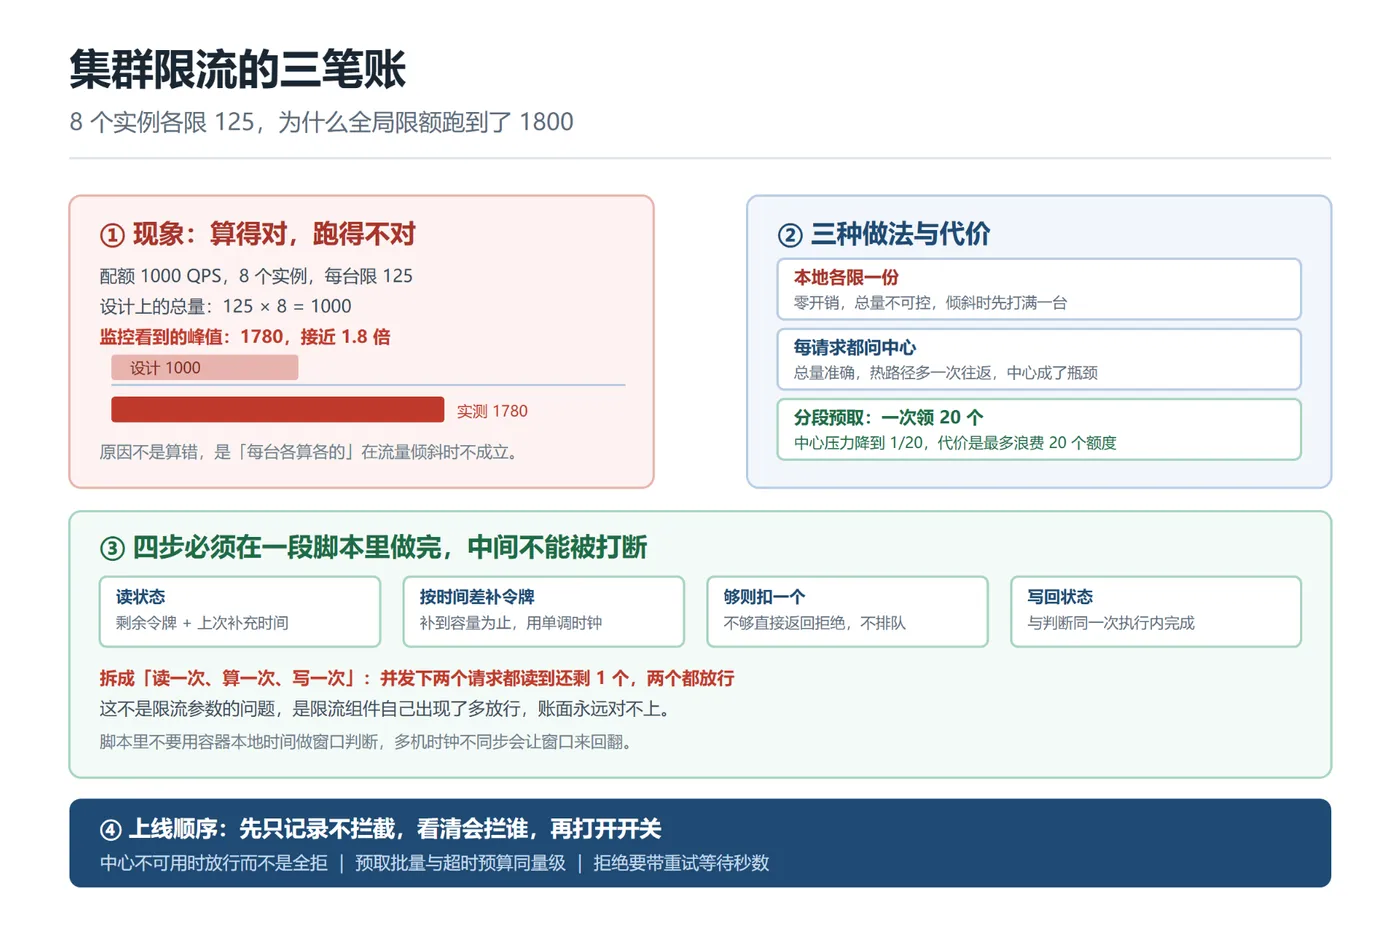
背景:对接的开放平台给了 1000 QPS 的调用配额,我们的服务部署在 8 个实例上。
设计时的算法很简单也很自然:1000 ÷ 8 = 125,每个实例用本地令牌桶限 125。
上线两周相安无事。然后某天上午,开放平台侧开始返回流控错误码,错误集中在订单同步那条链路上。
拉监控出来看,出站请求的峰值是 1780 QPS,不是 1000。
二、算得没错,错在假设
125 × 8 = 1000 这个算术是对的。它成立的前提是流量均匀落到 8 台机器上。
现实是:
- 3 台机器扛了大部分流量,本地令牌桶各自放满 125,加起来已经超了;
- 另外 5 台还有余量,但额度不能跨机器调配;
- 全局视角看,谁也不知道现在一共发了多少。
所以「总配额 ÷ 实例数」这个做法,在流量倾斜时必然失效。问题不在阈值算错,在于每台机器各算各的。
分布式系统里有一类共同的坑:本地计数器、本地锁、本地限速,这三样在单机上都是对的,放大到多实例之后全都不对。判断标准不是「这段代码对不对」,而是「这段代码跑在几个实例上,还对不对」。
三、第一版改造:把桶搬到中心
最直接的改法是集中计数:令牌桶状态放到中心存储里,8 台机器共享同一个桶。
这一版解决了总量失控,但带来了两个新问题。
问题一:中心成了瓶颈。 每个出站请求都要往返一次中心,热路径上多一次网络调用。峰值时中心存储的 QPS 就等于我们的出站 QPS,等于把压力从开放平台门口搬到了自己的存储上。
问题二:读写不是原子的。 第一版实现是「读状态 → 算令牌 → 写回」三段:
# 错误写法:三段之间可以插入其他请求
tokens, ts = load_state(key)
tokens = refill(tokens, ts)
if tokens >= 1:
    save_state(key, tokens - 1, now())
    return True
return False
并发下两个请求同时读到「还剩 1 个令牌」,两个都判断通过、都放行。限流组件自己就多放了额度——账面永远对不上。
四、第二版:原子脚本 + 分段预取
4.1 四步放进一段脚本
-- KEYS[1] 桶的键;ARGV[1] 速率(个/秒);ARGV[2] 容量;ARGV[3] 本次要取的个数
local key   = KEYS[1]
local rate  = tonumber(ARGV[1])
local cap   = tonumber(ARGV[2])
local want  = tonumber(ARGV[3])
local t = redis.call('TIME')                 -- 取中心时间,不用本机时钟
local now = tonumber(t[1]) + tonumber(t[2]) / 1000000
local data = redis.call('HMGET', key, 'tokens', 'ts')
local tokens = tonumber(data[1])
local ts = tonumber(data[2])
if tokens == nil then
    tokens = cap
    ts = now
end
local delta = now - ts
if delta > 0 then
    tokens = math.min(cap, tokens + delta * rate)
end
if tokens < want then
    redis.call('HMSET', key, 'tokens', tokens, 'ts', now)
    return 0                                  -- 拒绝
end
redis.call('HMSET', key, 'tokens', tokens - want, 'ts', now)
return want                                   -- 放行
四个要点:
读、补、判、写在一次执行内完成。 中间不会插入其他命令,不存在「两个请求都读到还剩 1 个」的窗口。
时间取中心时间。 用中心的时间而不是应用服务器本地时钟——多机时钟不同步或时钟回拨,会让时间差变成负数,令牌数算出异常值。
不够就拒绝,不排队。 排队会把限流变成延迟放大器,最后一起超时。
容量与速率两个旋钮独立。 速率决定长期配额,容量决定能扛多猛的突发。
4.2 分段预取,把中心压力降下来
每请求都问一次中心,压力扛不住。改成一次领一批:
import redis
r = redis.Redis(host="127.0.0.1", port=6379, db=0)
class PrefetchLimiter:
    """一次从中心领 batch 个额度,本地发完再去领。"""
    def __init__(self, key, rate, cap, batch=20):
        self.key = key
        self.batch = batch
        self.args = [rate, cap, batch]
        self.left = 0
    def take(self) -> bool:
        if self.left <= 0:
            got = r.eval(LUA_TAKE, 1, self.key, *self.args)
            if not got:
                return False
            self.left = int(got)
        self.left -= 1
        return True
中心压力降到 1/20,代价是最多浪费 20 个额度(实例本地还剩额度但整体已超限)。这个误差和调用总量比可以忽略。
批量大小要和超时预算同量级。 批太大,本地囤着一堆额度慢慢发,中心看到的速率和实际速率偏差变大;批太小,省不下往返。
4.3 中心不可用时的选择
限流组件是保险丝,不是总开关。中心存储故障时,正确做法是放行并记录,不是全部拒绝。
def take_safe(self) -> bool:
    try:
        return self.take()
    except redis.exceptions.RedisError:
        metrics.incr("limiter.center_down")
        return self.local_fallback.take()   # 退到本地宽松阈值
五、上线顺序
限流器最忌讳的是「上线即误伤」。正确顺序是三步:
- 只记录不拦截:先跑一周,只记录会拦谁、拦多少,看清楚再开;
- 按调用方分别开:先给异常调用量最大的那条链路开,观察一天;
- 保留一键关闭:配置里留开关,出问题能立刻降级为只记录。
六、检查清单
- 配额是集中计数的,不是「总配额 ÷ 实例数」本地各限一份
- 读、补、判、写在一段脚本里原子完成
- 时间差用的是中心时间或单调时钟,不是本机墙上时间
- 有分段预取,中心压力与出站 QPS 不是一个量级
- 中心不可用时是放行 + 告警,不是全拒
- 速率与容量两个参数分别可调,容量按突发幅度定
- 被拒绝时返回明确的重试等待秒数,不静默丢弃
- 有一条监控看「限流命中率」,突然飙高说明有调用方在异常重试
- 对下游依赖单独限制并发,入口限住不代表出口安全
- 上线顺序是「先记录、后拦截」,且保留一键关闭
七、一句总结
这次超发的根因不是阈值算错,是把「全局共享的额度」当成了「每台机器各自持有的额度」。
分布式系统里的判断标准很简单:这个状态,是我独占的,还是大家共享的? 答案决定实现方式——共享的状态,就必须在共享的地方算。