品牌 GEO 为什么必须先解决“AI 到底认为你是谁”
摘要
当企业开始关注 GEO 时,讨论往往很快进入关键词、Query、内容生产、AI Visibility、引用率和推荐率。但这些工作实际上都建立在一个更基础的假设之上:生成式 AI 已经正确识别了企业、品牌和产品所对应的真实实体。
现实中,这个假设并不总是成立。
一个品牌可能同时存在中文名称、英文名称、简称、历史名称、母公司、运营主体、商标持有人、生产企业、经销主体、不同市场公司以及多个产品版本。当这些信息分散在官网、新闻媒体、电商平台、行业数据库和第三方网页中时,AI 即使识别出了正确的品牌名称,也可能把品牌、公司、产品、人物或主体关系错误地组合在一起。
因此,企业 GEO 的第一层工程问题,并不是“如何让 AI 更多地提到品牌”,而是如何建立一个稳定的 Identity Layer:让不同名称、实体、关系、时间、市场和证据能够被明确区分,并能够持续验证。
本文从 Entity Resolution、Entity Linking、Knowledge Graph 与 RAG 的相关方法出发,建立一套面向企业 GEO 的身份解析框架,重点讨论品牌 Entity 如何建模、Entity Resolution 如何进入检索和 RAG、如何设计测试集,以及企业如何对实体识别错误进行持续监测和诊断。
需要特别说明的是:本文讨论的是一种面向企业知识治理与 GEO Evaluation 的工程方法,并不意味着 Google、OpenAI、豆包或其他商业生成式 AI 系统内部采用完全相同的 Entity Resolution 流程。
关键词: GEO;Entity Resolution;Entity Linking;Knowledge Graph;RAG;Brand Entity;Claim;Evidence;AI Search
一、品牌 GEO 的第一个问题,不是“AI 有没有提到你”
企业开始做 GEO 后,最容易关注的是可见性。
例如:AI 有没有提到自己的品牌?用户询问某一类产品时,品牌是否进入答案?为什么竞争品牌被推荐,而自己没有被推荐?
这些问题当然重要,但它们实际上发生在更靠后的阶段。
在讨论 Visibility 之前,还有一个更基础的问题需要首先得到验证:
AI 所理解的那个“你”,到底是不是你?
假设现实世界中存在以下关系:
品牌 A 的商标由公司 B 持有,公司 C 负责某一地区的业务运营,公司 D 负责产品生产。
互联网上关于这几个主体的资料大量共存,而且官网、新闻、电商平台、产品页面和第三方媒体的表达并不完全一致。
生成式 AI 最终可能回答:
“品牌 A 由公司 D 创立并运营。”
值得注意的是,这句话中的品牌 A 和公司 D 可能都真实存在。
问题并不一定是模型凭空创造了一个不存在的对象,而是把两个真实 Entity 之间的关系绑定错了。
这种问题可以理解为 Entity / Relation Misbinding。
相比完全虚构的信息,这类错误通常更加隐蔽。因为名称是真的、公司是真的,引用页面也可能真实存在,最终形成的答案甚至在语言逻辑上非常流畅。
所以,品牌 GEO 不能只问:
AI 有没有找到我?
还需要继续问:
AI 找到的到底是哪一个 Entity?
以及:
它把这个 Entity 与哪些 Company、Product、Person、Trademark 或 Market 建立了什么关系?
这才是 Entity Resolution 在企业 GEO 中真正需要解决的问题。
二、为什么 Entity 必须位于 Claim 和 Evidence 之前
如果把企业 GEO 的知识链路进行抽象,可以得到:
$$\mathrm{Entity}\rightarrow\mathrm{Claim}\rightarrow\mathrm{Evidence}\rightarrow\mathrm{Knowledge}\rightarrow\mathrm{Retrieval}\rightarrow\mathrm{Citation}\rightarrow\mathrm{Recommendation}$$
Entity 之所以位于最前面,并不是因为它只是一个方便的数据字段,而是因为后续所有事实都必须依附于一个明确对象。
例如:
“成立于 2018 年。”
单独来看,这不是一个完整事实。
真正需要表达的是:
哪个实体成立于 2018 年?
这里可能指品牌,也可能指公司、实验室、业务部门或者某个地区运营主体。
同样,“获得某项认证”也必须继续区分:认证属于公司还是品牌?属于整个产品系列还是某一个 SKU?属于产品本身还是生产工厂?在全球有效,还是只适用于某一个市场?
如果 Entity 没有确定,即使事实本身是真实的,也可能发生 Claim Misbinding:
正确事实,被绑定到了错误对象。
传统内容管理通常按照“文档”组织信息,例如品牌手册、产品手册、新闻稿、官网页面。
知识工程关注的则是另一套结构:
$$\mathrm{Object}\rightarrow\mathrm{Attribute}\rightarrow\mathrm{Relation}\rightarrow\mathrm{Evidence}$$
因此,企业 GEO 中的事实管理不能只停留在“这份文档有没有写错”。
真正需要继续追问的是:
文档中的每一条重要事实,到底属于哪个 Entity?
这也是 Entity Resolution 与传统品牌内容管理的根本区别之一。
三、NER、Entity Linking 与 Entity Resolution 解决的不是同一个问题
Entity Resolution 经常和 Named Entity Recognition、Entity Linking、Entity Disambiguation 混在一起讨论,但它们解决的问题并不完全相同。
3.1 Named Entity Recognition:文本里出现了什么对象
Named Entity Recognition,简称 NER,首先解决的是识别问题。
例如:
“Alpha 在上海设立研发中心。”
系统可能识别出:
- Alpha:Organization
- 上海:Location
这一步只能说明文本中出现了一个组织名称和一个地点名称。
它还没有回答:
Alpha 到底是哪一个现实世界中的组织?
3.2 Entity Linking:这个名称具体对应谁
Entity Linking 继续解决 Mention 与知识实体之间的映射问题。
假设文本中出现:
Alpha
系统可能需要从多个候选中判断它对应:
- Alpha Holdings
- Alpha Technology
- Alpha Brand
- Alpha Laboratory
Entity Linking 的目标,是把文本中的 Mention 映射到一个明确的 Canonical Entity。
可以简单表示为:
$$m\rightarrow e$$
其中,$m$ 表示文本中的 Mention,$e$ 表示知识系统中的 Canonical Entity。
3.3 Entity Disambiguation:多个候选中如何消歧
如果一个 Mention 对应多个可能实体,就需要进一步进行 Disambiguation。
对于 Mention $m$,候选集合可以表示为:
$$C(m)=\{e_1,e_2,\ldots,e_k\}$$
系统需要结合名称、上下文、实体类型和关系信息,判断当前语境真正指向哪个对象。
3.4 Entity Resolution:跨来源统一真实世界对象
企业 GEO 面对的问题还要更复杂。
同一个真实品牌可能在不同来源中被表达为:
Alpha、ALPHA、Alpha Global、Alpha®、阿尔法、Alpha Official。
企业需要判断这些表达中,哪些经过验证后确实指向同一个对象,哪些虽然名称相似,但必须保持分离。
因此,在品牌 GEO 场景中,可以把 Entity Resolution 理解为多个任务的组合:
$$\mathrm{Entity\ Resolution}=\mathrm{Recognition}+\mathrm{Candidate\ Generation}+\mathrm{Disambiguation}+\mathrm{Linking}$$
对于企业级知识治理,还需要进一步处理:
$$\mathrm{Enterprise\ Scope}=\mathrm{Deduplication}+\mathrm{Relation\ Resolution}+\mathrm{Time}+\mathrm{Market}$$
这里的 Time 和 Market 非常重要。
因为品牌关系往往既不是永久成立,也不是全球统一成立。
四、品牌不是一个 Entity,而是一张 Entity Graph
传统品牌传播经常把“品牌”视为一个整体。
但从知识工程角度看,一个真实企业更接近由大量实体和关系组成的图结构。
例如,一个简单的组织层级可能是:
$$\mathrm{Group}\rightarrow\mathrm{Company}\rightarrow\mathrm{Brand}\rightarrow\mathrm{ProductLine}\rightarrow\mathrm{Product}$$
与此同时,现实中还可能存在商标持有、运营、生产、经销、创始人与市场等不同关系。
因此,从知识建模角度看:
$$\mathrm{Brand}\neq\mathrm{Company}$$
$$\mathrm{Brand}\neq\mathrm{TrademarkHolder}$$
$$\mathrm{Product}\neq\mathrm{Manufacturer}$$
$$\mathrm{ParentCompany}\neq\mathrm{OperatingEntity}$$
现实问题在于,企业公开资料往往没有严格按照这种结构组织。
品牌手册强调品牌历史,官网介绍运营公司,新闻稿使用集团名称,产品包装展示生产主体,电商平台又可能展示经销主体。
如果企业没有建立统一的 Entity Layer,多个真实对象就很容易在后续检索和生成中被重新组合成一个看起来合理、实际错误的身份结构。
因此,企业真正需要治理的并不是一段更完整的 About Us,而是一张 Brand Entity Graph。
从图结构上,可以将它表示为:
$$G=(V,E)$$
其中,$V$ 表示实体节点集合,$E$ 表示节点之间的关系集合。
进一步表示为:
$$V=\{v_1,v_2,\ldots,v_n\}$$
$$E=\{r_1,r_2,\ldots,r_m\}$$
这样一来,品牌身份治理的问题就从“文案是否统一”,转变为两个更加明确的问题:
第一,节点是不是正确的;
第二,节点之间的关系是不是正确的。
五、面向 GEO 的 Brand Entity 数据模型
为了让品牌 Entity 可以被计算、验证和持续维护,可以把一个 Canonical Entity 抽象为:
$$E_i=(\mathrm{ID},\mathrm{Type},\mathrm{Name},\mathrm{Alias},\mathrm{Attribute},\mathrm{Relation},\mathrm{Time},\mathrm{Market},\mathrm{Evidence})$$
这个模型中的每一个字段都承担不同作用。
5.1 ID:稳定的实体身份
每个核心 Entity 都应该拥有一个稳定的内部 ID。
例如:
E-BRAND-001
E-COMPANY-001
E-PRODUCT-001
名称可以变化,但 ID 不应该随着企业文案变化。
如果一家公司发生更名,Canonical Name 可以更新,但原来的历史 Claim、Evidence 和 Relation 仍然需要继续关联到同一个真实对象。
从数据治理角度看,这种 ID 很接近数据库中的 Primary Key。
5.2 Type:明确对象类型
常见 Entity Type 可以包括:
Brand、Company、Organization、Person、Product、ProductLine、Trademark、Location 和 Service。
Type 的价值在于帮助后续检索过滤错误候选。
例如,“谁创立了 X”和“X 的保质期是多少”显然对应完全不同的实体类型和关系。
前者通常涉及 Person / Organization Relation;后者则应该进一步定位到 Product Entity。
5.3 Name 与 Alias:名称相似不代表实体相同
对于一个实体 $E$,可以定义 Alias 集合:
$$A(E)=\{a_1,a_2,\ldots,a_n\}$$
Alias 可以包含中文名称、英文名称、简称、历史名称、市场名称和常见缩写。
但 Alias 的意义并不是把所有相似字符串全部合并。
例如 ABC、ABC Holdings 和 ABC Technology 即使名称高度相似,也可能是三个不同的 Entity。
因此,Normalization 的原则应该是:
统一已经验证的别名,而不是统一所有相似名称。
5.4 Relation:很多品牌事实本质上是关系,而不是属性
企业知识中的重要信息,经常表现为 Subject、Predicate 和 Object 之间的关系。
例如:
品牌由哪个公司持有;
品牌由哪个公司运营;
产品由哪个公司生产;
某个人创立了哪家公司。
因此,企业知识中的稳定单元并不只是“一段介绍”,而更接近:
$$\mathrm{Subject}\rightarrow\mathrm{Predicate}\rightarrow\mathrm{Object}$$
这也是为什么企业品牌知识最终往往会从文档集合逐渐走向 Entity + Relation 的结构。
六、Time 与 Market:品牌 Entity 治理中最容易被忽略的两个变量
仅仅知道 A 与 B 存在某种关系还不够。
现实中的商业关系通常具有明确的时间和范围条件。
6.1 时间约束
一个带有时间范围的关系可以表示为:
$$R=(s,p,o,t_s,t_e)$$
其中:
- $s$ 表示 Subject;
- $p$ 表示 Predicate;
- $o$ 表示 Object;
- $t_s$ 表示关系开始时间;
- $t_e$ 表示关系结束时间。
例如,一个人在 2023 年担任公司 CEO,并不意味着该关系在 2026 年仍然成立。
如果时间边界没有被保存,系统就可能把过去正确的事实继续用于当前答案。
这种问题可以称为 Historical Fact Leakage。
6.2 市场约束
商业品牌还存在一个非常重要的变量:Market Scope。
同一品牌可能在中国市场由公司 A 运营,在印度尼西亚市场由公司 B 负责;同一产品也可能只在某些市场销售。
因此,关系不能永远只表达为“Brand → Company”。
更完整的结构应该保留 Qualifier。
可以表示为:
$$R=(s,p,o,q)$$
其中 $q$ 表示关系的限定条件。
例如:
$$q=\{\mathrm{market},\mathrm{time},\mathrm{version},\mathrm{jurisdiction}\}$$
Qualifier 的意义,在于防止:
局部成立的事实被生成式系统扩大成普遍成立的事实。
这也是 Wikidata 等知识系统中 qualifier 思路对企业 GEO 很有参考价值的原因。
七、面向 GEO 的 Entity Resolution Pipeline
借鉴经典 Entity Linking 方法,可以把面向企业 GEO 的 Entity Resolution 抽象成一个逐层收敛过程。
最简化的表达为:
$$m\rightarrow C(m)\rightarrow e^*\rightarrow R\rightarrow\mathrm{Evidence}$$
其中:
- $m$:文本中的 Mention;
- $C(m)$:Mention 对应的候选实体集合;
- $e^*$:最终解析后的 Canonical Entity;
- $R$:目标 Entity 与其他对象的 Relation;
- Evidence:支撑该 Entity 或 Relation 的证据。
这条链路的价值,不在于假设商业大模型内部必然这样工作,而在于帮助企业把“AI 认错品牌”拆成可以逐层诊断的问题。
7.1 Mention Detection
第一步是识别文本中出现了哪些实体对象。
例如:
“A 公司旗下 B 品牌推出 C 产品。”
至少可以识别三个 Mention:
A 是 Company Mention,B 是 Brand Mention,C 是 Product Mention。
但此时只完成了“发现名称”,并没有完成真实世界对象的绑定。
7.2 Candidate Generation
对于 Mention $m$,可以先生成候选集合:
$$C(m)=\{e_1,e_2,\ldots,e_k\}$$
例如“Alpha”可能对应 Alpha Brand、Alpha Holdings、Alpha Technology 和 Alpha Product Line。
在经典 Entity Linking 研究中,一个常见思路就是先召回候选,再进行更加精细的排序和消歧。
BLINK 就采用了典型的两阶段方法:首先进行候选检索,再使用更精细的模型进行 Re-ranking。
这说明一个重要问题:
Entity Linking 并不是一次字符串匹配,而是候选生成与消歧的组合过程。
7.3 Context Matching
得到候选之后,需要利用当前问题和上下文继续判断。
可以定义一个上下文信号:
$$S_{\mathrm{context}}(m,c,e)$$
其中,$m$ 表示 Mention,$c$ 表示上下文,$e$ 表示候选 Entity。
例如,当用户问:
“Alpha 的创始人是谁?”
Company 或 Brand Entity 通常比 Product Entity 更符合当前上下文。
而当用户问:
“Alpha 的保质期是多少?”
系统则应该进一步定位到具体 Product Entity。
7.4 Relation Constraint
纯语义相似度仍然不足以解决品牌身份问题。
假设用户问:
“A 品牌由哪个公司运营?”
目标其实是某一种特定 Relation,而不是“哪个公司与 A 经常一起出现”。
因此,可以再定义关系匹配信号:
$$S_{\mathrm{relation}}(e,q)$$
其中,$q$ 表示当前 Query。
品牌 GEO 中相当一部分错误,本质上并不是找不到 Entity,而是 Relation 被连接错了。
7.5 Evidence Validation
最后还必须回答:
为什么相信这条关系成立?
两个 Entity 同时出现在一篇新闻报道中,并不能自动证明二者存在所有权、运营权或者生产关系。
因此,一个完整身份 Claim 可以抽象为:
$$\mathrm{Claim}=(s,p,o,q,\mathrm{Evidence})$$
从这里开始,Entity Resolution 才真正与 Claim Governance 和 Evidence Governance 连接起来。
八、为什么只做向量检索仍然可能把品牌认错
这一问题在企业 RAG 中尤其典型。
假设知识库中存在两个文档。
Document A 表示 Alpha Brand 由 Alpha Global 运营。
Document B 表示 Alpha Technology 负责 Alpha 某项产品研发。
当用户询问:
“Alpha 是由哪个公司运营的?”
Vector Search 很可能同时召回两个文档,因为它们在语义上都与 Alpha、Company 和相关业务高度相关。
但必须区分两个概念:
$$\mathrm{Semantic\ Similarity}\neq\mathrm{Entity\ Identity}$$
同样:
$$\mathrm{Relevant\ Document}\neq\mathrm{Correct\ Relation}$$
一个文档与问题相关,并不意味着该文档中的任何 Entity 都适合填入目标 Relation。
如果企业 RAG 只有:
Query → Vector Search → Documents
那么模型就可能在多个“相关文档”之间重新组合出一个错误关系。
更稳健的企业知识检索,应该考虑加入 Entity、Relation、Metadata、Time、Market 和 Evidence 等约束。
例如,检索过程可以按照以下逻辑处理:
首先识别 Query 中涉及哪个 Entity,其次识别问题要求的是哪种 Relation,然后生成候选对象,再结合 Metadata、Graph Relation、Time、Market 和 Evidence 进行过滤,最后再进入答案生成。
这里必须再次强调:
这是一种企业可以控制和实现的 Knowledge Retrieval Architecture,并不是对任何公共生成式搜索平台内部结构的反向推断。
九、Entity Resolution 本质上是多信号约束问题
为了进一步解释为什么名称匹配或向量相似度不足以完成 Entity Resolution,可以构造一个概念性的多信号评分模型。
对于候选实体 $e_i$:
$$ERS(e_i)=\alpha S_{\mathrm{semantic}}+\beta S_{\mathrm{alias}}+\gamma S_{\mathrm{relation}}+\delta S_{\mathrm{evidence}}+\epsilon S_{\mathrm{temporal}}+\zeta S_{\mathrm{market}}$$
其中:
$S_{\mathrm{semantic}}$ 表示上下文语义匹配程度;
$S_{\mathrm{alias}}$ 表示名称与 Alias 的匹配程度;
$S_{\mathrm{relation}}$ 表示候选 Entity 是否满足当前 Query 所要求的关系;
$S_{\mathrm{evidence}}$ 表示身份关系是否存在可靠 Evidence;
$S_{\mathrm{temporal}}$ 表示事实时间是否与问题时间一致;
$S_{\mathrm{market}}$ 表示事实市场范围是否与当前问题一致。
这里的 $\alpha$、$\beta$、$\gamma$、$\delta$、$\epsilon$ 和 $\zeta$ 只是用于表达不同信号的重要程度。
需要特别强调:
ERS 不是 ChatGPT、Google、豆包或任何其他商业生成式系统公开的 Entity Resolution 公式。
它只是一个 Engineering Model,用来表达一个核心思想:
品牌 Entity Resolution 是一个多信号约束问题,而不是简单的字符串匹配或者向量相似度问题。
十、Entity Resolution 如何进入 GEO Evaluation
既然 Entity Resolution 是整个 GEO Knowledge Layer 的基础,就不能仅通过人工试问几个问题进行评价。
企业需要建立一个可重复、可比较的测试体系。
10.1 Entity Identification Accuracy
实体识别正确率可以表示为:
$$EIA=\frac{N_{\mathrm{correct\ entity}}}{N_{\mathrm{valid\ tests}}}$$
这个指标回答的是:
在全部有效测试中,系统有多少次最终绑定到了正确目标 Entity。
10.2 Entity Confusion Rate
实体混淆率可以表示为:
$$ECR=\frac{N_{\mathrm{wrong\ entity}}}{N_{\mathrm{valid\ tests}}}$$
典型错误包括:把 Brand 当作 Company,把 Parent Company 当作 Operating Entity,把 Manufacturer 当作 Brand Owner,或者把 Product Line 当成独立 Brand。
10.3 Relation Accuracy
Entity 正确,并不意味着 Relation 一定正确。
因此还可以定义:
$$RA=\frac{N_{\mathrm{correct\ relation}}}{N_{\mathrm{tested\ relation}}}$$
企业可以重点测试 Ownership、Operation、Part-of、Founder、Production 和 Distribution 等核心关系。
10.4 Alias Recall
对于已经确认的有效 Alias,可以定义:
$$AR=\frac{N_{\mathrm{recognized\ aliases}}}{N_{\mathrm{verified\ aliases}}}$$
如果系统只能识别正式英文名,而无法正确解析中文简称、历史名称或者常用缩写,那么 Identity Layer 仍然是不完整的。
10.5 Temporal Binding Accuracy
对于存在历史变化的 Relation,可以定义:
$$TBA=\frac{N_{\mathrm{correct\ temporal\ bindings}}}{N_{\mathrm{temporal\ tests}}}$$
它主要衡量历史事实和当前事实能否被正确区分。
10.6 Unsupported Identity Claim Rate
还可以专门监测生成答案中缺少证据支持的身份关系:
$$UICR=\frac{N_{\mathrm{unsupported\ identity\ claims}}}{N_{\mathrm{identity\ claims}}}$$
母公司、投资关系、创始人、商标权属和认证主体等高风险信息尤其值得监控。
需要说明的是,EIA、ECR、RA、AR、TBA 和 UICR 都属于本文提出的企业 GEO 工程指标,并不是目前任何 AI 平台发布的统一行业标准。
十一、Entity Resolution 的测试集不能只有“XX 是什么品牌”
如果测试集只有:
“XX 是什么品牌?”
那么即使回答正确,也很难证明 Identity Layer 已经稳定。
一个更完整的 Query Test Set 应覆盖不同类型的实体关系。
| Query 类型 | 测试目标 |
|---|---|
| Identity Query | 判断系统是否识别正确实体 |
| Alias Query | 判断不同名称能否映射到同一实体 |
| Ownership Query | 判断品牌与所有方关系 |
| Operation Query | 判断品牌与运营主体关系 |
| Product Query | 判断产品与品牌关系 |
| Founder Query | 判断人物与组织关系 |
| Relationship Query | 判断两个 Entity 之间的关系 |
| Market Query | 判断关系是否限定于正确市场 |
| Temporal Query | 判断当前事实与历史事实是否被区分 |
| Ambiguous Query | 测试简称、旧称和高混淆名称 |
如果进一步设计工程实验,可以把测试空间表示为:
$$E\times A\times Q\times M\times R\times T$$
其中:
- $E$:Entities;
- $A$:Aliases;
- $Q$:Query Variants;
- $M$:Models;
- $R$:Repeated Runs;
- $T$:Timepoints。
这个表达同样不是行业标准。
它想强调的是一个实验设计原则:
不能用一个名字、一个 Prompt、一个模型和一次回答证明 Entity Resolution 已经稳定。
十二、Entity Monitoring 的目标不是打分,而是 Debugging
如果测试最终只保存“正确”或者“错误”,仍然很难帮助企业真正修复问题。
一次 Entity Test 至少应该保留以下字段:
| 字段 | 作用 |
|---|---|
| query_id | 测试 Query ID |
| query_text | 原始问题 |
| target_entity | 目标 Entity |
| alias_used | 测试中使用的名称 |
| target_relation | 目标 Relation |
| model_id | 测试模型 |
| timestamp | 测试时间 |
| raw_answer | 原始答案 |
| resolved_entity | 实际解析 Entity |
| resolved_relation | 实际解析 Relation |
| citations | 答案引用 |
| entity_correct | Entity 是否正确 |
| relation_correct | Relation 是否正确 |
| temporal_correct | 时间绑定是否正确 |
| market_correct | 市场范围是否正确 |
| evidence_status | Evidence 是否有效 |
| review_status | 人工审核状态 |
这样,一次错误才能被进一步定位。
如果品牌完全没有被识别,问题可能位于 Discovery 或 Retrieval。
如果品牌名称出现了,但系统绑定到错误公司,更可能属于 Candidate Generation 或 Disambiguation 问题。
如果 Entity 正确,但运营主体或母公司关系错误,则需要检查 Relation、Claim 和 Source。
如果使用的是过去正确、现在已经失效的关系,则属于 Temporal / Freshness 问题。
如果引用了另一个市场中的主体关系,则属于 Market Scope 问题。
如果关系本身正确,但引用页面并不能真正支持该关系,则属于 Citation / Evidence 问题。
因此:
“AI 把品牌说错了”只是错误现象,并不是完整的工程诊断。
成熟的 GEO Monitoring 应该继续回答:
错误究竟发生在 Identity Pipeline 的哪一层?
这也是为什么 Entity Monitoring 更应该被理解为一个 Debugging System,而不是排行榜。
十三、Schema.org 和 sameAs 能不能直接解决 Entity Resolution
这是品牌 GEO 中最容易被过度简化的问题之一。
Google 的 Organization structured data 确实允许企业向搜索系统提供更加明确的组织信息,例如 name、alternateName、url、logo、sameAs、address 等。Google 也明确说明,这些信息可以帮助其更好地了解和区分组织。
因此,Structured Data 可以成为非常重要的 Identity Signal。
但必须区分:
$$\mathrm{Identity\ Signal}\neq\mathrm{Ground\ Truth}$$
结构化数据并不能简单理解成:
企业提交一次 Schema,所有生成式 AI 就会完全按照企业定义理解品牌。
真实的信息环境远比单一页面复杂。
搜索和生成系统可能同时接触新闻媒体、行业数据库、历史网页、电商平台、社交网络、第三方机构和其他公开知识来源。
所以,企业真正需要解决的是:
Multi-source Identity Consistency
而不是只解决一个页面上的 Schema。
十四、为什么 Wikidata 的知识结构值得企业 GEO 研究
Wikidata 值得研究,并不意味着每个品牌都必须依赖 Wikidata。
真正值得借鉴的是它的知识建模思想。
Wikidata 的 Statement 建立在 Subject–Predicate–Object 关系上,同时允许进一步加入 Qualifier、Reference 和 Rank。
对于企业品牌知识,这种结构非常具有启发性。
现实中的知识通常并不是一句简单的:
A 是 B。
更常见的情况是:
A 在某个时间、某个市场或者某个业务范围内,与 B 存在某种关系,并且该关系由某一来源支持。
因此,一个更加接近真实商业世界的知识表达需要同时包含:
Entity、Relation、Qualifier 和 Evidence。
这也是企业 Knowledge Base 从“文档仓库”逐渐向“结构化知识系统”发展的重要原因。
十五、Entity Resolution 不是一次性的名称清洗
企业很容易把 Entity 项目理解成:
把品牌名、公司名和产品名统一一次。
但现实中的 Entity 会持续变化。
公司可能更名,品牌归属可能调整,产品线可能重构,企业可能发生并购,新市场可能上线,运营主体和经销主体也可能变化。
因此,Identity Layer 必须拥有生命周期。
它至少包括:
Create、Verify、Publish、Monitor、Update、Conflict Resolution 和 Archive。
换句话说:
Entity Resolution 不是一次性数据清洗,而是一项持续性的知识治理工作。
这一点对于 GEO 尤其重要。
因为企业内部更新了一条事实,并不意味着公开互联网中的旧事实会自动消失。
新旧页面、新旧报道和不同版本信息可能长期共存。
因此,一个成熟的 Identity Layer 必须明确区分:
Current Fact 与 Historical Fact。
十六、为什么 Entity Resolution 应该成为 GEO 的 Hard Gate
企业在建立 GEO Dashboard 时,很容易希望最终获得一个综合分数。
例如 GEO Score = 87。
但如果核心 Entity 本身识别错误,那么这样的综合分数并没有太大意义。
假设某个品牌拥有很高的 Visibility、Citation Rate 和 Coverage,但生成式系统始终把品牌所有方和生产企业混淆,那么更高的曝光反而意味着:
错误信息被传播得更加稳定。
因此,在企业级 GEO 中,Entity Layer 更适合作为一个前置 Gate,而不是普通指标。
例如,可以建立以下内部检查门槛:
Gate 1:Canonical Entity 已建立。
Gate 2:核心 Entity Relationship 已完成验证。
Gate 3:高风险 Identity Claim 均存在 Evidence。
Gate 4:核心 Entity Confusion Rate 低于企业定义的风险阈值。
Gate 5:关键 Market、Time 和 Version Qualifier 完整。
只有通过 Identity Gate 以后,再继续讨论 Visibility、Citation、Recommendation 和 Business Outcome,才更有工程意义。
这里所说的 Gate 仍然属于企业管理框架,而不是行业统一标准。
十七、从 Identity Layer 到完整的 GEO Engineering
如果把企业 GEO 看成一套完整的信息工程系统,可以将它表示为:
$$\mathrm{Identity}\rightarrow\mathrm{Claim}\rightarrow\mathrm{Evidence}\rightarrow\mathrm{Knowledge}\rightarrow\mathrm{Retrieval}\rightarrow\mathrm{Citation}\rightarrow\mathrm{Recommendation}\rightarrow\mathrm{Action}$$
Identity Layer 解决的是:
这个对象到底是谁?
Claim Layer 解决的是:
关于这个对象有哪些可以陈述的事实?
Evidence Layer 解决的是:
为什么这些事实可信?
Knowledge Layer 解决的是:
这些事实如何被结构化组织、维护和发布?
Retrieval Layer 解决的是:
当用户提出问题时,相关知识能否被正确取得?
Citation Layer 解决的是:
引用是否真正支持答案中的 Claim?
Recommendation Layer 进一步解决:
为什么这个品牌或产品适合当前用户与场景?
Action Layer 则继续进入:
推荐能否进一步转化为服务、交易或 Agent 调用?
因此,Entity Resolution 并不是 GEO 体系中一个孤立的 NLP 技术问题。
它更接近整个企业知识系统的 Primary Key。
如果 Primary Key 本身错了,那么后面的 Claim、Evidence、Retrieval、Citation 和 Recommendation 做得再复杂,也可能只是在更加高效地处理错误对象。
十八、结论:GEO 的起点不是 Visibility,而是 Identity
今天很多 GEO 项目仍然从关键词、Prompt、内容生产和 AI Visibility 开始。
但对于真正进入企业级应用的 GEO,更值得优先验证的是:
AI 到底认为你是谁?
这个问题至少包含五个层次。
第一,系统是否识别到了正确 Entity。
第二,名称是否绑定到了正确 Canonical Entity。
第三,Brand、Company、Product、Trademark、Person 等对象之间的 Relation 是否正确。
第四,Time、Market、Version 等 Qualifier 是否被正确保留。
第五,关键身份关系是否存在可靠 Evidence。
只有这些条件基本稳定以后,企业继续讨论 AI 是否发现品牌、是否正确描述品牌、是否引用品牌、是否推荐产品,以及是否进一步调用企业能力,才真正具有工程意义。
所以,品牌 GEO 的第一步不是:
怎样让 AI 多提到我?
而是建立一个稳定、可验证、可维护的:
GEO Identity Layer。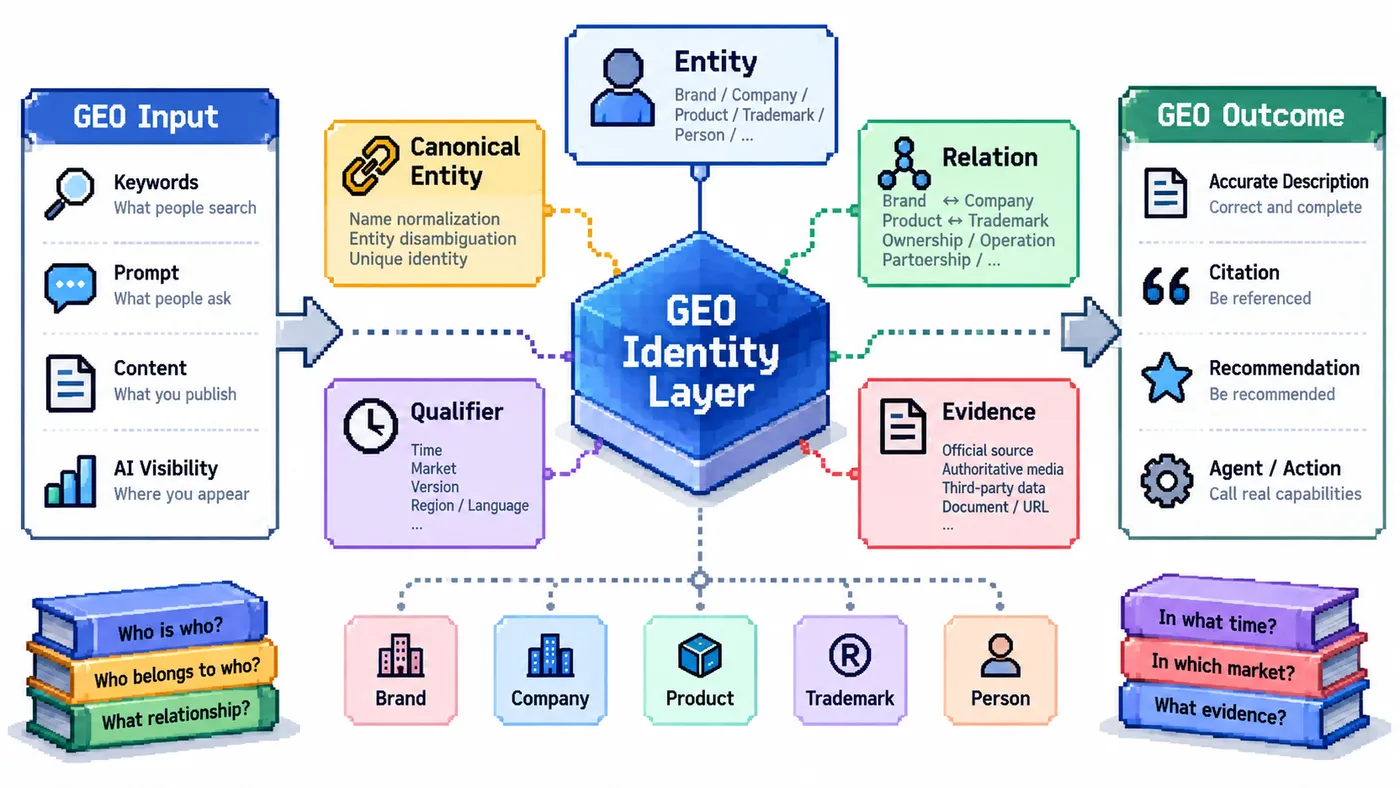
从这个角度看,Entity Resolution 是企业从“内容优化”进入“知识基础设施”的第一道分水岭。
企业真正需要建设的,也不再只是一个内容更加丰富的 About Us 页面,而是一套能够持续回答以下问题的实体知识系统:
谁是谁?
谁属于谁?
谁运营谁?
谁生产谁?
什么关系在什么时间成立?
什么关系只在某个市场成立?
哪些关系已经成为历史信息?
每一条关键身份关系由什么 Evidence 支持?
当“你是谁”这个问题稳定下来之后,Claim、Evidence、Knowledge Hub、Citation、Recommendation 和 Agent 才拥有真正可靠的基础。
因此,从工程视角看:
GEO 的起点不是曝光,而是身份。
十九、下一篇:从 Entity Resolution 理论进入企业 Entity Governance
本文主要解决的是 Entity Resolution 在 GEO 中的理论与工程方法。
下一篇将从真实企业品牌管理场景出发,进一步讨论:
《企业 GEO 工程化实践(四):品牌如何搭建一套可长期维护的 Entity Governance System》
下一篇将进入真正的操作层,包括:
- Entity Inventory
- Canonical Entity
- Alias Dictionary
- Entity Map
- Relationship Matrix
- Claim Matrix
- Evidence Mapping
- Conflict Registry
- Market / Time Qualifier
- Query Test Set
- Version Control
- Monitoring Dashboard
并通过实际品牌结构进一步回答:
品牌部、产品部、法务、技术和内容团队,究竟应该如何把 Brand、Company、Product、Trademark、Person 与 Market 整理成一套真正能够长期维护的 Entity Governance System?
参考文献
[1] Wu, L., Petroni, F., Josifoski, M., Riedel, S., & Zettlemoyer, L. Scalable Zero-shot Entity Linking with Dense Entity Retrieval. Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP), 2020, pp. 6397–6407. DOI: 10.18653/v1/2020.emnlp-main.519.
[2] Röder, M., Usbeck, R., & Ngonga Ngomo, A.-C. GERBIL – Benchmarking Named Entity Recognition and Linking Consistently. Semantic Web, 2018. DOI: 10.3233/SW-170286.
[3] Wikidata. Help: Statements. Wikidata uses statements to connect entities through property-value relationships and supports qualifiers, references and ranks for additional context and provenance.
[4] Wikidata. Help: Qualifiers. Qualifiers can further constrain or contextualize statements, including validity period and other conditions.
[5] Google Search Central. Organization Structured Data. Organization structured data can provide explicit identity information such as name, alternateName, URL, logo, address and sameAs, helping Google understand and distinguish organizations.
研究说明
本文提出的 GEO Identity Layer、Entity Resolution Scoring Model、EIA、ECR、RA、AR、TBA、UICR 以及 Identity Gate,属于基于 Entity Linking、Knowledge Graph、RAG 与企业 GEO 场景构建的工程分析与管理框架。
这些模型并不是 Google、OpenAI、豆包或其他生成式 AI 平台公开发布的内部算法,也不是现行行业统一标准。
本文引用 Entity Linking、知识图谱、RAG 与结构化数据相关研究,目的在于构建一套可以被测量、验证、复现和诊断的企业 GEO Identity Framework,而不是通过公开现象反向推断任何商业大模型的具体内部实现。