
做大模型应用这么久,我见过最多的AI编码翻车场景,十有八九都出在“文档过时”上。让Claude Code对接最新版Supabase,它能给你编出几个早已废弃的API。大模型的训练数据永远追不上开源库的迭代速度,这是所有AI编码工具的天生短板。直到我接触到Context7——一个专门给AI代理提供实时、版本精准的库文档的工具,本质上是把垂直领域的RAG做到了编码场景的极致。官网显示它已经索引了超过14.7万个开源库的文档,从前端的React、Next.js到后端的Supabase、Playwright,几乎覆盖了主流开发栈。
核心逻辑:两级流水线实现精准文档检索
很多人以为它就是个文档搜索引擎,其实它的核心是一套标准化的“库识别-精准检索”两级流水线,配合MCP协议无缝接入所有主流AI编码客户端。
它的核心工作流用一句话说就是:先从你的问题里识别出你用的是什么库,再去这个库的最新文档里精准检索你需要的内容,最后把结果塞回AI的上下文里。
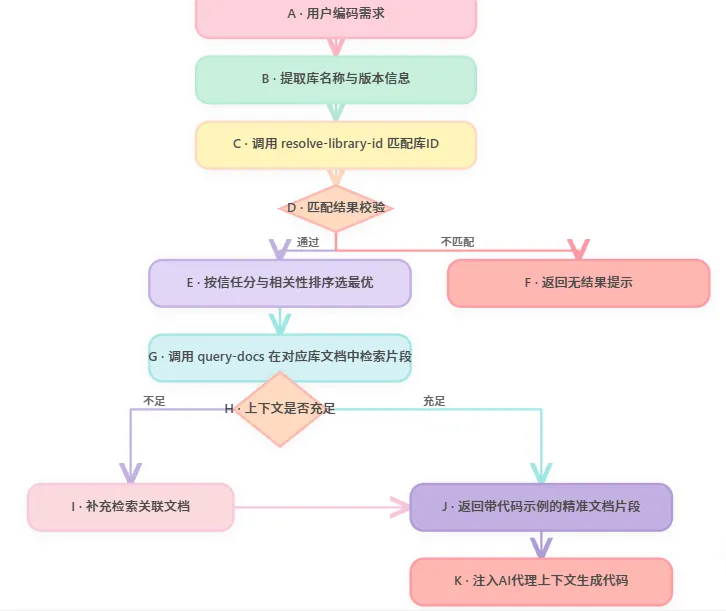
这个流程里最核心的是两个MCP工具: 第一个是resolve-library-id,输入自然语言的库名(比如“React”“nextjs”),输出Context7标准的库标识符(比如/reactjs/react.dev、/vercel/next.js)。它不是简单的字符串匹配,会结合仓库星数、维护活跃度、域名权威性等信任分排序,还能识别别名和简称,比如你说“playwright测试工具”它能准确匹配到微软的Playwright库。
第二个是query-docs,拿到库ID之后,针对具体问题在对应库的文档里做语义检索,返回的不是整篇文档,而是和问题最相关的段落+代码片段,避免冗余上下文占用Token。
这两级拆分的设计非常巧妙。通用RAG工具往往是把所有文档塞到一个向量库里一起搜,很容易出现跨库混淆,比如搜“useState”同时跑出React和Vue的结果。Context7先锁定库,再在库内检索,准确率直接拉高一个量级,这也是垂直RAG和通用RAG的核心区别。
在此基础上,官方还封装了预构建的Context7Agent,自动完成从库识别到文档检索的全流程,不需要手动调用工具。适合长上下文任务场景,能避免文档检索的工具调用记录挤占核心编码上下文,最终只返回精简的答案和代码示例。
技术架构:四层模块化设计
Context7的整体架构是分层的,从客户端到数据层各司其职,扩展性很强。
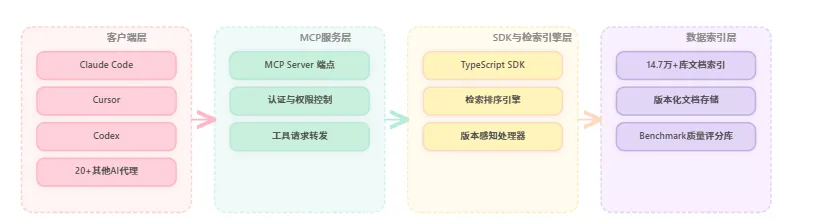
最底层的数据索引层,是Context7的核心护城河。它不是简单爬取文档,而是会做深度结构化处理:
- 版本感知解析:自动识别多版本文档结构,默认只索引最新稳定版,旧版本保留可访问路径,支持通过
/org/project@version格式指定版本检索 - 代码片段提取:自动从Markdown、rst、ipynb等文档里提取可运行的代码示例,单独建立索引
- 冗余去重:精确字符串匹配+余弦相似度过滤,去掉重复的文档片段和同质化代码示例
- 质量评分体系:每个库都有Benchmark分数,用自动化生成的开发者视角问题测试文档回答准确率,官网热门库列表里可以直观看到这个分数——比如React是83.6分,Next.js是78.0分,Supabase是74.4分。
除了自动索引开源库,任何人都可以提交公共库到Context7,支持从GitHub/GitLab/Bitbucket仓库、官方文档网站、Confluence空间、OpenAPI规范等多种来源导入。它的Docs7组件会把每个文档页面转换成干净的Markdown格式,提供llms.txt文档清单、/ask搜索API等标准化端点,方便AI代理自动发现和读取文档,这也是它能快速接入大量库的核心原因之一。
中间的检索引擎层,负责语义检索和结果排序,除了语义相关性,还会把库的信任分、Benchmark分数加权进排序算法,优先返回高质量、高活跃度的库的结果。
MCP服务层是对接客户端的核心,完全遵循Model Context Protocol标准协议,只要支持MCP的AI代理都能无缝接入,这也是它能同时支持Claude、Cursor、Codex等二十多款工具的原因。
最上层的客户端层,除了MCP原生支持,还提供了CLI工具,不支持MCP的环境也能用命令行调用文档能力,兼容性拉满。
开箱即用:一条命令接入你的编码工具
Context7的接入成本极低,这是我最欣赏的一点。不需要你去部署向量库,不需要写任何集成代码,一条npx命令就能完成全流程配置。
核心命令是npx ctx7 setup,运行后有两种模式可选:
- MCP服务器模式:把Context7注册为你AI工具的MCP服务器,代理可以原生调用两个核心工具,适合支持MCP的客户端,比如Claude Code、Cursor
- CLI + Skills模式:安装一个docs技能,通过ctx7命令行调用文档能力,不需要MCP支持,兼容性更广
针对常用工具,还可以一键定向配置,省去选择步骤:
# 配置 Claude Code
npx ctx7 setup --claude

# 配置 Cursor
npx ctx7 setup --cursor

# 配置 OpenCode
npx ctx7 setup --opencode
整个配置过程走OAuth设备流,会弹出浏览器登录授权,自动生成API密钥并写入对应工具的配置文件,全程不用手动复制粘贴。对于远程SSH、无头服务器、CI环境也一样能用,只要在任意设备上打开验证链接完成授权就行。
配置完成之后,使用起来几乎没有感知。比如在Cursor里,你正常写需求“用Next.js App Router写一个带JWT校验的接口”,它会自动调用Context7拉取最新的Next.js文档,生成的代码都是当前最新版本的写法,不会再出现过时的API。如果用的是预构建的Context7Agent,甚至看不到工具调用过程,直接返回最终结果。
质量与安全:把可靠性刻进底层
很多人用AI工具生成代码,最怕的就是“一本正经的胡说八道”,Context7在质量管控和安全防护上做了不少底层设计。
首先是Benchmark驱动的质量体系。每个入库的库都会用自动化生成的开发者问题做测试,统计回答准确率,生成Benchmark分数。这个分数是完全公开的,直接展示在官网的库列表里,分数低的库在检索时会被降权,相当于用公开透明的机制倒逼文档质量提升。
其次是信任评分机制。每个库的信任分由两部分组成:仓库信号(Star数、提交活跃度、维护账号年龄)和网站信号(TLS证书、域名权重、反向链接数量)。知名组织维护的库(比如Vercel的Next.js、Meta的React)信任分更高,检索时会优先返回,从源头上降低遇到低质量文档的概率。
还有很重要的一点是提示注入防护。因为文档内容来自第三方,可能存在恶意注入的提示词,Context7做了双通道检测流水线来拦截恶意内容,同时最小化误判率,并且会定期更新检测规则应对新的攻击方式。
隐私方面,Context7采用隐私优先的架构设计:你的代码、对话历史、完整Prompt都不会传到Context7的服务器,只有你查询的库名和问题文本会发送过去。企业版还可以关闭查询存储,甚至完全私有化部署,所有数据都留在企业内部。
适用场景与实际体验
从这段时间的使用来看,这几类场景下Context7的价值最明显:
第一,新技术栈快速上手。比如你刚接触Next.js 15或者Supabase v3,不用边写边翻官方文档,AI直接基于最新文档生成代码,踩坑概率大大降低。我最近用它写Playwright自动化脚本,之前经常记错API名称和参数顺序,现在生成的代码基本一次就能跑通,调试时间减少了至少六成。
第二,多版本库兼容开发。如果你维护的老项目用的是旧版本库,可以指定版本号检索对应文档,比如/vercel/next.js@14.0.0,不会给你返回v15的新用法,避免出现版本不兼容的问题。
第三,企业内部文档私有化接入。企业版支持把内部的组件库、业务文档、接口规范接入Context7,这样公司内部的AI编码工具就能基于内部文档生成代码,不用再担心内部API泄露或者AI瞎编业务逻辑。
当然它也不是万能的。对于非常小众的库,或者文档写得很差的库,它的效果也会打折扣,毕竟巧妇难为无米之炊。另外国内直接访问可能会有网络延迟,对速度要求高的团队可以考虑私有化部署方案。
总的来说,Context7代表了AI编码工具的一个重要方向:大模型本身的能力是基础,但要真正落地到生产级编码,必须要有精准、实时的外部知识注入。通用大模型的训练数据永远追不上技术迭代,而垂直领域的实时RAG就是补上这块短板的关键。

