
数据团队最容易被低估的一项工作,是把数据从一个系统搬到另一个系统。业务方看见的是结果:报表里多了一列,数据仓库里多了一张表,分析平台里多了一份数据。
数据团队看见的是另一回事。源库是什么?数据类型要不要转换?历史数据怎么搬?新增数据怎么同步?任务中断之后从哪里继续?
每一个问题,都不难回答。但当数据源从三个变成三十个,从三十个变成上百个,ETL 就不再是一个脚本问题,而是一项长期运维工作。这也是为什么,数据集成工具一直没有消失。
当接入的系统越来越多,仅靠脚本维持数据链路,团队很容易把大量时间耗在重复开发、故障排查和任务维护上。
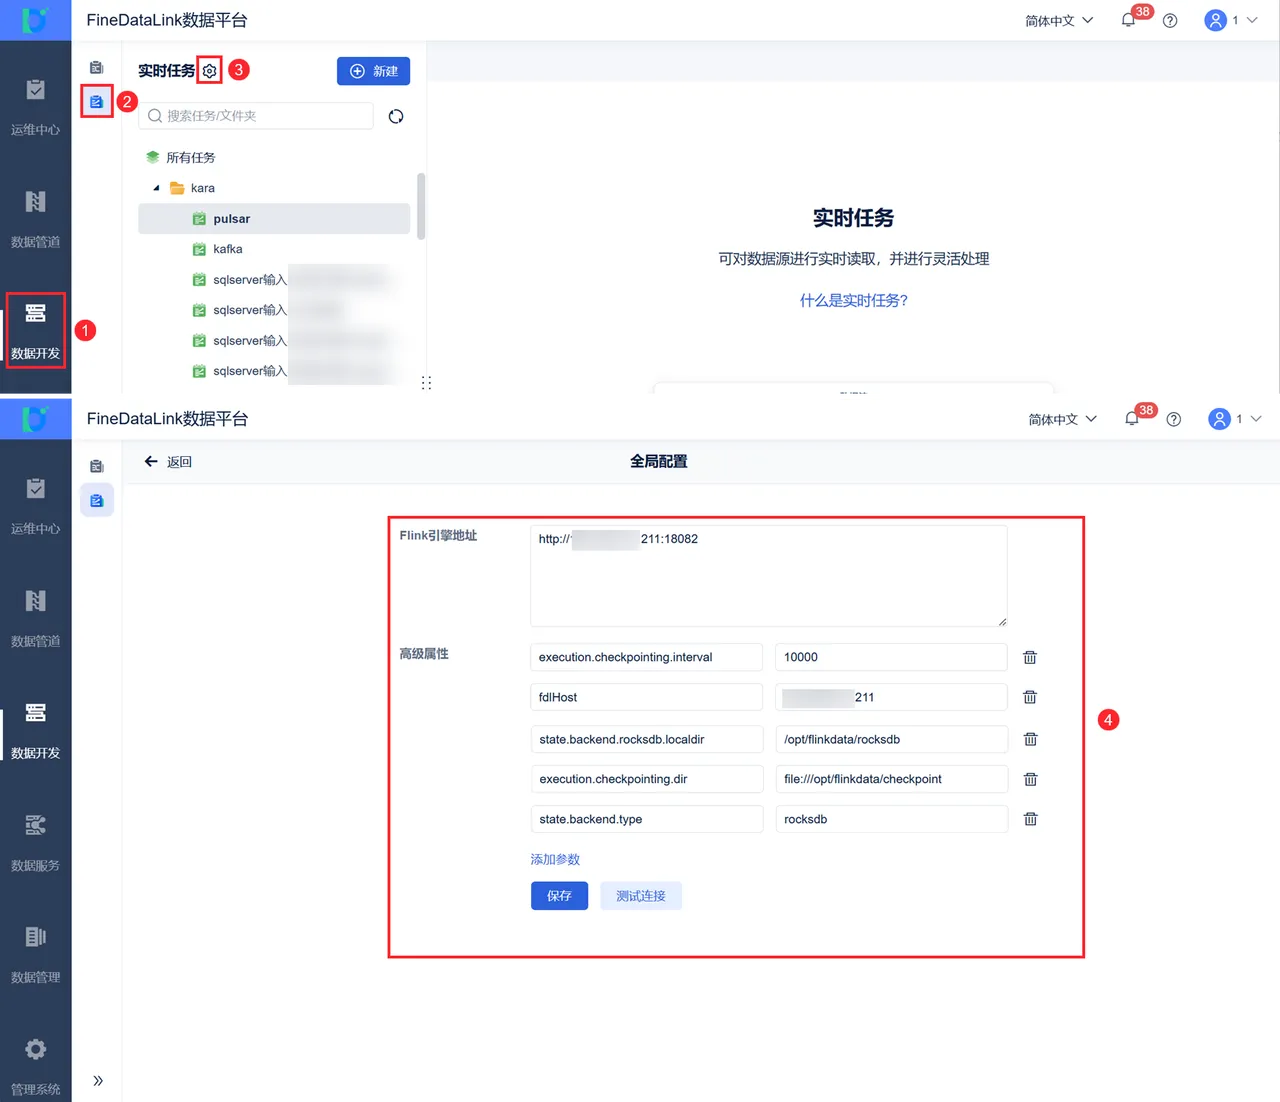
下面就从数据团队最常遇到的问题出发,看看 ETL 工具为什么仍然不可替代,以及“百种数据源接入”和“海量数据同步”究竟解决了什么。
一、ETL 最麻烦的,从来不是「搬」
很多人第一次接触 ETL,会把它理解成三个动作:抽取、转换、加载。Extract,抽取数据。Transform,转换数据。 Load,加载数据。概念很简单。真正做起来,麻烦从第二天就开始了。
今天要把 MySQL 的订单表同步到数仓。明天要把 Oracle 的客户表同步到数据集市。后天又接入一个 MongoDB,再过几天,Kafka 里的实时消息也要落到分析平台。每接一个数据源,就要重新确认连接方式、字段结构、数据类型和同步策略。
同一个「客户状态」,在 A 系统里叫 status,在 B 系统里叫 customer_state,到了 C 系统又变成了中文枚举。同一个日期,在不同系统里可能是时间戳、字符串,或者带时区的时间类型。
数据没有消失。它只是以不同的方式存在,然后等着数据团队把它们翻译成同一种语言。ETL 的难点,不是把数据搬过去,而是让不同系统里的数据能够正确地对上。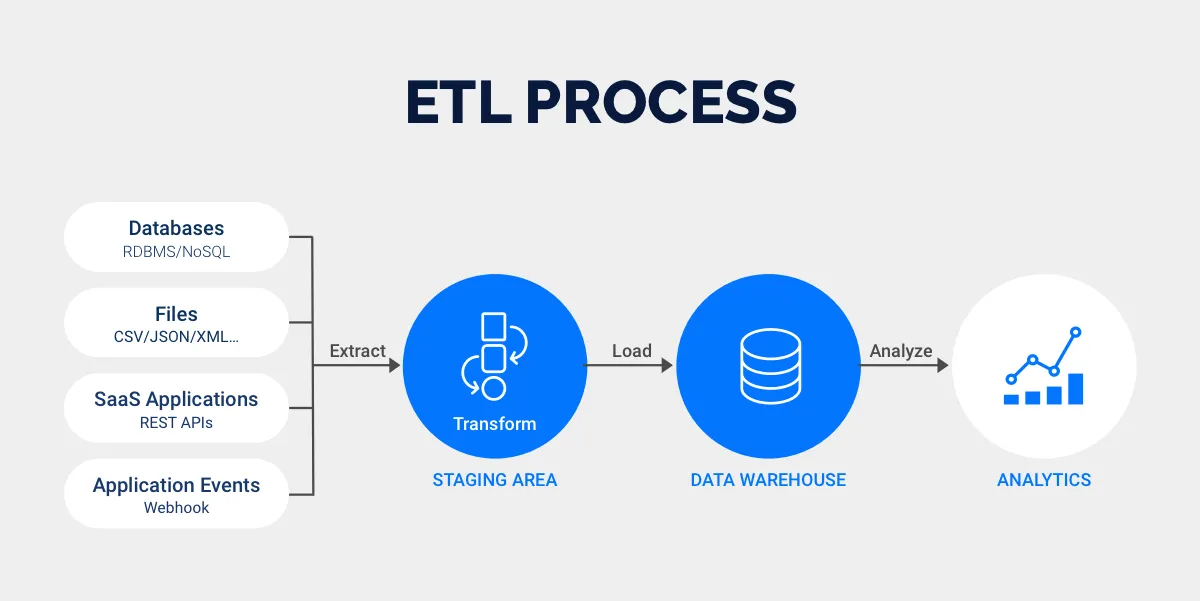
二、数据源一多,脚本就开始失控
一开始,很多团队会选择自己写。写一个 Python 脚本,连接 MySQL,抽数据,清洗,再写入目标库。能跑。于是再写一个,连接 Oracle。再写一个,处理 CSV 文件。再写一个,消费 Kafka 消息。
脚本越来越多,任务越来越复杂,最后形成了一套谁也不敢动的系统:连接信息散落在不同配置文件里,字段映射写死在代码里,全量同步和增量同步各有一套逻辑,任务依赖靠 Cron 和人工记忆维护,失败之后没有统一告警,只能等业务来发现,上游表结构一改,下游任务就开始报错
真正让人崩溃的,不是写第一个脚本。是第 38 个脚本出问题的时候,没有人知道它依赖了哪些任务,也没有人确定改完之后会不会影响另外 12 个系统。脚本解决的是「这次能不能跑」。 数据集成平台解决的是「以后能不能一直稳定地跑」。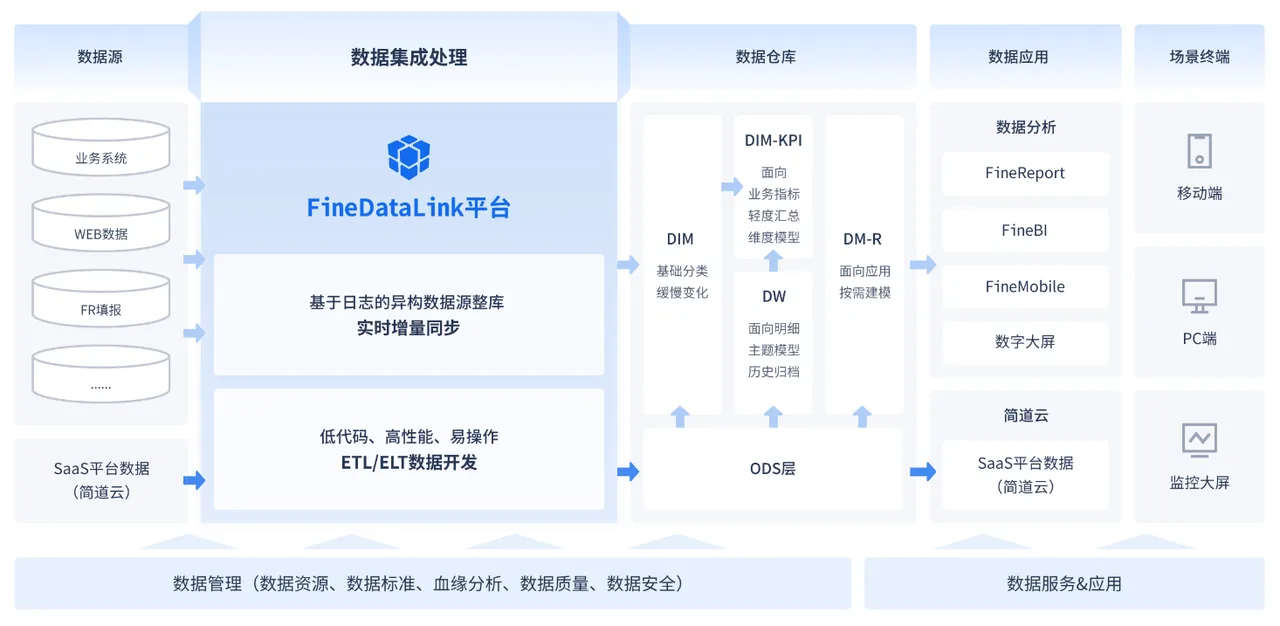
三、百种数据源,解决的不是连接问题
一款数据集成工具支持百种数据源,听起来很有吸引力。但「支持」这个词,不能只看连接器数量。能连上,只是第一步。
还要看连接之后能不能配置同步任务,能不能处理字段映射,能不能做增量采集,能不能控制数据写入策略,能不能在任务失败之后恢复。
否则,连接器再多,也只是一个数据源通讯录。真实的数据环境通常是混合的: 关系型数据库里有核心业务数据。大数据平台里有历史明细。NoSQL 数据库里有用户行为和日志。消息队列里有实时事件。文件和接口里还有一批无法绕开的外部数据。
数据团队需要的不是一款只会连接数据库的工具,而是一个能够把这些数据源统一纳入管理的集成平台。这件事看起来不够炫。但对于每天都在接系统的数据团队来说,统一入口本身就是效率。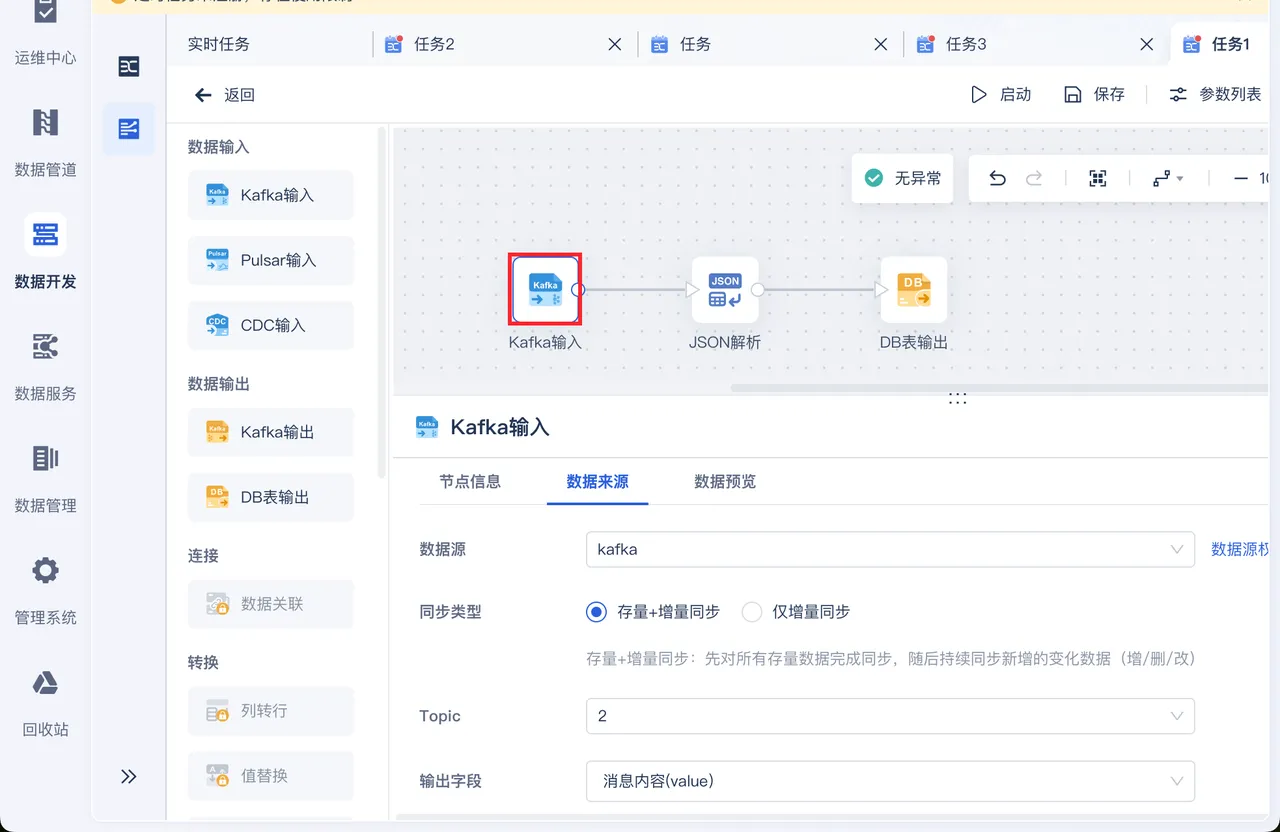
四、海量数据同步,最怕「一把梭」
数据量小的时候,全量同步很好用。每天晚上跑一次,把表全部读出来,再全部写进去。数据量上来之后,这种方式很快就会遇到问题。源库压力变大了。传输时间变长了。任务窗口被拉长了。一个任务失败,可能要从头再来。
更麻烦的是,业务系统不会因为你在同步数据就暂停更新。你刚把前 80% 的数据搬过去,源库又新增了一批订单。等你把剩下的 20% 搬完,前面的数据可能已经发生了变化。
所以海量数据同步,不能只看「一次能搬多少」。要看它有没有分层的同步策略:历史数据怎么做全量迁移,实时变化怎么做增量采集,任务中断怎么断点恢复,目标端写入冲突怎么处理。
历史数据先完成初始化,后续变化通过增量机制持续同步。这样做的意义,不是把全量任务跑得更快,而是避免每次都重复搬运那些没有变化的数据。数据量越大,这种差异越明显。海量同步的核心,不是蛮力更大,而是每一次只处理真正需要处理的数据。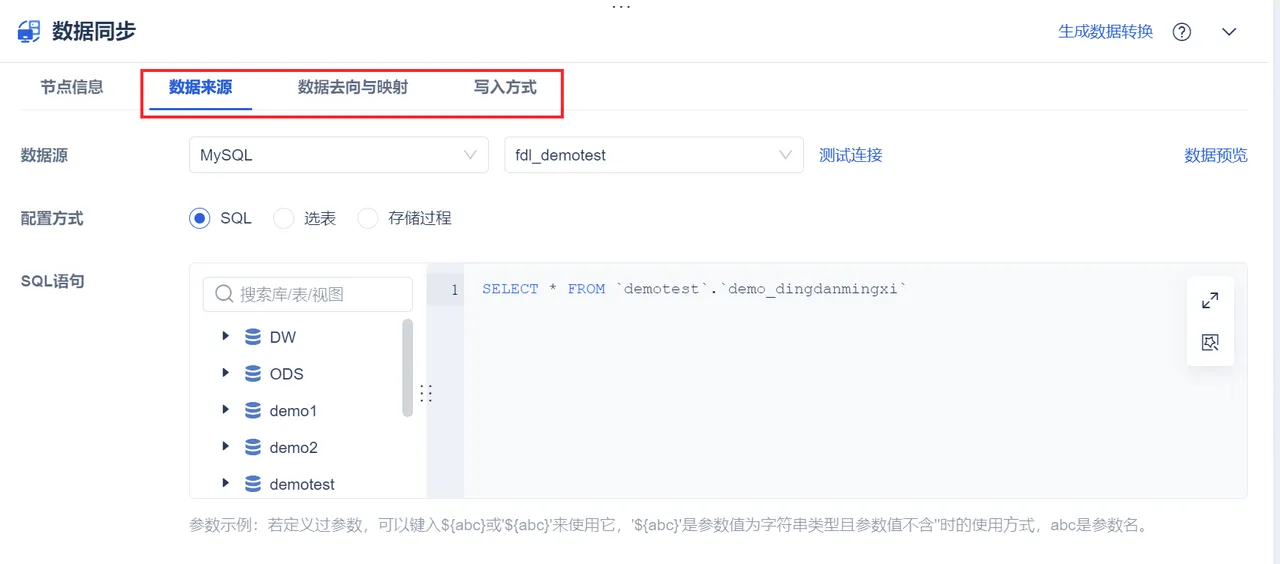
五、增量同步,才是 ETL 工具的分水岭
全量任务能不能跑,通常很容易判断。增量任务能不能长期稳定运行,才是真正的考验。 因为增量同步要回答一个问题:到底什么数据变了?
有些数据库可以读取变更日志。有些系统只能依靠更新时间字段。有些数据源没有标准的增量标记,只能通过主键、版本号或业务状态来判断。不同数据源的增量策略不一样,不能用一套逻辑硬套所有系统。
把全量同步、增量采集和任务调度放在同一个平台里,数据团队可以根据数据源的实际情况选择同步方式,而不是每接一个系统就重新开发一套方案。
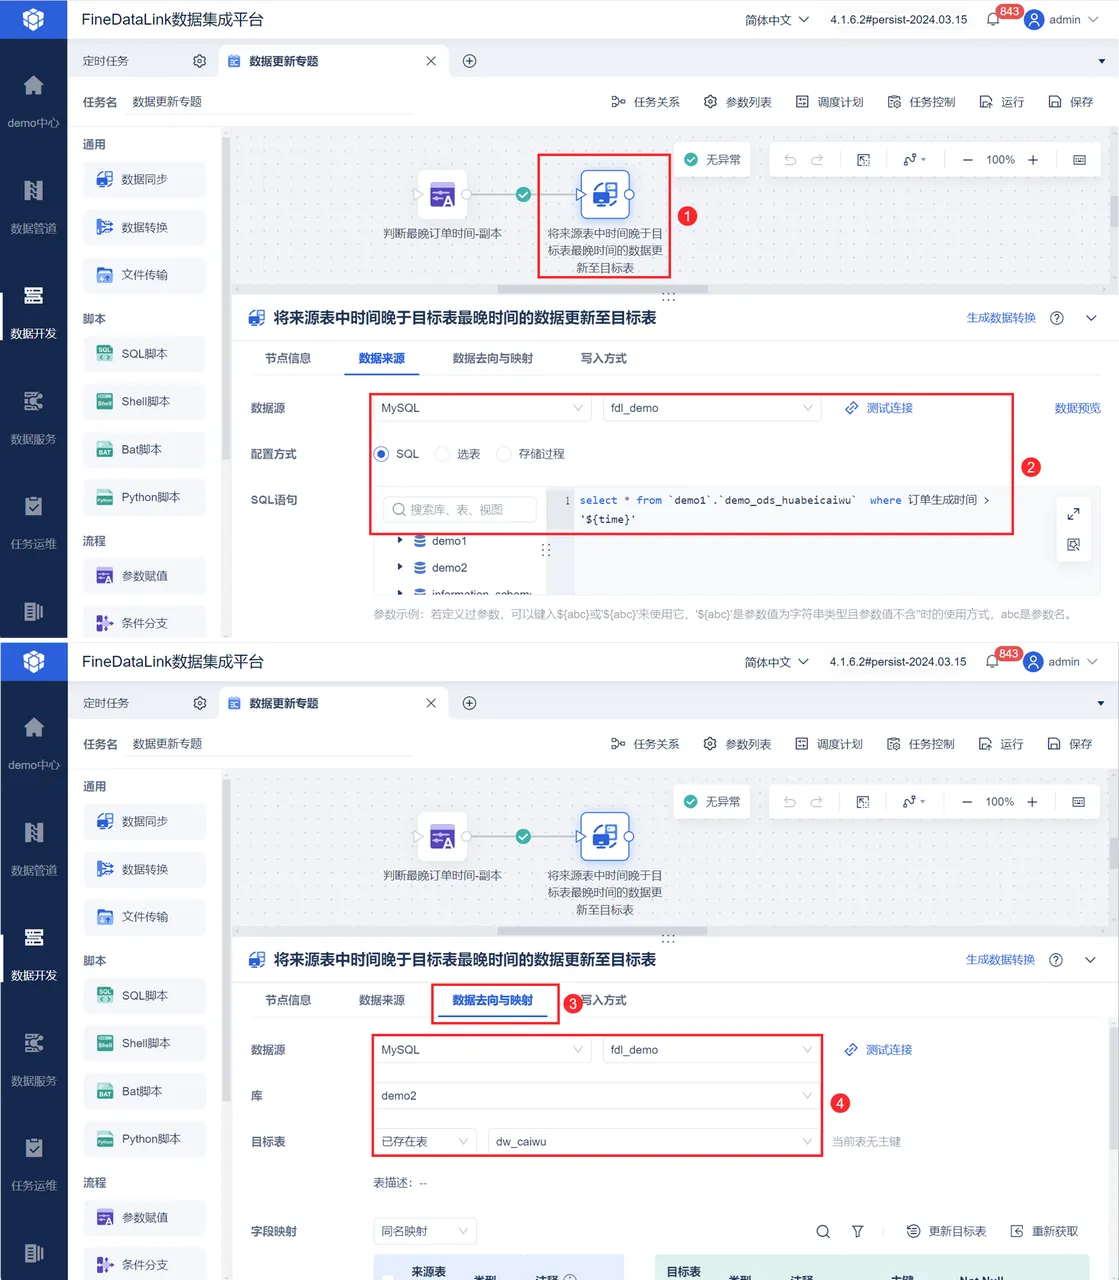
这对生产环境很重要。因为任务不是跑一次就结束了。它要每天跑,每小时跑,甚至每分钟跑。中途断过一次之后,还要能够从正确的位置继续。数据有重复或者遗漏,还要能够被发现。ETL 工具的价值,不是让任务成功一次,而是让任务在没人盯着的时候也能持续成功。
六、转换逻辑不能只藏在代码里
数据同步最容易被忽略的一部分,是 Transform——转换。源端字段和目标端字段不一致,需要映射。数据类型不同,需要转换。脏数据需要过滤。重复数据需要去重。多张表之间需要关联。业务规则发生变化,还要重新调整逻辑。
如果这些东西全部写在脚本里,短期看很灵活,长期看很难维护。新同事接手时,要先读几百行代码才能知道一个字段是怎么来的。业务方问「这个指标为什么变了」,数据团队要翻日志、找 SQL、查中间表,最后才能解释清楚。
可视化 ETL,解决的不是「让开发人员不用写一行代码」,而是让数据转换逻辑变得可见。字段怎么映射,条件怎么过滤,数据怎么清洗,目标端怎么写入,都可以在任务流程里被看到、被修改、被复用。
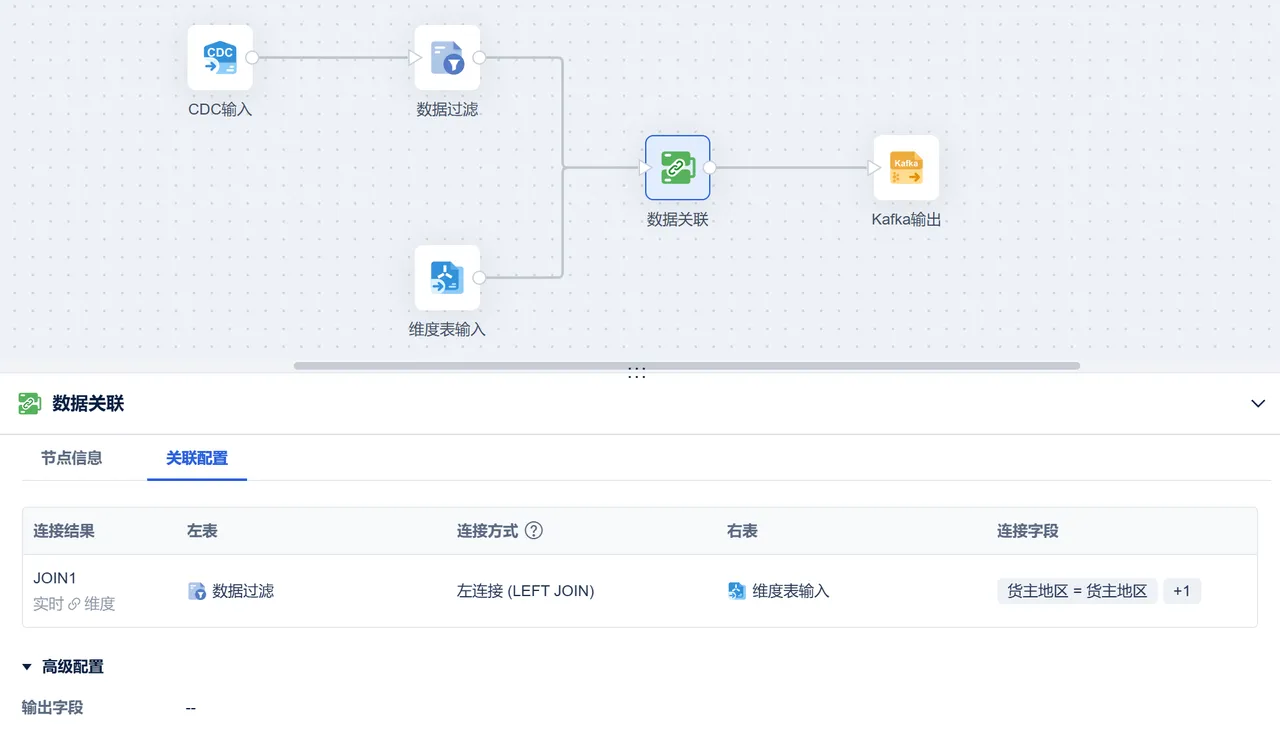
这比把逻辑藏在脚本里更适合团队协作。因为数据管道不是个人作品。它是整个数据体系的一部分,应该能够被理解、被审查,也应该能够被交接。
七、任务跑起来之后,才是运维的开始
很多 ETL 工具演示时都很好看。选两个数据源,拖几条连线,点击运行,数据很快就到了目标端。演示结束了。真正的工作才刚刚开始。
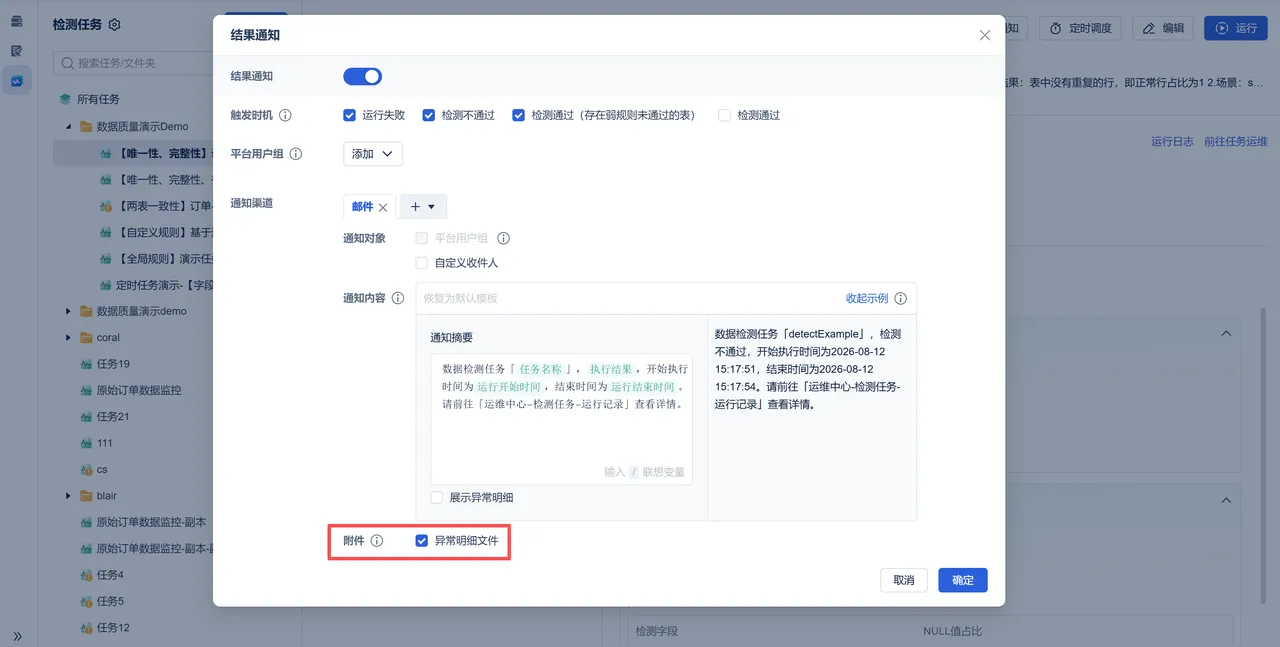
任务每天几点跑?上游任务没完成,下游能不能等待?失败之后重试几次?数据延迟超过阈值怎么办?某张表的数据量突然少了一半,谁能第一时间发现?
如果这些问题没有统一的答案,数据同步就只能靠人盯。人一旦不盯,问题迟早会发生。数据集成不是搭一条管道,而是长期运营一组管道。
八、别把「支持百种数据源」理解成万能
当然,数据源数量多,不等于所有场景都能直接拿来用。特殊数据库、复杂接口、定制化协议,仍然可能需要额外适配。海量数据同步,也不等于不需要做数据分层、网络规划和资源配置。
ETL 工具能解决集成效率和任务管理问题,但不能替代数据治理、指标设计和架构规划。 这也是选型时需要保持清醒的地方。不要因为一款工具连接器很多,就把所有数据问题都交给它。先确认自己的数据源、数据量、同步频率、实时性要求和安全边界,再决定工具怎么落地。
数据源开始变多,脚本开始失控,实时同步和增量采集变得必要,团队也需要一套统一的任务管理方式。如果只是每天同步一张几万行的小表,一个定时 SQL 可能就够了。工具不是越重越好。是要和问题的复杂度匹配。
九、结语:ETL 工具真正要替代的,不是人
很多数据工程师听到「可视化 ETL」「百种数据源」「自动化同步」,第一反应是:那以后还需要开发人员吗?需要。只是开发人员不应该把时间耗在重复写连接、重复写字段映射、重复补失败重试逻辑上。
数据团队真正应该花时间解决的,是数据标准、数据质量、业务口径、架构设计和异常分析。 过去,数据集成靠的是个人经验。谁熟悉哪个数据库,谁就负责接入。谁写过那段脚本,谁就成了唯一的维护人。以后,数据集成更应该靠平台和流程。
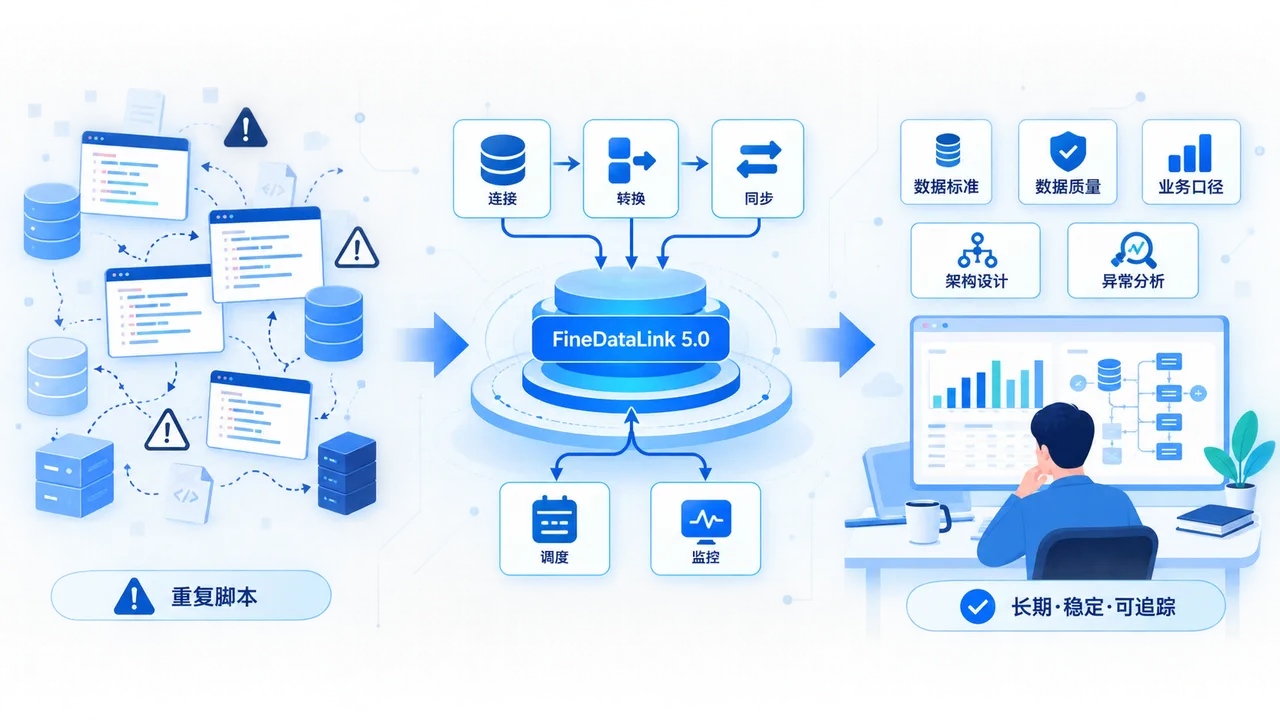
让数据源可以被统一接入,让转换逻辑可以被复用,让同步任务可以被监控,让出了问题之后的人,能够知道问题发生在哪里。
ETL 工具真正替代的,不是数据工程师,而是那些没人愿意维护、却每天都在消耗团队时间的重复劳动。如果你的团队正被大量异构数据源和同步任务拖住,先别问它能不能连接百种数据源。先问一个更重要的问题:接入之后,这些数据能不能长期、稳定、可追踪地流起来。

