每周完成一个 ARTS: 至少做一个 leetcode 的算法题、阅读并点评至少一篇英文技术文章、学习至少一个技术技巧、分享一篇有观点和思考的技术文章。(也就是 Algorithm、Review、Tips、Share 简称 ARTS)
Algorithm
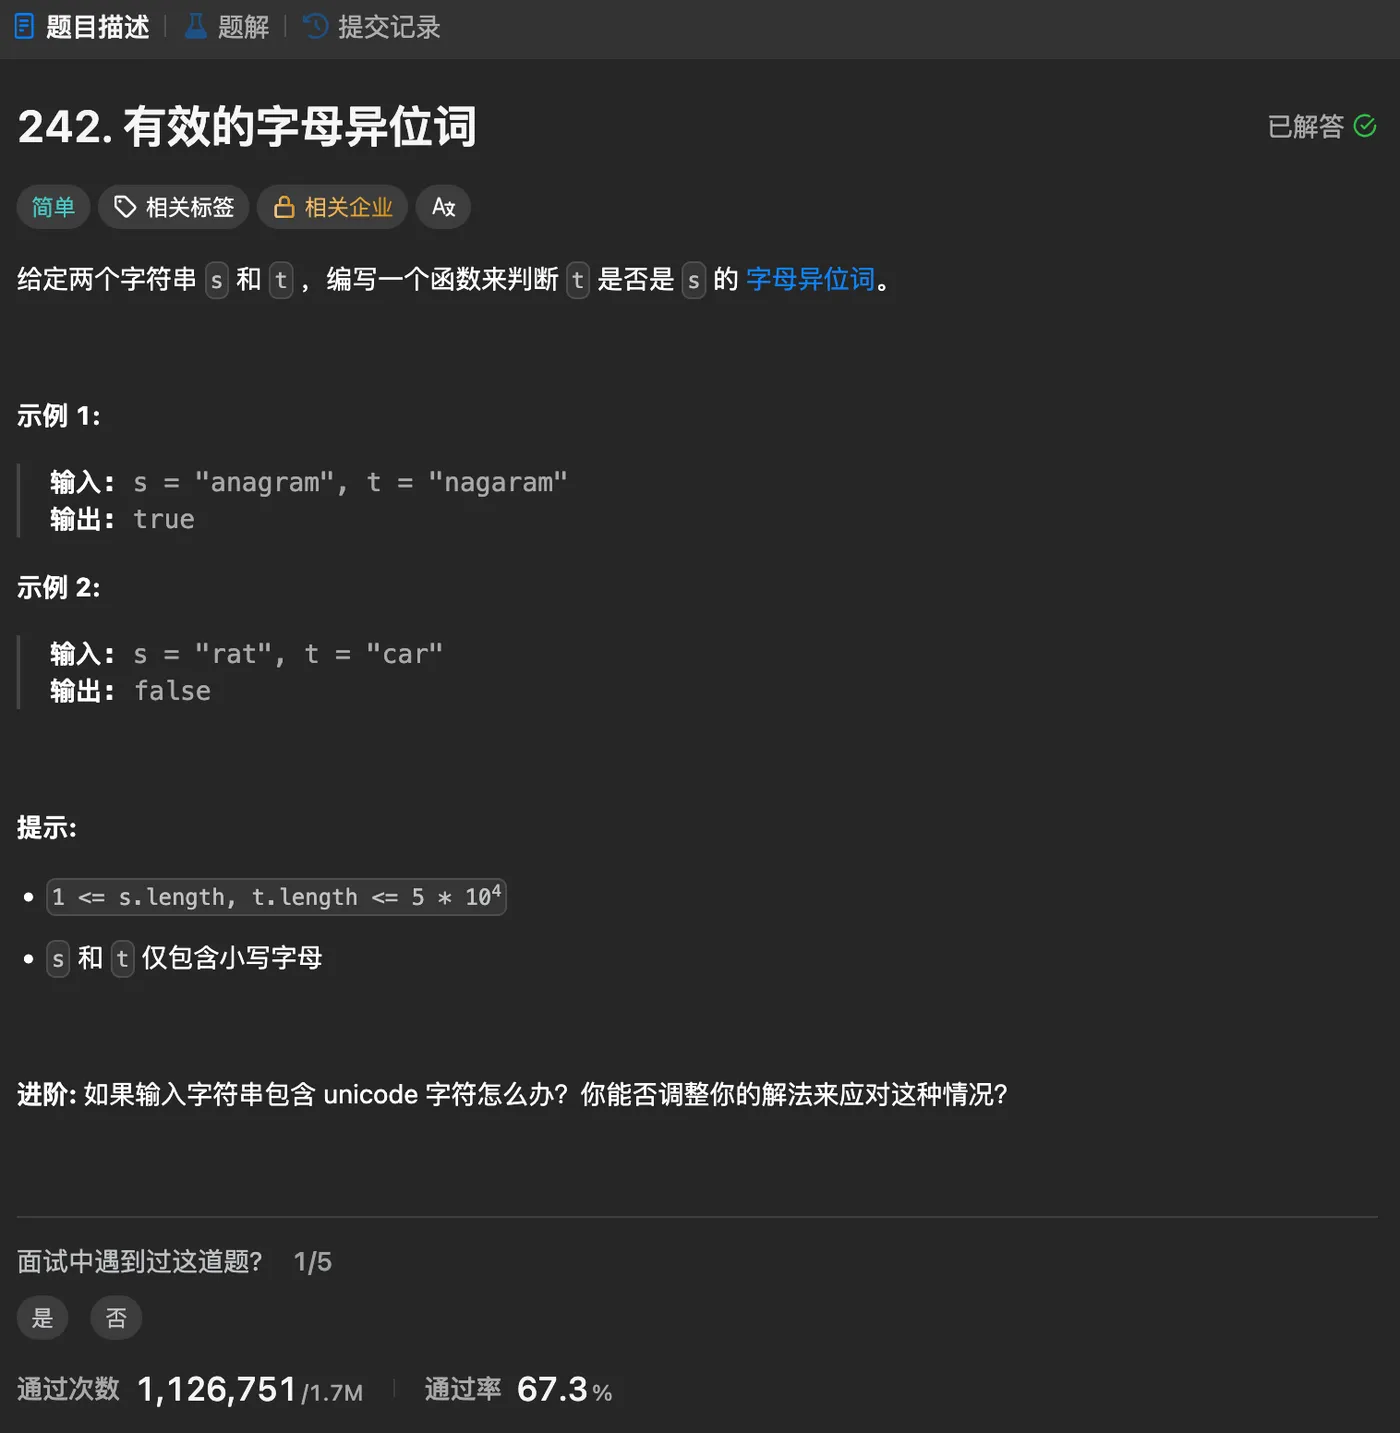
这道题目相对简单一些:
1、可以通过转化成 map,对应的 map 对应的 char 出现了几次。这样方便比较某一个字母出现的次数
2、在设置值的时候可以用 Map 的 merge 方法,这个第三个参数 (t,u) ,这个 t 是 map 里面原来的值,这个 u 是 merge 方法后第二个参数的值。
class Solution {

    public boolean isAnagram(String s, String t) {

        HashMap<Character, Integer> sMap = toMap(s);
        HashMap<Character, Integer> tMap = toMap(t);
        if (sMap.size() != tMap.size()) {

            return false;
        }
        for (Map.Entry<Character, Integer> entry : sMap.entrySet()) {

            Character key = entry.getKey();
            if (!Objects.equals(tMap.get(key), entry.getValue())) {

                return false;
            }
        }
        return true;
    }

    private HashMap<Character, Integer> toMap(String s) {

        HashMap<Character, Integer> map = new HashMap<>();
        for (Character c : s.toCharArray()) {

          map.merge(c, 1, (t, u) -> t + 1);
        }
        return map;
    }
}
Review
文章:How the Claude Code team does code review
Anthropic 分享了 Claude Code 团队的代码审查流程。随着 AI 生成的代码越来越多,人工逐行审查开始跟不上。他们把更多常规检查交给 AI,同时关注回滚和事故有没有增加:如果省下来的审查时间,最后都花在了修 Bug 上,那就没有真正提高效率。
结合网友的评论,分享一下:
1、提交 PR 前,先让 Agent 跑测试、构建或检查页面,拿出实际结果,再用全新上下文的 Agent 检查 diff。项目约定放在 CLAUDE.md,审查重点放在 REVIEW.md,发现问题要指出文件和行号。
不过,把更多代码交给 AI 审查之后,人通过什么方式了解代码,也需要考虑。评论里有人担心团队越来越依赖 AI 的解释,也有人认为,大型项目本来就没人掌握所有细节,按需生成模块说明和图示很有用。我感觉,可以让 AI 帮忙梳理,但涉及自己负责的改动,还是要沿着具体输入和执行路径走一遍,知道测试覆盖了什么、还漏了什么。
2、人工审查按风险分配。符合条件的可信作者提交低风险改动,可以在自动检查通过后合并;风险更高的改动需要一到两人批准,AI 的批准不能代替这里要求的人类批准。发起改动的人仍然要对结果负责。
这里有条评论很值得留意:AI 可能不断新增实现,却没有复用已有逻辑。每个 PR 单独看都能工作,等公共需求变化时,才发现多个地方都要修改。我觉得这也是人需要参与判断的地方。比如新增缓存,除了看读写是否正确,还要看看项目里有没有类似机制,是否值得再维护一套。局部功能做对了,仍然可能给整个项目增加维护负担。
3、审查的轮数也要控制。他们遇到过 Agent 一夜互相审查、修改超过 50 轮的情况,后来增加轮数限制,几轮之后只看新增 diff,并且不重复报告已经提出的问题。
这也对应了评论里对成本的提醒:有读者把这类经验比作 Google 的基础设施文章,模型公司的资源条件和普通团队不同,多 Agent、多轮审查不能直接照搬。对自己的项目来说,我会更关心每轮究竟发现了什么,以及这些问题是否值得再改一遍。反复修改却没有明确收益,就应该停下来重新看方案。
4、审查工具本身也需要验证。他们把历史事故和回滚整理成评测集,检查 reviewer 能否发现已知问题,同时用没有已知问题的 PR 检查误报,上线后还有灰度和快速回滚。
Tips
1、一个任务重复了几次之后,可以有意思的让 AI 帮忙整合成 skills。
2、代码中的一些 AI 看来「不合理」的架构或者其他问题,如果不想修改的话尽量自己单独写一下,防止 AI 每一次都想「反向优化」。
Share
Linus 反对用「某件事不准使用 AI」来规定开发方式,同时强调:贡献者要尽力做好工作,并且理解自己在做什么。
他的反问很有意思:如果一定要靠不用工具证明能力,那是不是也该禁止编译器,要求大家手写汇编?是不是连编辑器也不能用,免得退格键掩盖了打字错误?他借这个类比说明,使用什么工具,并不能直接说明一个人是否理解自己的工作。
我的理解是,这个观点落到 vibe coding 上,关键就在「理解」两个字。让 AI 帮忙实现一个想法之后,自己还得知道它为什么这样实现、在哪些条件下成立,以及哪里可能出问题。仅凭「页面能打开」「测试全绿」,还不足以回答这些问题。
比如让 AI 写一个文件清理脚本,最容易验证的是它能不能删掉目标文件。但我还会关心:路径为空怎么办,匹配范围会不会扩大,遇到符号链接怎么处理?这些问题如果自己都没想过,就很难判断 AI 给出的实现是否符合真正的需求。
放到前面的 code review 话题里也是一样。AI 可以帮忙解释陌生模块、寻找问题、补充验证,但我需要知道这些检查覆盖到了哪里。尤其是自己不熟悉的代码,应该把改动拆小,沿着输入到输出的过程看明白,再决定是否接受。
可以把更多编写工作交给 AI,理解和判断仍然需要自己参与。 这样节省下来的时间,才有机会用来想清楚需求和实现,而不是等出问题之后再从头认识自己的代码。