
AI算力集群快速落地,企业往往更关注模型、推理和业务应用的安全。但近期 NVIDIA DCGM Exporter 披露的安全问题提醒企业:AI基础设施的风险入口,不一定只在业务侧,也可能藏在一个看似普通的运维监控接口里。
公开研究数据显示,约2100台 DCGM Exporter 主机曾无需认证即可对外提供监控指标,涉及近300家机构和超过12000个GPU标识。相关问题可能导致监控服务资源被大量占用甚至停止响应;在资源隔离不足的情况下,还可能影响同一环境中的AI任务运行。
1、“只是监控接口”,为什么也值得重视?
DCGM Exporter主要用于采集GPU温度、功耗、显存、负载和运行状态等信息。对运维人员来说,它只是一个监控组件,但如果这类接口直接暴露在公网,就可能让外部获取GPU型号、硬件标识、运行状态、资源使用情况以及部分工作负载信息。
所以真正值得企业思考的,不只是“这个监控工具安全吗”,而是:一个内部运维接口,为什么能够被公网直接访问?
2、AI基础设施,也有自己的“管理面”
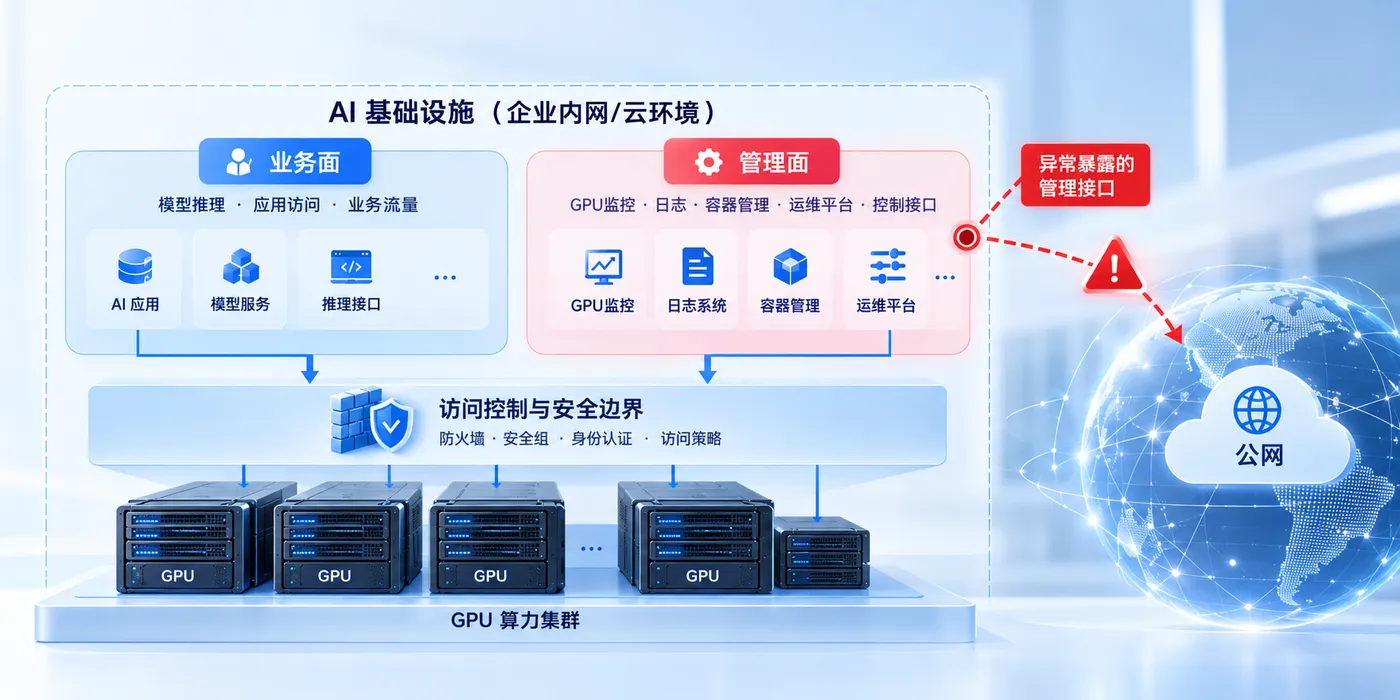
可以简单把AI基础设施分成两个部分:业务面负责模型推理、应用访问和业务流量;管理面则包括GPU监控、日志、容器管理、模型管理、运维平台及相关控制接口。
这些系统不一定直接承载业务,却掌握大量基础设施运行信息,部分系统还具备较高管理权限。随着AI基础设施不断扩张,管理接口也在持续增加。如果这些接口缺少身份校验、访问限制,或者长期直接暴露在公网,就可能形成新的风险入口。
业务系统需要安全边界,管理系统同样需要。
3、真正需要检查的,不只是补丁有没有升级
针对此次问题,NVIDIA已经提供修复版本,并建议关闭非必要的性能分析接口。升级版本当然重要,但对企业来说,更值得追问的是:为什么一个内部监控服务,会出现在公网?
如果只修复单个组件,却没有重新检查公网暴露面和访问边界,类似问题仍可能出现在其他管理组件上。企业可以重点核查哪些管理端口正在对外开放、哪些服务真正需要公网访问,以及防火墙、安全组和访问策略是否真正生效。
减少不必要的公网暴露,是降低同类风险的重要基础。
4、AI基础设施要从“能运行”走向“可管理”
GPU集群、容器环境和AI平台可能分布在不同机房、云平台和业务环境中。企业不能只关注算力是否正常,还需要知道资源在哪里、哪些接口对外开放、谁可以访问。
否则就可能出现一种情况:业务正常运行,管理接口却已经暴露在公网。
因此,AI基础设施建设不能只考虑算力和性能,管理面同样需要明确访问边界。
写在后面
这次事件提醒企业,AI基础设施的安全不只在模型和业务侧,监控、日志、运维等管理接口,同样需要被纳入安全边界。
企业不妨先检查三个问题:有哪些管理接口正在对外开放?这些接口真的需要公网访问吗?访问策略是否真正生效?
AI基础设施不仅要跑得起来,更要边界清楚、管理可控。

