
今天学习第二章 ·上下文工程
实验2-1是上下文工程,本期目标是:先安装统一 ch2 环境 → 启动 Ollama → 普通对话测试 → 提天气请求,观察完整工具调用链路(流式输出)
准备工作要做:step1:安装 Homebrew、再装 ollama
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"
安装结束后,一定要执行下面两行,把 brew 加到环境变量(M 系列 Mac 必做),确认好我们的环境有没有get ready。
echo 'eval "$(/opt/homebrew/bin/brew shellenv)"' >> ~/.zshrc
source ~/.zshrc
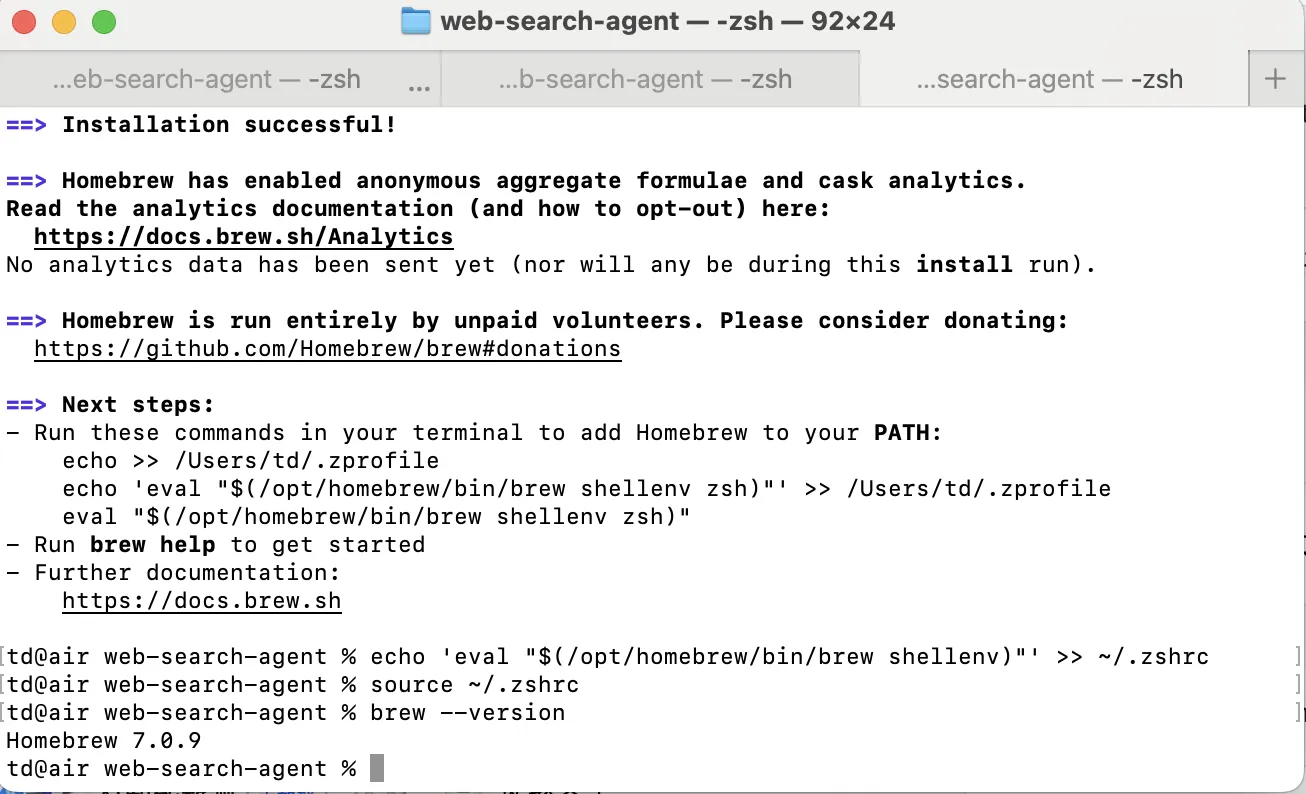
step2:验证我们已经安装好honebrew之后就可以执行下面这个命令,新开一个终端窗口安装ollama还有python的sgk包
brew install ollama
python3 -m pip install ollama #python代码import ollama用的库
step3:到这步之后你就可以打开你的第三个终端窗口,一个是Ollama 后台服务(这是常驻服务不要关掉),第二个是我们之前下载 ollama/pull 模型的终端,第三个就是安装我们试验要用的依赖环境,mac需要提前安装好homebrew
在仓库根目录 ai-agent-book里一次性安装第二章全部依赖,创建.venv
python3 -m pip install -e ".[ch2]"
安装好上述环境之后,就可以运行我们的试验
python3 -m pip install -r requirements.txt
python3 main.py --backend ollama
就顺利连上我们的Qwen拉!!!但是还没完,api调用告诉我模型能力不足,那么我们就升级!!!
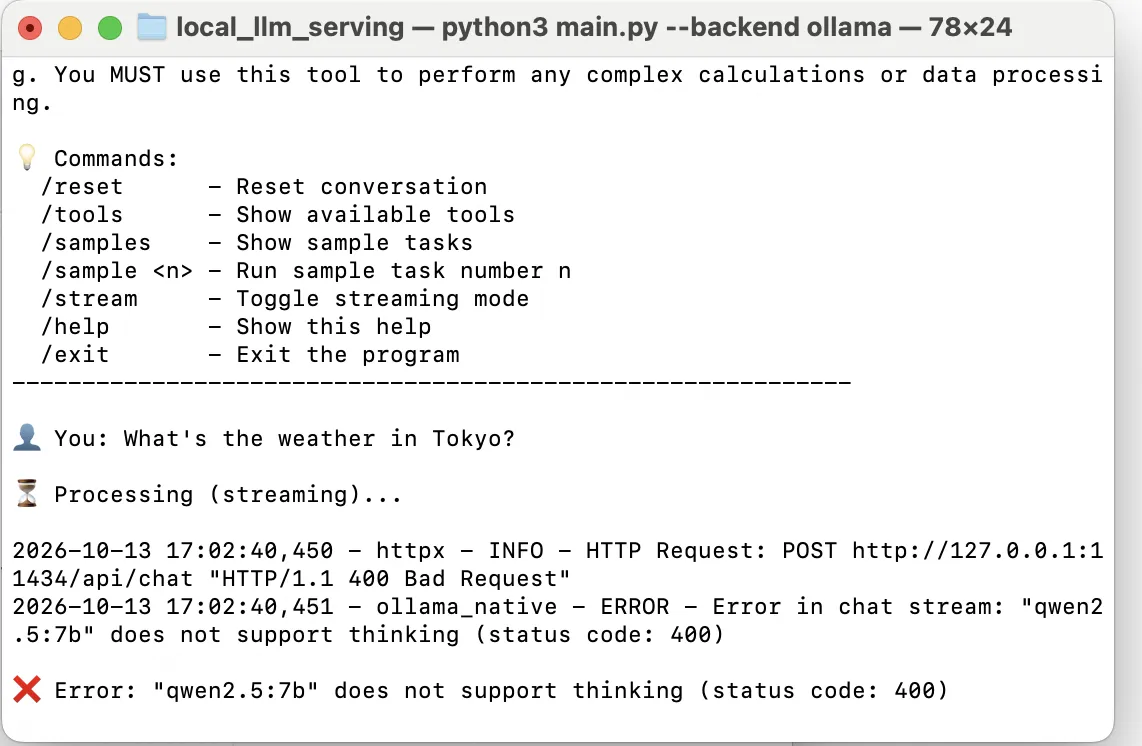
吧模型拉到可以支持thinking的地步(运行到这步对ollama有了比较切实的认识)
ollama pull qwen3:0.6b
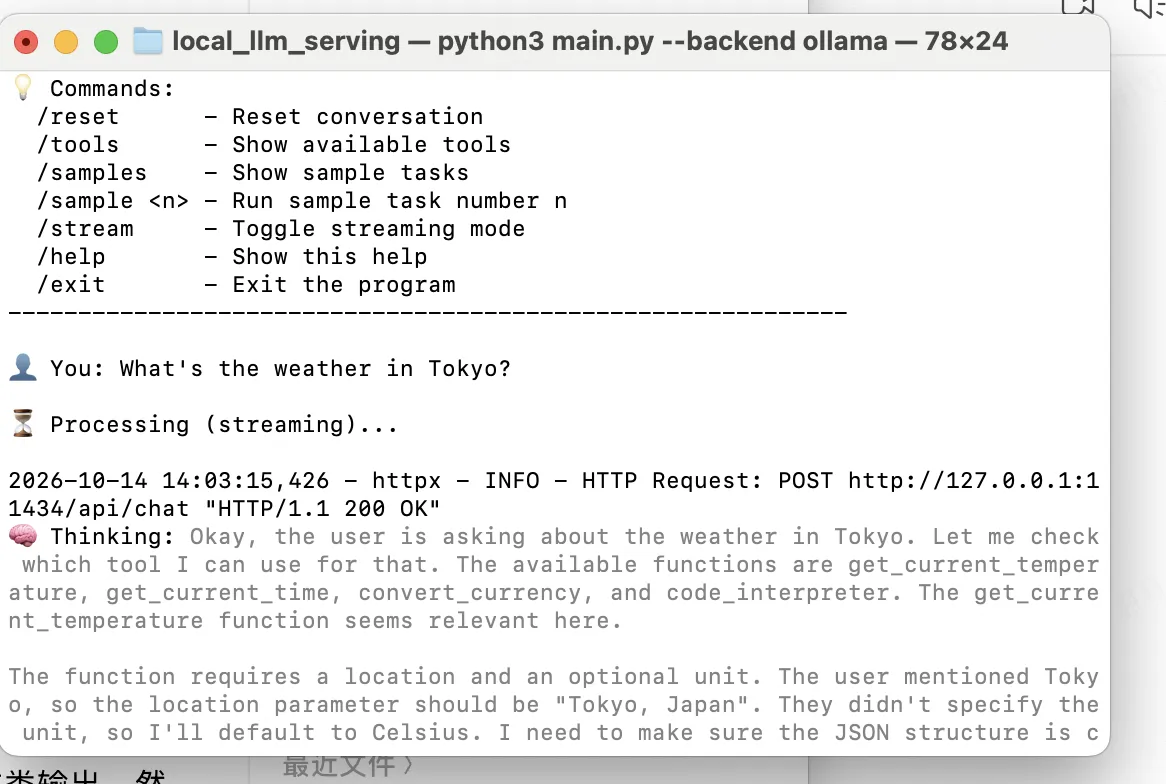
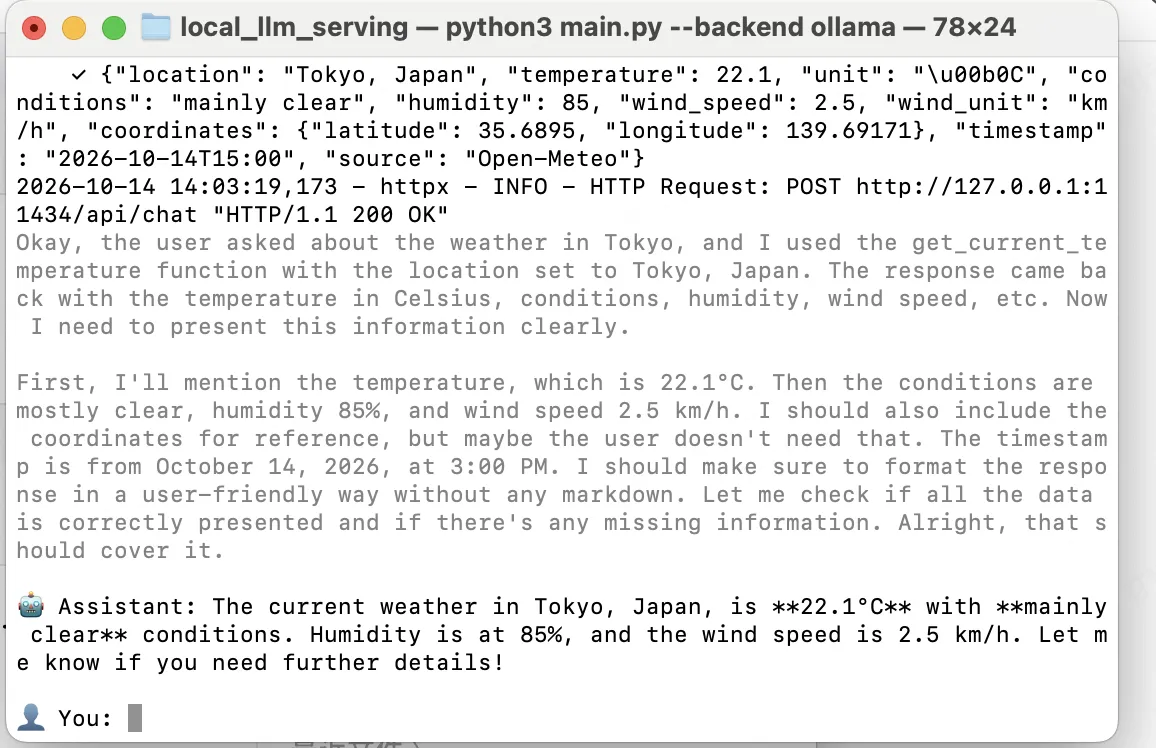
对话实验成功!!!
实验2-2是注意力机制可视化
首先进入到我们的【attention_visualization】目录里
cd chapter2/attention_visualization
注,这里咋们就不用跟着网页里的环境搭建再跑一遍全部命令了,我就是重跑了一遍吧所有环境依赖包都清空了(因为当时跑2-2实验我有做强制退出的动作),所以咋们就直接进去目录,运行代码就可以了
其次,我们要用transformers 库从 HuggingFace 下载模型,可以选择在国内镜像下载 Qwen3-0.6B 模型
这里又学到一个新名词【HuggingFace(简称 HF)】,他是全球最大的开源 AI 模型托管平台,相当于 "AI 界的 GitHub"。我们的试验要跑本地代码所以得用HF吧模型文件取下来
echo 'export HF_ENDPOINT=https://hf-mirror.com' >> ~/.zshrc
source ~/.zshrc
随后就可以跑可视化代码了
python3 attention_cli.py
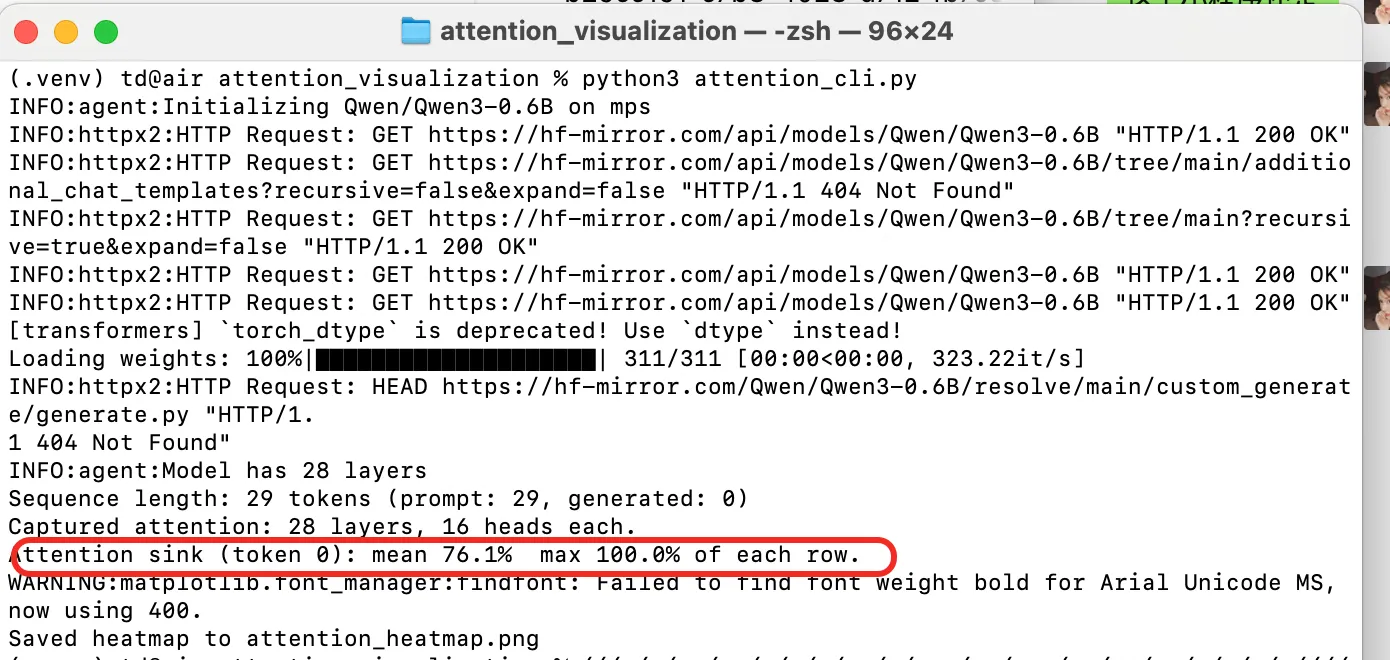
到这一步,咋们又刷新了一个新的名词【attention sink】,他的概念就是LLM 会无意识地把大量注意力 "倾倒" 到句子第一个 token 上,作为信息 "缓冲锚点"。之后用代码跑出来的可视化图片就会保存在当前目录的【attention_heatmap.png 】,下图就是大模型底层 Transformer 的可视化
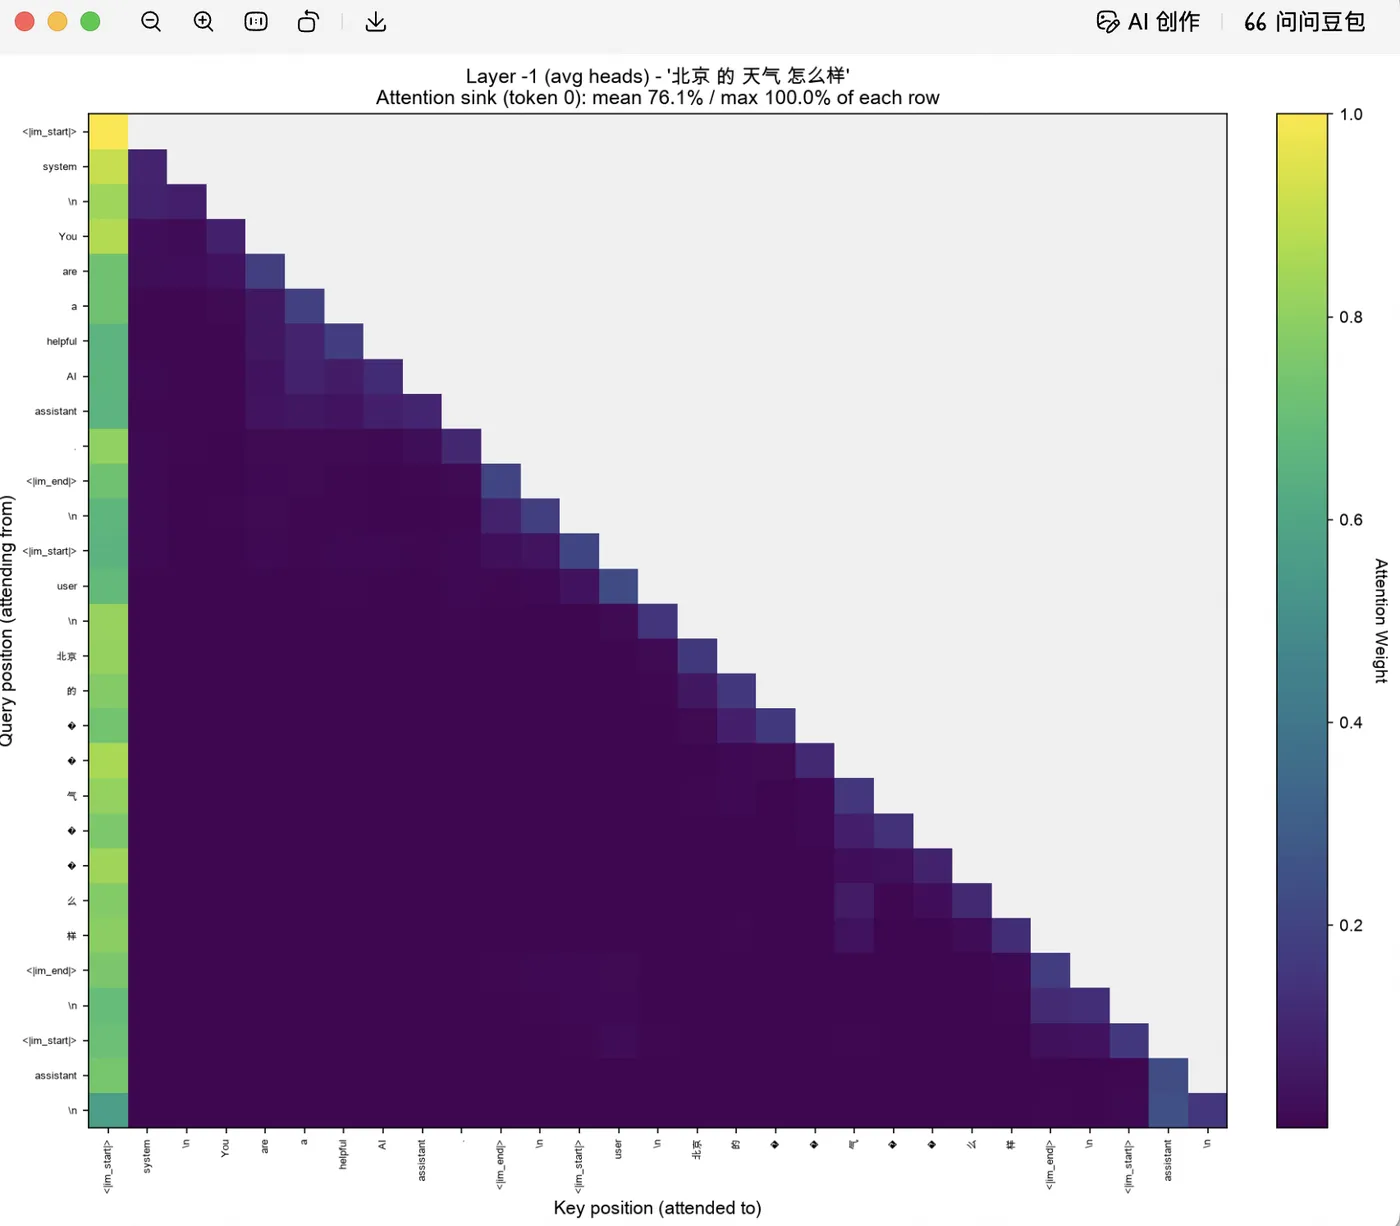
分析热力图:1)y轴的含义是发出注意力的 Token,每一行=一个token。x轴的含义是被关注的token,每一列=一个token,这一列代表:这个位置被前面哪些 token 关注 2)图片左上叫是<|im_start|>标记,这就是 Attention Sink。模型会强制保留一部分注意力在序列最起始的占位 token 上,当作一个 “信息锚点”,方便后续长文本的信息回溯,哪怕这个标记本身没有业务语义。也代表颜色亮的区域我们应该着重去关注 3)顺着对角线能看到一个由上到下蓝色的斜线图标,这部分的含义就是,每个token会更关注与他前面邻近的token3)左半边的深紫色三角形的含义是注意力权重≈0,也就是代表这两个 token 之间几乎没有关联,模型推理时完全不看。
补充说明:Attention Sink是什么?模型在预训练过程中学到:把多余、无处安放的注意力,全部丢给第 0 号 token 是最安全的选择,不会干扰语义计算。于是就形成了 sink。
那他的作用是什么?1)模型内部:稳定表示,防止信息过度混杂,避免因为数据噪点出现模型混乱的问题 2)工程推理层面:长上下文、KV 缓存优化。大模型推理会保存 KV Cache(每一个 token 的 K、V 向量),上下文越长内存占用越大。
有了初步能看懂图片的能力之后,我们继续往下走
python3 attention_cli.py --prompt "哈密 的 天气 怎么样" --layer 0 --head 3 --output layer0_head3.png
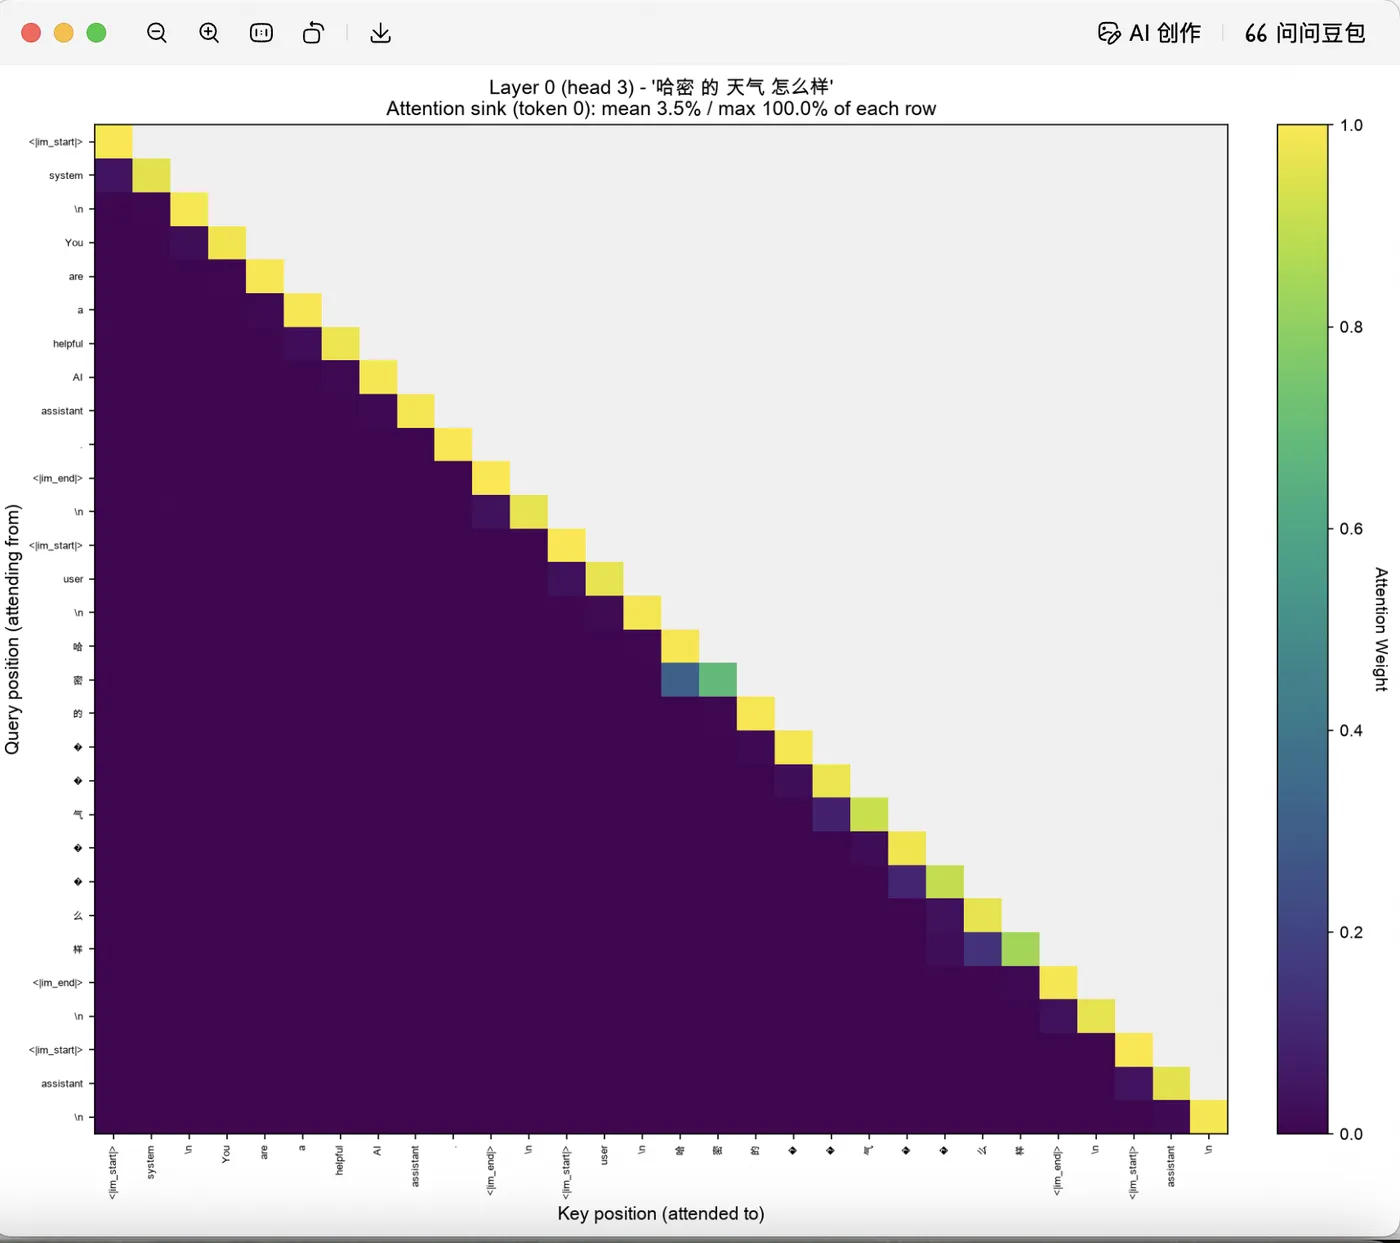
这张图可以明显的看到sink几乎消失,仅占3.5%。因为我们这次的代码写的是【layer0 head3】,这个头本职任务就是跟踪相邻词语、语序,它天生几乎不会把注意力分配给开头的<|im_start|>符号。写第一张图的代码他的含义就是不管我们些什么问题,llm的注意力都是会放在第一行的符号上,第二章图片的代码他的含义就是llm的注意力都会放在前一个词上面--head x 他的意思就是看某一个单独prompt的行为。

