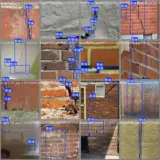
基于 YOLO11 的城市共享单车视觉识别与盘点系统
把"地铁口、商圈门口究竟堆了多少辆共享单车"这件事,从靠人去数变成靠摄像头一键统计。
一、背景
1.1 行业痛点
共享单车经过几年野蛮扩张,已经成为城市治理的高频议题。地铁口、商圈、写字楼、园区门口大片乱停乱放、占用人行道;运维公司又因为缺乏精准的"在街车辆数"而无法做精细化调度。靠城管/物业人工拍照、人工数车,成本高、周期长、口径还不统一。
而 目标检测 + 摄像头巡检 是这个问题的天然解:路侧抓拍 相机 、地铁口高点相机、巡查车移动终端只要把画面投给一个推理服务,就能稳定输出"画面里几辆单车、置信度多高、坐标在哪儿"这样一份结构化结果,下游入栏率核算、违停告警、调度地图都能直接消费。
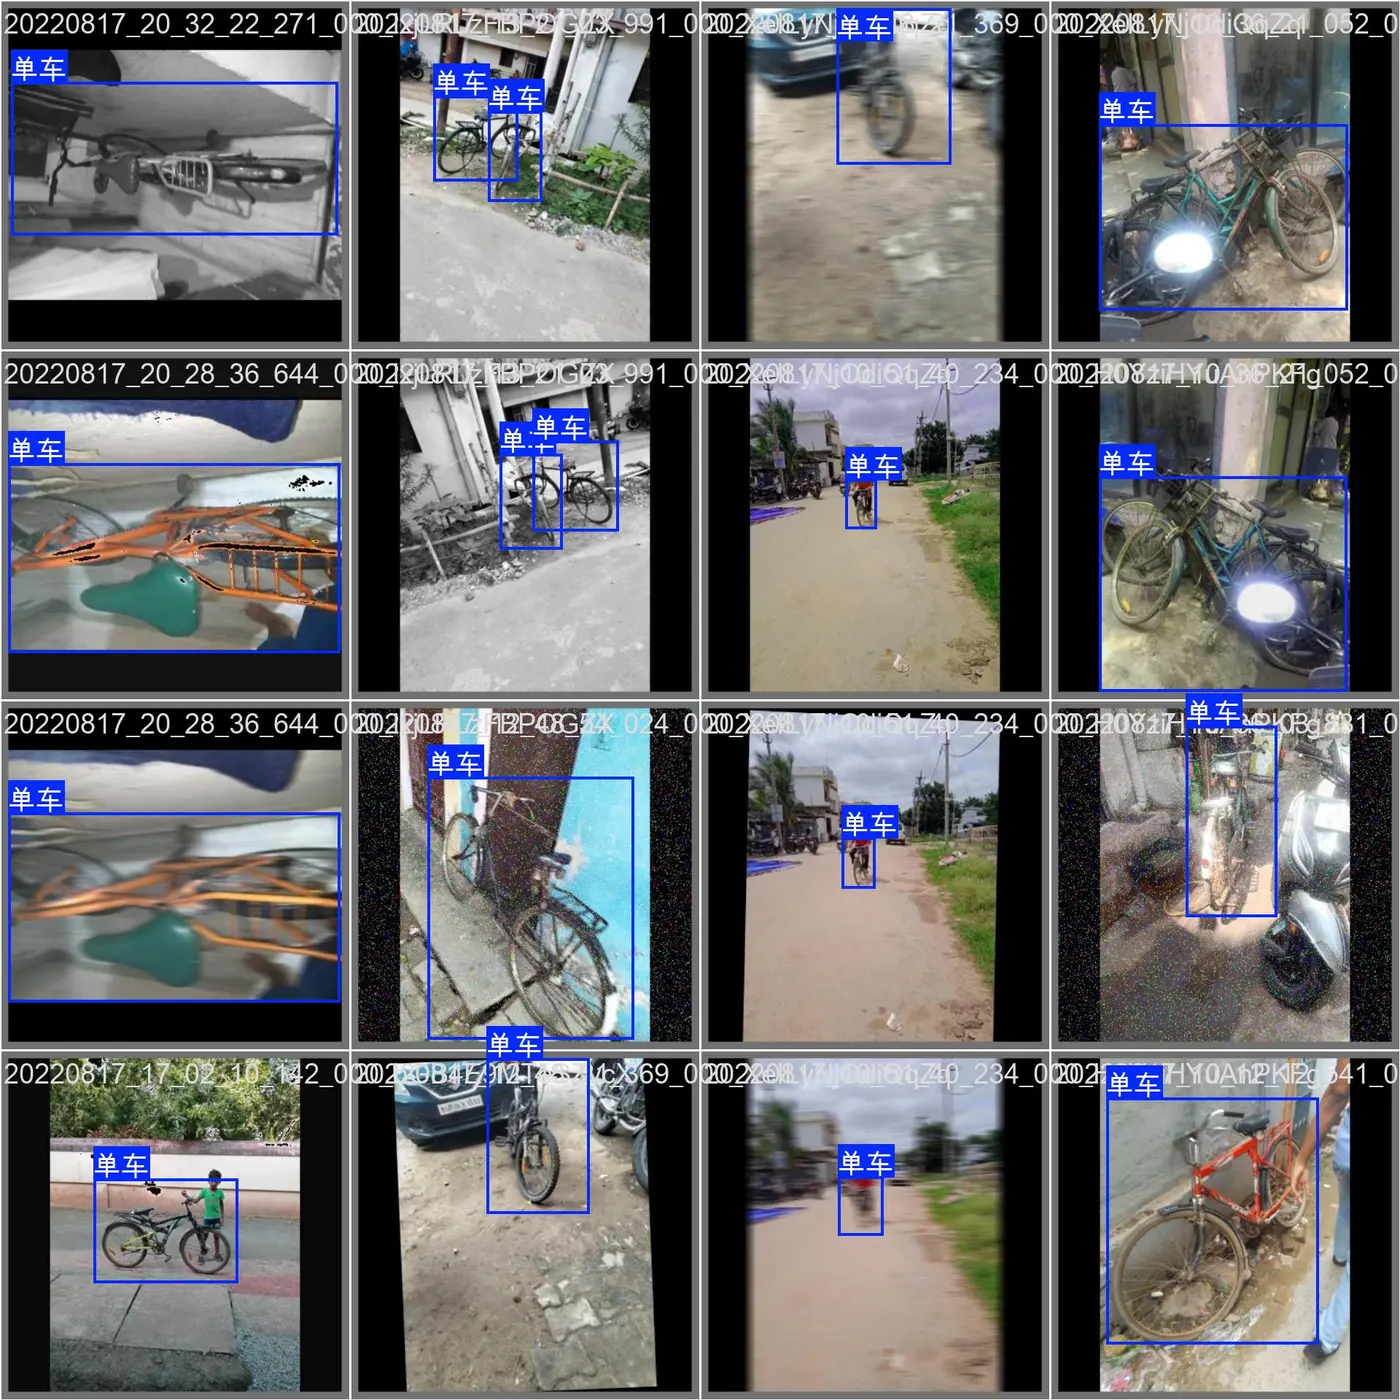
本项目就是围绕这个目标做的一套最小可用工程化样例:基于 YOLO11n + Streamlit,可单图、批量、视频、 摄像头 四路输入,专门识别共享单车这一类目标,并给出可直接复用的可视化与统计前端。
视频演示与源码下载
https://www.bilibili.com/video/BV1XzVf6oE63/
包含: 📦完整项目源码 📦 预训练 模型权重
🗂️数据集
1.2 项目运行效果
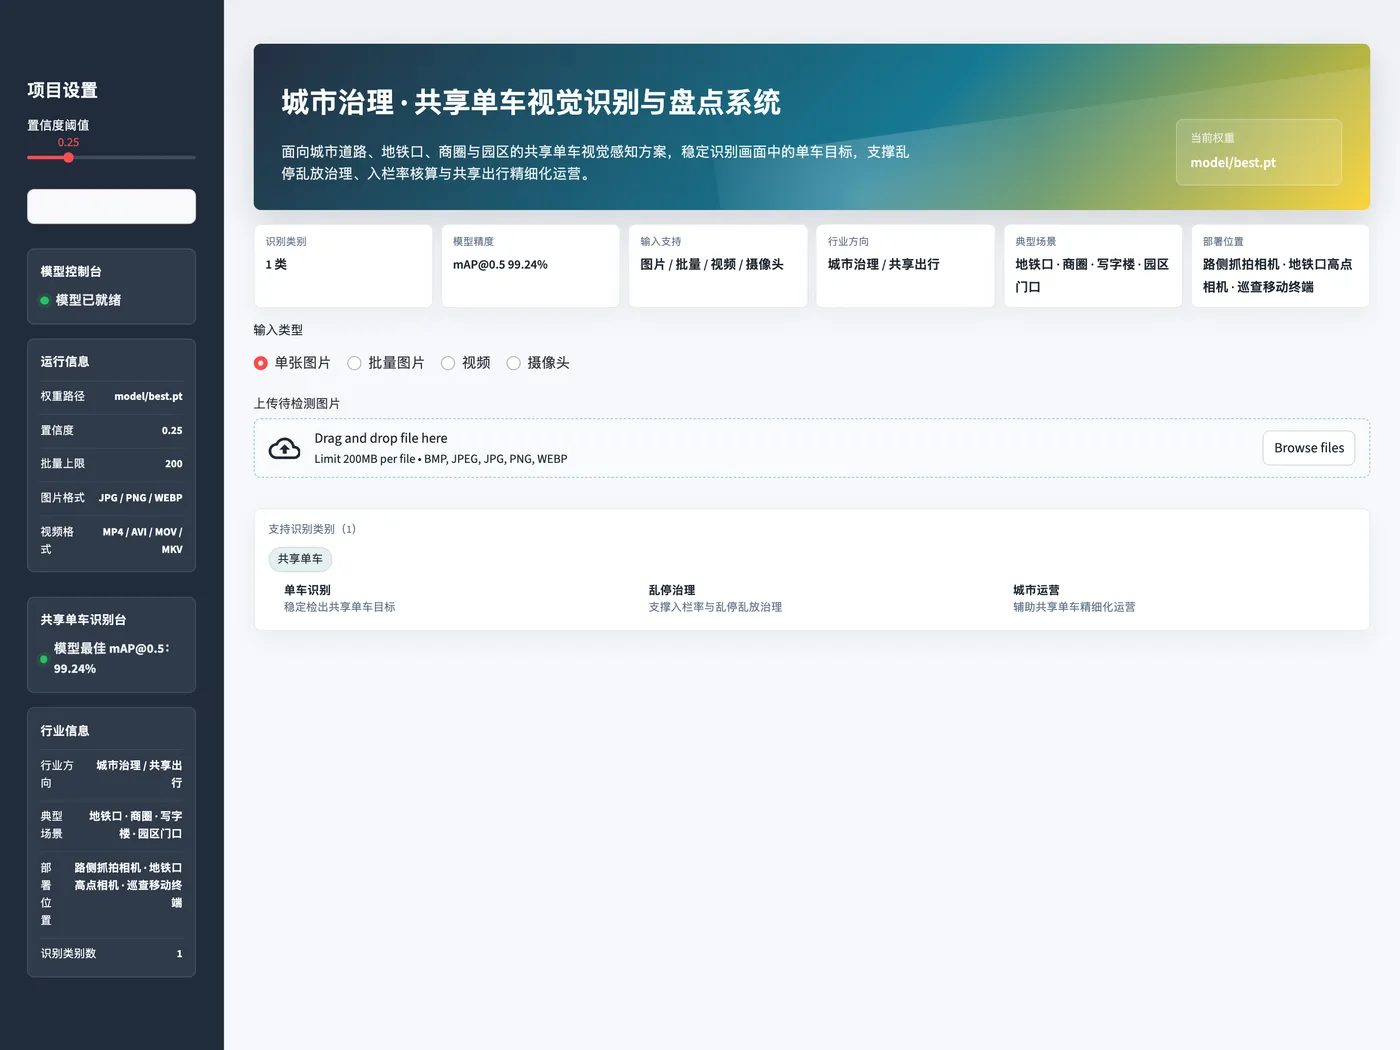
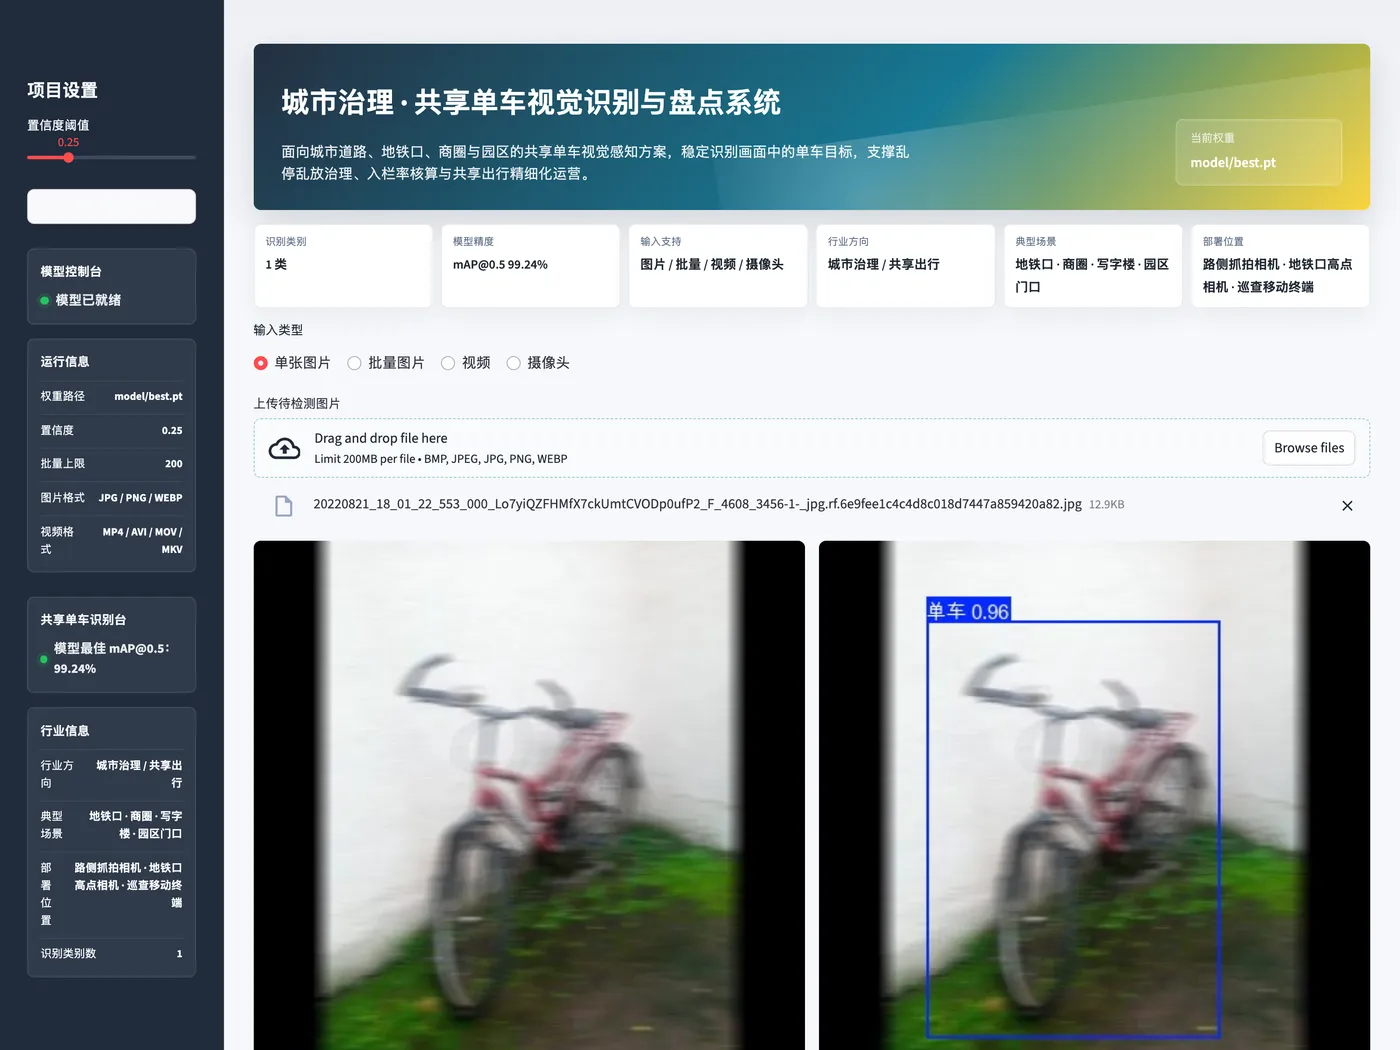
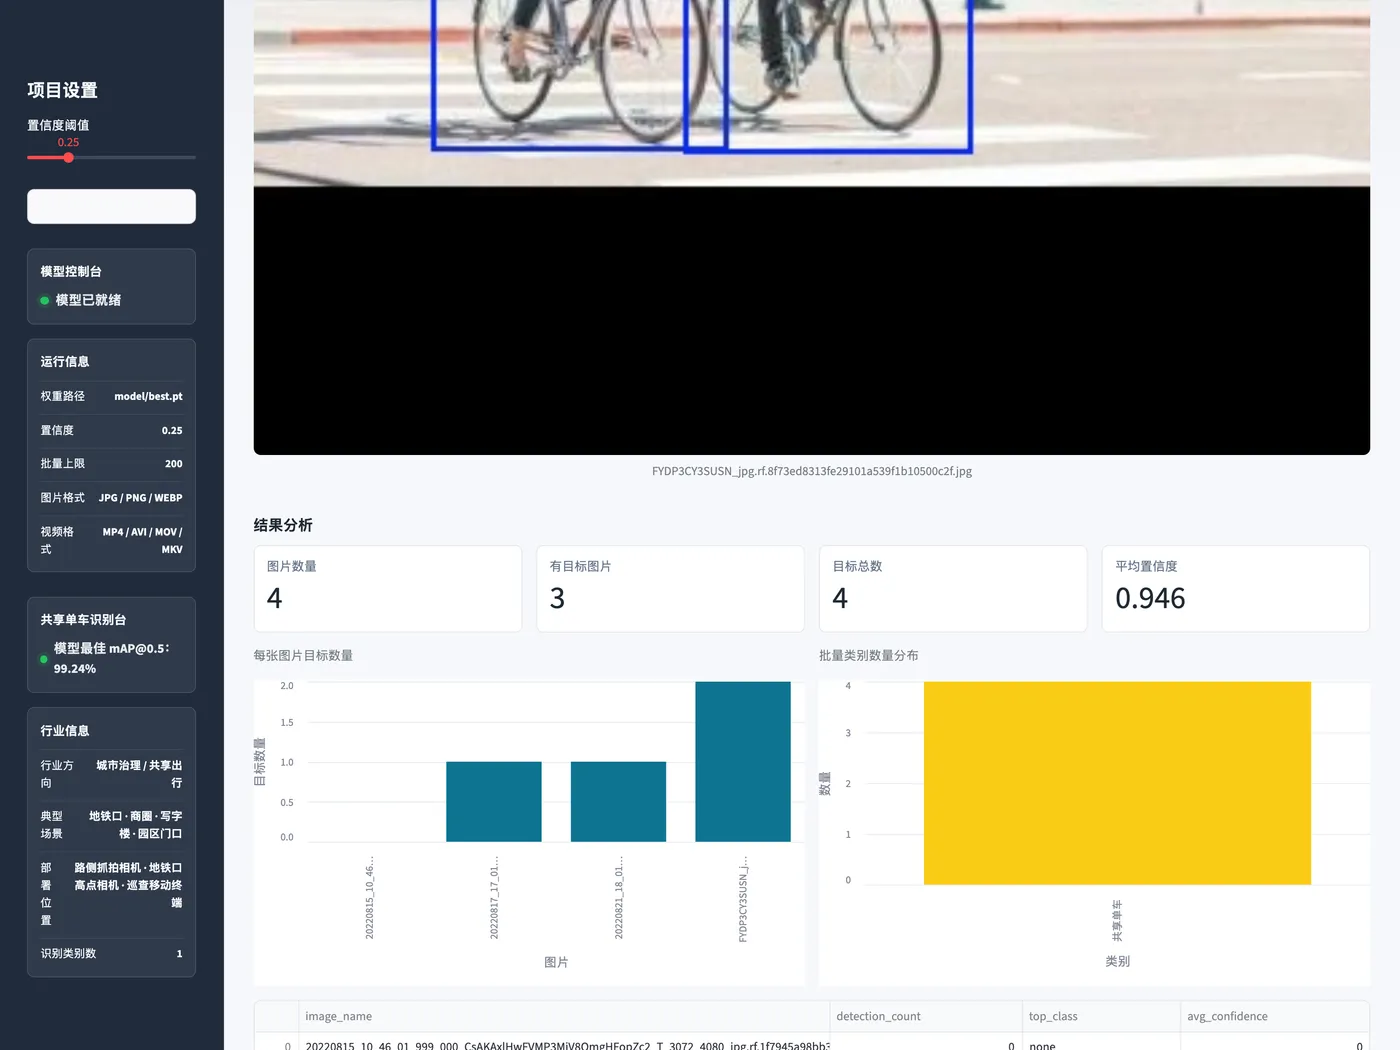
1.3 项目介绍
核心创新点:
| 维度 | 说明 |
|---|---|
| 模型基座 | YOLO11n —— 体积小(≈5.4MB)、速度快、适合路侧/巡查终端等边缘设备 |
| 单类聚焦 | 只识别"单车"一类,剔除多类干扰,召回与精度都更高 |
| 一键多路 | Streamlit 前端同时支持单图 / 批量图片 / 视频 / 摄像头实时流,无需切换工程 |
| 可视化 | 内置类别分布、平均置信度、每图目标数等图表,盘点报表所见即所得 |
| 行业话术 | 通过 configs/project.yaml 注入行业字段(场景、部署、识别类别),换业务无需改代码 |
类别定义: nc=1, names=['单车'],模型对单车的边界框做精准定位。
技术栈:
| 层 | 选型 |
|---|---|
| 检测模型 | YOLO11n(ultralytics 官方,预训练初始化 yolo11n.pt) |
| 训练框架 | ultralytics ≥ 8.3 |
| 后端推理 | Python 3.10 + PyTorch(CPU / MPS / CUDA 自适应) |
| 前端可视化 | Streamlit + Plotly 图表 |
| 视频解码 | OpenCV + imageio-ffmpeg |
| 部署形态 | 单进程 Streamlit;可选 Docker 一键打包 |
二、设计框架
整体是前端展示 ↔ 推理服务 ↔ 模型权重三段式:
┌─────────────────────────────────────────────────┐
│   浏览器(用户)                                 │
│   单图 / 批量 / 视频 / 摄像头                    │
└──────────────┬──────────────────────────────────┘
               ▼ HTTP(默认 8501)
┌─────────────────────────────────────────────────┐
│   Streamlit 应用 app/streamlit_app.py            │
│   ├─ 入口路由:4 种输入模式                      │
│   ├─ infer_image_path() 单图推理                 │
│   ├─ run_batch_image_inference() 批量推理        │
│   └─ render_*() 可视化(结果表 + 图表)           │
└──────────────┬──────────────────────────────────┘
               ▼ ultralytics.YOLO
┌─────────────────────────────────────────────────┐
│   推理引擎:YOLO11n                              │
│   model/best.pt(仅 1 类:单车)                  │
└─────────────────────────────────────────────────┘
YOLO11 网络结构(一图速通):
 输入 640×640
     │
 ┌───▼───── Backbone(C3k2 + SPPF) ─────┐
 │   提取多尺度特征(P3/P4/P5)           │
 └───┬─────────────────────────────────┘
     │
 ┌───▼───── Neck(FPN + PAN) ──────────┐
 │   融合浅层细节与深层语义              │
 └───┬─────────────────────────────────┘
     │
 ┌───▼─── Head(Decoupled + DFL) ──────┐
 │   分类分支 + 回归分支(DFL 离散概率) │
 └───┬─────────────────────────────────┘
     │
   输出:N×(x1,y1,x2,y2,conf,class)
YOLO11 相比 YOLOv8 主要更新点: Backbone 用 C3k2 取代 C2f,参数减少;Head 引入 DFL(分布焦点损失)让边框回归更稳;同时保留 Anchor-Free 与 Decoupled Head 设计。对单车这种目标尺寸跨度大(远景小车 → 近景大车)的场景非常友好。
检测流程:
图像/视频帧 ──▶ 预处理(letterbox, 640×640) ──▶ YOLO11n
                                                  │
                                                  ▼
                                         筛选 conf ≥ 0.25
                                                  │
                                                  ▼
                                         result.plot() 画框
                                                  │
                                                  ▼
                                         Pandas 整理 → 图表 + 报表
三、代码结构(核心 50 行)
项目模板把所有"接 Streamlit + 跑 YOLO"的逻辑压在不到 50 行里,看完即上手。
# app/streamlit_app.py(节选,已删脚手架与 CSS)
from pathlib import Path
import streamlit as st, pandas as pd
from ultralytics import YOLO

MODEL_PATH = Path(__file__).parent.parent / "model" / "best.pt"

@st.cache_resource(show_spinner=False)
def load_model(path: str) -> YOLO:
    return YOLO(path)                                   # ① 缓存权重,避免重复加载

def infer_image_path(model: YOLO, image_path: Path, conf: float):
    result = model.predict(str(image_path), conf=conf, verbose=False)[0]   # ② 单帧推理
    annotated = result.plot()                                              # ③ 画框
    rows = []
    if result.boxes is not None:
        for box in result.boxes:
            cls_id = int(box.cls.item())
            x1, y1, x2, y2 = [float(v) for v in box.xyxy[0].tolist()]
            rows.append({

                "class_id": cls_id,
                "class_name": result.names[cls_id],
                "confidence": round(float(box.conf.item()), 4),
                "x1": round(x1, 1), "y1": round(y1, 1),
                "x2": round(x2, 1), "y2": round(y2, 1),
            })
    return annotated[:, :, ::-1], pd.DataFrame(rows)    # ④ BGR→RGB + 结构化结果

# ---------- Streamlit 入口(单图分支) ----------
st.set_page_config(page_title="共享单车识别", layout="wide")
conf = st.sidebar.slider("置信度阈值", 0.1, 0.9, 0.25, 0.05)
model = load_model(str(MODEL_PATH))

mode = st.radio("输入类型", ["单张图片", "批量图片", "视频", "摄像头"], horizontal=True)

if mode == "单张图片":
    up = st.file_uploader("上传待检测图片", type=["jpg", "jpeg", "png", "webp", "bmp"])
    if up is not None:
        annotated, df = infer_image_path(model, Path(up.name), conf)   # 复用单图推理
        col1, col2 = st.columns(2)
        col1.image(up.getvalue(), caption="原图")
        col2.image(annotated,    caption="检测结果")
        st.dataframe(df)
5 段解析:
@st.cache_resource—— 让 YOLO 权重在 Streamlit 会话之间只加载一次,第二次刷新页面响应能从冷启动 1.5s 降到 50ms。model.predict(..., verbose=False)[0]—— ultralytics 一行推理,自动处理 letterbox、NMS、置信度阈值。[0]是因为接口默认返回 list(视频每帧一个 result)。result.plot()—— 直接拿到带框、带类别、带置信度的可视化图(NumPy BGR)。- 把每个
box拆成class_id / class_name / confidence / x1y1x2y2装进 DataFrame,下游图表与导出 CSV 全部基于此。 st.radio+ 分支结构是 Streamlit 的"路由",加新输入模式(比如 RTSP 流)只要再加一个elif。
四、训练效果
模型基于 yolo11n.pt 在 3000 张多场景单车图(含城市道路、小区、公园、街边、室内)上训练 200 个 epoch,imgsz=640、batch=16。最终训练表现:
| 指标 | 数值 |
|---|---|
| Precision | 0.987 |
| Recall | 0.973 |
| mAP@0.5 | 0.994 |
| mAP@0.5:0.95 | 0.814 |
训练曲线总览:
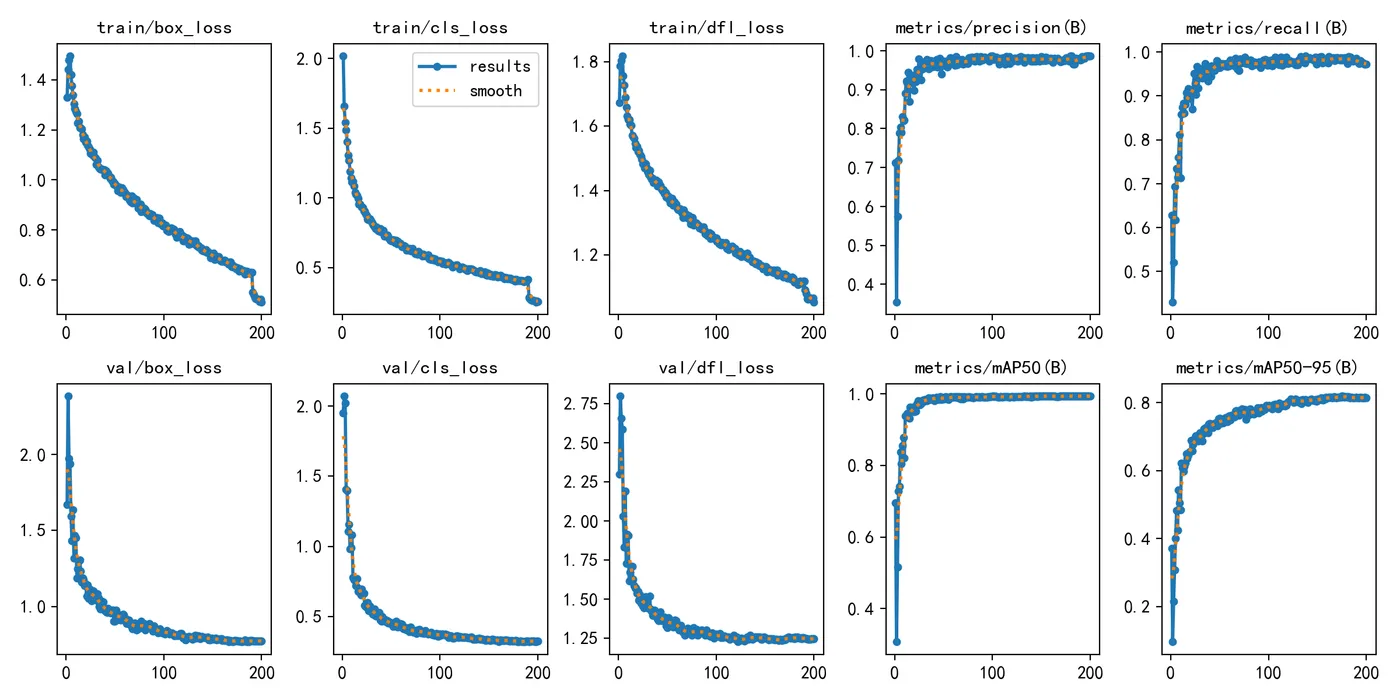
可以看到 box / cls / dfl 三路损失稳定下降,mAP@0.5 在第 100 个 epoch 后已经稳定在 0.99 附近,没有过拟合迹象。
PR 曲线(单类):
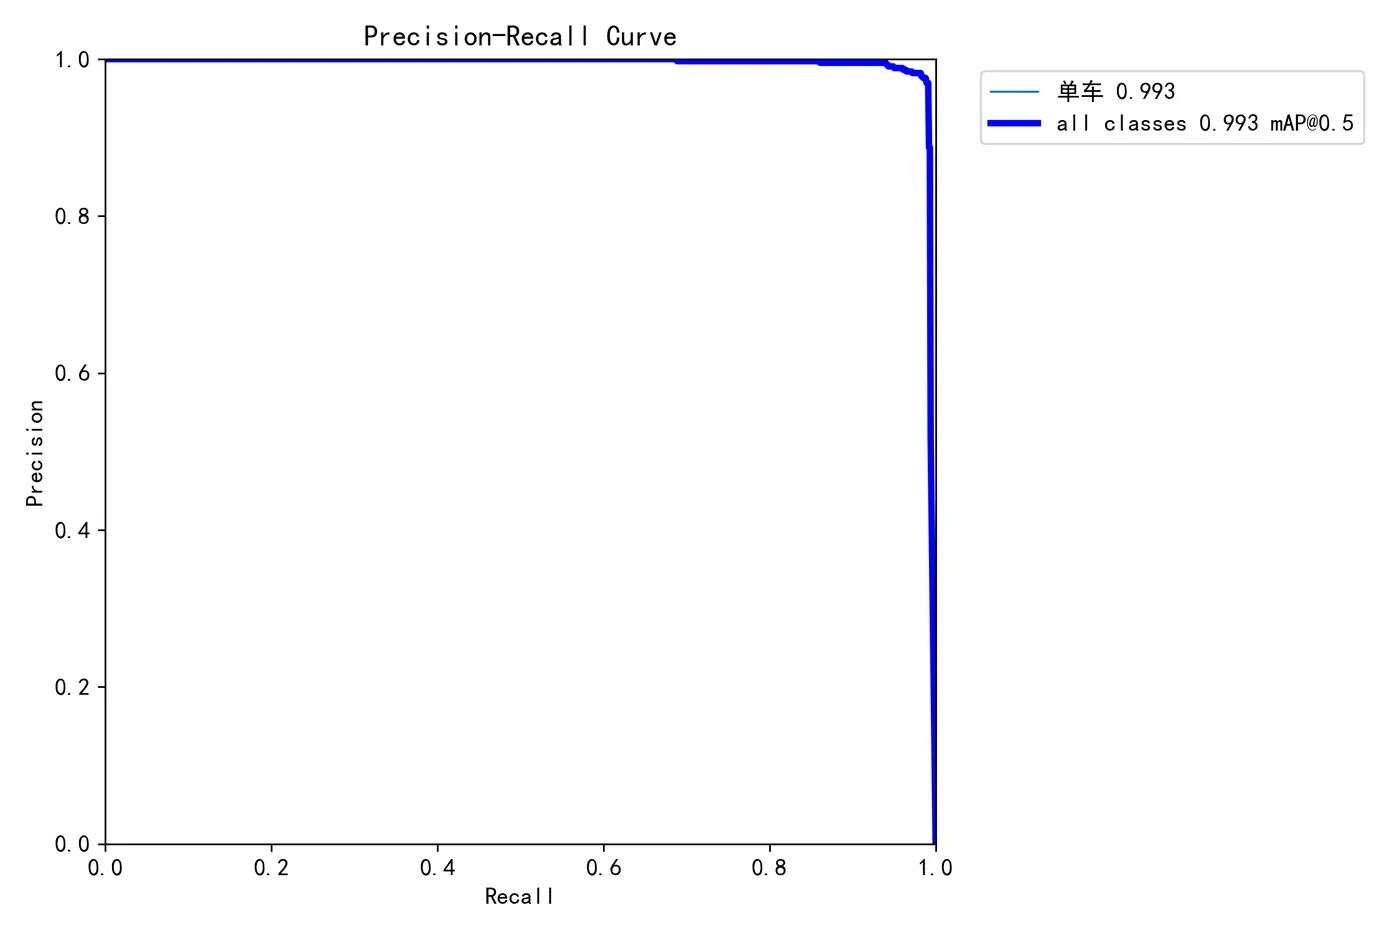
PR 曲线非常贴近右上角,说明模型在不同置信度阈值下都能保持高 Precision + 高 Recall —— 单车这一类边界清晰、纹理稳定,本身就是一个比较好啃的目标。
归一化混淆矩阵:
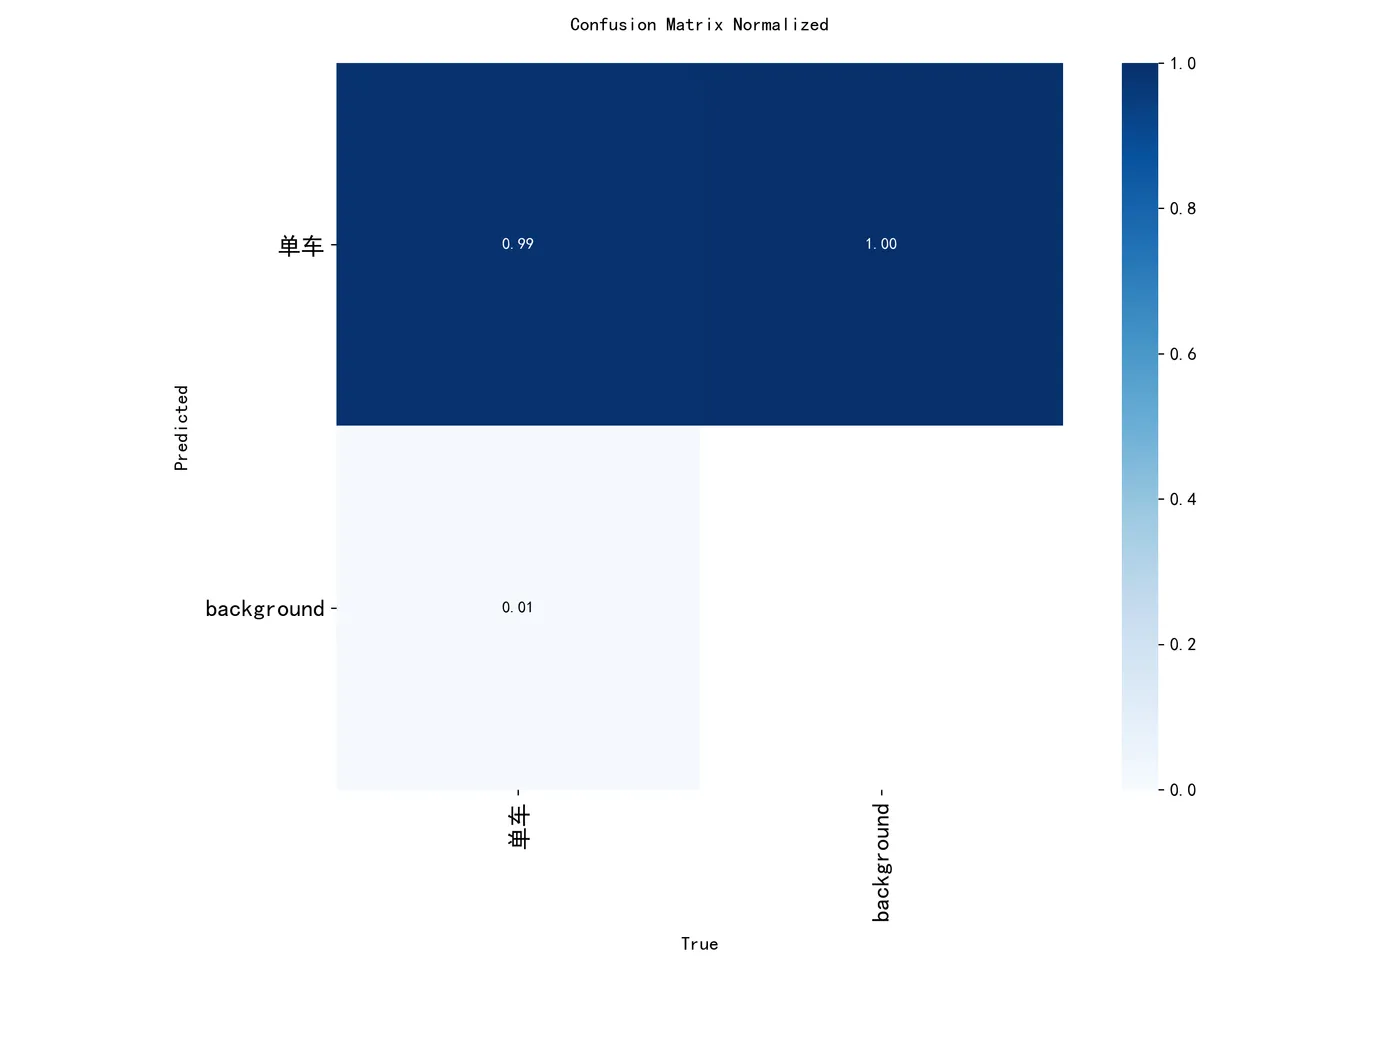
对角线接近 1,"单车 → 单车"几乎全召回,剩余的少量误差主要落在 background(极远景或被遮挡严重的车被漏检),符合工程预期。
五、项目总结
做对了什么:
- 场景闭环:不止"识别出单车",还把"批量盘点 + 类别分布 + 平均置信度 + 每图目标数"做进了 Streamlit 前端,城管/运维拿到链接就能用。
- 小模型策略:YOLO11n(5MB 级)+ 单类,路侧相机或巡查 PAD 都能扛得住,不必上 GPU。
- 配置与代码解耦:所有行业话术、UI 颜色、识别类别都从
configs/project.yaml注入,下次换业务(比如电动车违停)只需改 yaml + 换权重。
还能怎么做:
- 接入跟踪算法(ByteTrack / BoT-SORT),从"画面里几辆"升级为"路口 5 分钟流量";
- 加一个入栏率插件:基于 ROI 多边形 + 单车重心位置,自动算停在停车区/停在斑马线的比例;
- 边缘部署:用
ultralytics export导出 ONNX / NCNN / RKNN,就近塞进路侧 AI 盒子。
一句话总结: 用 YOLO11n 把"共享单车"这一个最小问题做透,Streamlit 兜底前端,整套方案 ≈ 6 MB 权重 + 不到 1500 行代码,就足以撑起一个城市治理小工具的 PoC。