
事情是这样的。
眼瞅着十一长假没几天了,我正盘算着假期去哪耍。
那天老板甩过来一个需求:做跨银行数据一致性校验的性能优化 POC。我想抓紧和客户方沟通把这个事搞定,结果等客户把具体资料发过来时,竟然有二十道题之多。数据量嘛,帐户 5.25 亿,关联交易流水 1.5 亿,现在跑着某著名国产 MPP 数据库(就不点名了,下面就用 MPP 指代),3 节点,每节点 48 核×2,768G 内存,感觉有点慢,想看看能不能优化。
老板说:你去搞一下,看看 SPL 能不能跑,性能怎么样。
我:???20 个校验???这节怕是过不好了。
我写你麻辣鸽……
第一反应:这活儿得干到什么时候
20 个校验逻辑,意味着 20 段 SQL 要翻译成 SPL,不说一大堆 JOIN,复杂的还用了 CTE,字段名也是脱敏的一堆字母数字,看了就懵逼,也没中文业务逻辑的说明。我本来对业务不熟悉,翻译完了还要优化性能。我一个人干?这不得搞俩月?
我是写 SPL 的,但我也不是神仙。这种量级的代码,让我手写,先不说写不写得对,光是调试就得掉层皮。
然后我想起来:不是还有豆包吗?
让豆包写,我盯着
其实也没直接开写。我先让豆包把给的 SQL 读一遍,用大白话给我讲每个校验到底在查什么——遇到绕的 CTE 嵌套,我就丢样本数据进去让它举例子,哪个字段跟哪个字段关联、分组后判断什么条件,一来二去我就把 20 个校验的业务逻辑摸了个大概。
然后我再回头看 SQL 里的关键点:关联键是哪些字段、GROUP BY 按什么、过滤条件在哪。这些定了,我就能想清楚:这张表按什么键存组表、哪张表要进内存、哪个外键得序号化、游标要不要多线程。
简单说就是:豆包帮我读SQL、讲业务、写代码;我负责定存储方式和算法,写完对结果、揪bug。
说实话一开始我也没底。几个月前让 AI 写 SPL,它连函数名都查不对,for 循环和单元格引用搞混,写出来的脚本引用全是错的。
但这次它居然能干活了。
SPL 快在哪,我只说三个事
事 1:数据排好序再扫,别搞哈希
MPP 跑一个“按身份证分组算 18 个字段是否跨行一致”的校验,跑了 76 分钟。
为啥?SQL 的 GROUP BY 不管你数据在磁盘上排没排序,一律建哈希表,然后把 5.25 亿行 shuffle 到 3 个节点上去算。网络和哈希就把时间吃光了。
SPL 呢?我把 5.25 亿行按身份证号物理排序存成一个组表文件(16G),后面所有按身份证分组的校验,读出来就是有序的,group@s 直接流式分组——不建哈希表,不 shuffle,读一遍就完。
AI 写出来的核心代码:
=file("/SPL/full_t25.ctx").open().cursor@mv(B050005,...;;4)
=A2.group@s(B050005; count(1):cnt, icount(RPT_ORG_NO):orgcnt, ...)
就这么两行。MPP 跑 76 分钟的,SPL 跑了 6 分钟。快12倍。
另一个校验,MPP 跑了 144 分钟,SPL 跑了 57 秒。快150倍。
我不是说 MPP 不行,是 SQL 这个东西,它没有“物理有序存储”这个概念。你告诉它我数据排好序了,它不听,它觉得它比你懂。
事 2:外键别用字符串,用整数序号
集团成员表 455 万行,要关联集团主表。关联键是(集团 ID, 银行代码)——字符串。
AI 一开始写的是用字符串做 key 做 pfind,内存直接炸。
我说:你给每个集团分配一个递增整数 grp_seq,成员表按这个整数排序存。关联的时候不是比字符串,是比整数,两张表游标都按 grp_seq 顺序走,归并连接。
AI 改了改代码,几行搞定,毫秒级。
这个思路 SQL 做不到——SQL 没有“外键序号化”这个概念。Java 能做,但你得自己写、自己管外存游标,AI 大概率写不对。SPL 几行就完了。
事 3:小表装内存,大表别装
最复杂的一个场景:1.5 亿行交易流水,找 A 行交易在 B 行有没有反向匹配的。
我说:B 行数据量小,直接全读进内存做哈希表;A 行 1.5 亿行用游标流式读,每来一条去 B 行内存表里 find。别两边都装内存。
AI 写出来:
=B行.cursor@mv(...).fetch()
=A行.cursor@mv(dfzh,...; B行.find(dfzh); 4)
A 行从头到尾不进内存,就占个游标位置。MPP 做同样的事跑 154 秒,SPL 跑 47 秒。
豆包写代码的本事,一言难尽
也别吹 AI 全自动,它也是真能犯傻:
· 字段顺序和组表定义不一致,数据全错位了它不检查;
· 把该存 int 的字段存成 string,后面比大小直接报错;
· JVM 默认给 1G,跑 16G 组表直接 OOM,我得告诉它给 60G;
· MPP 导出的 CSV 里 NULL 是 \N,它当成字符串存进去,后面 if(FIELD,...) 把空串当真值,结果全错;
· 最离谱的一次,这货竟然自作主张把 SQL 简化了,一个 LEFT JOIN 改成 INNER JOIN,数据少了 30%,我对结果时发现行数不对才揪出来。
这些坑都得人盯着。但人盯的不是语法——语法它自己能查文档——人盯的是算法对不对。
不过话说回来,它也不是光犯傻,有地方是真强。
SPL 那种链式循环函数——new、select、group、.conj()、.news() 串在一起,动不动嵌套四五层。我每次看这种表达式都得硬控几十秒,掰着指头数这个括号里到底在算啥。
豆包不一样。你说个需求,它“唰”一下就写出来了,还写得对。后来我干脆放弃读它写的复杂循环,直接拿数据对结果——结果对得上,我就不管中间过程了。
那一刻我确实觉得:这钱(会员)花得值。
最后成绩
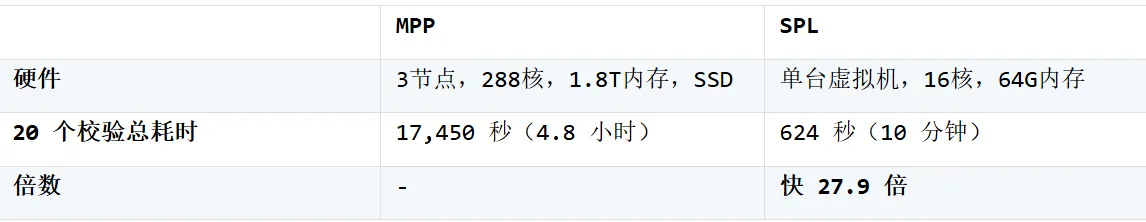
288C1.8T 对 16C64G,4.8 小时对 10 分钟,SPL又一次完胜!(为什么要说“又”?)
这事前前后后也搞了两周多点,不过一多半时间都花在和客户沟通如何造出合理的测试数据,写 SPL 再调性能的时间也就三五天,这在以前是没法想的,豆包算是立了大功!
说点正经的
这个事想明白了:
SQL写不出来。 不是SQL不强,是SQL没有有序存储、外键序号化、外存流式游标这些概念。AI再强,你让它写GROUP BY,它写出来就是哈希shuffle,它想不到“先把数据排好序再顺序扫”——因为SQL不允许它这么想。
Java理论上能写。 但你得自己管游标、自己排外存、自己处理内存。AI 能写出伪代码,真到 5.25 亿行不 OOM、不错位、不漏数据,得踩无数坑。你也不会写。
Python没性能。 pandas 一上来全读内存,1.5 亿行直接 GG。
SPL能。 不只是因为它语法优雅——其实单元格写法(A1、B5那种)开始看着还有点怪——更重要的是它把“有序存储”“外存游标”“组表”“序号化”这些高性能数据处理的标准动作内化成了语言原语。你告诉AI思路,它查文档就能拼出来。
几个月前 AI 读 SPL 文档都费劲,现在能现学现卖了。一方面是 AI 进步了,另一方面 SPL 的文档和示例够全,函数参考、代码示例,AI 自己就能查。
但它还是需要人。人负责想清楚算法:哪些表有序、外键怎么序号化、哪个进内存哪个流式。这些是数据处理的 know-how,不是看看文档就能学会的。
SPL 的价值不是“又一门要学的新语言”,它是AI时代让AI能写出高性能数据处理代码的语言。
而且,你不需要学会写 SPL,但要会想清楚算法,AI 能帮你落地。
这事儿要是让 AI 写 Java 实现同样的有序存储 + 流式分组 + 序号化关联,我赌它写不出来——不是 AI 不够聪明,是 Java 没这些原语,一切从零造轮子,AI 也没戏。
SQL 就更别提了,AI 再强也没法让 SQL 按物理顺序分组。
那打工狗呢? 看到这你可能有点慌:SPL 是挺快,但我是不是也得去啃一门新语言?不用。这次 20 个校验的 SPL,九成是豆包写的,我干的活是提需求、定算法、对结果。语法这关,AI 替我过了,你连函数名都不用背,说人话,它查文档,活就干了。
算法常识也没那么玄。有序存储、小表装内存、外键序号化——这些看起来是 SPL 发明的黑魔法,其实是你本来就会的数据处理直觉:Excel 里你也会先按一列排好再逐行对,Python 里你会把小的那个塞进字典提速。而且,SPL 论坛上还有葵花宝典教你,就算没什么经验的程序员,翻着也能快乐地完成凡人头疼的性能优化工作。
所以别把 SPL 当新语言学,把它当“指挥 AI 干活的姿势”。 以后老板甩需求,别人吭哧吭哧写 SQL 等俩小时,你坐那跟豆包聊两句,十分钟出结果——这日子,想想就美。
最后畅想一下
现在 AI 写代码已经能干活了,就是算法设计还得人来做:哪些表有序、外键怎么序号化、哪个进内存哪个流式,这些得我告诉它。
等哪天 AI 再炼丹一段时间,把这些高性能算法的设计思路也学会了——自己就知道该有序存储、该序号化、该内外存分工——那我就可以真下岗了。
到时候老板再甩过来 20 个校验,我直接跟豆包说:你去 POC 吧,我钓鱼去了。
哈哈哈,希望那天来晚点,我还想再摸两年鱼。
