在亚马逊上找到能卖的产品,本质是个数据问题。两个卖家看同一个类目:一个靠周末手动翻几十个页面凭感觉下单,另一个先拉出 BSR 趋势、评论增速、价格历史和关键词需求,算清楚了再备货。Amazon 选品 API 就是第二个卖家的数据来源——用程序化的方式拿到这些数据,规模是浏览器翻页比不了的。
这篇指南讲四件事:API 到底返回什么数据、选品工作流怎么一步步走、成本怎么算、服务商怎么选。
选品 API 到底给你什么数据
抛开营销话术,选品 API 就是一份结构化的亚马逊公开市场数据。对选品真正有用的字段:
- 商品详情——标题、品牌、ASIN、图片、五点描述、详情页文案
- 价格——当前售价、各变体价格、优惠券和促销标识
- 排名信号——类目 BSR(Best Sellers Rank),公开数据里最接近真实销量的指标
- 社会证明——评分、评论数、评论增速
- 竞争格局——跟卖数量、FBA/FBM 比例、购物车归属
- 搜索数据——关键词搜索结果,带自然/广告位标识
- 类目数据——类目层面的需求、集中度、新品活跃度
每个字段对应一个选品问题。价格 + BSR + 评论数告诉你这个类目还有没有空位;广告位占比告诉你进场要烧多少钱;评论区告诉你用户在骂什么——而用户骂得最多的地方,往往就是产品的机会点。
BSR 别用错了
BSR 是选品里被误读最多的数字,三点提醒:
- 它是类目内相对排名。 厨具类第 1000 名和工业品类第 1000 名,销量可能差一个数量级。跨类目对比 BSR 没有意义。
- 它按小时更新。 单点截图会骗人,看 30–90 天的趋势才作数。
- 它反映近期动量,不是历史总量。 一个靠惯性维持排名、评论却在流失的老品,恰恰是最脆弱的 incumbent——也就是你的机会。
官方 API 和第三方 API
亚马逊官方的 PA-API(Product Advertising API)是正规渠道,但它是给联盟客做商品推荐挂件用的,不是给选品用的。要 Associates 账号审批、限流严格,不给批量搜索结果、不给跟卖数据、大规模 BSR 想都别想。
| PA-API(官方) | 第三方商品数据 API | 无代码选品工具 | |
|---|---|---|---|
| 批量关键词搜索 | 不支持 | 支持 | 支持(界面操作) |
| 大规模 BSR | 受限 | 支持 | 支持 |
| 跟卖/报价数据 | 不支持 | 支持 | 部分支持 |
| 评论挖掘 | 不支持 | 支持 | 支持(AI 总结) |
| 接入条件 | Associates 账号 | API key | 注册账号 |
| 适合 | 联盟挂件 | 开发者、数据团队 | 不写代码的卖家 |
PA-API 做几个 ASIN 的比价挂件是够的。一旦你要扫类目、跟踪排名变化、挖掘评论,就超出它的能力范围了。第三方 API 的存在就是因为选品需求不在 PA-API 的设计目标里——拿亚马逊的"官方祝福"换覆盖面。
选品工作流:六步走
下面是一次完整选品怎么映射到 API 调用。不管你写代码还是用无代码工具,流程是一样的。
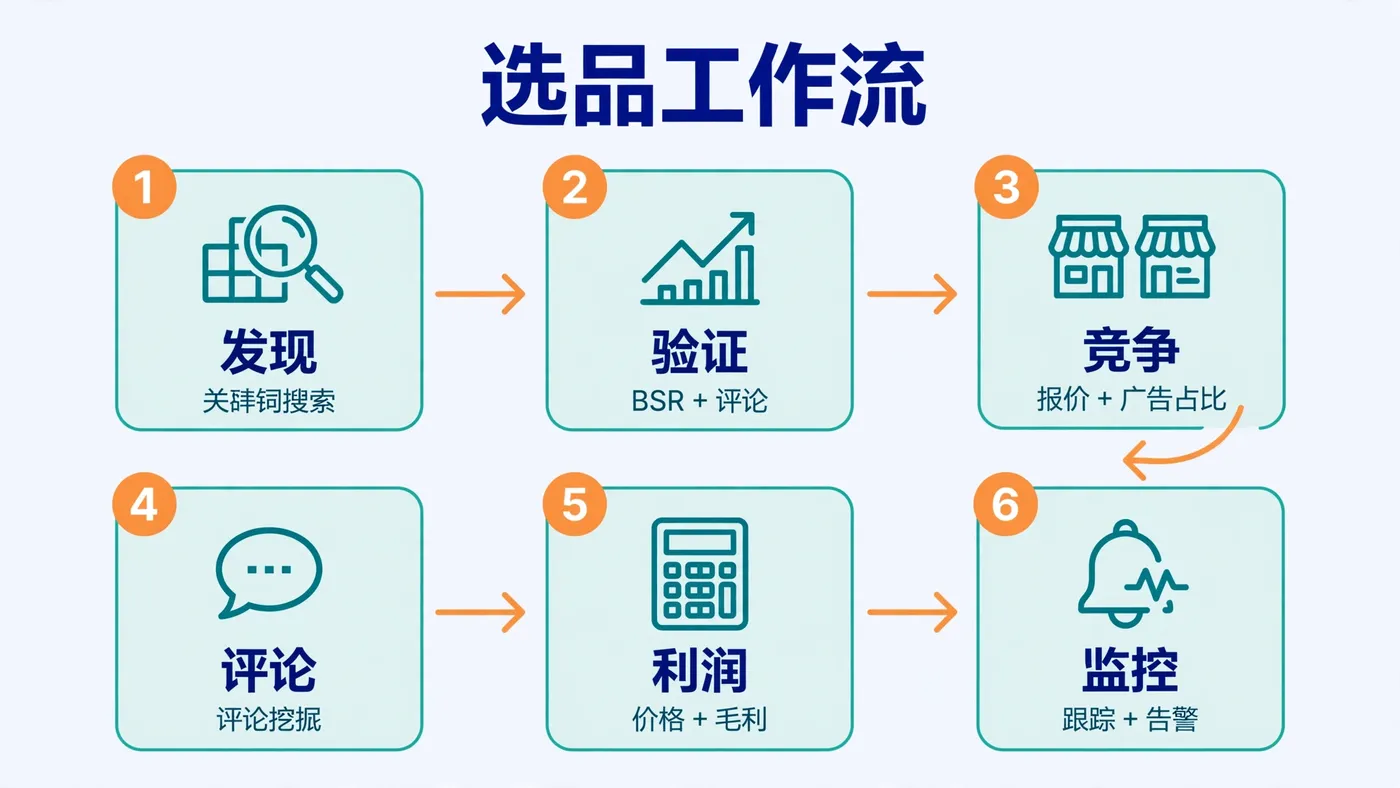
选品六步工作流与 API 端点的对应关系。
第一步:发现候选
先铺开。用种子词拉关键词搜索结果,或者拉类目 Best Seller 榜单。收集 ASIN、标题、价格、评分、评论数——几百行数据,这就是你的候选池。
实操口径:一个类目 3–5 个种子词,每个词取前 100 名,去重后 300–500 个候选。手动翻页面这是一个周末的工作量,API 一批就跑完。
第二步:验证需求
每个候选拉商品详情:BSR 趋势、价格历史、评论增速。看三个数:
- 评论增速(每月新增评论)比评论总数重要。400 评论每月新增 40 个的产品,跑赢了 3000 评论每月新增 5 个的老品。
- 价格稳定性。 一个类目频繁打折说明利润在被挤压;价格坚挺说明还有空间。
- BSR 趋势 vs 评论趋势。 BSR 往上走、评论没跟上,说明类目增速超过了老品的承接能力——这就是进场窗口。
第三步:看竞争格局
拉 offer 列表和卖家数据:几个卖家、FBA 占比、购物车在谁手里。再看核心关键词搜索结果的广告/自然占比。经验值:
- 首屏大多是广告位 → 烧钱进场类目,PPC 预算要留足。
- 一个品牌占了种子词 3 个以上自然坑位 → 你打的不是市场,是一个深耕多年的 listing。
- 竞争对手 FBA 占比高 → 快速物流是门票,不是差异化。
第四步:挖掘评论
评论是最便宜的产品开发输入。别读十条就下结论——批量拉下来,先看差评。找反复出现的抱怨:尺寸问题、缺功能、不耐用。每个反复出现的两星主题,都是一份现成的产品需求文档。这一步正是Pangolinfo 评论数据 API 的价值:规模化的情绪,而不是个案。
第五步:算利润账
售价、预估费用、你的到岸成本放一起。不需要精确的销量预估——要的是利润区间和价格带感知。如果竞品全挤在 $19.99–$24.99,这就是市场价格锚;你的差异化要么待在这个区间里,要么给出打破它的理由。别忘了留出上架前 60–90 天的折扣空间。
第六步:持续监控,别只看快照
选品数据会过期。把 shortlist 跟踪起来:价格变动、BSR 异动、新品进入、差评激增。设真正有意义的告警阈值——跟踪的 ASIN BSR 跌 20%、Top 20 进了新竞品、突然来一波一星。赢的卖家在第二周就发现趋势,不是第六个月。
实战示例:10 分钟看"硅胶保鲜盖"
数字是示意的,但形状是真实的:
- 发现。 "silicone stretch lids" + "reusable food covers" + "bowl covers silicone" 三个词 → 300 条结果,去重剩约 180 个 ASIN。
- 验证。 按评论数取前 30 拉详情。三个突出:4.5 星+、2000+ 评论,但月新增评论不到 15——老品,增速放缓。
- 竞争。 头部 ASIN 12+ 跟卖,80% FBA。搜索结果前 8 里 4 个广告位——烧钱进场,但自然坑位没被某个品牌垄断。
- 评论。 差评挖掘发现反复主题:"盖不住大碗"(2–3 星评论里约 8% 提到)——这就是产品缺口。
- 利润。 价格带 $12.99–$16.99,$14.99 定价、留出上架折扣后还有 35%+ 毛利空间。
- 监控。 5 个 finalist 周跟踪,新品进入和 BSR 异动告警。
结论:可以做,但卖点必须是"密封性更好"。整轮 API 成本不到 1000 credits。
好的 API 数据长什么样
不是所有 JSON 都一样。选服务商时看返回结构:
- 每条记录带时间戳。 没有日期的研究数据是谣言——你必须知道每个价格、排名、评论数是什么时候抓的。
- 广告标识是显式字段。 每条搜索结果带
is_sponsored布尔值,而不是藏在标题文字里让你猜。 - 缺字段返回 null,不编造。 编造数据的 API 比没数据的更危险。
- 多站点 schema 一致。
.com和.de返回字段名不一样,你的 pipeline 就要为此交税。
代码:串起来
不管哪家,模式都一样:鉴权、请求、翻页、入库。(示意——精确的端点定义见Pangolinfo文档。)
import requests
from datetime import date

API_KEY = "pgl_xxx"  # tool.pangolinfo.com 免费领 key,前 60 次免费
headers = {
   "Authorization": f"Bearer {API_KEY}"}

# 1. 发现:搜关键词,收集候选 ASIN
resp = requests.get(SEARCH_URL, headers=headers, params={
   "q": "silicone stretch lids"})
today = date.today().isoformat()
candidates = [
    {
   "asin": p["asin"], "price": p["price"], "rating": p["rating"],
     "reviews": p["reviews"], "captured_at": today}
    for p in resp.json()["products"]
]

# 2. 验证:shortlist 拉详情 + BSR,保留时间戳
shortlist = []
for c in candidates[:30]:
    d = requests.get(DETAIL_URL, headers=headers, params={
   "asin": c["asin"]}).json()
    shortlist.append({
   **c, "bsr": d["bsr"], "bsr_trend": d.get("bsr_trend_30d")})

# 3. 按动量排序,不看绝对值
shortlist.sort(key=lambda x: x["reviews_velocity_30d"] or 0, reverse=True)
成本:真实的 credit 数学
计费按 credit 来,坑在乘数。Pangolinfo 当前价格(2026 年 10 月实测):商品数据 1 credit/页,评论 5 credits/页,类目研究 2 credits/页。Raw HTML 比解析好的 JSON 省 25% credits。
一轮完整的类目调研:
| 步骤 | 请求数 | Credits |
|---|---|---|
| 500 页搜索结果建候选池 | 500 | 500 |
| 100 个 shortlist ASIN 拉详情 | 100 | 100 |
| 20 个 finalist 拉评论(各 2 页) | 40 | 200 |
| 合计 | 约 800 |
持续监控比发现便宜——你复拉的是固定的 shortlist,不是扫类目。100 个 ASIN 每天拉一次详情:100 × 30 = 3000 credits/月。
前 60 次免费,所以验证流程的成本是零。真正要看的不是"每次请求多少钱",而是每条可用数据多少钱。便宜但返回被封页面或过期数据的 API,比贵的贵得多。
五个烧钱的选品误区
- 只看快照。 一次抓取说明不了趋势。不看两个以上时间点就别判断需求。
- 无视广告占比。 首页看着自然流量丰富,换个干净环境一搜 70% 是广告——这是 PPC 修罗场。
- 把销量预估当事实。 预估是带误差的模型,拿来给候选排序可以,拿来算备货量不行。
- 评论抽样偏差。 只读前十条好评——而好评天然扎堆。机会藏在批量挖掘的差评里。
- 跨类目比 BSR。 一个类目的第 2000 名可能比另一个类目的第 200 名卖得多。BSR 只在类目内有意义。
自建、买 API,还是不写代码
- 自建爬虫:数据采集就是你的核心能力、且有工程师长期维护解析器、代理、验证码对抗,再考虑。多数团队低估了维护成本——这是个随时间复利的数据工程问题。
- 买商品数据 API:比如 Pangolinfo Amazon Scraper API,要结构化 JSON 但不想搭基建。按请求付费,精力放在分析上。
- 不写代码:Pangolinfo Amazon Product Research Tool,同一套工作流——ASIN、关键词、类目、榜单跟踪 + AI 分析——在飞书多维表格里跑,1.5 credits/页。
服务商怎么选
- 覆盖面——哪些站点、哪些端点(搜索、商品、报价、评论、类目)
- 新鲜度——实时数据还是几小时前的缓存
- 广告识别准度——广告/自然标识靠不靠谱(Pangolinfo 标注 90%+ 广告位识别率)
- 反爬可靠性——在亚马逊这个站上的成功率,不是泛泛的"抓取成功率"
- 每条可用数据的成本——单次 credit × 成功率
- 开发者体验——文档质量;玩 Agent 的话看有没有 MCP 支持
FAQ
官方 PA-API 能做选品吗?
能试,但它不是为选品设计的:要 Associates 审批、限流严、不给批量搜索和大规模 BSR。多数选品工作流需要第三方 API。
BSR 和销量预估什么区别?
BSR 是亚马逊自己的公开排名——真实,但类目相对、反映近期动量。销量预估是第三方基于 BSR 等信号建的模型。看 BSR 的方向,预估只拿来给候选排序,别拿来算备货。
抓亚马逊商品数据合法吗?
公开市场数据的采集用于研究是行业常规做法,具体司法辖区请咨询律师。用 managed API 是把基建负担转给服务商。
选品 API 数据多少钱?
Pangolinfo 当前价格:商品数据 1 credit/页,评论 5 credits/页,类目研究 2 credits/页,前 60 次免费。一轮完整类目调研几百 credits。
研究数据多久刷新一次?
发现阶段的数据几周就过期;shortlist 按类目节奏每天或每周跟踪。用告警代替重复全量扫。
不会写代码怎么办?
不用写。API 给开发者;Amazon Product Research Tool 把同一套工作流——跟踪、告警、AI 分析——做成了无代码版本。