接口用例越多越难维护?先让AI学会看懂一次业务变更

简介: 本文揭示AI测试维护的核心陷阱:字段变更易引发断言误判。主张从“改脚本”转向“判影响”,依托OpenAPI与业务不变量生成候选影响清单,聚焦高风险链路闭环验证,并将关键断言纳入契约回归,实现可追溯、可复用的质量门禁。(239字)

先看测试人最容易忽略的那一步

接口字段改动不会平均影响全部用例。真正危险的是:字段看似只多了一个枚举值,AI却按照旧规则批量维护断言,把“部分退款”仍当成“退款完成”。这篇把接口维护从“改脚本”改成“判影响”的流程。

为什么原来的测试直觉不够用

订单接口新增 refund_status=partial 后,客服页、对账、优惠券返还都可能变。不要让AI直接改500个断言;先让它把变更翻译成:哪些状态机迁移新增、哪些下游接口消费该字段、哪些旧断言会把部分退款误判成完成。

排查不要从模型开始

第一步,锁定业务不变量:部分退款后订单不能变成已关闭;已退金额加剩余金额必须等于原支付金额;优惠券只能按实际退货金额回补。第二步,让AI从OpenAPI、历史用例和调用关系中生成“候选影响清单”,但候选不是最终答案。第三步,测试工程师只审核高风险链路,并把确认结果沉淀成下一次可复用的规则。
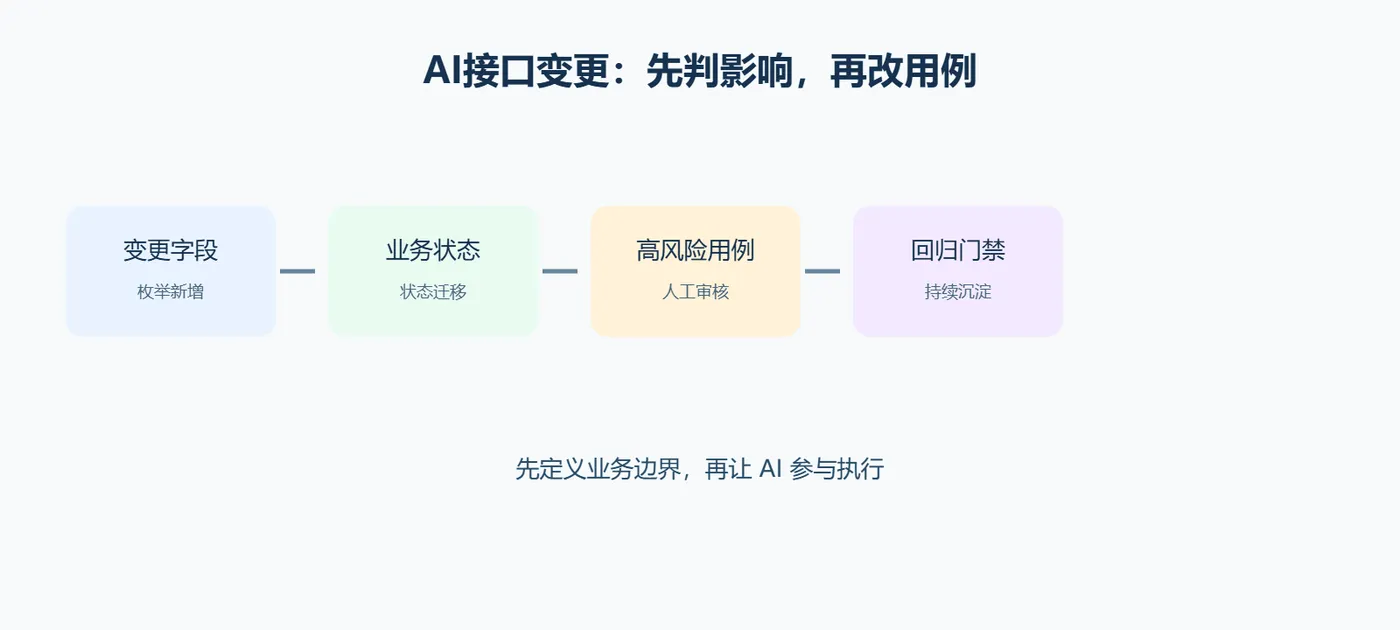
image.png

可进入回归的最小验证

assert order["refund_status"] == "partial"
assert order["refunded_amount"] + order["payable_amount"] == order["paid_amount"]
assert order["status"] != "closed"

这三条断言的价值,不是证明接口有字段,而是拦住AI把业务状态压扁成“退款成功/失败”两个值。把它们放到契约回归中,后续再有类似枚举变更,AI才能先指出风险而不是安静地改绿用例。

把这件事接进日常质量门禁

最后,给每次AI维护留一份变更报告:它建议改了哪些断言、没有改哪些、依据是字段说明还是历史Trace。3人团队真正省下来的不是敲代码时间,而是不用再靠记忆排查“这个字段到底牵动了谁”。

别把“最终看起来没问题”当成通过

AI 系统的难点在于,同一个表面结果可能来自不同路径:模型可能猜中了,也可能绕开了关键工具;脚本可能跑完了,也可能把业务断言改弱了;数据可能很多,也可能根本不满足业务约束。测试时必须把“结果对不对”拆成“输入是否可信、过程是否越界、动作有没有副作用、失败时有没有停下”。

一个很实用的工作习惯是,每次只挑一条高风险链路做证据闭环:记录输入、模型或Agent的决策、工具参数、服务返回、最终状态。它不需要昂贵平台,先用JSON日志和一组pytest断言就可以。等这条链路跑稳,再把同一套证据结构扩到其他业务。

新手落地清单

  1. 选一个金额、权限或订单状态相关的风险,不从“让AI写更多用例”开始;
  2. 写清通过条件和必须失败的条件;
  3. 把输入、关键Trace和最终副作用保留下来;
  4. 模型、提示词、工具Schema或页面发生变化时,优先重跑这批高风险样本;
  5. 复盘失败时,先归类为数据、模型、工具、规则还是环境问题,再决定修复。

这样做的价值不是把每个AI行为都变成确定性,而是把最不能接受的不确定性提前暴露出来。

为什么“加更多测试用例”常常无效

很多团队遇到Agent事故的第一反应,是再补十条相似问法。但如果十条用例只比较最后回复,它们仍可能一起放过错误路径。真正需要增加的是分叉:订单号缺失时必须转人工;取消未成功时不得直接退款;退款工具超时后必须先查询执行结果;跨账号订单永远不能作为候选。每个分叉都对应一个必须可见的Trace事件。

把这些分叉写成状态机,比把提示词写得更长可靠。状态机的好处是,它能让产品、研发、测试同时看到:哪一步允许自动继续,哪一步必须停下,哪一步需要人工确认。Agent Harness 的价值也在这里——把原本藏在模型语言里的行为,变成能回放、能对比、能回归的工程对象。

CI里怎么设门禁

不要一上来追求“所有Agent用例100%通过”。建议先分级:金额、权限、删除类操作的行为断言零容忍;普通咨询允许措辞不同,但关键事实不能错;低置信度问题必须产生转人工事件。模型更新时先跑这批小而尖的用例;有一条高风险轨迹越界,就不让版本进入下一阶段。

这套方法也能迁移给传统自动化同学。你熟悉的接口断言、状态机、Mock和回归集都没失效,只是断言对象从HTTP响应多了一层Agent决策与工具轨迹。
相关文章
|
2月前
|
人工智能 测试技术 UED
Google公开Agent Quality Flywheel:为什么改Prompt的模型不能同时当裁判?
Google提出Agent质量飞轮核心原则:**优化器不可自评**。若同一AI既修改Prompt又评分,易“游戏化指标”,而非真实提升体验。需严格解耦Optimizer与Evaluator,冻结测试集、Rubric和基线版本,实施盲测与多维验证(如保留集、硬指标、人工盲评、失败类型迁移),确保分数上涨反映真实改进。(239字)
Google公开Agent Quality Flywheel:为什么改Prompt的模型不能同时当裁判?
|
2月前
|
监控 测试技术
测试报告别只做『成绩单』:五个字段把放行责任写清楚
这是一份面向发布决策的质量报告革新方案:用“放行决策件”替代传统成绩单式报告。它以五个刚性字段(范围对账、风险账、证据链接、判定签名、回滚确认)结构化回答“能否上线、谁拍板、依据何在、责任归属、退路是否可靠”,直击复核成本高、追责难、决策无抓手等痛点。数据自动装配,判定机器可验,签名人工不可绕——让质量报告真正成为发布决策的法定依据。
测试报告别只做『成绩单』:五个字段把放行责任写清楚
|
2月前
|
人工智能 监控 测试技术
「我改完自己试了几个问题,感觉没问题」不算发布记录:给每次 Prompt 上线留一份三段式报告
Prompt作为AI应用的“事实源代码”,却长期缺乏代码级发布管理。本文提出三段式发布报告(变更台账+回归结论+回滚阈值),通过Git版本化、CI自动校验、相对指标比对与强制回滚锚点,将Prompt变更纳入可追溯、可回滚、可复盘的工程闭环,终结靠记忆复盘的裸奔时代。(239字)
「我改完自己试了几个问题,感觉没问题」不算发布记录:给每次 Prompt 上线留一份三段式报告
|
2月前
|
人工智能 JSON 数据格式
OpenAI旧Evals进入退役倒计时:Agent测评别再押在一个平台按钮上
OpenAI旧Evals即将退役,警示团队:评测资产不可绑定单一平台。须独立保存四类核心资产——数据集、评分规则、执行Trace、CI报告,并版本化管理。迁移前需双写校验,聚焦行为证据与诊断标签,确保质量记忆不随平台消失。
|
2月前
|
运维 自然语言处理 算法
pytest 断言管得了代码,管不了「基本可用」:质量人手里的第三张表,为什么决定你在不在决策桌上
本文探讨智能体时代测试范式的根本转变:判据不再源于需求文档,而需测试人员主动构建分场景判定式;被测对象扩展至“评估本身”;跨职能接口统一于同一套可判定标准。核心主张——写清判据,方能定义验收。
|
2月前
|
人工智能 自然语言处理 前端开发
字节用半年让85%的AI用例跑进CI/CD,你的团队还在为“AI生成不能用”发愁?
本文剖析字节跳动NL2Test Agent成功落地的五大关键:聚焦“用例转译”而非替代、先闭环再优化、LLM与程序分工协作、精准治理上下文、优先生成稳定断言。对比失败案例,揭示AI测试成败核心在工程设计,而非模型能力。
|
1月前
|
传感器 监控 算法
IP102农作物害虫检测数据集 | 4400张YOLO智慧农业数据集
IP102农作物害虫检测数据集(5类子集)含约4400张YOLO格式高质量标注图像,覆盖稻纵卷叶螟、豆芫菁等5类主要作物害虫,背景真实、标注规范,适配YOLOv5-v12等主流模型,支撑智慧农业、虫情测报与精准植保研究与应用。(239字)
|
2月前
|
人工智能
AI真人头像生成实践:参考图规范与提示词模板详解
想让AI画出“像自己”的头像?关键不是提示词,而是**一张拍对的参考图**!本文详解5条拍摄规范、两段式提示词结构(身份锁定+场景替换)、4套可直接套用的模板(职场/社交/动漫/古风),并指出80%翻车源于参考图不合格。实操性强,240字内搞定AI真人头像。
AI真人头像生成实践:参考图规范与提示词模板详解
|
1月前
|
人工智能 自然语言处理 安全
Jev:从 DOOM 到自动化测试的 AI Agent 决策模型
TypeSafe AI推出的Jev是首个“系统一模型”(System One Model),专注高频、结构化决策(Choice/Score/Noul),非通用生成式模型。它以低延迟(70–500ms)、低成本($0.042/百万tokens)支持DOOM游戏控制、浏览器自动化、测试失败分类等场景,核心价值在于将复杂推理与轻量决策解耦,提升AI Agent效率与可控性。(239字)
Jev:从 DOOM 到自动化测试的 AI Agent 决策模型
|
1月前
|
人工智能 运维 前端开发
接入多家模型供应商之后,我总结的 7 条铁律
AI 应用接了第二家模型供应商之后,事情就不再是"多加一个接口"那么简单——不是调不通,是钱会算错。这篇讲我们定下来的 7 条规则:幂等键、任务落库时机、备用线路的切换边界、退款、凭据隔离、付款来源固化、密钥不进浏览器。