
排查线上问题时,运维经常遇到同一个用户IPv4和IPv6定位结果不一致的情况。这不是工具出错了,而是IPv4和IPv6在定位逻辑上本身就存在根本性差异。要判断到底是数据问题还是协议本身的差异,需要同时查询两种协议的归属地做交叉比对。 在实际排查中,可以使用支持双栈查询的离线库工具,比如IP数据云,它同时提供IPv4和IPv6的归属地查询能力,帮助运维快速定位差异来源。下面从技术原理到实操排查,完整拆解两者的核心区别。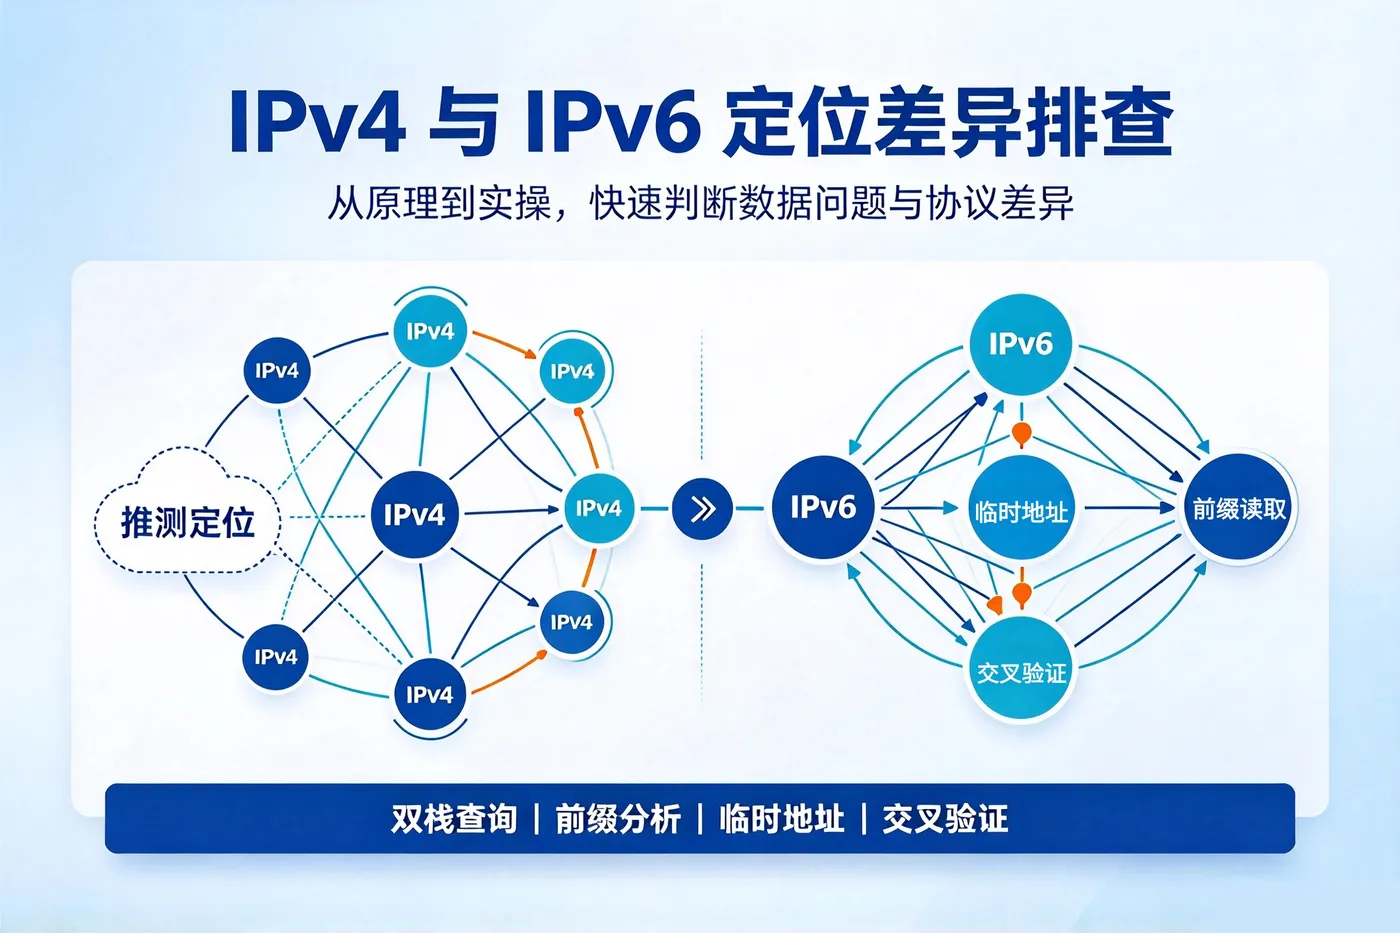
一、为什么同一个用户,IPv4和IPv6定位会不一样?
某电商平台运维团队发现,风控系统对同一笔订单的来源判断出现了矛盾:IPv4地址归属深圳,IPv6地址归属东莞。用户实际在深圳,最终确认是IPv6地址被分配到了东莞的节点。
类似的情况在日常排查中并不少见——IPv4和IPv6的定位逻辑不同,结果自然可能不一致。理解这个差异,需要先搞清楚两种协议在地址分配机制上的根本区别。
二、核心差异:IPv4靠“猜”,IPv6靠“读”
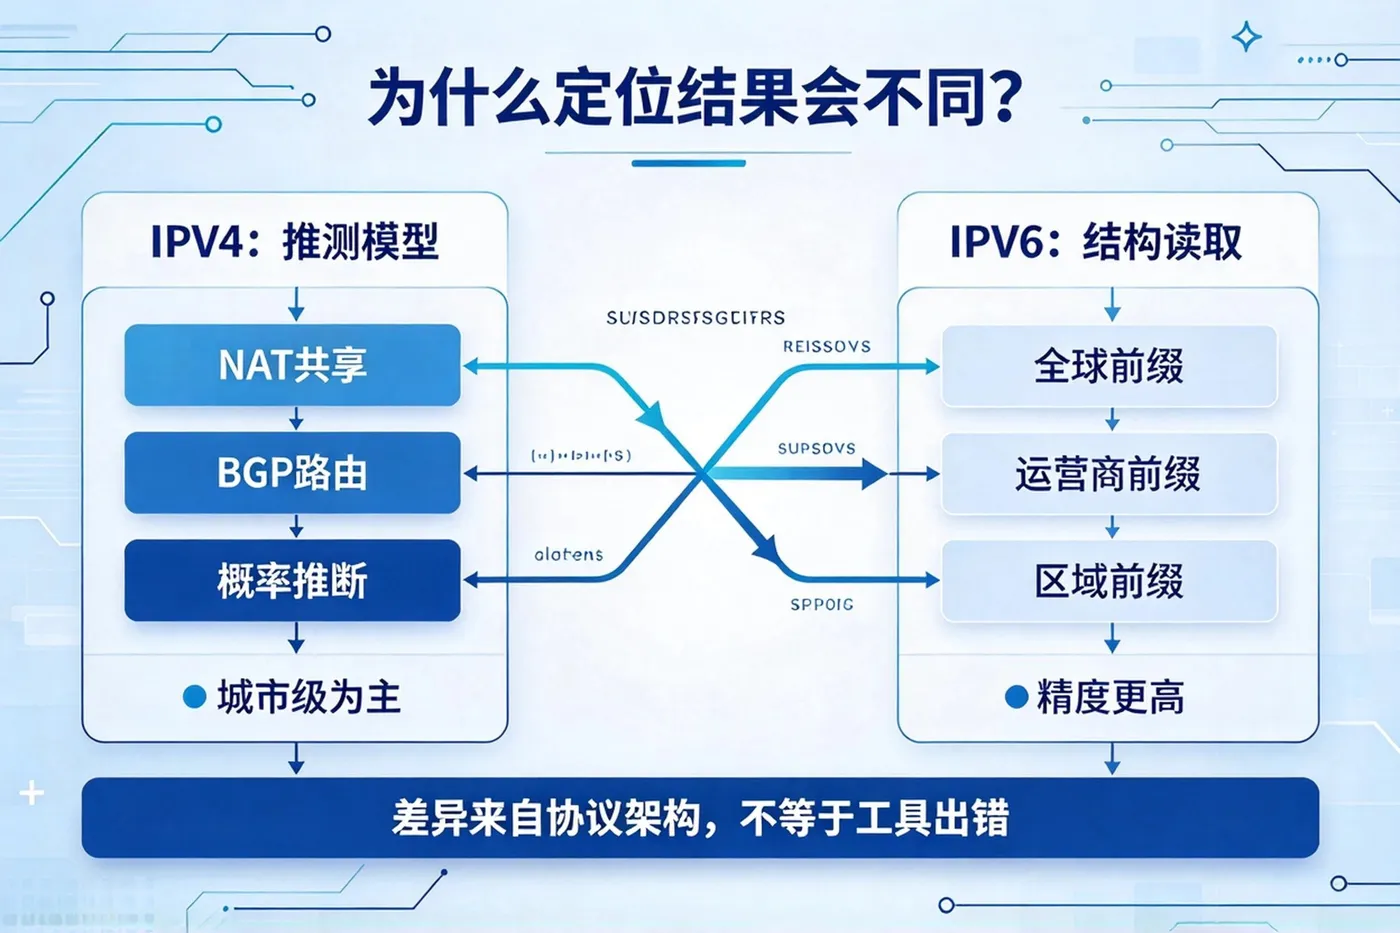
IPv4定位是概率推断。 IPv4地址已经枯竭,运营商和云厂商大量使用NAT,一个公网IP背后可能挂着成百上千用户。定位系统只能通过WHOIS注册信息、BGP路由通告和网络延迟来推测,本质上是在做概率判断,无法精确到真实位置。
IPv6定位是结构读取。 IPv6地址结构自带层次化信息——全球路由前缀(/23)、运营商前缀(/32)、区域前缀(/48)。运营商会按地域分配IPv6地址段,比如把某个/48前缀专门划给一个城市。只要建立前缀与地理区域的映射关系,定位精度天然高于IPv4。
这不是算法更强,而是架构设计使然。
三、关键差异对比
| 对比维度 | IPv4 | IPv6 |
|---|---|---|
| 定位模型 | 推测模型(概率推断) | 拓扑线索(结构自带) |
| 数据来源 | Whois注册信息、BGP路由、主动探测 | 运营商前缀分配、Geofeed订阅 |
| 城市级准确率 | 约87% | 约96% |
| 地址分配 | 按需分配,NAT共享 | 按地域分层分配 |
| 临时地址机制 | 无 | 有(RFC 4941),设备定期生成随机接口标识 |
| 典型误差来源 | NAT共享出口、动态IP | 临时地址漂移、Geofeed覆盖不足 |
| 定位精度天花板 | 城市级为主 | 区县级可达 |
四、实操排查:三步定位差异来源
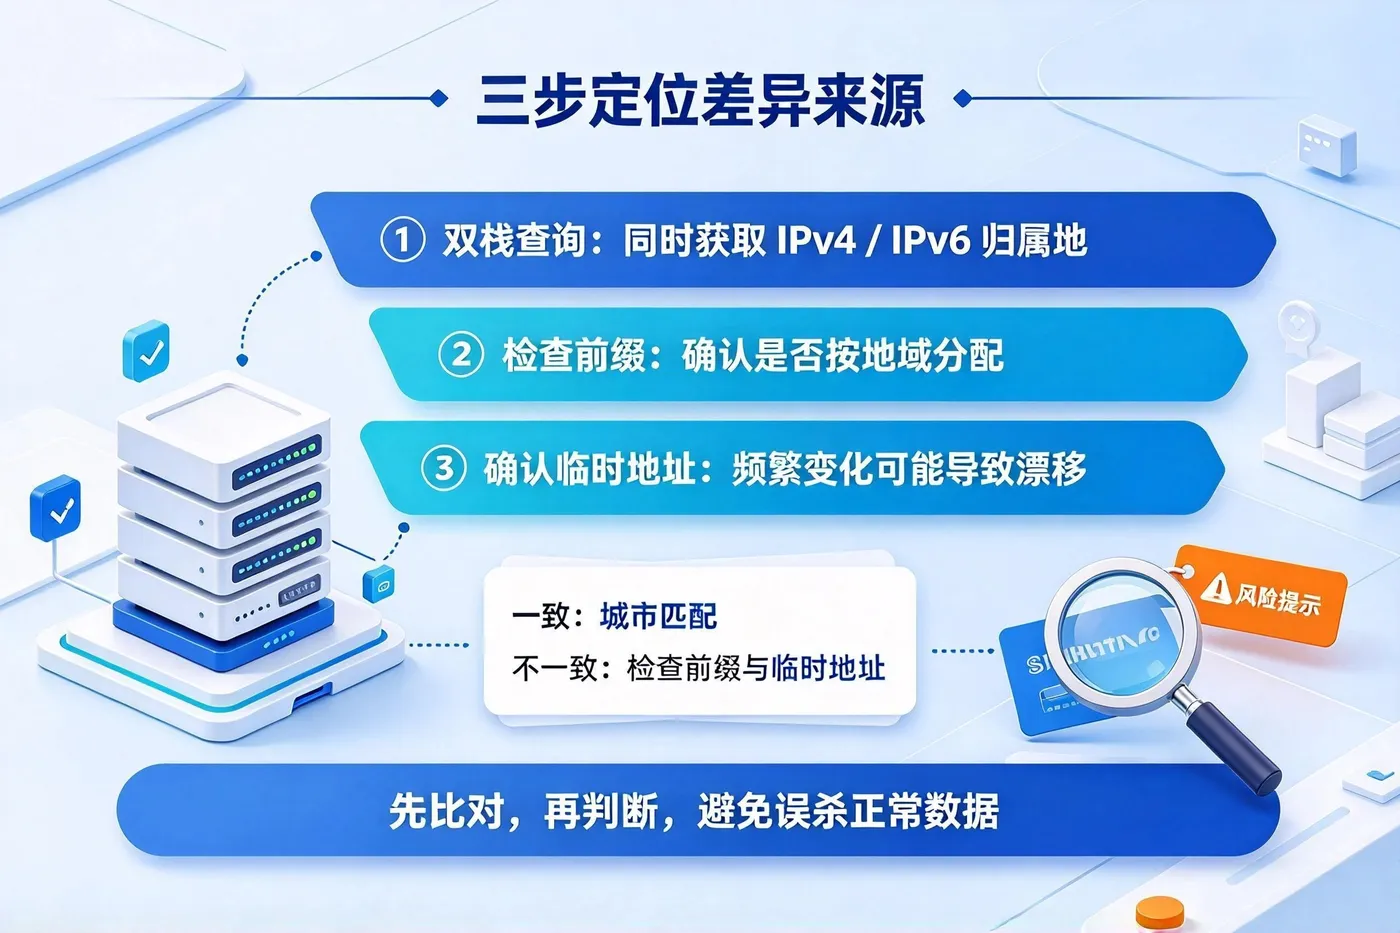
第一步:双栈查询比对
用IP查询工具(IP数据云,IP66等)分别获取IPv4和IPv6的归属地信息,确认两者是否指向同一城市。像这些专业的离线库支持双栈查询,单次调用即可同时获取IPv4和IPv6的定位结果,无需切换工具。
第二步:检查IPv6前缀分配策略
如果IPv6归属地与IPv4不一致,检查该IPv6地址的运营商前缀。部分运营商的IPv6分配策略是“按批次”而非“按地区”,会导致同一城市的用户被分配到不同前缀。
第三步:确认是否为临时地址
IPv6的临时地址机制(RFC 4941)会让设备定期生成随机接口标识。如果地址变化频繁,定位结果也会随之漂移。可以在终端执行以下命令查看:
# Windows
ipconfig /all | findstr "临时"

# Linux/macOS
ip addr show | grep "temporary"
五、不同业务场景下的应对策略
| 业务场景 | IPv4定位策略 | IPv6定位策略 |
|---|---|---|
| 登录风控 | 城市级判断为主,配合设备指纹 | 城市级精度更高,可适当放宽阈值 |
| 支付验证 | 需结合IP风险评分,不单靠归属地 | 区县级精度可用,提高拦截准确率 |
| 广告投放 | 城市级定向为主,区县级需付费增强库 | 城市级精度足够,区县级需校准Geofeed |
| 日志分析 | IPv4/IPv6分开统计,避免混算 | IPv6可前缀聚合后统计,减少误差 |
六、避坑指南
在排查IPv4和IPv6定位问题时,有几个常见误区需要注意。
第一个误区是用IPv4的精度标准要求IPv6。 IPv6的架构不同,城市级精度天然更高,用IPv4的误差预期去评估IPv6,容易误判定位结果不可用。
第二个误区是忽略临时地址机制。 RFC 4941会让IPv6地址定期变化,如果定位结果频繁漂移,可能是临时地址在作祟,而非工具本身的问题。
第三个误区是不区分IPv4/IPv6数据源。 两种协议的数据更新频率不同,混在一起统计会导致日志偏差,决策依据失真。建议在数据管道中分开处理。
七、总结
IPv4和IPv6的定位差异,本质上是“补丁机制”与“原生机制”的区别。IPv4因为地址枯竭和NAT,定位只能靠推测;IPv6因为地址结构自带地域信息,定位可以靠读取。两者的城市级准确率差距接近10个百分点,在高精度风控场景中不可忽视。

