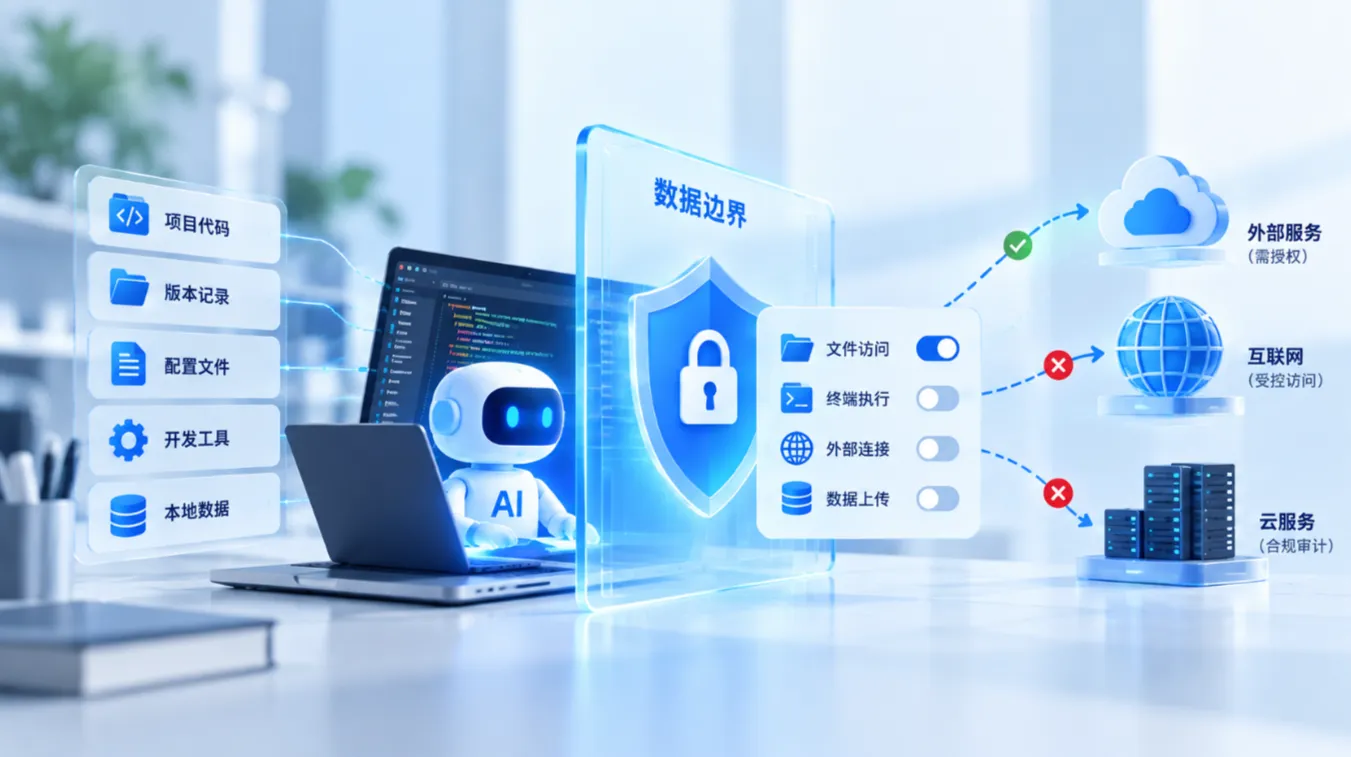
近期,智谱AI编程工具的数据上传问题出现讨论。相关信息显示,AI代码工具在理解项目过程中,可能涉及项目代码、版本记录、配置文件等数据访问。厂商随后回应并对相关功能进行了调整。
这件事带来的启示并不只是某个产品如何设置,而是一个越来越现实的问题:
当AI智能体能够读取文件、执行命令、连接外部服务,企业该如何管理它的数据和权限边界?
01、AI正在成为新的数据访问入口
过去的代码工具主要完成代码补全,如今的AI智能体为了理解整个项目,可能需要访问多个文件、调用终端、读取配置并连接外部服务。
能力范围扩大后,接触到的数据也随之增加。AI工具正在从单纯的效率工具,逐渐成为新的数据访问入口。
02、能访问,不代表可以无限访问
企业代码仓库中不仅包含业务代码,还可能存在历史版本、账号配置、访问凭证及内部系统信息。
因此,企业需要逐步明确:哪些目录可以读取?哪些数据可以发送?哪些操作需要确认?哪些外部连接需要限制?AI使用边界不能只依赖个人判断。
03、权限控制需要跟上AI能力变化
AI智能体获得的文件、终端、账号和外部访问权限,应与实际任务相匹配。
同时,对异常读取、异常上传、权限变化等行为保留必要记录,才能在出现异常时及时发现和追溯。功能越深入业务,权限管理越需要前置。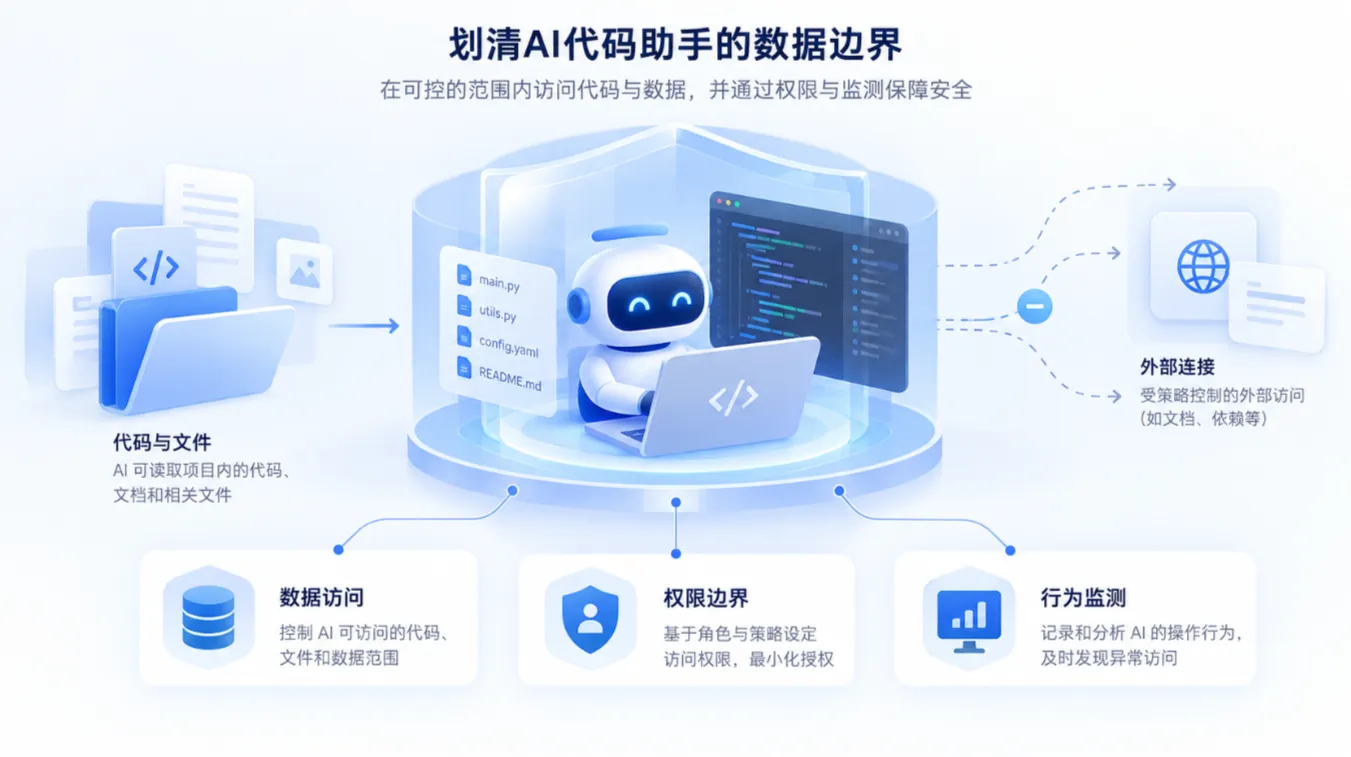
04、AI安全需要从“管工具”走向“管行为”
未来企业很难简单通过“允许使用”或“禁止使用”解决AI安全问题。更实际的方式,是持续关注AI工具的:数据访问、账号权限、终端行为和外部连接。
让AI真正成为生产力,需要做到:权限有边界、数据有范围、行为可追踪、异常能发现。
AI智能体越深入企业业务,数据与权限边界就越需要提前划清。