
先说一个很少被摆到台面上的变化。
以前一个需求上线,中间至少经过四双眼睛:产品看需求对不对、后端看接口合不合理、前端看交互顺不顺、测试看边界有没有漏。
现在,一个人配一套 AI 工具,四双眼睛变成一双。
效率确实高了。但有个问题没人回答:那三双眼睛原来挡住的东西,现在谁挡?
一、评审链条越短,风险越集中
软件工程里有个朴素的共识:缺陷在被写出来的那一环被发现,成本最低;越往后挪,成本越高。
传统分工之所以要设那么多环节,不是因为流程崇拜,是因为每个环节都是一道滤网。产品挡住需求理解错,后端挡住数据模型错,前端挡住交互逻辑错,测试挡住边界情况漏。
这些滤网效率很低——一个需求走完所有环节可能要两周。但它有效。
一个人交付的时候,这些滤网被压缩成了一道。你既是写的人,也是查的人。
问题在于:写的人和查的人共享同一套假设。
你写的时候认为"这个字段不可能为空",查的时候你还是这么认为。你写的时候觉得"这个状态只会从 A 到 B",查的时候你不会去想 C。
这就是一个人交付最真实的处境:不是你不够仔细,是你没有办法对自己不知道的东西产生怀疑。
而 AI 的加入,让这个处境又恶化了一层。
二、"能跑"和"对"之间,有一道缝
Veracode 在 2026 年 3 月发布的春季 GenAI 代码安全更新里,做了一件事:把 150 多个大模型放进 80 个编码任务里,覆盖 Java、JavaScript、C#、Python,然后逐个做安全测试。
结果是两组数字,放在一起看非常有冲击力:
- 95% 以上的生成代码能编译、能运行
- 45% 的生成代码含有已知的安全漏洞
一句话概括:语法层面近乎完美,安全层面接近一半有问题。
这个组合是最危险的那种。因为"能跑"会制造一种强烈的正确感。代码格式工整、命名一致、结构现代,跑起来也没报错——你会自然地认为它是对的。
Sonar 2026 年那份 1149 人的开发者调查里,还有一组数字可以对照着看:96% 的开发者不完全信任 AI 生成的正确性,但只有 48% 会在提交前始终检查。
也就是说,在超过一半的情况下,那 45% 的问题里的一部分,是没人看过就进了仓库的。
一个人交付的时候,这个比例只会更差。不是因为你不负责,是因为你没有一道外部流程逼你停下来看。
三、最危险的时刻不是写错,是"没证据地继续"
把话题再往前推一步。
一个人交付,最怕的其实不是 AI 写错了某一行。写错一行,跑起来会发现,日志会告诉你,改掉就行。
真正麻烦的是另一种情况:上游没定,AI 自己猜了一个,然后顺着这个猜测往下写了两百行。
比如接口设计里没写清楚"停用优惠券"返回什么。AI 猜了一个结构,写了 Service、写了 Controller、写了前端的状态判断。全部自洽,全部能跑。
直到联调那天你才发现,真实的返回不是这个结构。这时候要改的不是一行,是一条链。
这类问题的特点是:它在发生的那一刻完全不可见。
代码是干净的,逻辑是自洽的,编译是通过的。唯一的问题是——它建立在一个从来没被确认过的假设上。
所以在跨层交付里,真正有价值的设计不是"生成得多快",而是在没有依据的地方停下来。
四、宁可卡住,不要硬编
这里有一个做法值得单独拿出来说。
在飞算 JavaAI 的智能会话里,前端开发这条指令对上游产物是强依赖的。如果你当前是个纯后端项目,还没有前端相关的设计文档,它不会自己发挥,而是停下来,提示你回到前后端设计环节把文档补齐,补齐之后才能继续。
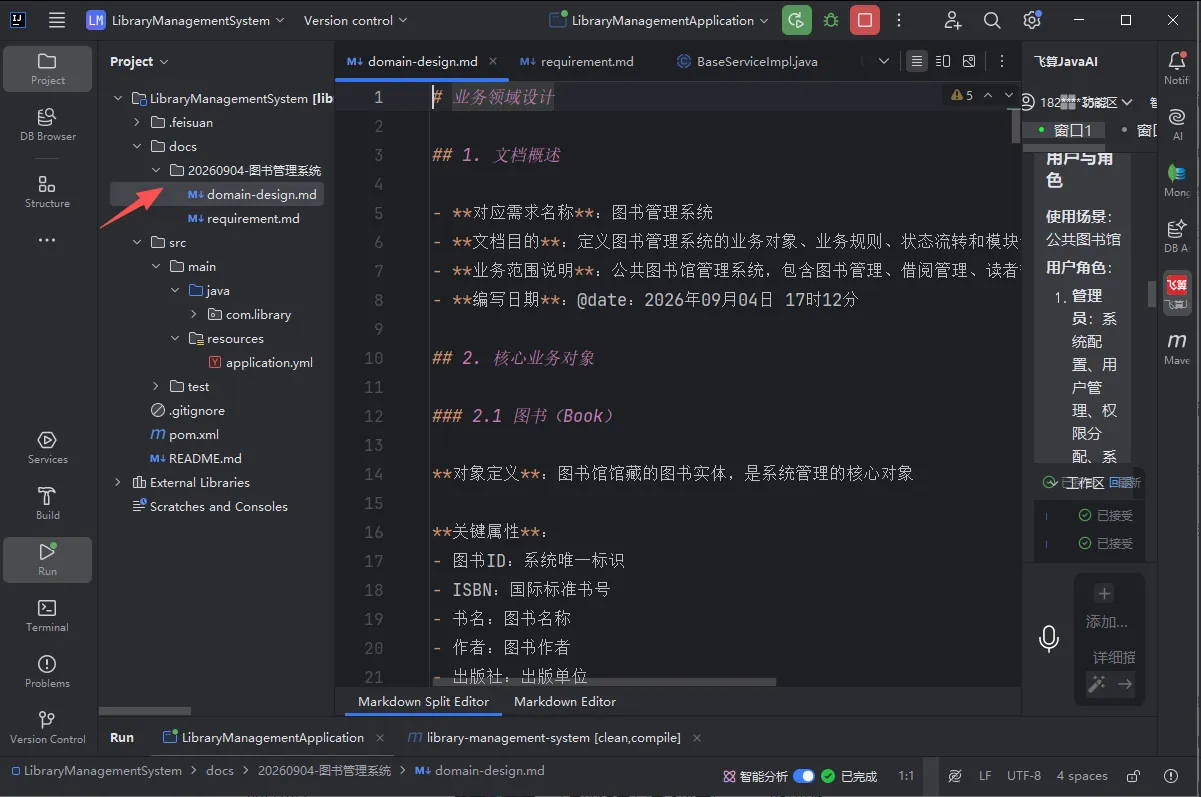
类似的行为在需求分析那条指令上也有:解析原始需求的时候,遇到边界模糊的地方,它会先发起澄清,而不是默认一种理解往下写。
这两处"停下来",是同一件事:在缺少依据的地方,不猜。
这件事的价值,跟"生成能力"不在同一个维度上。生成能力决定你多快看到结果,而"卡住"这个动作决定你看到的结果是建立在确认过的事实上,还是建立在模型的猜测上。
后者在一个人交付的场景里尤其致命——因为你是唯一一双眼睛,如果系统也不提醒你,那个假设就真的没人会质疑。
边界要说清楚:它不替你做代码评审,也不替代安全扫描。Veracode 测出来的那 45%,它不会帮你发现——那是 SAST 工具的活。它做的是更早一步的事:不让缺失的上游产物被悄悄跳过去。
五、一个人交付时,值得守住的三条底线
如果"一个人配 AI 交付一个需求"已经是你现在的工作方式,有三条底线值得守住。
第一条:上游没定的地方,宁可停。
接口没定、表结构没定、需求边界没说清——这时候停下来问,成本是半小时;往下猜,成本可能是两天。
而且猜出来的东西有个特点:它会伪装成已完成的样子,让你在验收前都意识不到有问题。
第二条:把"能跑"和"对"分开验证。
能跑是编译和主流程的事,对是边界、异常、权限、并发的事。前者 AI 已经做得很好了,后者几乎全靠人。
具体到动作:提交前至少过一遍异常分支、权限判断、并发路径。Sonar 那个 48% 的数字说明,大多数人连这一步都没做。
第三条:给自己造一道外部滤网。
一个人交付不代表必须一个人查。最低成本的三种做法:
- 用静态扫描工具兜住能自动查的那部分
- 把关键设计写成文档,哪怕只有你自己看——写下来的动作本身就会逼你重新审一遍
- 在合并前强制自己隔一天再看,隔夜的眼睛比当天的眼睛更接近"别人的眼睛"
六、效率账单的另一半
这两年关于 AI 编程的讨论,绝大多数集中在"提效"这一侧:写得多快、省了多少时间、产能翻了几倍。
这些数字是真的。但一张完整的效率账单有正反两面,现在被反复展示的只有正面。
背面写的是:产出变大的同时,滤网的数量在减少。
LinearB 的数据里,AI 时代的 PR 体积是此前约 2.6 倍,merge 率不到一半。这两件事是同一个现象的两面——一次提交的东西更多了,通过的比例反而低了。
一个人交付把这个趋势推到了极致:产出最大,滤网最少。
所以真正该问的问题不是"AI 能不能帮我一个人交付一个系统"——答案是能,现在就能。
该问的是:当四双眼睛变成一双,你打算用什么补上另外三双?
如果 AI 在一个信息缺失的地方没有停下来,而是自己猜了一个字段名继续写了两百行,你会在哪个环节发现它?
联调那天?测试环境?还是上线之后?评论区说说你踩过的最晚的一次。
