
在数字化业务、大模型推理训练、企业业务系统搭建的场景之下,ECS弹性计算实例是底层算力底座,区别于轻量化套餐化的轻量应用服务器,ECS具备完整的弹性计算能力,支持自定义网络、弹性网卡、多块云盘挂载、灵活升降配,同时衍生出GPU加速实例,专门面向AI推理、模型微调、图像渲染、高性能计算场景。新版ECS实例基于CIPU架构迭代,细分出通用型、内存增强型、存储优化型、GPU虚拟化、GPU物理计算型多个规格族,覆盖个人开发、中小企业业务、大型AI项目等不同层级需求。
本文完整梳理新版ECS普通实例与GPU云服务器的规格划分、计费逻辑、价格区间,附带完整Linux实操命令、性能测试、选型策略以及大量实战踩坑要点,帮助使用者结合业务负载挑选匹配算力,同时合理控制整体算力成本。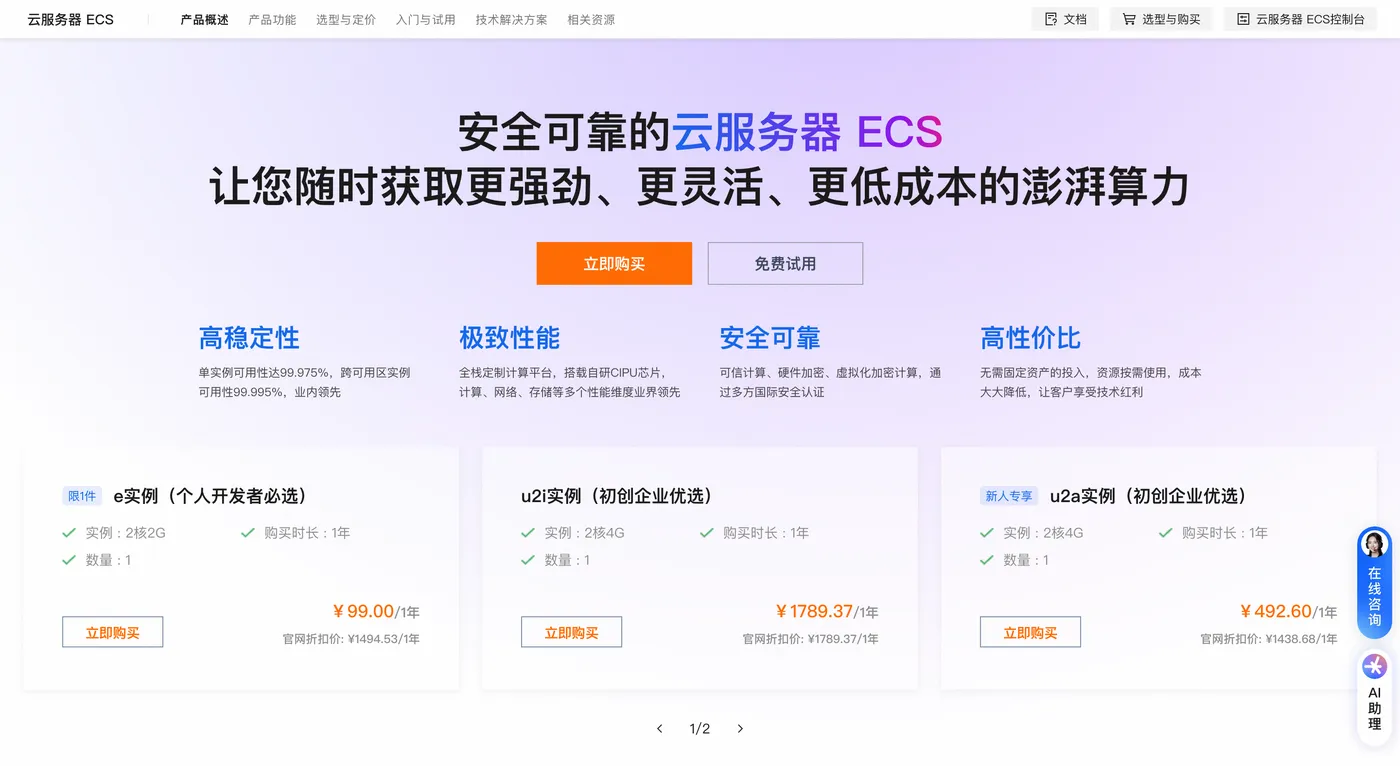
阿里云ECS云服务器 的付费模式分为包年包月、按量付费、抢占式实例三种,不同付费模式适用业务场景完全不同。包年包月属于预付费模式,一次性购买周、月、年周期资源,长期稳定业务优先选择,购买时长越长,单单位算力成本越低,支持设置自动续费,到期前完成续费避免实例释放。按量付费采用按秒计费,随用随销毁,适合临时测试、突发业务峰值,账户需要留存最低余额保障实例正常创建,实例停机之后vCPU内存资源释放,公网IP会发生变化,如果需要保留固定公网IP,需要绑定EIP弹性公网IP。抢占式实例在按量付费基础上提供显著折扣,但是存在被系统回收释放的风险,适合非核心离线任务,不可以用于线上对外提供服务的业务。同时可以搭配节省计划、预留实例券进一步降低长期使用的算力开销,适合企业大规模部署实例的场景。
普通 阿里云ECS云服务器 实例规格族划分清晰,主流通用型g8i、g8ae系列,采用新一代处理器,vCPU内存配比覆盖1:2、1:4,网络支持基础带宽叠加突发带宽,弹性网卡、云盘挂载数量大幅提升,适合Web业务、后端服务、数据库、中间件部署。入门规格2核8G,基础网络带宽3Gbit/s,突发带宽最高可达15Gbit/s,云盘突发IOPS最高20万,适合中小型网站、小程序后端、开发测试环境。4核16G规格,4vCPU搭配16G内存,网络4Gbit/s基础带宽,突发15Gbit/s,能够承载中小型业务系统,部署Redis缓存、MySQL数据库,支撑数万级别的访问请求。8核32G规格面向中型业务,8vCPU、32G内存,6Gbit/s基础带宽,适合多服务混合部署,微服务集群、业务后台系统。16核64G、32核128G属于中大型企业主力规格,具备高收发包PPS能力,支持大量弹性网卡,适合业务流量高、多租户系统、业务集群部署。
内存增强型r8i系列侧重大内存配比,vCPU内存比例1:8,适合内存数据库、缓存集群、大数据分析、日志解析业务,很多需要加载大量数据集做预处理的AI业务,会优先选用大内存实例,避免内存溢出导致进程崩溃。存储增强g8ise实例族优化磁盘IO能力,针对OLTP数据库、NoSQL、日志检索场景,最大化云盘读写性能,支持NVMe协议云盘,挂载多块高速ESSD云盘,满足数据库高IO吞吐需求。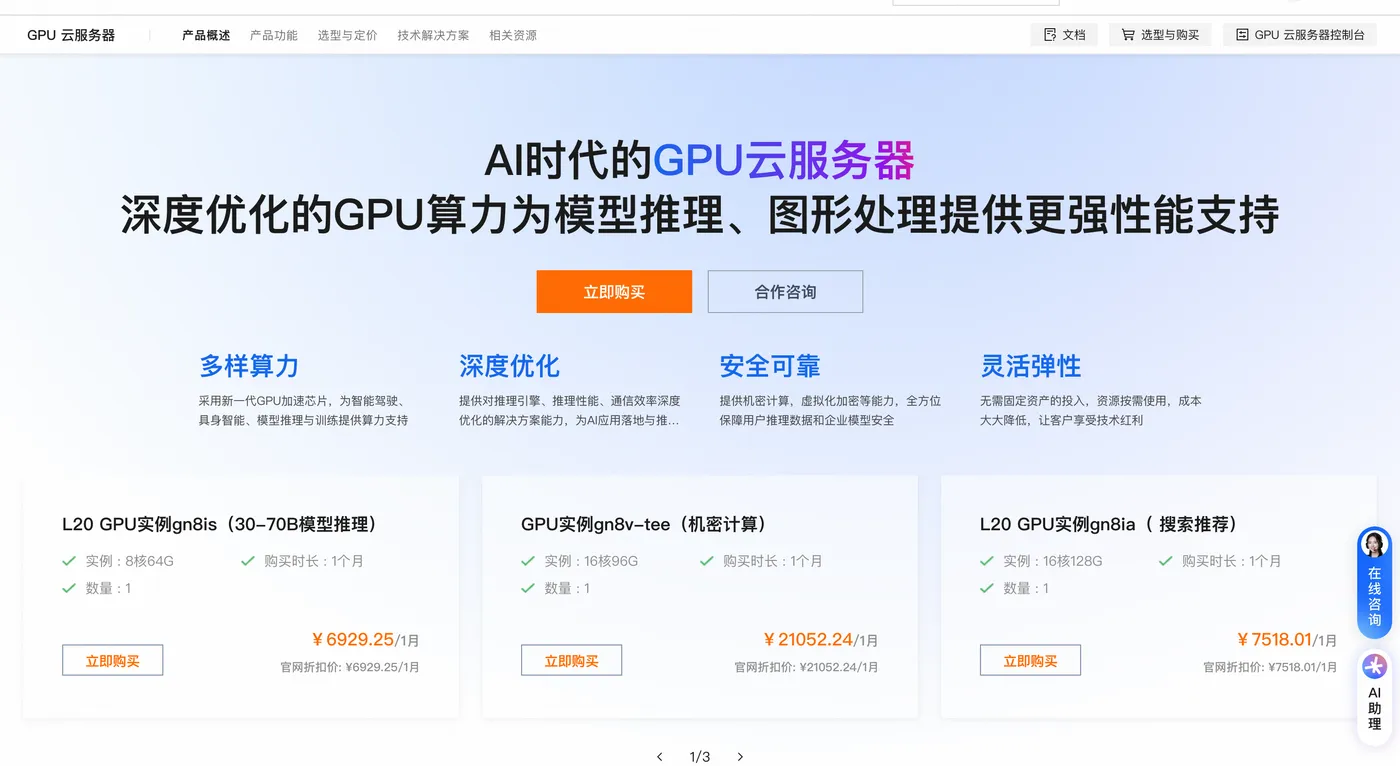
阿里云GPU云服务器 分为GPU虚拟化实例与物理GPU计算实例两大类别。GPU虚拟化实例sgn7i‑vws系列,将单块物理GPU做算力切分,提供1/12、1/6、1/3的GPU显存份额,适合轻量大模型推理、简单AI Agent服务、图形可视化场景,成本更低,不需要占用完整一块GPU卡资源,4核15.5G搭配1/12 A10显卡,24GB显存做切分,足够运行7B参数大模型推理服务,个人开发者、小团队测试大模型接口调用非常合适。
物理GPU计算实例gn8v系列搭载完整独立GPU显卡,完整显存全部交付实例使用,主要面向大模型训练、大规模微调、多并发推理、视频渲染工作流。规格覆盖单卡、双卡、四卡、八卡配置,双卡实例32核192G内存,两块独立GPU,单卡显存96GB,适合70B参数大模型微调、多并发推理;八卡实例64核768G内存,八张GPU,超高显存与算力,用于千亿级大模型预训练、大规模分布式训练任务。不同地域GPU库存存在差异,部分高阶多卡规格不是所有可用区都开放购买,下单前要确认对应地域规格库存状态。
价格层面,普通ECS实例,目录价为标准售价,新用户首购会有大幅度折扣,老用户续费、新购实例一般执行目录标价。2核8G包年包月,年付可以摊薄成本;4核16G、8核32G随着算力提升,整体成本同步上涨。内存增强、存储增强实例,同等vCPU数量下,价格高于通用型实例。GPU实例成本显著高于普通ECS,虚拟化切分GPU实例价格适中,适合个人和小团队;完整物理GPU实例,单卡、多卡规格成本较高,离线训练任务可以优先考虑抢占式GPU实例压低开销,但不能用于线上业务。GPU实例磁盘、公网带宽需要额外选配,系统盘建议至少100GB以上,大模型权重文件体积巨大,磁盘空间预留不足会直接导致任务失败。
计费方面有几个极易踩坑的关键点。第一,阿里云GPU云服务器 实例不管是虚拟化还是物理卡,只要实例处于运行状态,GPU资源持续计费,停机状态下,包年包月实例持续扣费;按量付费实例停机,CPU内存释放,但绑定的云盘仍然会持续计费。第二,公网带宽支持按带宽计费或者按流量计费,高并发业务建议选择按带宽计费,流量波动极大的业务可以选择流量计费,避免高额带宽成本。第三,升降配规则,包年包月实例支持升级规格,补齐差价即可;部分规格不支持直接降配,降配需要重新创建实例迁移业务数据。第四,GPU实例驱动,实例创建完成之后,需要手动部署NVIDIA驱动、CUDA工具套件,镜像没有预装驱动会导致GPU硬件无法识别,很多新手部署大模型服务失败,根源就是缺少对应驱动环境。
拿到全新ECS实例之后,首先完成系统初始化,下面以CentOS Linux操作系统为例,提供全套实操命令,普通ECS实例与GPU实例都可以执行基础初始化操作。登录实例之后,首先更新系统软件源:
yum update -y
关闭系统非必要服务,释放系统资源:
systemctl stop postfix
systemctl disable postfix
systemctl stop sendmail
systemctl disable sendmail
安装基础运维工具,包含网络、磁盘、进程监控组件:
yum install -y wget curl unzip vim net-tools sysstat htop atop
核对实例硬件资源,确认购买规格和实际分配资源一致:
#查看CPU详细信息
lscpu
#查看内存占用
free -h
#查看磁盘分区与容量
df -h
#查看网卡信息
ip addr
对于GPU实例,安装完成NVIDIA驱动之后,执行命令查看GPU硬件识别状态:
nvidia-smi
这条命令可以展示GPU型号、显存大小、CUDA版本、GPU利用率,如果命令提示不存在,代表驱动没有正确安装,需要完成驱动部署之后再运行大模型相关业务。
日常运维排查,htop工具直观查看CPU内存进程负载,定位高占用进程:
htop
atop工具持续采集系统全维度指标,记录历史负载情况,适合排查间歇性卡顿问题:
atop 2 10
参数含义为每2秒采集一次,一共采集10次输出报告。
磁盘性能测试,使用fio工具测试ESSD云盘读写性能,注意:禁止在存有业务数据的系统盘直接执行压测,建议使用全新空数据盘开展测试,防止数据损坏丢失。安装fio工具:
yum install -y fio
4K随机读性能测试:
fio --name=ecs_rand_read --ioengine=libaio --rw=randread --bs=4k --size=2G --numjobs=8 --iodepth=64 --runtime=60 --time_based --direct=1
4K随机写性能测试:
fio --name=ecs_rand_write --ioengine=libaio --rw=randwrite --bs=4k --size=2G --numjobs=8 --iodepth=64 --runtime=60 --time_based --direct=1
重点观察IOPS与平均延迟数值,IOPS越高、延迟越低,磁盘性能越好,数据库、大模型文件读取业务对磁盘IO非常敏感,如果IOPS过低,会出现模型加载缓慢、数据库查询卡顿现象。
内存压力测试工具sysbench,用于验证实例内存读写吞吐,压测操作务必避开业务高峰期,测试实例优先使用测试机,不要直接跑在线业务实例:
yum install -y sysbench
sysbench memory --memory-block-size=1M --memory-total-size=200G run
业务选型环节,很多使用者分不清普通ECS、GPU虚拟化实例、物理GPU实例该如何选择。普通ECS实例没有GPU硬件,适合Web、后端、数据库、中间件业务,如果要运行大模型,只能调用外部API接口,不能本地加载模型权重。GPU虚拟化切分实例,适合7B及参数规模的大模型推理、AI Agent服务,预算有限,不需要完整GPU显存资源的开发测试场景。物理完整GPU实例,适合34B、70B乃至更大参数模型的本地部署、模型微调、训练任务,对显存、算力有硬性要求的业务。
不同业务场景配置选型建议。中小型Web与企业后台业务,通用型g8i系列,4核16G起步,搭配ESSD云盘,足够承载常规业务访问;数据库业务,优先存储增强实例,提升磁盘IO,8核32G起步;大数据预处理、数据集加载,选择内存增强大内存实例;7B参数大模型推理测试,GPU虚拟化实例,切分1/6或者1/3显卡资源;70B大模型推理,单张完整物理GPU实例;模型微调训练,双卡及以上GPU实例。
同时要认清阿里云ECS云服务器 以及GPU实例的产品边界。ECS支持弹性网卡、多块云盘、自定义VPC网络,能力远高于轻量应用服务器,但也要注意限制,抢占式实例会随机回收,严禁线上业务使用;GPU实例的CUDA版本、驱动版本需要和运行的大模型框架版本匹配,版本不匹配会直接报错;多卡GPU实例对PCIe带宽有依赖,分布式训练业务需要关注实例内部互联带宽;按量付费实例,忘记释放会持续产生账单,闲置实例需要及时释放。
新手高频踩坑点整理。第一,GPU实例下单之后不安装驱动,直接部署大模型,程序报错无法识别GPU设备;第二,模型权重文件体积巨大,磁盘空间预留不足,运行过程中磁盘占满,任务崩溃;第三,混淆抢占式实例能力,线上业务使用抢占式GPU实例,业务中途实例被回收;第四,按量付费实例测试完成忘记释放资源,长时间闲置产生高额账单;第五,带宽选型失误,大模型推理返回大量数据流,公网带宽不足,接口请求响应缓慢;第六,不做快照备份,实例误操作、磁盘故障,业务数据丢失,重要业务定期创建快照,关键数据同步到对象存储。
保姆级落地操作步骤,购买实例之后,第一步配置密钥登录,关闭密码登录,提升服务器安全等级;第二步安全组只放行业务需要端口,不必要端口全部拒绝访问;第三步阿里云GPU云服务器 实例优先部署对应版本NVIDIA驱动、CUDA环境,执行nvidia‑smi确认硬件识别;第四步配置云监控告警,CPU、内存、磁盘使用率设置告警阈值,同时监控GPU显存占用;第五步创建磁盘快照,重要业务定期备份;第六步测试完成之后,按量付费、抢占式实例及时释放资源。
日常运维中,查看磁盘占用,避免磁盘满导致业务异常:
df -h
查看系统内存、CPU整体负载:
top
GPU实例持续监控GPU显存以及算力占用,观察模型运行负载情况:
watch -n 2 nvidia-smi
watch命令每2秒刷新一次GPU状态,可以直观看到每张卡显存占用、GPU利用率,方便调试大模型推理任务。
当业务规模持续扩张,阿里云ECS云服务器 支持变更实例规格,升级vCPU内存,普通实例和GPU实例之间不能直接互相转换规格。如果业务从普通计算业务转变为本地大模型业务,需要重新购买GPU实例,迁移业务代码、模型权重、数据文件。对于长期稳定的AI项目,包年包月GPU实例成本可控;对于短期实验、调参测试,优先使用按量付费,测试结束立刻释放实例;离线非核心训练任务,使用抢占式实例降低算力开销。
综合新版配置与价格来看,ECS普通实例提供灵活通用的计算底座,GPU云服务器补齐AI算力缺口,规格覆盖从轻量切分显卡到多卡高阶物理GPU,满足从原型开发到正式生产的全链路需求。选型的时候,不能只看硬件规格,需要结合业务的CPU需求、内存大小、显存需求、磁盘容量、网络带宽,预估业务峰值负载,预留20%‑30%资源冗余。同时做好监控告警、快照备份、闲置资源及时释放,规避不必要的账单风险,就可以充分发挥ECS与GPU实例的算力价值,支撑Web业务、数据库、大模型推理训练等各类业务落地。
