嗨,我是小华同学,专注解锁高效工作与前沿AI工具!每日精选开源技术、实战技巧,助你省时50%、领先他人一步。👉免费订阅,与10万+技术人共享升级秘籍!
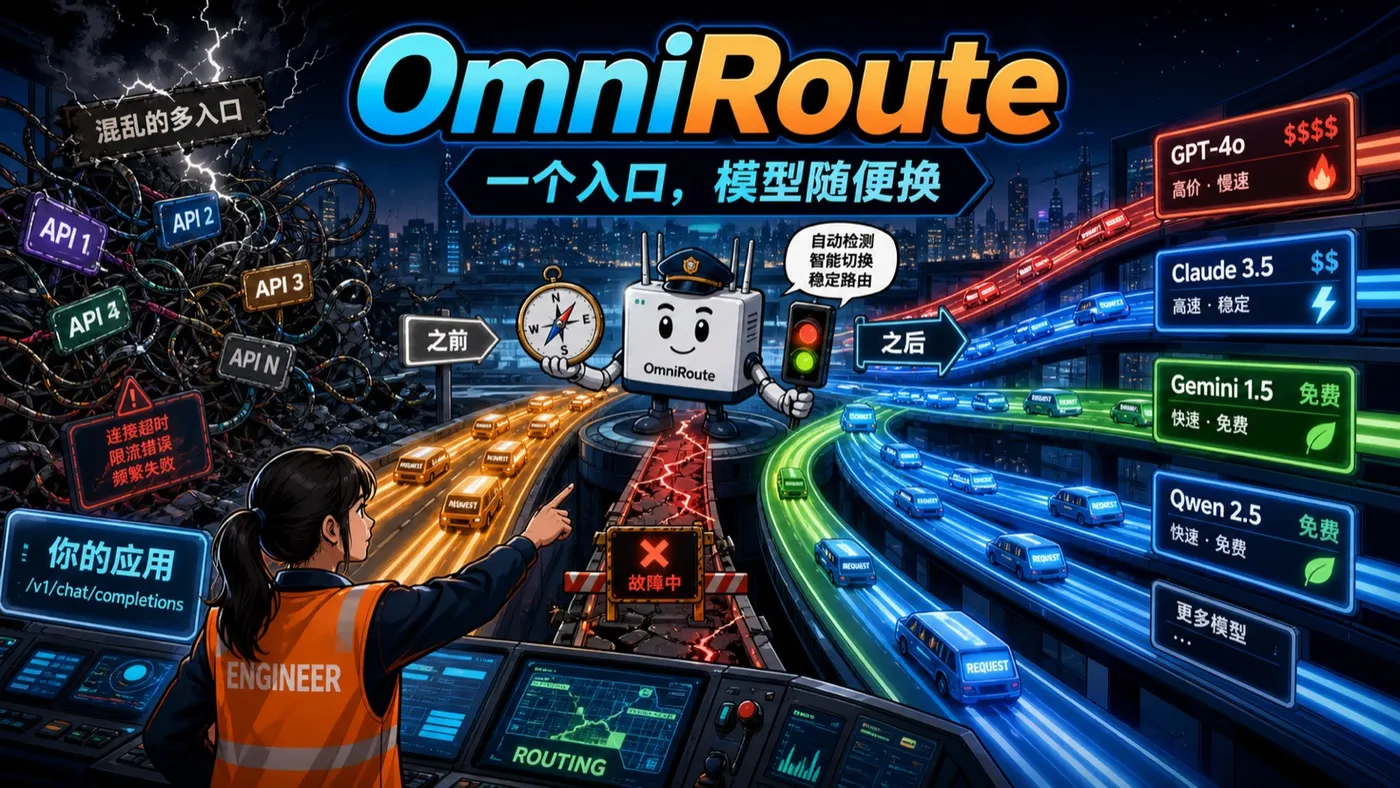
现在接一个 AI 工具,常常要配一套 API;换一个模型,又要改一遍 Base URL、模型名和鉴权逻辑。
更麻烦的是,额度会耗尽、接口会 429、供应商会超时,最强模型也不一定永远在线。
OmniRoute 的思路很“硬核”:应用只认一个 OpenAI 兼容入口,背后的模型、账号、免费层和故障转移交给路由层处理。
这篇用 3 分钟讲清楚:它为什么不只是一个代理,而是在给多模型应用补一层真正的路由基础设施。
OmniRoute 是什么
一句话:OmniRoute 是一个本地优先的开源 AI Gateway,把多家模型供应商统一到一个入口。
截至本次核对,项目 GitHub 约有 2.9 万 Star。官方 README 描述它支持 290+ providers、500+ models、90+ free tiers,并兼容 Claude Code、Codex、Cursor、Cline、Copilot、OpenCode 等工具。
| 你遇到的问题 | OmniRoute 的处理方式 |
|---|---|
| 每个工具都要单独接模型 | 统一使用 http://localhost:20128/v1 |
| 供应商太多,不知道选谁 | auto、cheap、fast、coding、offline 等组合 |
| 某个接口额度耗尽或报错 | 自动切到下一个可用目标 |
| Tool 输出太长,Token 消耗高 | RTK + Caveman 堆叠压缩,README 标称节省 15%-95% 的适用 Token |
| 想把网关接进 Agent | MCP、A2A、CLI 和 OpenAI 兼容 API |
它解决的不是“模型少”,而是接入太乱
很多团队的模型接入代码最后会变成这样:
if provider == openai;if provider == anthropic;if quota_exhausted;if request_timeout;- 再补一套模型名转换、鉴权、重试和降级。
问题不在于你不会调用模型,而是模型供应商的变化不应该污染业务代码。
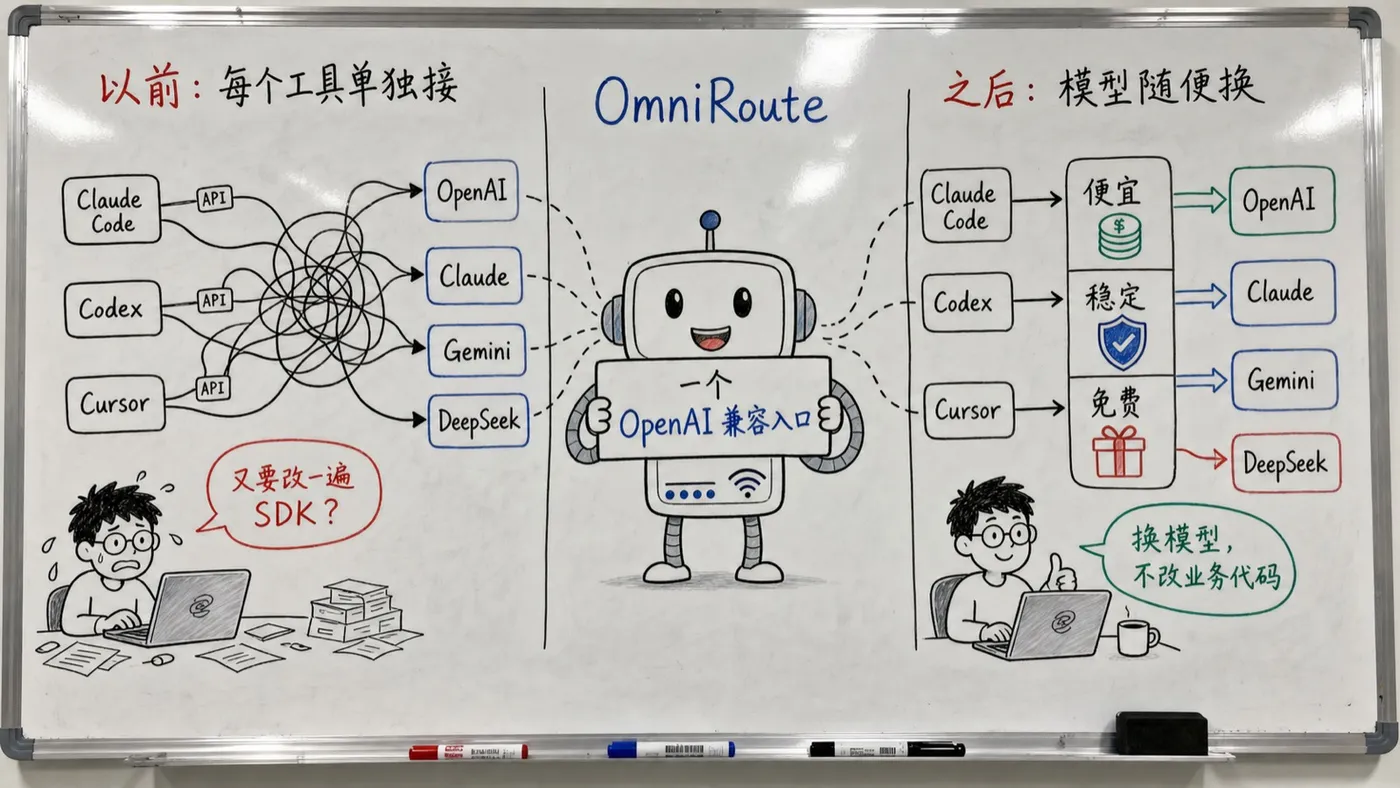
OmniRoute 把这层变化收进了网关:上游工具只需要对着一个本地地址发请求,路由层再决定到底走 OpenAI、Claude、Gemini、DeepSeek,还是某个免费供应商。
一次请求,怎么自动选路
可以把 OmniRoute 的工作过程理解成五步:
- 工具发请求:Claude Code、Codex、Cursor 或你的业务服务调用统一入口。
- 压缩上下文:对工具输出和长上下文做可选压缩,减少无效 Token。
- 读取组合策略:根据
auto、成本、速度、代码质量或剩余额度选择路线。 - 执行与故障转移:当前目标遇到 429、超时或额度耗尽,就尝试下一个目标。
- 返回统一响应:上游工具不需要知道这次到底用了哪家供应商。

项目把多个目标组合成 Combo。官方 README 当前列出了 19 种路由策略,包括 priority、round-robin、weighted、cost-optimized、headroom、context-optimized、cache-optimized、lkgp 和 auto 等。
这意味着你可以把“质量优先、成本优先、速度优先、额度优先”从一堆散落的 if-else,变成可配置的路由策略。
为什么程序员值得关注
1. 对客户端保持 OpenAI 兼容
兼容入口是它最实际的价值。很多工具只要支持自定义 Base URL,就能接入 OmniRoute,不必为每个模型供应商单独改客户端。
2. 把故障转移放到基础设施层
模型服务不是永远稳定的。把重试、冷却、Fallback、Circuit Breaker 和额度判断放在网关层,业务服务就不用重复实现一遍。
3. 把成本和上下文也纳入路由
它不只按“谁能回答”来选模型,还可以考虑价格、延迟、上下文大小、缓存命中和剩余配额。RTK+Caveman 压缩也更适合工具输出很长的 Coding Agent 场景。
4. 本地优先,工具入口统一
项目支持 npm、Docker、Electron、PWA、Termux 和 ARM 环境,数据目录和控制台可以留在自己的机器上。它还提供 MCP Server 和 A2A 协议,方便继续接入 Agent 工作流。
先别急着把“免费”理解成永久免费
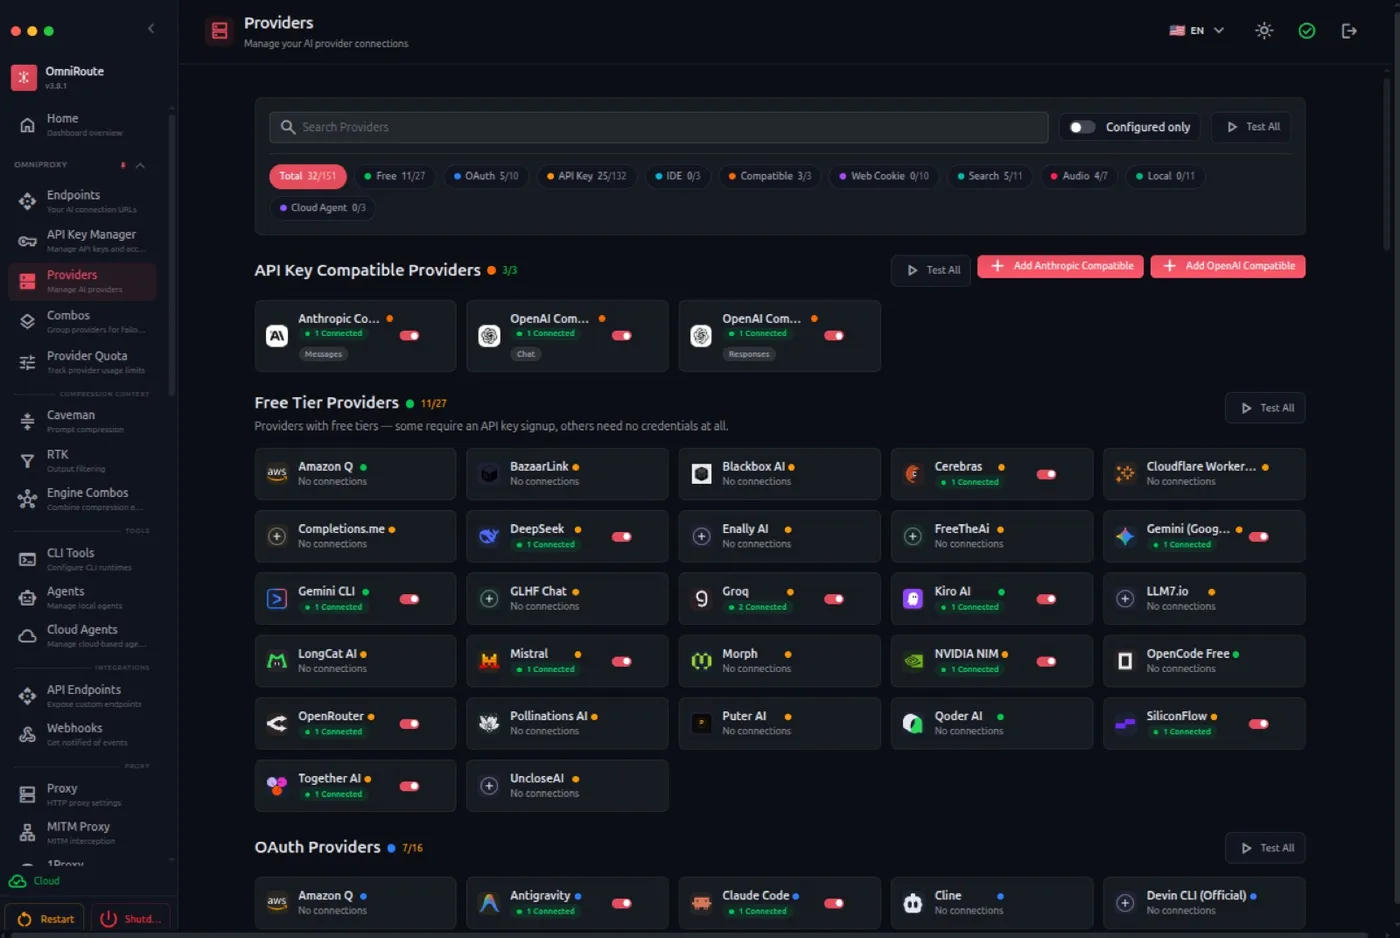
OmniRoute 的 README 汇总了大量免费层和免费供应商,但这里有一个必须说清楚的边界:免费额度属于供应商条款,不是 OmniRoute 自己创造的无限资源。
额度、模型、地区限制和服务条款都可能变化。更稳妥的理解是:OmniRoute 帮你把这些入口统一管理,并在可用时做更合理的调度,而不是承诺每个模型永远免费。
同样,自动故障转移也不能保证所有请求都成功。不同模型的上下文窗口、工具调用、视觉能力和协议细节并不完全一致,生产环境仍然需要做模型能力白名单和真实链路测试。
3 分钟启动体验
官方 README 提供 npm 全局安装方式:
npm install -g omniroute
omniroute
启动后,默认访问 http://localhost:20128。如果只是快速验证,可以直接调用统一入口:
curl http://localhost:20128/v1/chat/completions \\
  -H "Content-Type: application/json" \\
  -d '{"model":"auto","messages":[{"role":"user","content":"Hello!"}]}'
然后再把 Claude Code、Codex、Cursor 或自己的服务指向 http://localhost:20128/v1。建议先用一个模型和一个简单请求跑通,再逐步启用免费层、压缩和复杂 Combo。
小华的判断
OmniRoute 最值得借鉴的地方,不是“它接了多少模型”,而是它把模型供应商变化隔离在了路由层。
对于个人开发者,它可以减少多套 API 配置;对于 Agent 产品,它更像一层模型调度和韧性基础设施;对于团队,它还可以继续研究额度、成本、审计和模型能力白名单怎么落地。
如果你正在做 Coding Agent、AI 网关或多模型应用,下一篇可以继续拆 OmniRoute 的 Combo 配置、Fallback 链路和压缩策略,看看它到底是怎么把“模型随便换”做成工程能力的。