背景
正如前文《非结构化数据,为什么是Dataphin?》提到,企业内部 80% 以上的数据都以非结构化形态存在,从这些数据中挖掘有用的知识和数据是AI时代下所有企业都绕不过的命题。
Dataphin 的非结构化数据处理能力,已经支持两种形态的处理工作流:
- 离线工作流(V6.1):定时调度、批量治理,把散落的文档、图片、音视频批量加工成可被 RAG/Agent 消费的知识资产;
- 实时工作流(V6.2):事件驱动、流式处理,数据一更新就持续消费、持续加工。
但还有一类诉求,前两种模态都覆盖不到——业务系统需要"来一个、处理一个、秒级或者分钟级拿结果",设想如下场景:
- 门店销售在接待完客户后,期望可以快速拿到接待录音的AI分析结果,比如客户的购买意愿、提及竞品等;
- 企业内销售用户在业务系统里上传一份合同草稿,希望可以快速知道其中的问题;
- 客服系统收到一张工单图片,希望一键诊断识别异常数据,并给出应对方案;
- 企业定制知识库系统,期望针对不同模态定义和自己业务相关的解析流程,上传文件后自动解析。
这些场景的共同点是——处理逻辑不复杂,但必须即时响应,且由上游业务系统按需触发。用离线批处理来做,就得"攒一批、半夜跑",业务方拿不到即时结果;用实时工作流来做,又要额外架设 Kafka 事件通道,对一个"请求—响应"式的调用而言过重。
基于此,Dataphin 在 V6.3 版本中推出“在线工作流”——让已经编排好的非结构化处理流水线,一键暴露为 HTTP API,随叫随到。
工作流类型 |
适用场景 |
举例场景 |
离线工作流 |
定时调度、批量处理历史存量数据 |
|
实时工作流 |
事件驱动、持续处理源源不断的增量数据流 |
|
在线工作流 |
按需调用、即时响应一次具体的业务请求 |
|
功能介绍
Dataphin 将在线服务能力具象化为两个协同的概念:API 数据集(契约层) 与 在线工作流(编排层),分别对应"对外接口长什么样"与"接口背后怎么算"。
2.1 API 数据集
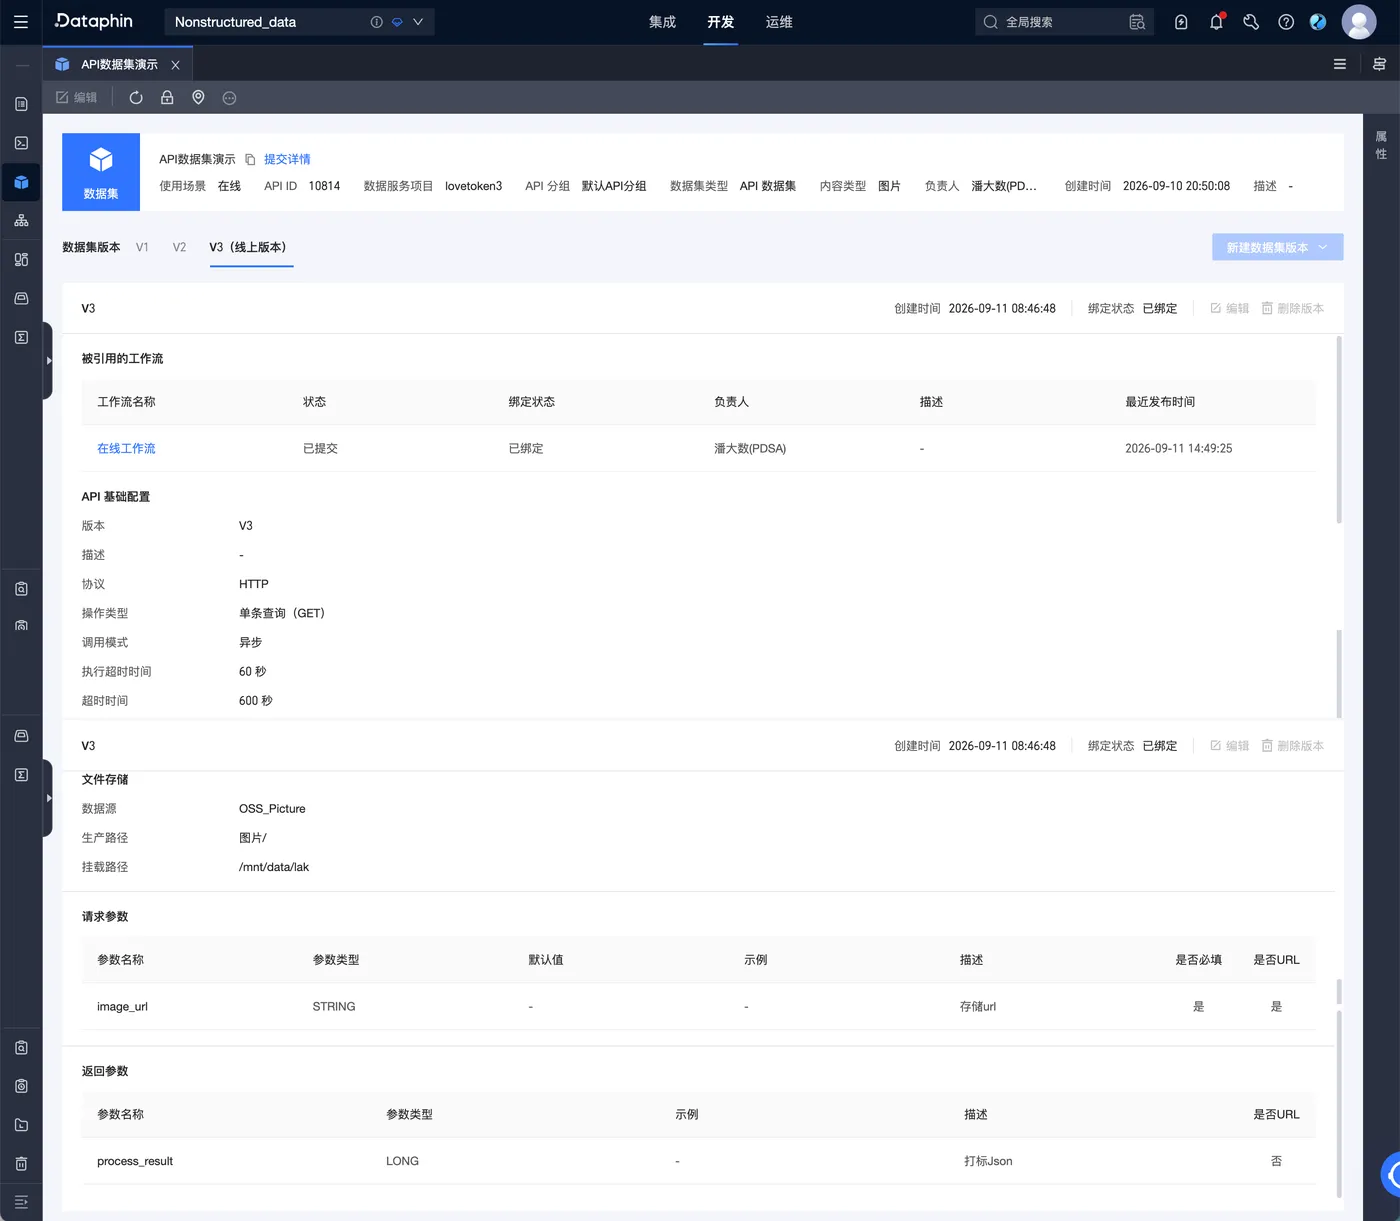
API 数据集是一种全新的数据集子类型,专门承载 HTTP API 的对外契约:
- 调用模式:同步调用 / 异步调用,按业务节奏选择;
- 请求参数结构:声明每个入参的位置、类型、默认值、是否必填、是否为文件 URL;
- 返回参数结构:声明返回字段的取值路径与类型;
- API 路径自动生成:提交后由系统按全局唯一 API ID 生成调用地址,用户无需也不应手动管理路径,避免路径冲突与治理混乱;
- 版本级绑定:一个 API 数据集版本与一个在线工作流 1:1 强绑定,接口与后端一一对应,路由确定性强。
2.2 在线工作流:画布编排,一键成 API
在线工作流是计算任务的一种全新子类型,与“离线工作流”、“实时工作流”并列,承载接口的执行编排:
- 选 API 自动生成首尾节点:创建时在属性面板选择已提交的 API 数据集及其版本,系统自动生成「API 请求」根节点与「API 响应」叶节点,无需手动拼装;
- 复用全套非结构化算子:在画布上拖入解析、分块、Embedding、LLM 推理、图片打标等算子,与离线/实时工作流用的是同一批算子,编排心智完全一致;
- 字段映射打通契约:在请求节点配置入参如何注入算子,在响应节点配置返回字段从哪里取值,把"接口契约"与"处理逻辑"精准对齐;
- 提交即注册后端:工作流提交时自动注册为该 API 的后端,接口从"未就绪"变为"可调用",无需额外部署动作。
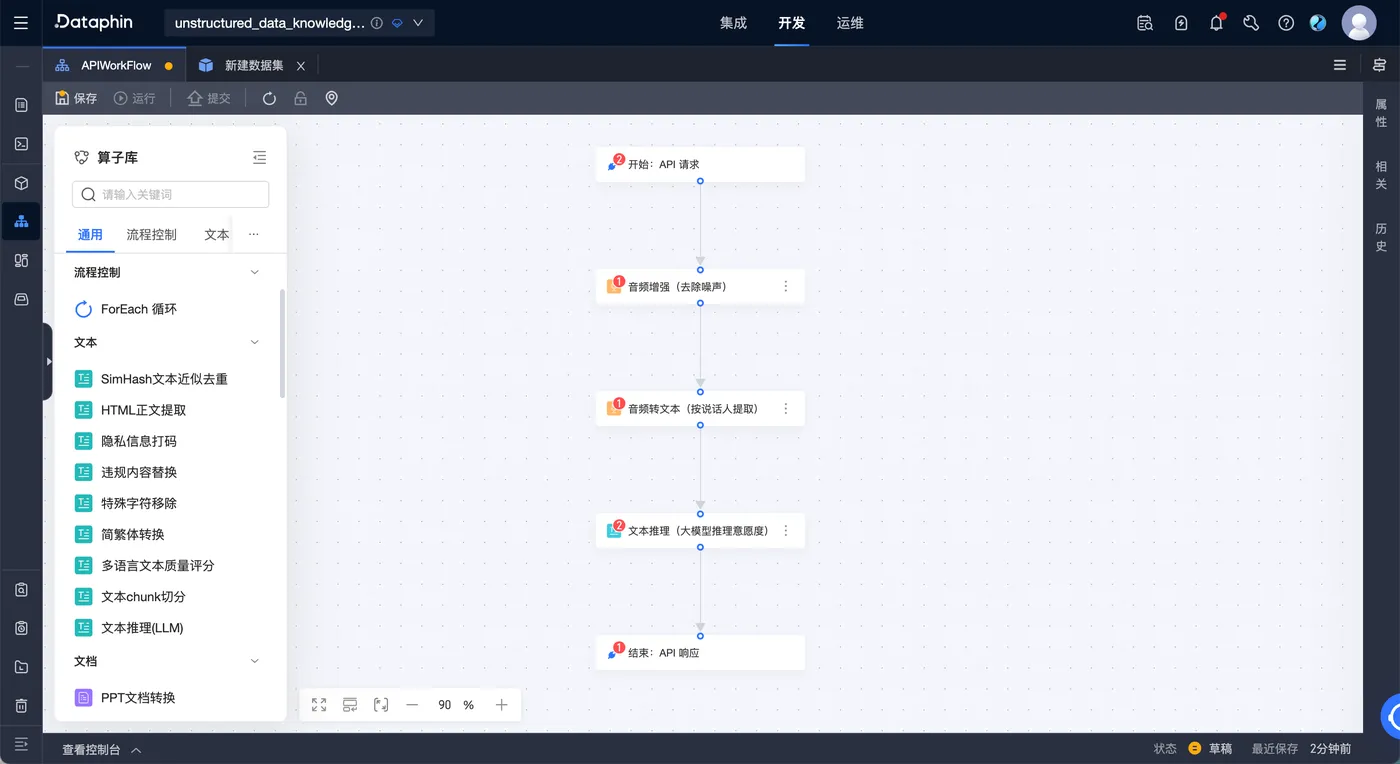
(场景01:销售场景音频分析)
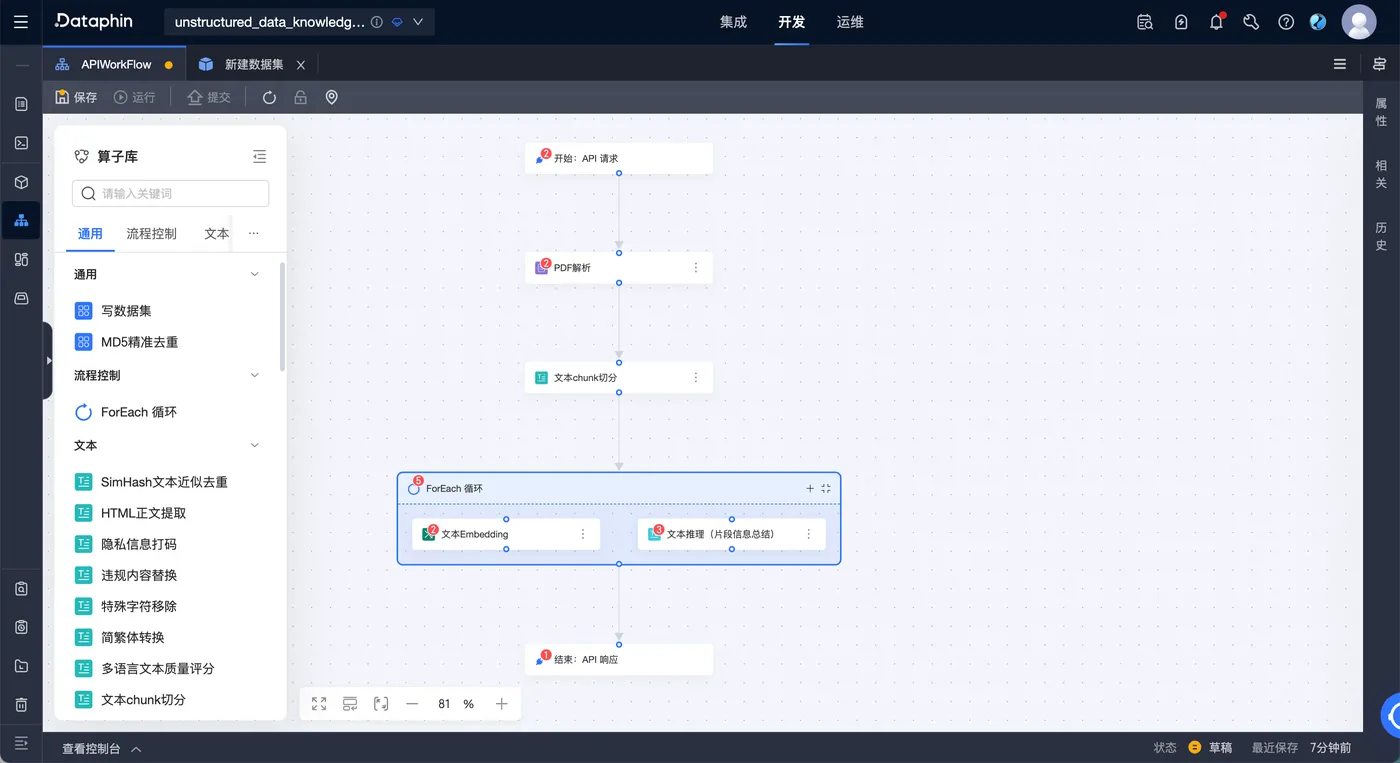
(场景02:文档解析与向量化)
使用步骤详解
3.1 创建API数据集
- 创建使用场景为“在线”的数据集,API ID由系统自动生成,无需填写
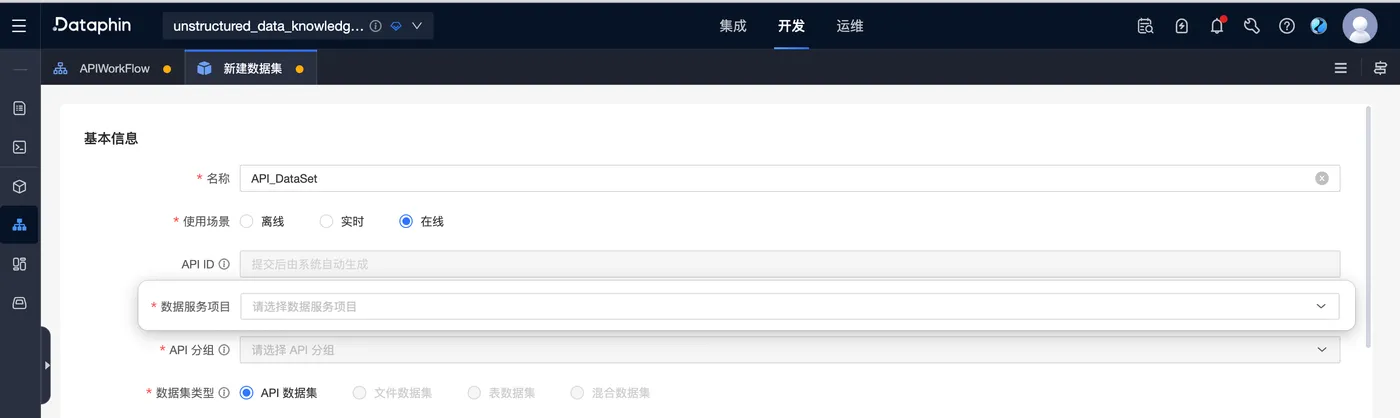
- 数据服务项目:
- 创建API数据集后,会自动在数据服务的项目中创建一个API,所以此处需要选择一个数据服务项目
- 请前往【数据服务】-【服务管理】页面,选择一个项目,并点击成员管理
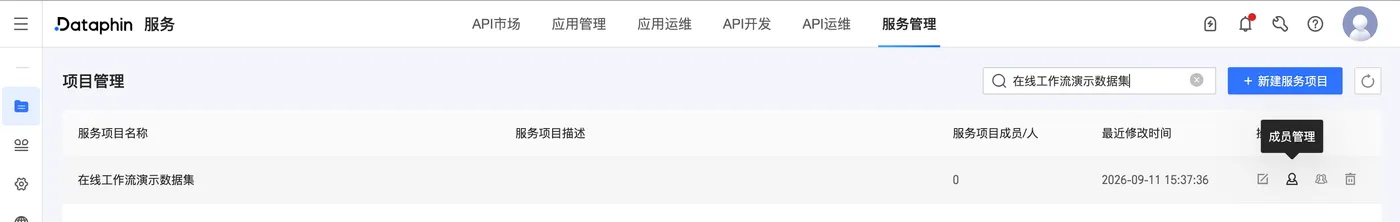
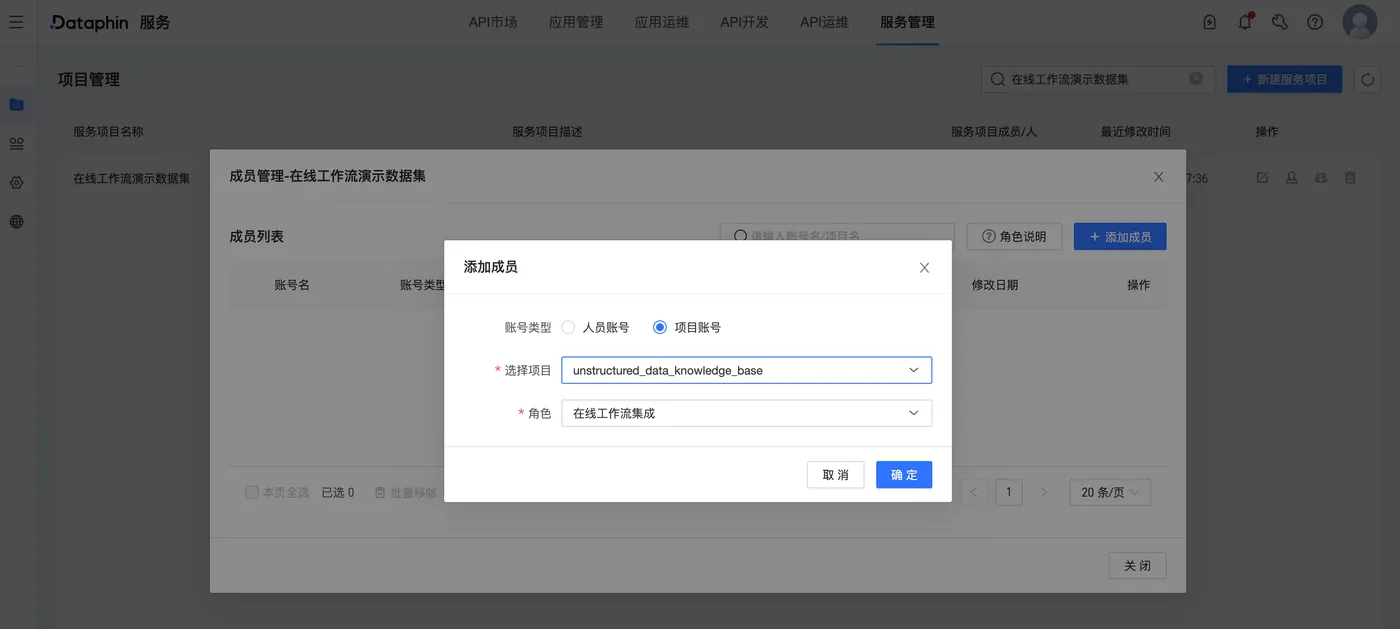
- 将数据集所在研发项目添加到数据服务项目并分配角色“在线工作流集成”,即允许该项目在所选服务项目中创建API
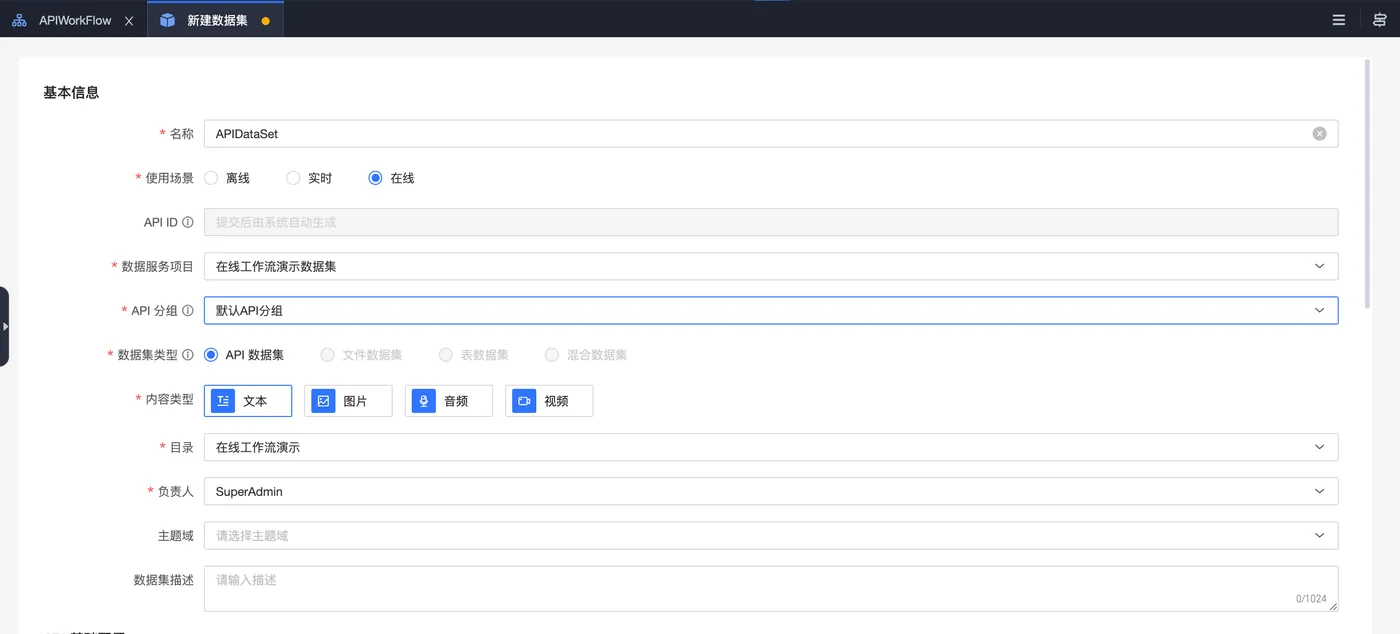
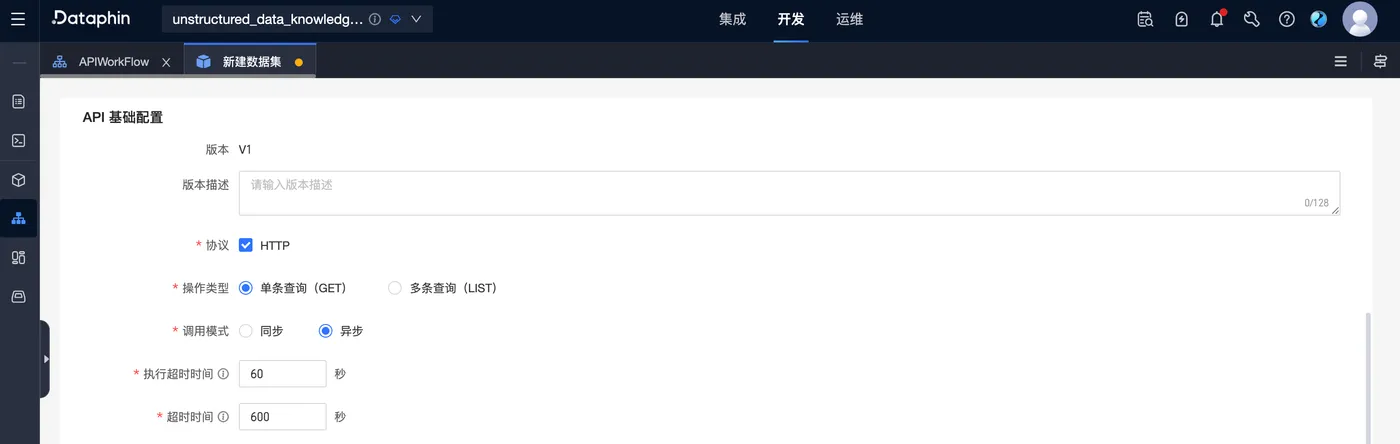
- 完成API基础配置
- 本文以“单挑查询”+“异步调用”作为演示,您可按需配置执行超时时间和超时时间
- 执行超时时间:API数据集所绑定工作流运行的最长时间
- 超时时间:从调用API到异步获取结果的最长间隔
-
- 选择文件存储和配置参数
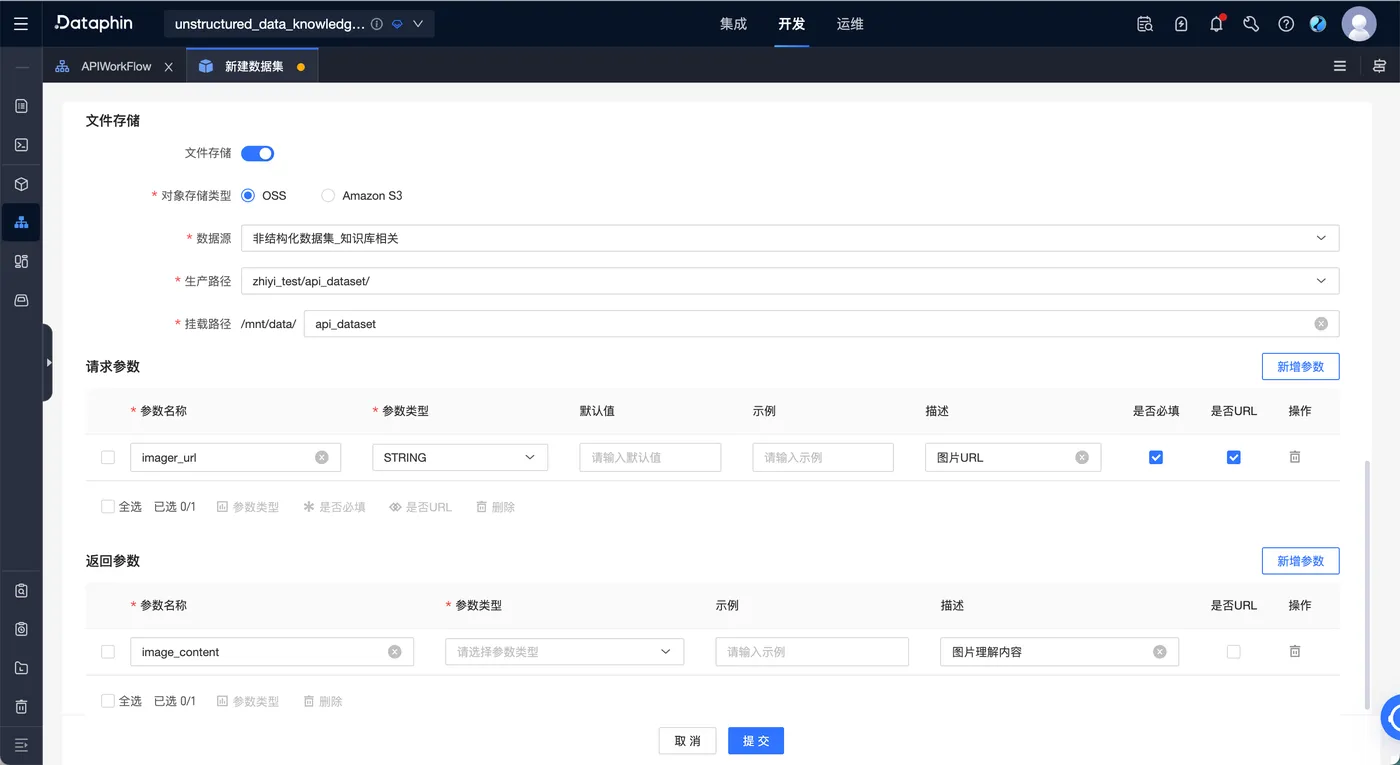
- 文件存储:API工作流处理时接收的是文件在对象存储数据源上的URL,所以需要绑定一个文件所在的文件存储,并设置文件所在路径。(如果存在多个文件夹,可以选择多个文件夹的父级目录)
- 请求参数:定义一个URL作为入参,本文以图片URL为例进行显示,定义了一个
image_url作为入参,设置为必填,并勾选“是URL” - 返回参数:定义图片内容理解结果为出参,期望达到上传一个图片,通过模型对图片进行内容理解
- 提交:确认后进行提交,初次提交可能需要申请权限
-
3.2 创建在线工作流
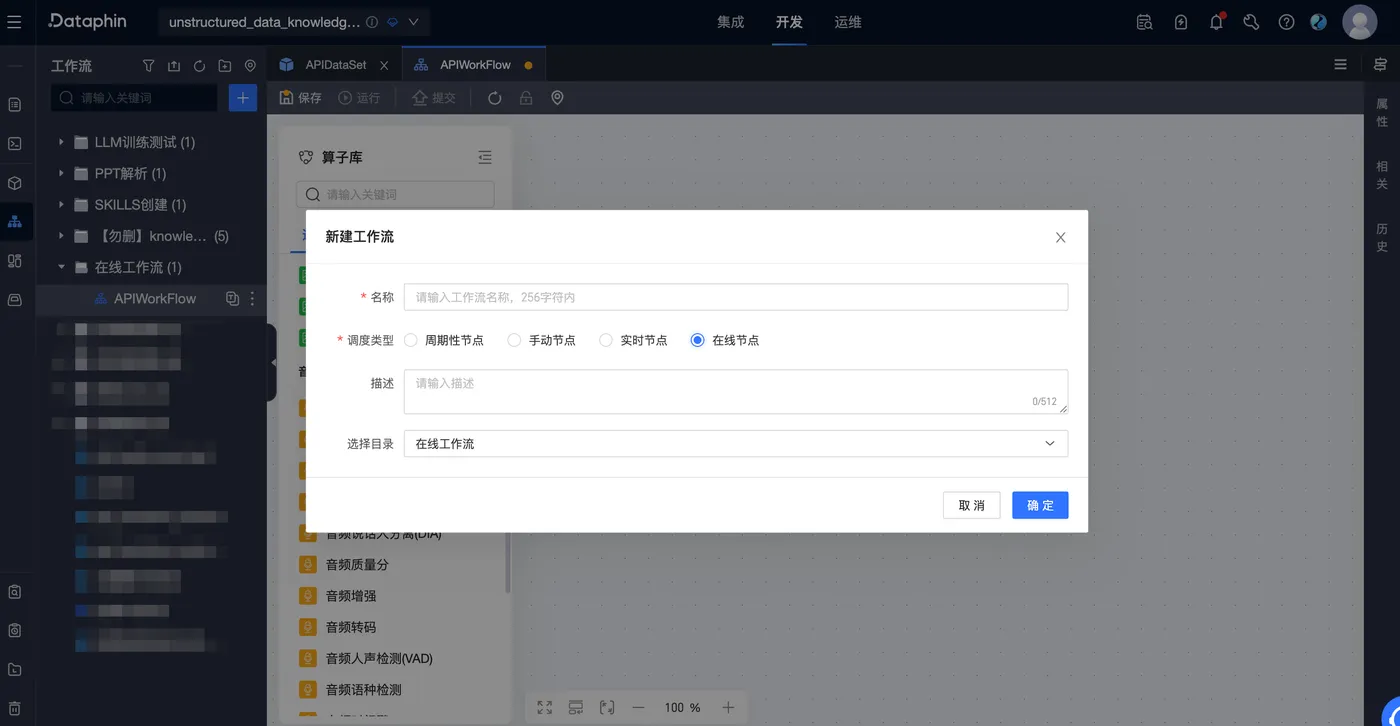
- 创建类型为“在线节点”的工作流
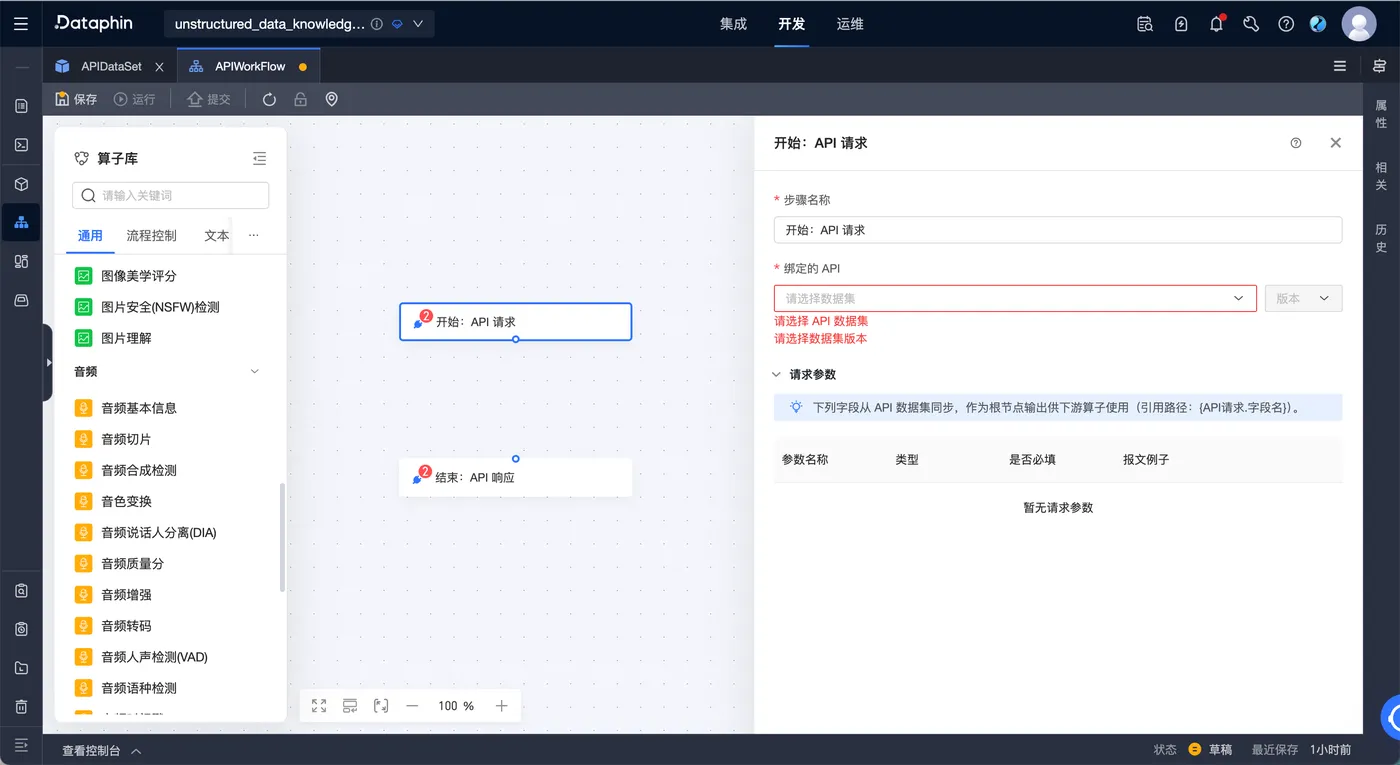
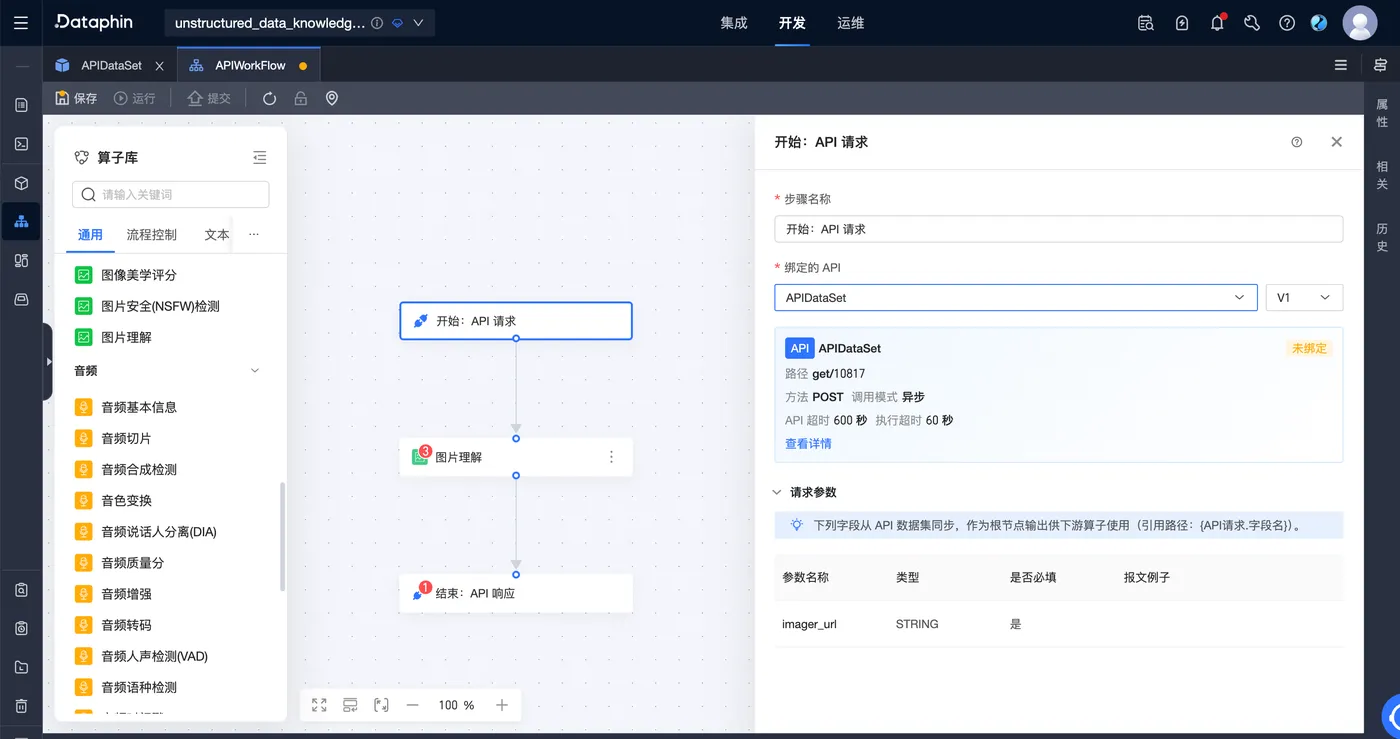
- 在线工作流创建后,画布中初始化一定会有一个“开始:API 请求”和“结束:API 响应”的节点,不可删除,可修改名称
- 完善工作流
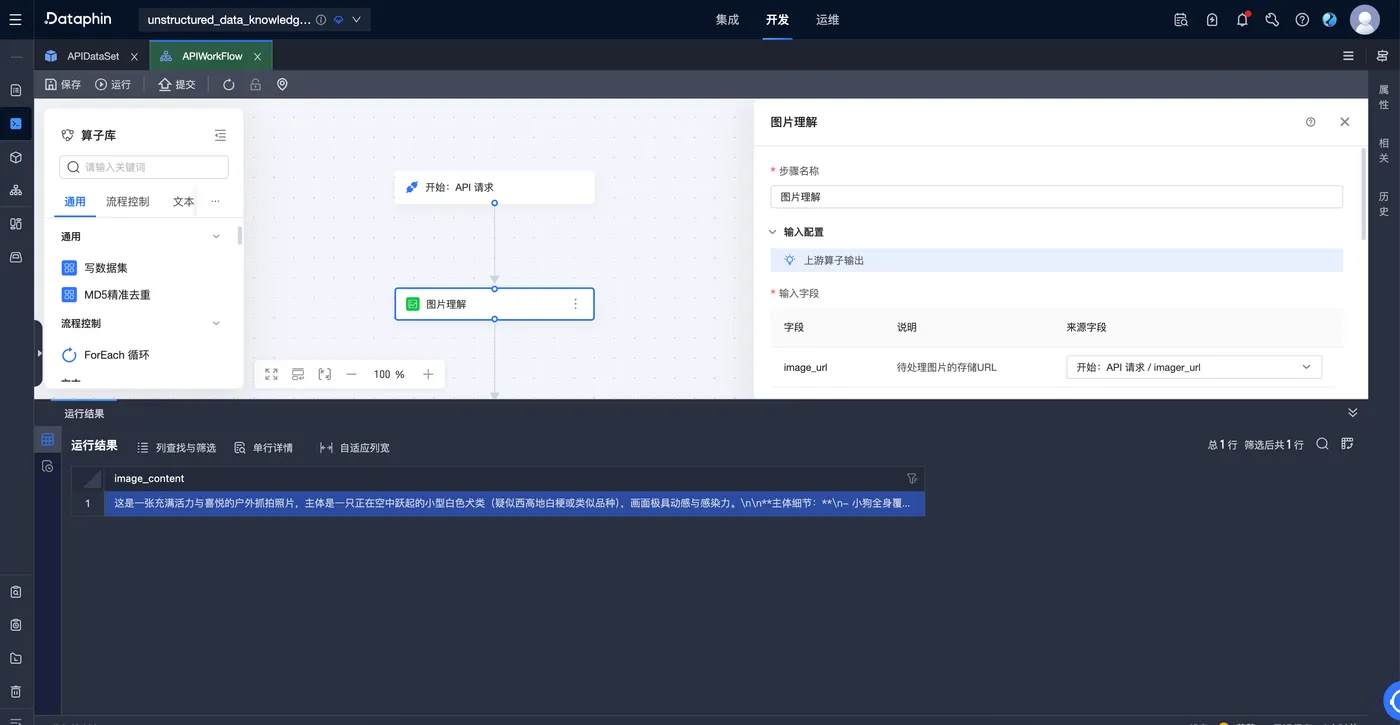
- 本文新增一个“图片理解”算子,用于对上传的图片进行理解,算子补充后,选择输入数据数据集
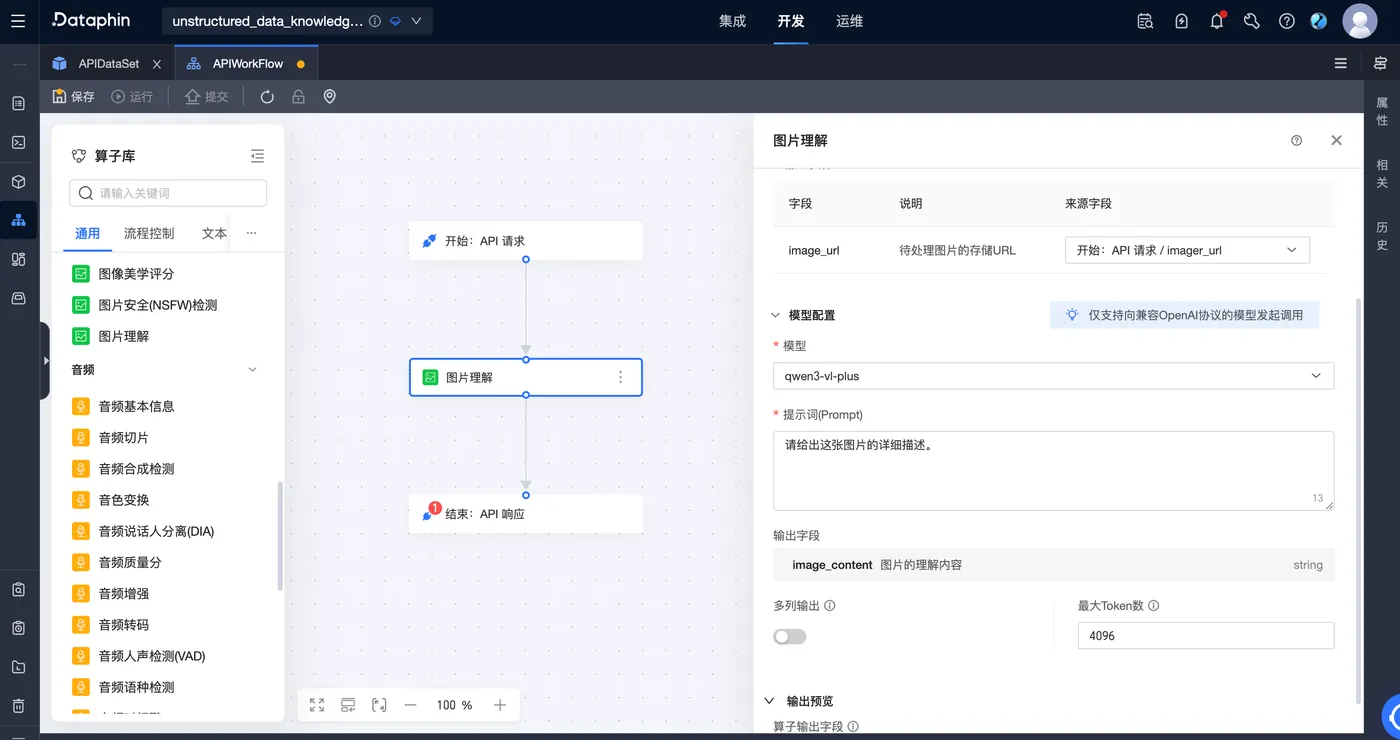
- 配置图片理解处理算子,可按需选择模型和定义理解的提示词
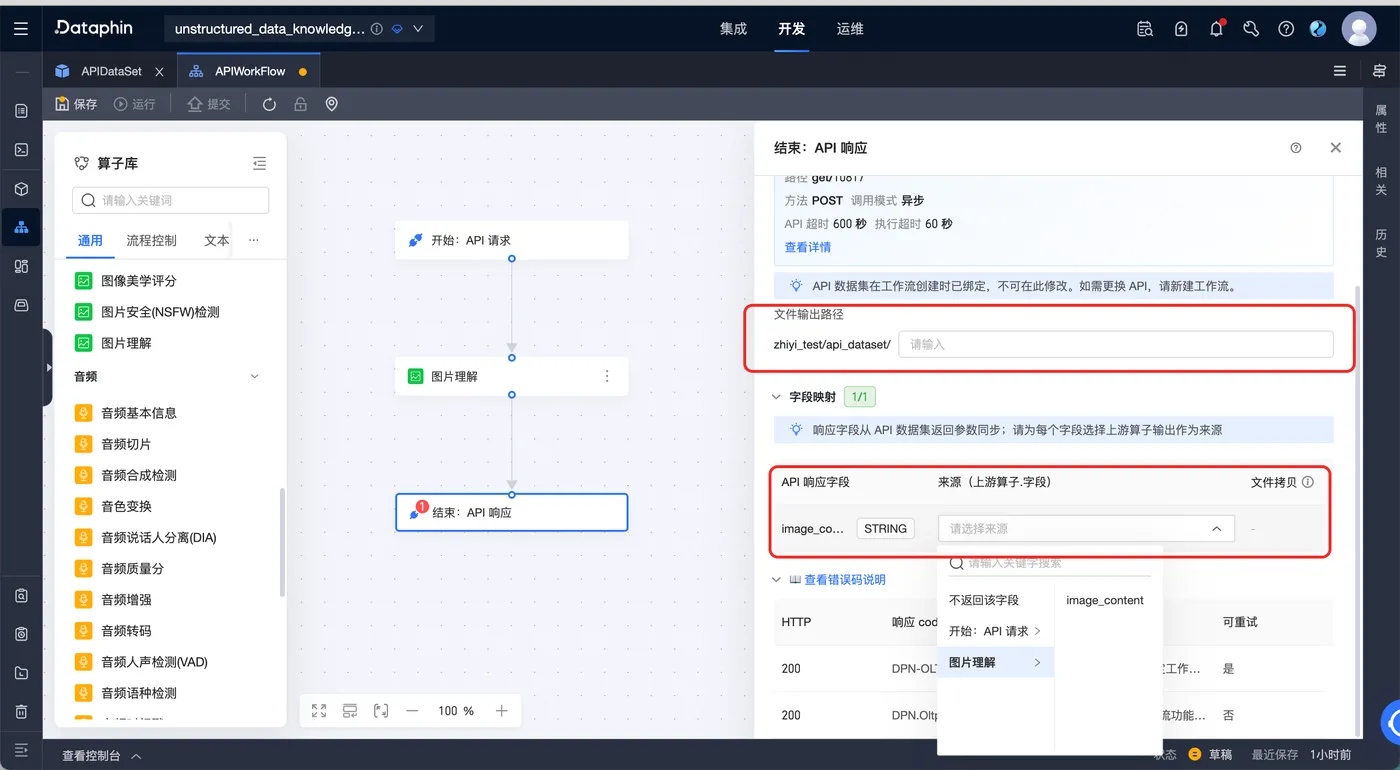
- 配置输出参数
- 文件输出路径:仅在上游算子有文件生成时需要填写,填写后文件会存储到该路径下。比如:PDF解析会生成Markdown,视频切片会生成切片后的视频
- API响应字段:请配置响应字段与上游算子输出字段的映射关系,即把哪个算子的输出用于API的输出
-
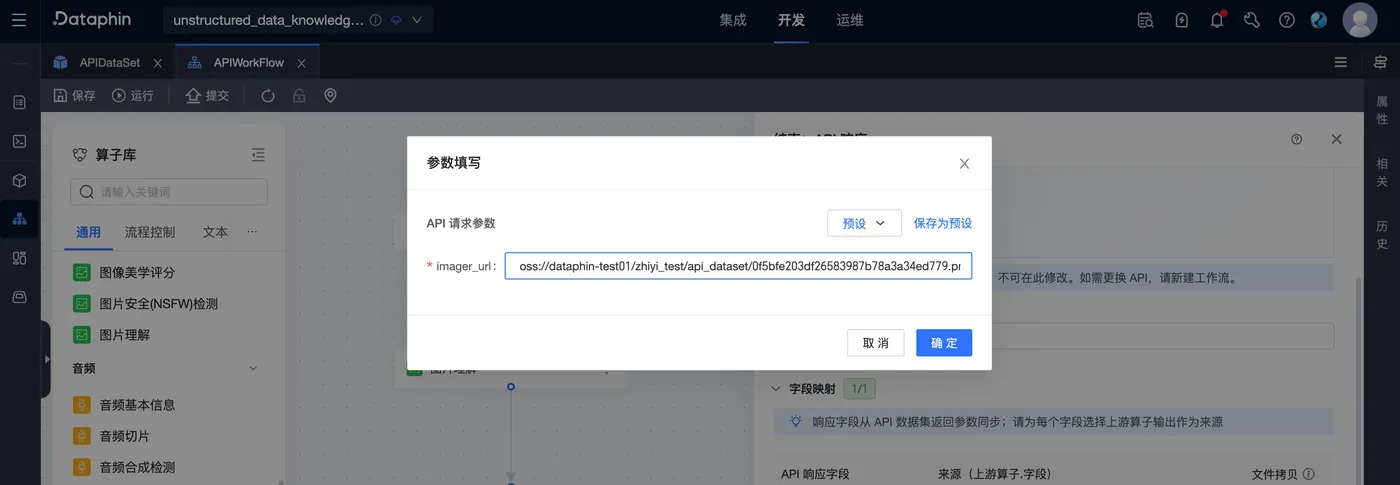
- 试运行
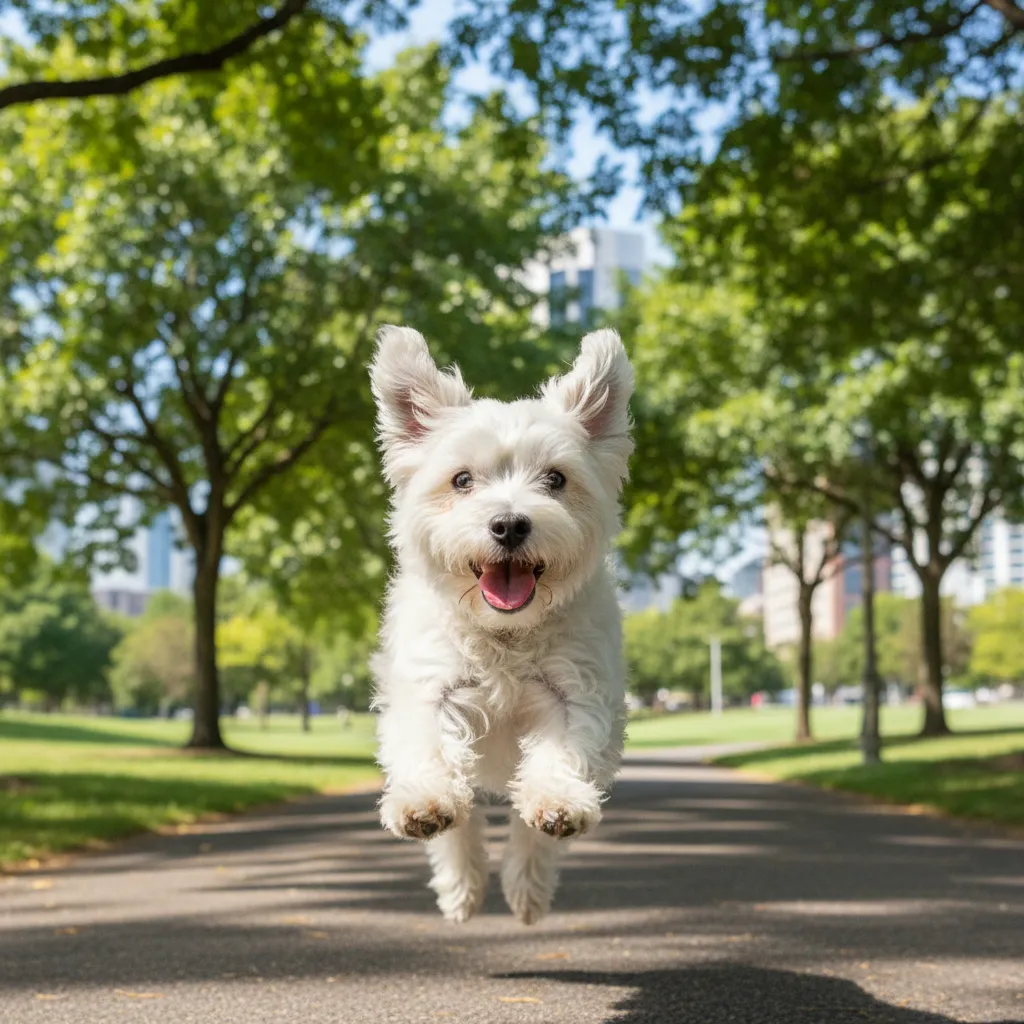
- 点击运行可以测试工作流的输出效果,输出一个图片URL(图片需要在所选的文件存储指定路径下)
-
- 示例图片(AI生成,如有侵权可联系删除):
- 测试结果
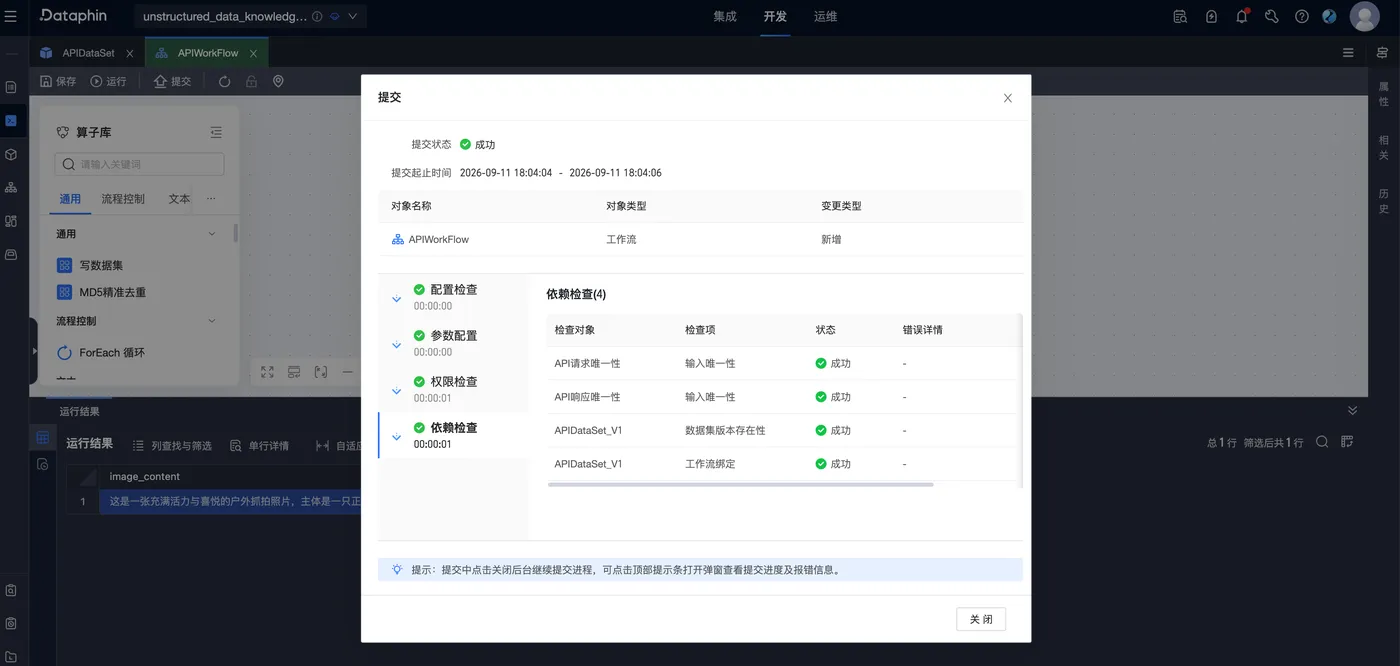
- 请确保工作流提交到线上
3.3 安装服务SDK
- 请在本地安装数据服务的调用SDK,Dataphin提供两种编程语言的SDK,分别是Java、Python
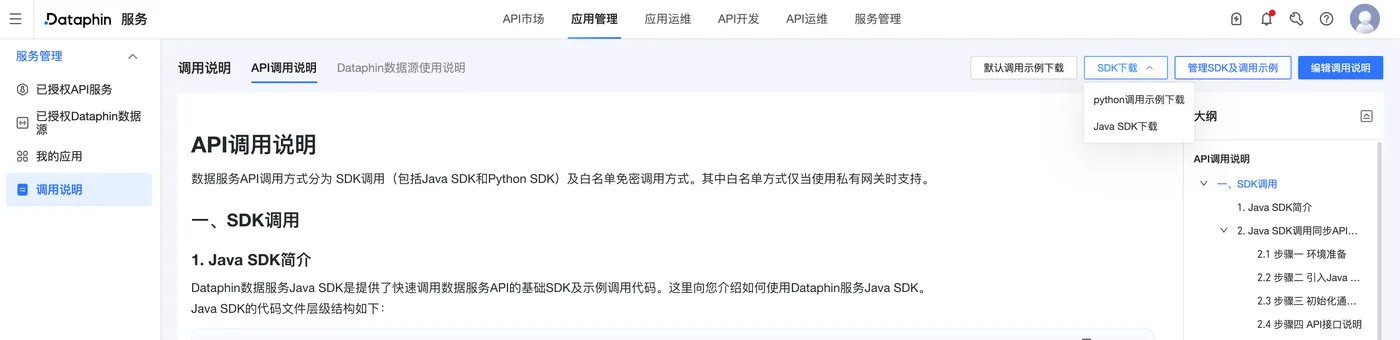
- 获取API数据集名称相同的API的调用文档
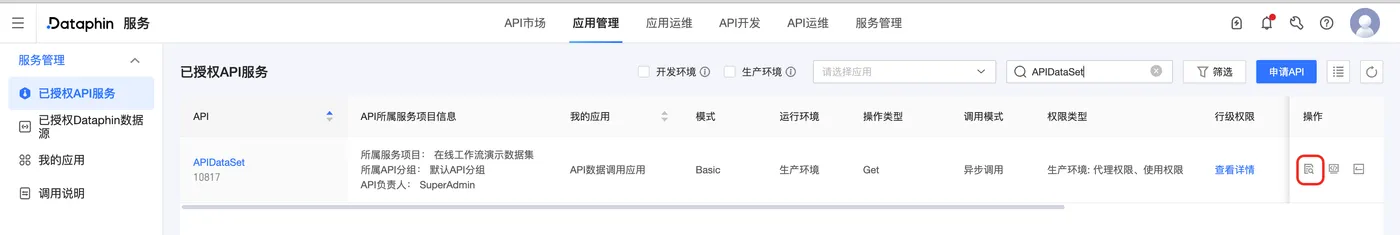
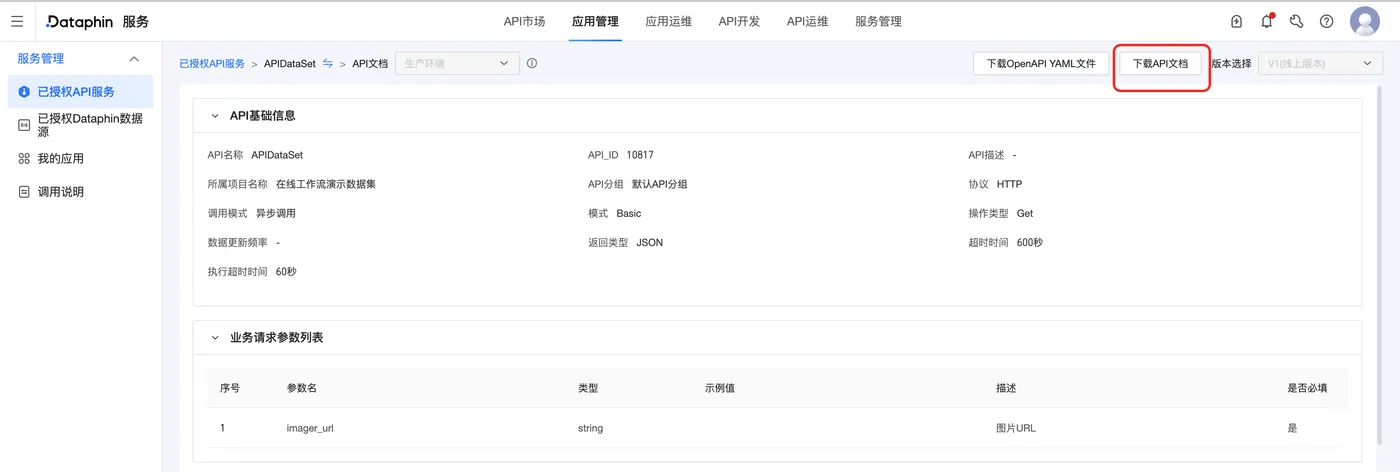
- 获取数据服务调用域名
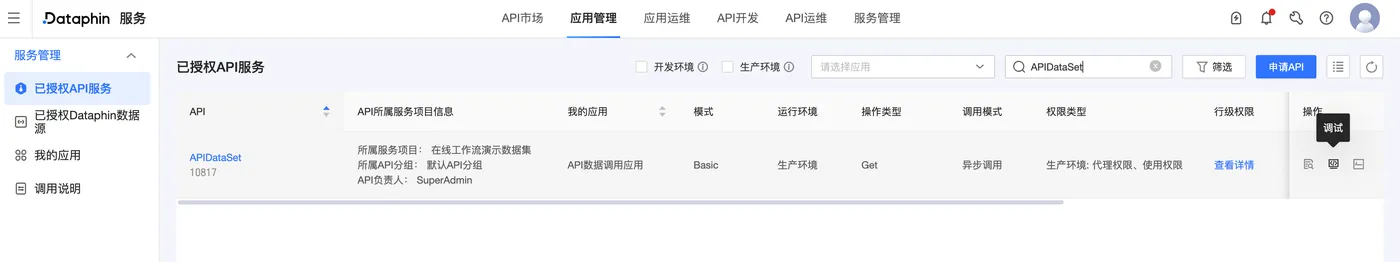
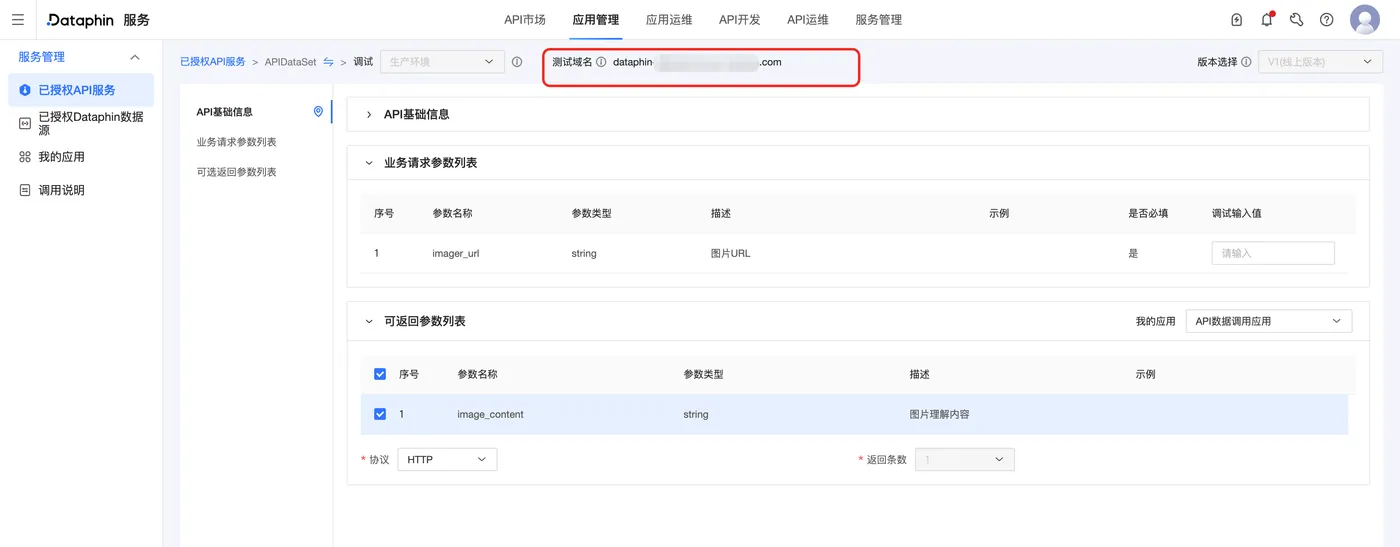
- 获取有权限调指定API的应用的AK和SK(后续调用是采用该应用的AK和SK进行调用)
-
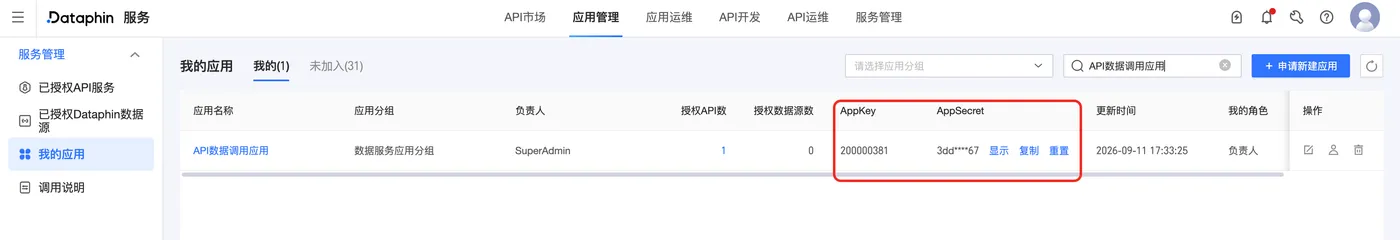
- 如果数据应用没有调用API的权限,请前往【权限管理】申请权限
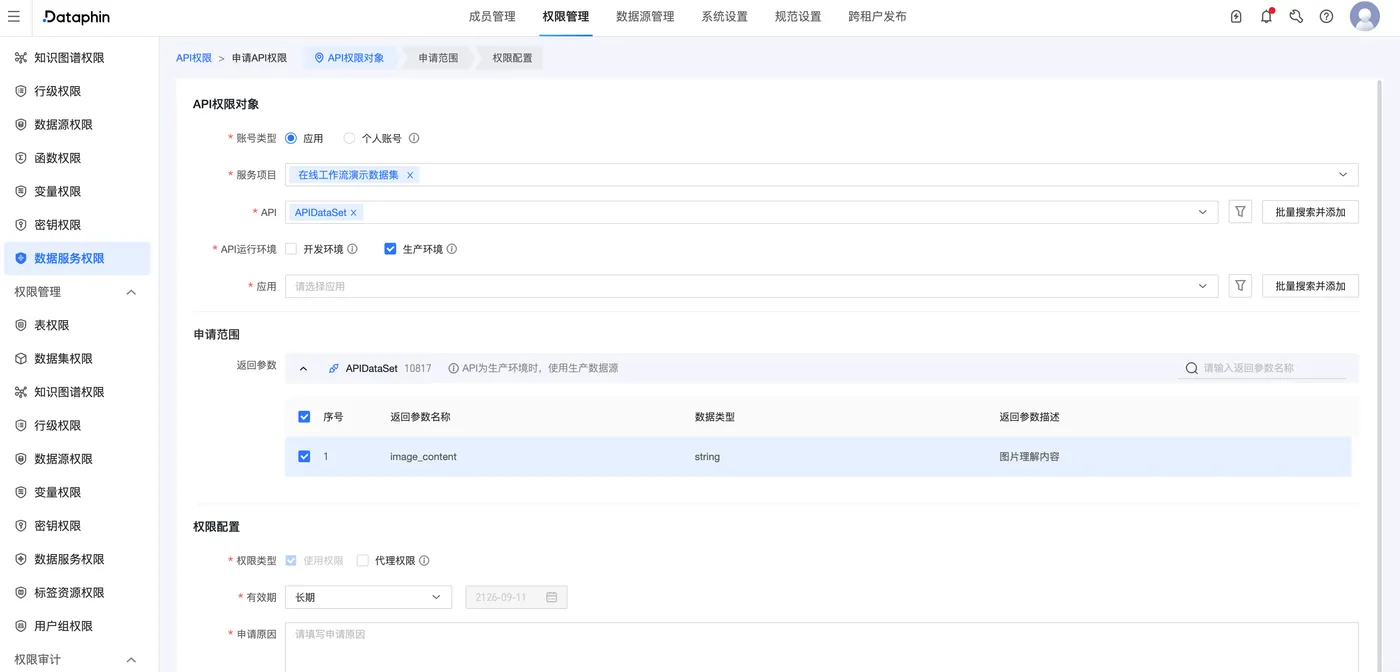
- 本地安装SDK,写调用代码(代码工程此处不展示)