在 AndroidWorld 这个移动端 GUI Agent 基准上,字节开源的 Midscene.js 官方公布的成绩是 Pass@1 93.10%(配置 Midscene 1.9.5 + Gemini-3.5-Flash)。更反直觉的是它做 UI 测试的方式:整套登录、搜索、下单流程,你可以一个选择器都不写。
传统 UI 自动化最大的维护成本,从来不是写用例,而是选择器——前端把 class 改个名、把表单换成组件库、把 data-testid 挪个位置,一整套回归脚本当天全红,哪怕页面在用户眼里一模一样。Midscene.js 这类 GUI Agent 的思路,是用自然语言描述意图、让视觉模型看着截图找元素,从根上绕开选择器这条脆弱链路。
这篇把它拆开:怎么定位、怎么断言、稳定性代价在哪、什么场景该用什么场景别用。
一、93.10% 这个数字,先说清楚它是什么
先把数据摆正,免得被单一数字带节奏。以下是 Midscene.js 官方文档站公布的基准成绩:
| 基准 | 成绩 | 测试配置(官方标注) |
|---|---|---|
| AndroidWorld | Pass@1 93.10%、Pass@2 95.69%、Pass@3 97.41% | Midscene 1.9.5 + Gemini-3.5-Flash |
| MobileWorld | Pass@1 78.63%(92/117) | Midscene 1.10.3 + Gemini-3.6-Flash |
| AppControlBench | Pass@1 96.7%(58/60) | Midscene 1.12.0 + Doubao Seed 2.1 Turbo |
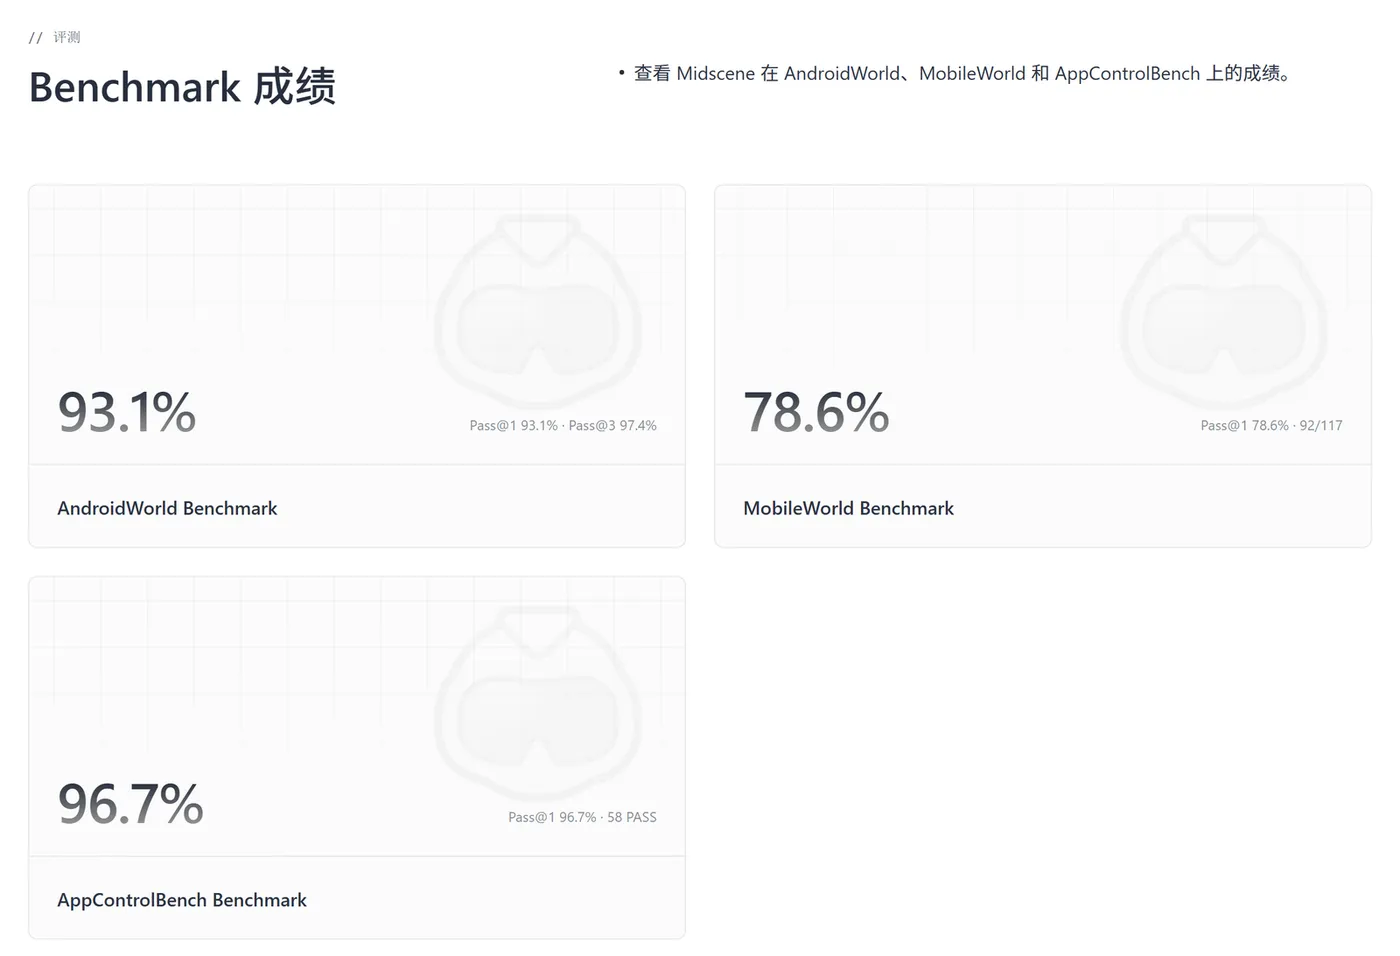
两个读数要点。第一,Pass@1 / @2 / @3 是递增的(93.10% → 95.69% → 97.41%),这本身就在说明:单次执行存在不稳定性,多给几次尝试通过率会往上走。这是视觉模型路线的固有特征,后面第五节会展开。第二,成绩强绑定模型和版本,换一个模型、换一个 Midscene 版本,数字就不一样,别把 93.10% 当成一个脱离配置的绝对值。
需要强调的是,这些是官方在标准基准上的自报成绩,反映的是「GUI Agent 这条路线已经能打到什么水平」,不等于你项目里的通过率。
二、它到底是什么:一个跨端的视觉 GUI Agent
Midscene.js 官方定位是「开源 GUI Agent + Testing Kit」,用一套 Agent API 覆盖 Web、Android、iOS、HarmonyOS 和桌面应用,MIT 协议,GitHub 在 web-infra-dev/midscene。它的核心工作方式,官方描述得很直白:像人用软件一样——观察屏幕、根据看到的内容操作、再检查界面呈现的结果。
你用自然语言描述任务和预期,它根据截图判断在哪里操作、界面是否符合预期。官方特别点出它能定位选择器最难搞的那几类元素:纯图标按钮、自定义控件、<canvas> 里的内容、跨域 iframe 里的元素——这些恰恰是传统选择器要么写不出、要么写得极其脆弱的地方。
除了 Agent API,它还配了一套 Testing Kit,把「零散的视觉操作」组织成可持续维护的 E2E 工程:既能在 Playground(Chrome 插件)里交互式试指令,也能用 YAML 直接写 UI 流程和预期结果;Beta 阶段的 Midscene Test(@midscene/test)更进一步,把声明式测试意图和可编程实现分离——YAML 描述流程,可复用的 TypeScript 节点封装 API 调用、数据准备和清理,一条退款用例可以先用 API 造订单、再用 UI 申请退款并验证结果。跑完之后,它会生成交互式 HTML 报告,把每一步的截图、元素定位、AI 决策过程、操作与断言结果全都记录下来。这份报告是它相对传统自动化的一个隐性优势:失败时你能看到模型当时「看到了什么、为什么这么判断」,而不是只有一句 element not found。
三、它怎么定位:视觉理解,而不是选择器
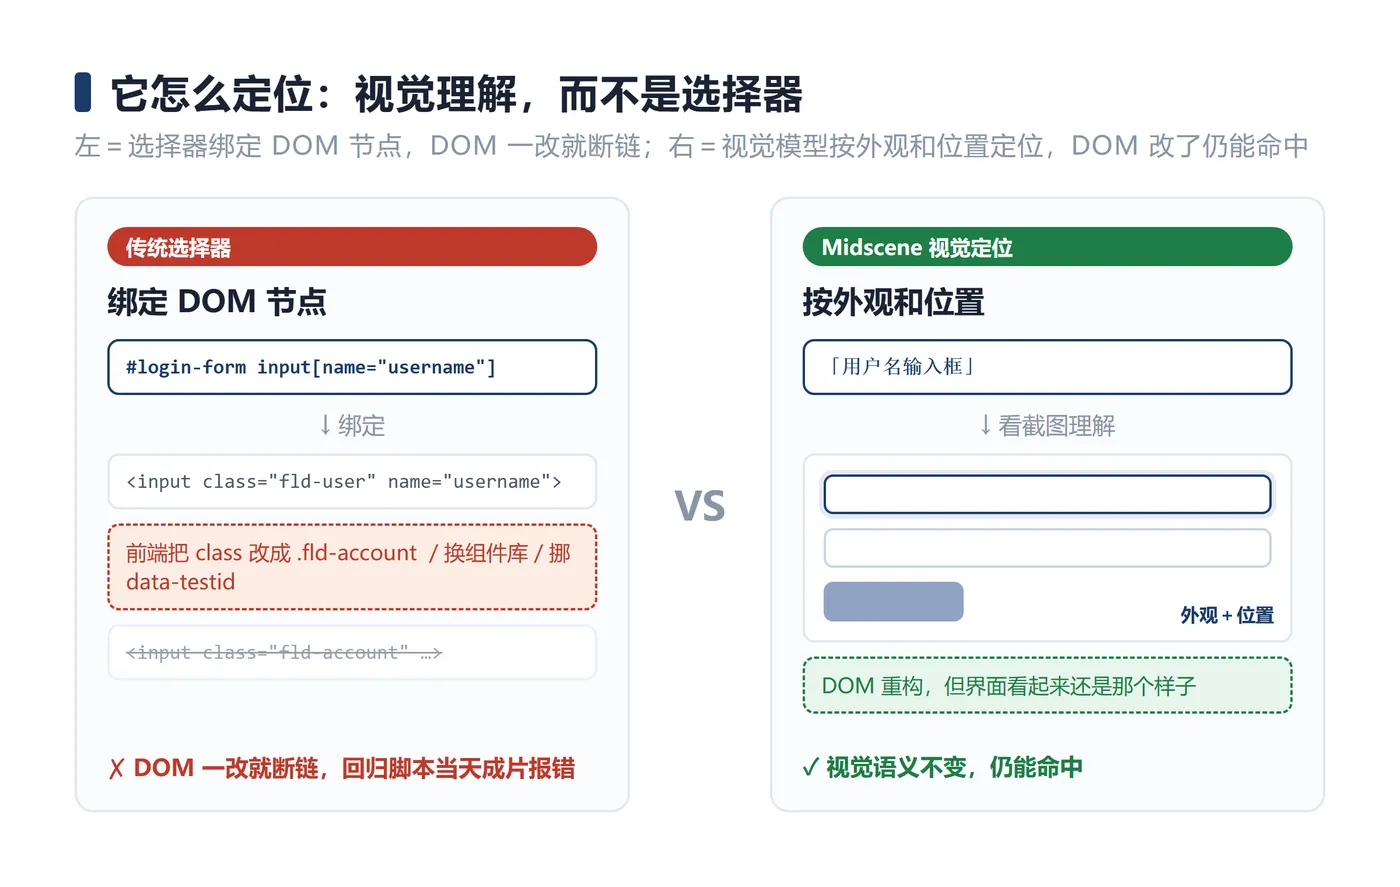
这是整条技术路线的分水岭,值得单独拎出来对比:
| 维度 | 传统选择器(Playwright/Selenium) | Midscene 视觉定位 |
|---|---|---|
| 定位依据 | DOM 结构、id/class/data-testid/属性 | 元素的外观和位置(截图 + 多模态模型理解) |
| DOM 重构时 | 选择器失效,脚本成片报错 | 只要视觉语义不变,仍能命中 |
| 可读性 | #login-form input[name=u],需懂前端结构 |
用户名输入框,业务同学也能读懂 |
| 确定性 | 高,命中即唯一 | 依赖模型判断,存在假阳/假阴 |
| canvas/图标按钮/跨域 iframe | 常常无从下手 | 官方明确支持 |
| 调试成本 | 定位失败信息精确到节点 | 需看 HTML 报告里的截图和 AI 决策过程 |
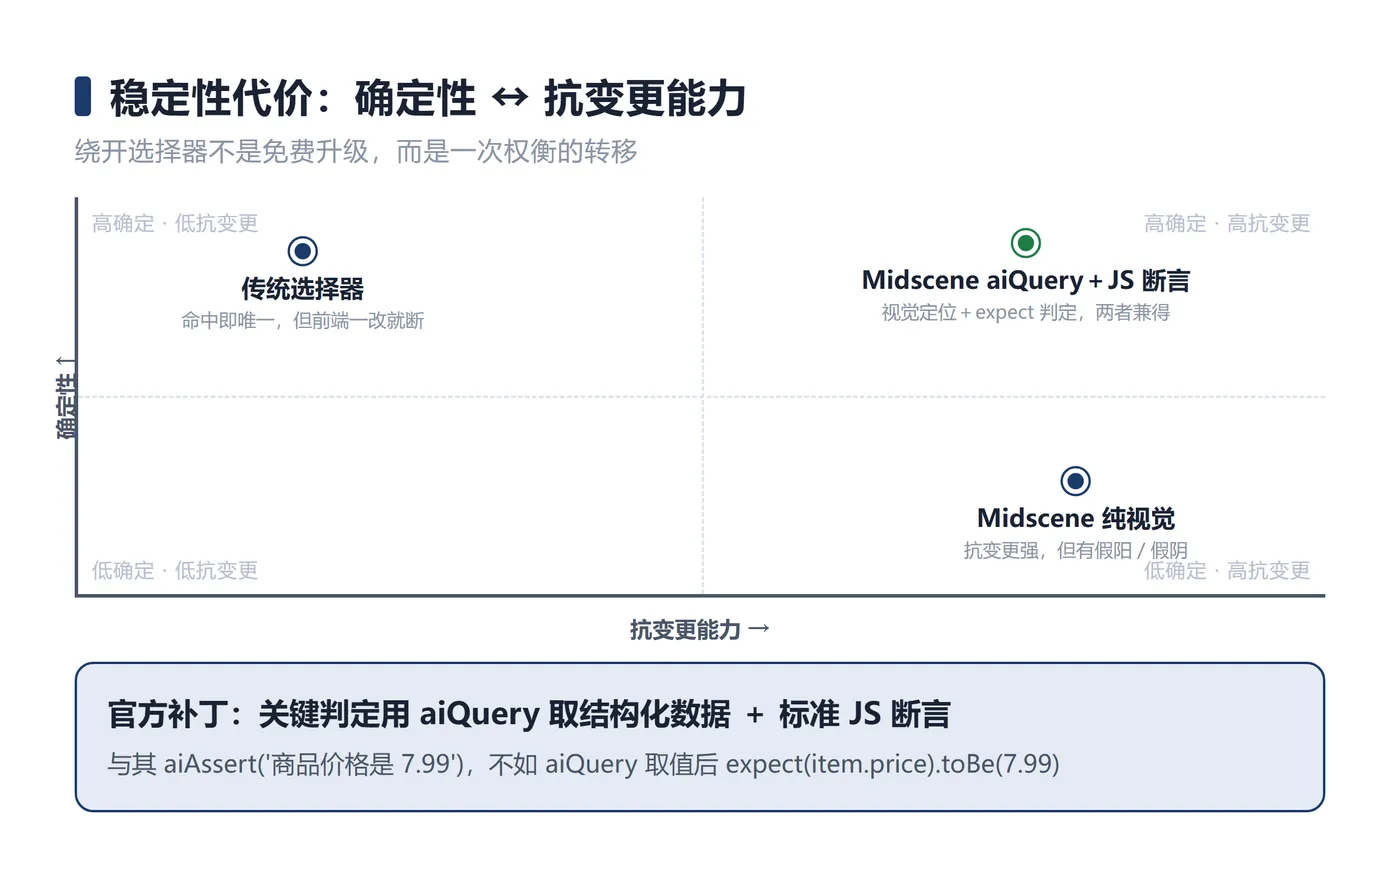
一句话概括这个取舍:传统选择器用「确定性」换来了「脆弱」,视觉定位用「脆弱性的降低」换来了「确定性的下降」。 它不是免费的升级,而是一次权衡的转移。
四、怎么断言,以及官方自己给的确定性补丁
Midscene 的断言也是视觉式的:aiAssert('登录成功后右上角显示了用户头像'),它像人工测试一样观察截图判断预期是否呈现。
但这里有个非常关键、且来自官方一手的细节——Midscene 官方文档明确写了:断言在测试脚本里至关重要,为降低模型假阳/假阴的风险,需要确定性校验时,应把 aiQuery 和标准 JavaScript 断言组合使用。 官方给的原话示例是:与其 aiAssert('商品价格是 7.99'),不如先 aiQuery 把商品名和价格取成结构化数据,再用 expect(item.price).toBe(7.99) 做判定。
这条官方建议本身就说明:纯视觉断言不适合承载「必须精确、必须可复现」的判定。 正确的用法是分两层——用视觉能力去定位和操作(发挥它抗变更的长处),用 aiQuery 取数据 + 标准断言去做确定性判定(补回它不确定的短板)。
五、稳定性代价:把账算清楚
任何「绕开选择器」的方案,代价都转移到了别处。Midscene 的代价清单如下:
| 代价维度 | 具体表现 | 缓解手段(官方能力) |
|---|---|---|
| 判定非确定性 | 同一脚本两次跑,视觉定位/断言结果可能不同(Pass@1<@2<@3 即证据) | 关键断言改用 aiQuery + JS expect |
| 模型成本 | 每步操作/断言都调多模态模型 | 官方称 AppControlBench 60 任务总费用 0.59 美元;纯截图不发庞大 DOM |
| 执行延迟 | 视觉理解比读 DOM 慢 | 缓存 AI Planning 与定位结果,官方示例 51s→28s |
| 数据隐私 | 截图直接发给你选的模型 provider | 可换可自托管的开源模型(Qwen3.x、UI-TARS 等) |
| 环境依赖 | 结果强绑定模型与版本 | 锁定模型/版本,把配置写进 CI |
这里要澄清一个高频混淆:这条路线和「视觉回归」不是一回事。 视觉回归比的是两次截图的像素差异,回答「页面有没有变样」;GUI Agent 理解界面语义并执行操作,回答「这条业务流程能不能走通、结果对不对」。前者是守成的比对,后者是驱动的测试。别把 Midscene 当成截图 diff 工具来用。
六、代码对照:同一条登录流程,两种写法
来看真实 API 写的可跑用例。场景:用正确账号密码登录,验证进入用户中心。
Midscene 写法(视觉 Agent,全程零选择器):
// login.midscene.spec.ts
import {
    test, expect } from '@playwright/test';
import {
    PlaywrightAgent } from '@midscene/web/playwright';

test('用户能用正确账号密码登录', async ({
    page }) => {

  await page.goto('https://shop.example.com/login');
  const agent = new PlaywrightAgent(page);

  // 用自然语言描述意图,视觉模型自己找到输入框和按钮
  await agent.aiInput('用户名输入框', {
    value: 'test_user' });
  await agent.aiInput('密码输入框',   {
    value: 'P@ssw0rd' });
  await agent.aiTap('登录按钮');

  // 等待跳转后的界面出现
  await agent.aiWaitFor('页面已进入用户中心并显示了欢迎语', {
    timeoutMs: 8000 });

  // 视觉断言:判断用户真正看到的结果
  await agent.aiAssert('右上角显示了用户头像,且没有出现登录失败的红色提示');

  // 需要确定性判定时,按官方建议用 aiQuery 取数据 + 标准断言
  const info = await agent.aiQuery<{
    name: string; loggedIn: boolean }>(
    '{name: string, loggedIn: boolean}, 返回当前登录用户名和登录状态',
  );
  expect(info.loggedIn).toBe(true);
  expect(info.name).toBe('test_user');
});
传统 Playwright 写法(每一步都绑定选择器):
// login.playwright.spec.ts
import {
    test, expect } from '@playwright/test';

test('用户能用正确账号密码登录', async ({
    page }) => {

  await page.goto('https://shop.example.com/login');

  // 前端一旦改结构/改 class/换组件库/挪 data-testid,下面几行当天全崩
  await page.locator('#login-form input[name="username"]').fill('test_user');
  await page.locator('#login-form input[type="password"]').fill('P@ssw0rd');
  await page.locator('#login-form button.submit-btn').click();

  await page.waitForSelector('.user-center .welcome-text', {
    timeout: 8000 });

  await expect(page.locator('.user-center .avatar')).toBeVisible();
  await expect(page.locator('.login-error')).toHaveCount(0);

  const name = await page.locator('.user-center .username').innerText();
  expect(name).toBe('test_user');
});
两段脚本功能等价,但维护成本的来源完全不同。传统写法里有 6 个选择器耦合点,每一个都是一次「前端改结构就断」的风险;Midscene 写法里,定位靠的是「用户名输入框」「登录按钮」这种视觉语义,只要界面看起来还是那个样子,DOM 怎么重构它都还能命中。
代价也写在里面了:Midscene 那几行 aiInput/aiTap/aiAssert 每一步都要调模型,慢、有成本、且不是 100% 可复现——所以最后一段确定性判定,我按官方建议用了 aiQuery + expect,而不是全靠 aiAssert。这就是这条路线的正确姿势。
七、什么场景该用,什么场景别用
| 场景 | 建议 | 理由 |
|---|---|---|
| 前端频繁重构、选择器天天失效 | 推荐 | 视觉定位对 DOM 变更不敏感,维护成本骤降 |
| 纯图标按钮、自定义控件、canvas、跨域 iframe | 推荐 | 选择器难写或写不了,正是它的强项 |
| Web/Android/iOS/HarmonyOS/桌面 跨端复用 | 推荐 | 一套意图描述跨平台,端上重写成本低 |
| 探索性测试、冒烟测试、快速验证关键路径 | 推荐 | 自然语言上手快,YAML/Playground 即可试 |
| 金额、状态等必须精确可复现的判定 | 谨慎 | 纯 aiAssert 有假阳/假阴,须配 aiQuery+JS 断言 |
| 超大回归套件、CI 时长/成本极敏感 | 谨慎 | 每步调模型,成本与延迟会随用例数放大 |
| 截图绝不能出内网、又无自托管模型 | 别用 | 数据隐私红线;除非自托管 Qwen3.x/UI-TARS |
八、写在最后
Midscene.js 这类 GUI Agent 真正的价值,不是「让 AI 替你点按钮」,而是把 UI 自动化里最脏最累的那部分——选择器的长期维护——从根上拿掉了。
但它没有消灭成本,只是把成本从「前端一改就修脚本」转移到了「模型调用的钱、时间,和判定的不确定性」上。
想清楚这笔账的人,会把它用在界面善变、跨端、探索性的场景,同时在关键判定上老老实实退回 aiQuery + expect 的确定性写法。工具替你绕开了选择器,但没替你绕开工程判断。
我们在持续拆各类开源测试工具的技术路线与真实代价,如果你在评估要不要把 GUI Agent 引进你的 UI 自动化,留言区聊聊你的场景,我帮你对一下该用哪部分、别用哪部分。