600亿买来的Cursor,被OpenAI一脚踢开——聊聊测试人的AI护城河

简介: OpenAI宣布2026年11月终止向SpaceX旗下Cursor提供模型服务,主因信任缺失。此事警示测试人:工具可被断供,能力才是核心。AI时代,唯有掌握大模型原理、质量工程与落地能力的复合型测试人才不可替代。

这两天科技圈的大瓜,估计你已经刷到了——

8月28日,OpenAI发布公告:正式通知SpaceX,将终止向AI编程工具Cursor提供模型,停止日期定在2026年11月12日。
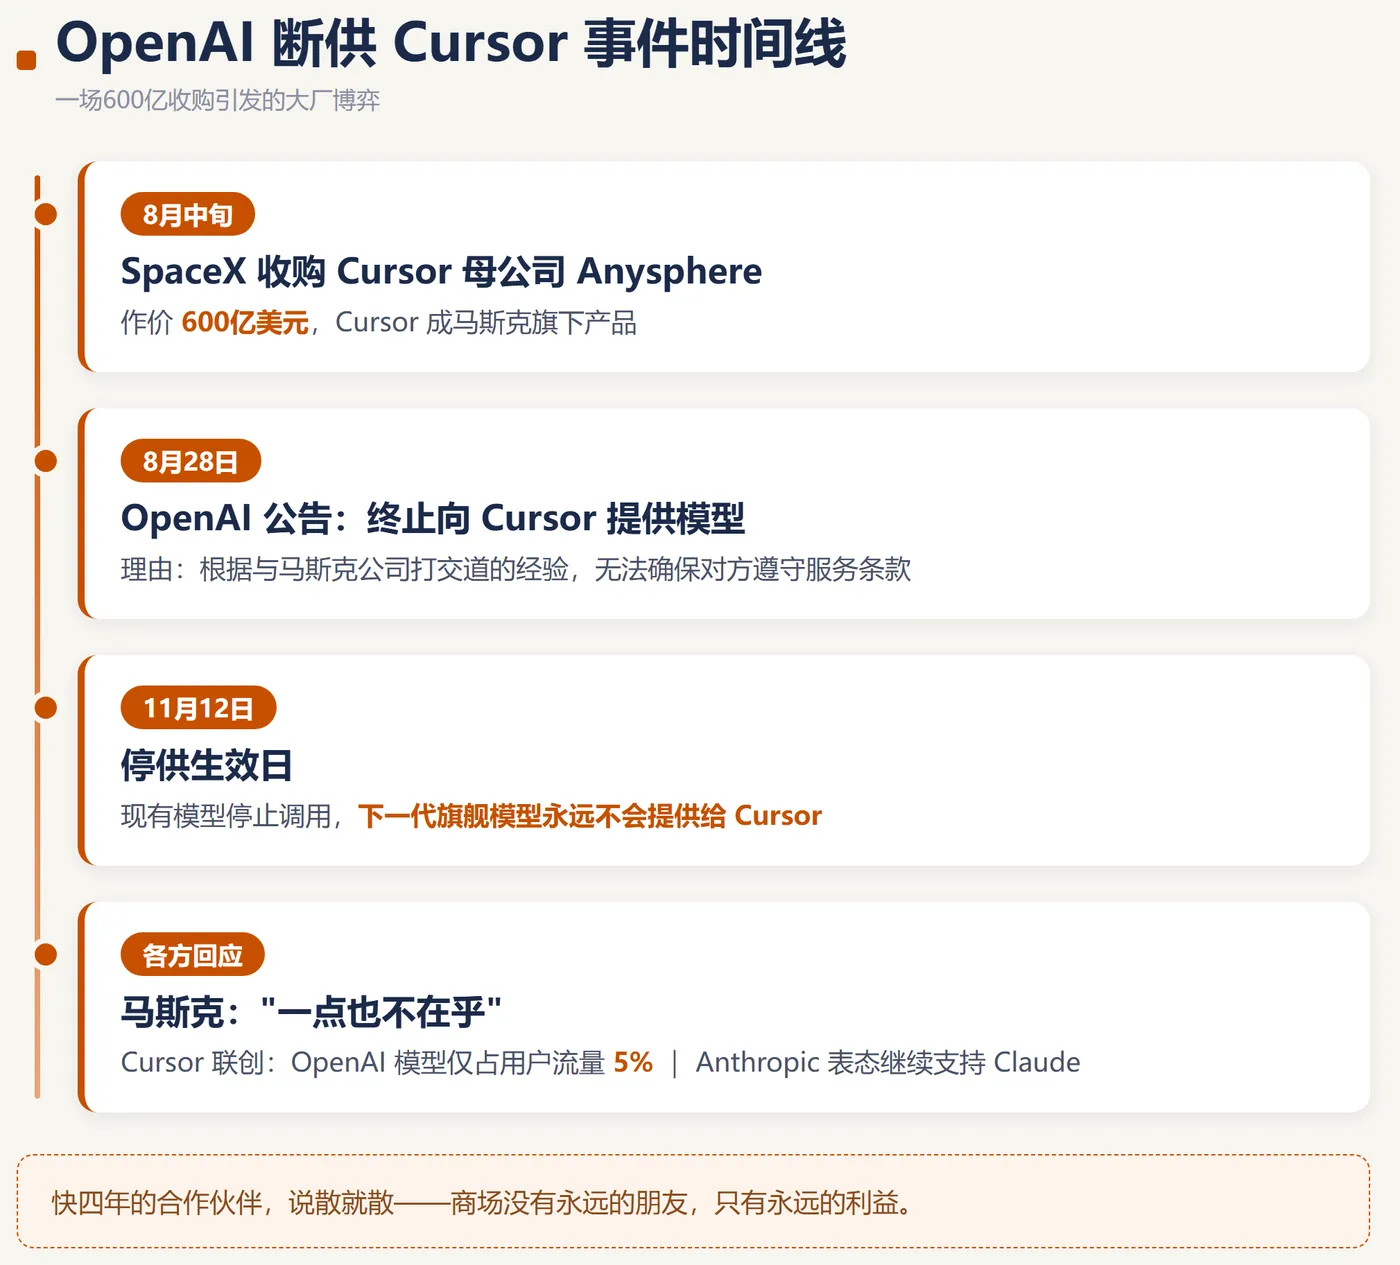
image.png

有意思的是时间点。就在两周前,SpaceX刚以600亿美元完成对Cursor母公司Anysphere的收购。收购墨迹未干,OpenAI反手就递了一份"终止合作通知书"。

OpenAI在公告里说得直白:11月12日起,Cursor无法再调用OpenAI的模型;未来的新模型(包括下一代旗舰)永远不会给Cursor;理由是"根据与马斯克公司打交道的经验,无法确保对方遵守服务条款"。

翻译一下就是:我不信任马斯克。Twitter当年的违约、xAI承认蒸馏OpenAI数据,这些旧账都在桌上。

马斯克的回应也很马斯克——"一点也不在乎"。Cursor联合创始人补了一刀:OpenAI模型只占Cursor用户流量的5%左右。Anthropic则迅速表态,继续支持Cursor里的Claude。

快四年的合作伙伴,说散就散。商场没有永远的朋友,只有永远的利益。


这事跟测试人有什么关系?
image.png

关系大了。

Cursor是什么?全球领先的AI编程工具,100万+付费用户,服务包括OpenAI、英伟达在内的数万家企业。大量开发者已经把它嵌进日常开发流程——写代码、改Bug、生成测试用例,用得比微信还顺手。

结果呢?因为两家大厂的恩怨,这一环说断就断。

你以为用顺手了、充了会员,这个工具就是你的了?工具是租来的,能力才是自己的。

对测试同学来说,这个教训要放大三倍看:

现在不少测试团队,已经把日常工作流绑在各种AI工具上——AI生成用例、AI写自动化脚本、AI做缺陷分析。一旦模型换血、平台转型、接口涨价,最先被打回原形的,就是那些"只会用工具"的人。
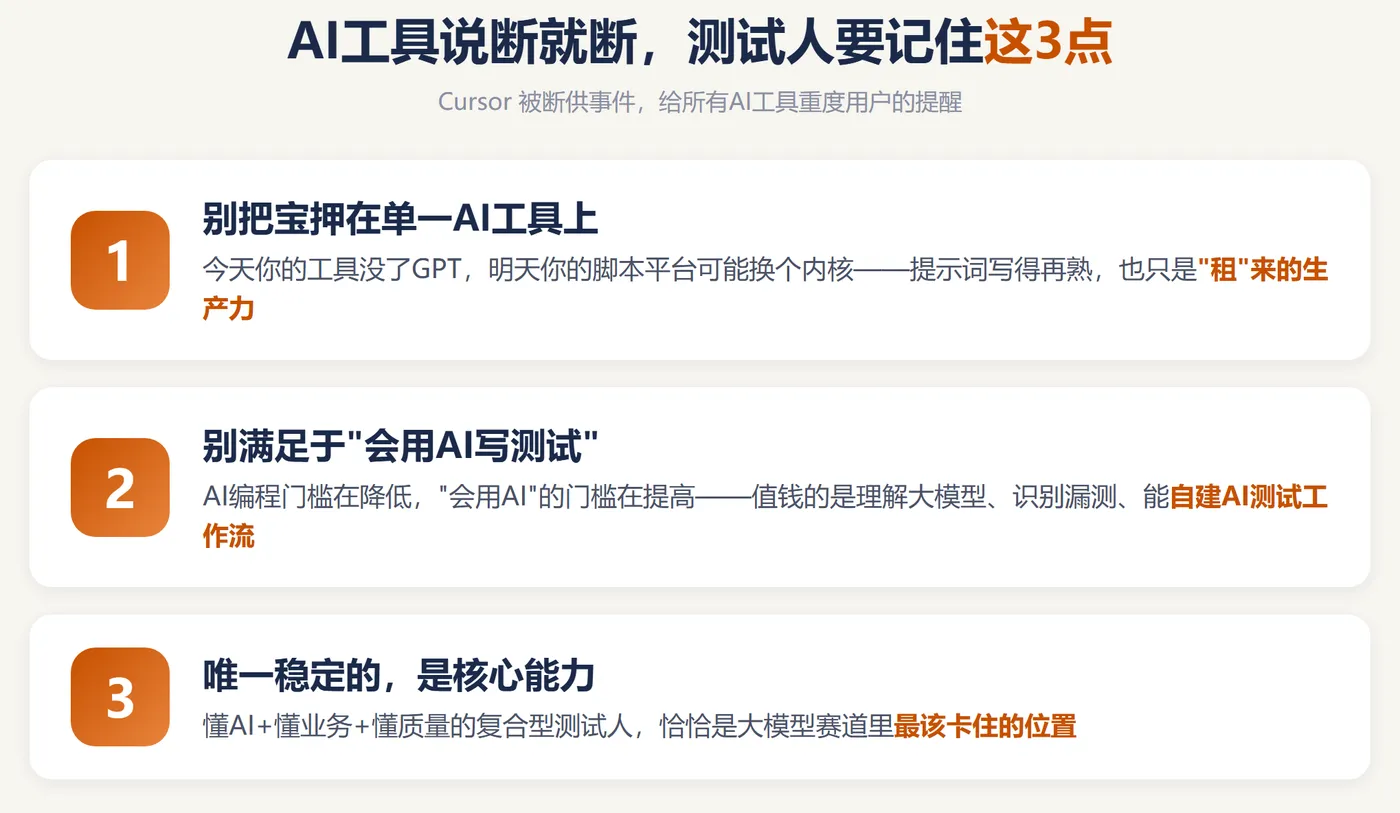
image.png

1. 别把宝押在单一AI工具上

今天你的工具没了GPT,明天你的脚本平台可能换个内核。提示词写得再熟,也只是"租"来的生产力。

2. 别满足于"会用AI写测试"

AI编程的门槛在降低,但"会用AI"的门槛在提高。真正值钱的不是记住某个工具的按钮在哪,而是理解大模型怎么工作、知道AI生成的用例哪里会漏测、能自己搭一套AI测试工作流——工具换了,工作流还是你的。

3. 唯一稳定的,是质量工程的核心能力

模型供应商打架,反而说明大模型赛道热度只增不减。而每一个AI产品背后,都需要大批"懂AI+懂业务+懂质量"的复合型人才——这恰恰是测试人最该卡住的位置。


传统测试 vs AI测试开发,差距已经拉开
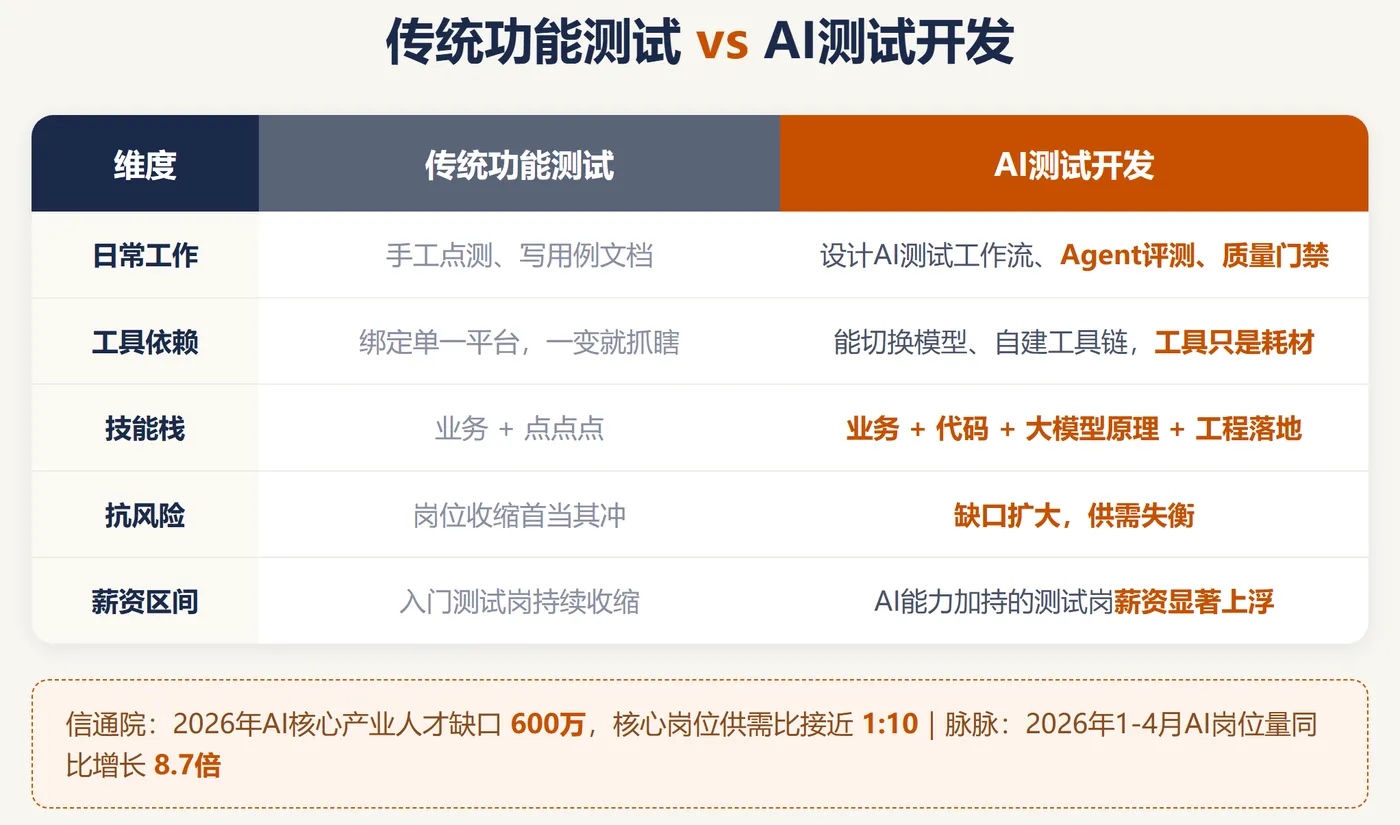
image.png

维度 传统功能测试 AI测试开发
日常工作 手工点测、写用例文档 设计AI测试工作流、Agent评测、质量门禁
工具依赖 绑定单一平台,平台一变就抓瞎 能切换模型、自建工具链,工具只是耗材
技能栈 业务 + 点点点 业务 + 代码 + 大模型原理 + 工程落地
抗风险 岗位收缩首当其冲 缺口扩大,供需失衡
薪资区间 入门测试岗持续收缩 AI能力加持的测试岗薪资显著上浮

这不是危言耸听,数据摆在这:

  • 中国信通院数据:2026年中国AI核心产业人才缺口达600万人,算法工程师、Agent开发、大模型训练架构师等核心岗位供需比接近1:10;
  • 《脉脉2026春招职场洞察报告》:2026年1-4月,AI领域岗位量同比增长8.7倍;
  • 招聘市场实感:AI能力加持的测试开发岗位薪资普遍上浮,"会Agent、懂MCP"已经是硬性加分项——字节等大厂春招已把Agent实战列为硬性要求。

一边是入门级纯手工测试岗位持续收缩,一边是企业高薪抢"懂AI的测试人"。同一个行业,两种命运。


从"会用工具"到"能落地",中间差一套系统训练
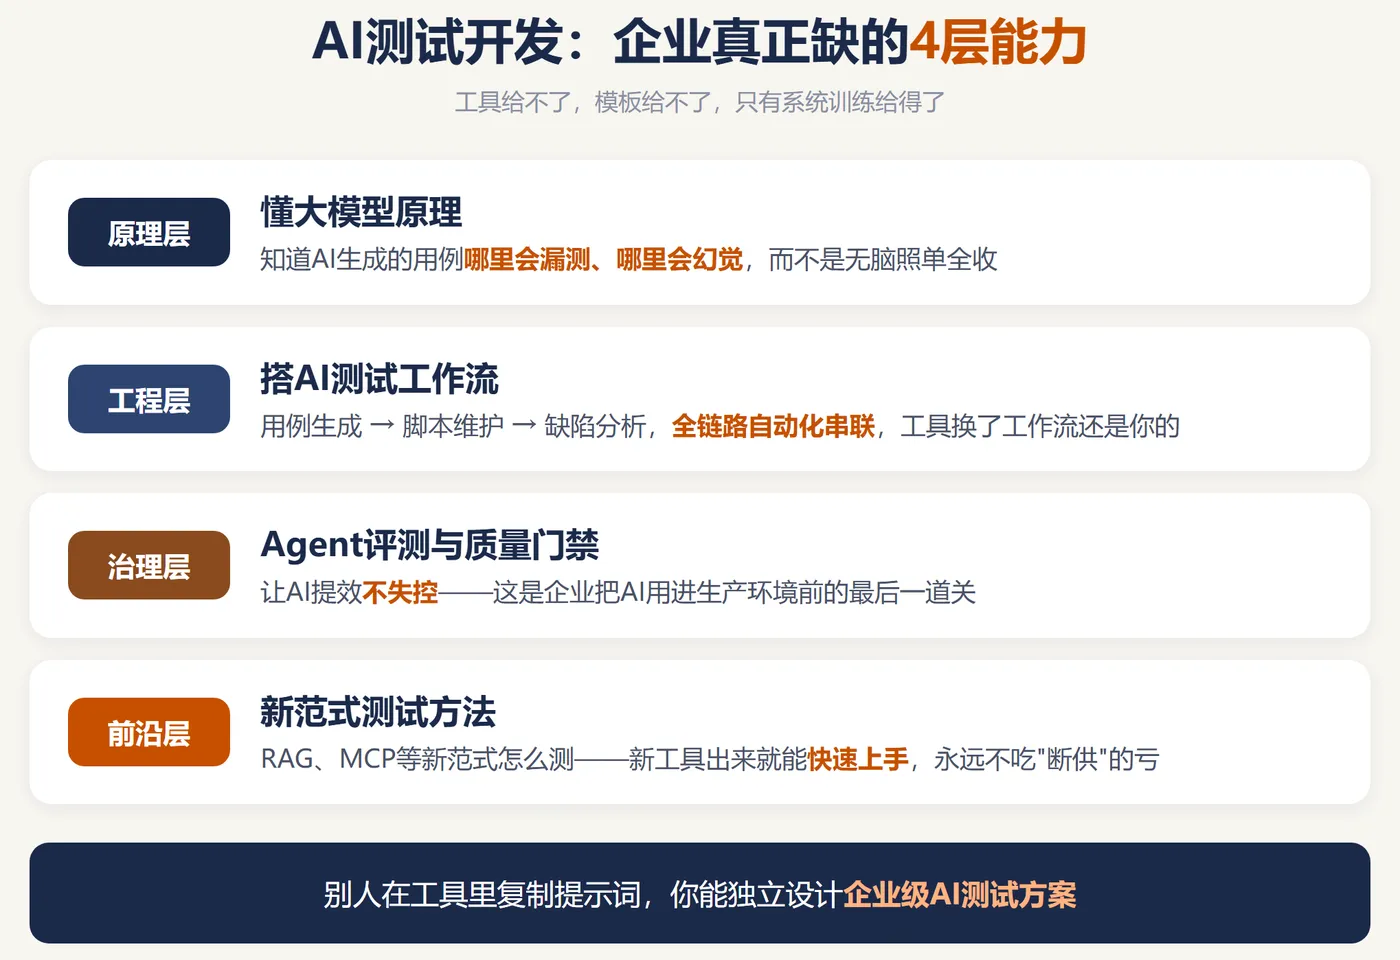
image.png

市面上的AI工具教程,大多停留在"怎么调用API、怎么写提示词"。但企业真正缺的,是能把AI落到质量工程里的人:

  • 懂大模型原理,知道AI生成的用例哪里会漏测、哪里会幻觉;
  • 会搭建AI测试工作流,用例生成、脚本维护、缺陷分析自动化串联;
  • 能做Agent评测与质量门禁,让AI提效不失控;
  • 掌握RAG、MCP这些新范式的测试方法,新工具出来就能快速上手。

这些能力,工具给不了你,模板也给不了你,只有系统训练给得了。

同样是写测试脚本,别人在工具里复制提示词,你能独立设计企业级AI测试方案——这才是跳出同质化内卷的资本。


写在最后

回到Cursor被断供这件事。信息更新这么快,过两天可能就翻篇了。

真正值得记住的是一句话:AI时代,没有任何一个工具是铁饭碗;但"懂AI、懂业务、懂质量"的人,走到哪都是铁饭碗。

工具会被断供,能力不会。

想系统提升AI测试开发能力,私信我,聊聊你的情况。


(信息来源:OpenAI官方公告及公开报道、中国信通院、脉脉2026春招职场洞察报告|AI质量工程 · 整理出品)

相关文章
|
2月前
|
人工智能 NoSQL 测试技术
AI岗位渗透率升至37.56%:2026届秋招,测试开发应届生的准备方式也该变了
2026秋招AI岗位激增47.3%,渗透率达37.56%,但门槛同步升高:简历堆砌AI术语难过关,真能力看项目深度。应届生需夯实测试开发基础,再以RAG、Agent等真实AI测试项目体现工程力——会用AI不值钱,能测AI才稀缺。
|
2月前
|
SQL 人工智能 算法
AI岗位渗透率升到37.56%:测试岗正在分成“新旧两种人”
2026秋招AI岗位渗透率达37.56%,测试岗正加速分层:传统执行岗溢价消失,懂AI应用、Agent工程、LLM评估的全栈测开人才需求暴增340%,薪资高30%-50%。转型,刻不容缓。
|
8天前
|
运维 监控 安全
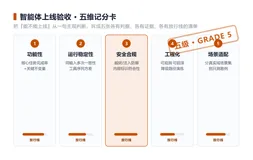
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
智能体上线评审常陷“五人五义”困局。全国首个五级智能体评测证书揭示破局关键:将主观判断拆为功能性、稳定性、安全、工程化、场景适配五大可证维度,每维设独立判据与证据链,推动验收从经验走向可审计、可复现、可追责。(239字)
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
|
2月前
|
人工智能 运维 数据挖掘
企业Agent上线后最头疼的不是Bug,而是同一个Bug反复出现
企业AI测试不能只靠静态测试集!真实生产中,用户千奇百怪的提问、工具调用异常、循环重试、规则违反等Bad Case才是最大挑战。本文提出“三层动态回归体系”:Smoke集保核心、Critical集守底线、Production Failure集持续沉淀线上问题。强调从Trace中自动挖掘Bad Case,构建私有化、可演进的AI质量资产库,实现真正可持续的Continuous Evaluation与Quality Gate。
企业Agent上线后最头疼的不是Bug,而是同一个Bug反复出现
|
9天前
|
人工智能 自然语言处理 前端开发
大模型测评实战:从零跑通 Kev,给“概率模型”做 4 类自动化测试
本文介绍如何将Kev——一种类型化决策AI模型——作为可测试服务进行验证。它不生成文本,而是针对结构化问题(noul/choice/score)返回概率化答案。重点在于:建立本地HTTP服务、编写接口契约测试、验证多题隔离与选项顺序稳定性、开展概率校准,并构建可回归的冻结样本集。核心理念:把AI当被测对象,而非黑盒顾问。(239字)
|
1月前
|
人工智能 架构师 Java
测试专用大模型 CodeLlama-34B-Test 深度解析:AI驱动的软件测试新范式
CodeLlama-34B-Test是基于Llama 2微调的开源测试专用大模型,参数达340亿,HumanEval准确率53.7%(微调后超73%)。首创融合轻量级符号执行,实现语义理解+路径推导,显著提升单元测试生成质量与业务覆盖能力,正重塑AI时代软件质量保障范式。
|
8天前
|
SQL 人工智能 安全
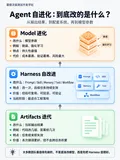
Agent 自进化:从评测、记忆到 Skill 更新,工程闭环怎么搭
AI Agent自进化不是让模型“自学成才”,而是构建工程化闭环:评测发现问题→沉淀经验→更新Prompt/Skill→回归验证→灰度发布→反馈回流。核心在于Harness层(Prompt、Skill、Memory等)的持续优化,需借鉴CI/CD、自动化测试、Trace分析等软件工程实践,实现可验证、可回滚、可管控的真正持续改进。(239字)
Agent 自进化:从评测、记忆到 Skill 更新,工程闭环怎么搭
|
16天前
|
自然语言处理 负载均衡 安全
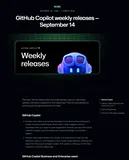
Copilot把模型选择变成“效率、平衡、智能”三档:同一套测试还能证明三个档位都可靠吗?
GitHub Copilot 新增 efficiency/balance/intelligence 三档自动路由,按任务风险分层管控模型选择、成本与行为可靠性。测试需聚焦路由契约、故障转移、档位门禁及多维断言,而非仅看平均成功率。
Copilot把模型选择变成“效率、平衡、智能”三档:同一套测试还能证明三个档位都可靠吗?
|
15天前
|
安全 测试技术 开发工具
Grok 4.7进Copilot后,测试团队先别比谁更聪明:先测它会不会把任务做得更危险
本文探讨模型升级(如Grok 4.7接入Copilot)中的质量保障难点:仅靠结果正确性远不够,需关注工具调用轨迹、行为边界、风险控制与成本变化。提出任务分层、轨迹评测、三类关键回归检测、多轮等价测试及CI门禁机制,强调将模型升级转化为可观察、可审计、可回滚的工程实验。
Grok 4.7进Copilot后,测试团队先别比谁更聪明:先测它会不会把任务做得更危险
|
17天前
|
人工智能 安全 测试技术
Jev 与概率校准:AI 决策系统该怎么测试?
Jev是TypeSafe推出的“系统一模型”,专注结构化决策:不生成文本,只输出带概率与置信度的选择、评分或是非判断。其核心价值在于可校准的可靠性——让程序知悉AI“有多确定”,从而安全实现自动分支、风险拦截与人机协同。(239字)
Jev 与概率校准:AI 决策系统该怎么测试?

热门文章

最新文章