非结构化单据自动化:文档智能五步法与版式兜底实践

简介: 企业大量合同、发票等单据非结构化、版式多变,纯OCR识别准却难落地。本文详解文档智能端到端五步法(采集→分类→提取→审核→录入),强调多模态识别+规则校验+人工兜底的协同闭环,让识别结果真正驱动ERP、自动化流程,实现“业务跑得通”。

企业里大量业务凭证——合同、发票、报关单、订单、物流单——都是非结构化的。它们格式千变万化、版式年年更新,纯靠人工录入慢且错,纯靠通用 OCR 又常常"识别准但业务跑不通"。本文拆解一套文档智能的端到端实践,重点聊容易被忽视的"兜底"环节。

一、为什么单据是自动化的硬骨头

与固定界面的系统操作不同,单据的难点在于"没有固定结构":同一类发票来自不同供应商、排版各异;同一份合同每次条款顺序不同;扫描件还有倾斜、印章遮挡、表格跨页等问题。这些因素叠加,让单点识别模型在真实业务里频频失手。

二、五步法:采集 → 分类 → 提取 → 审核 → 录入
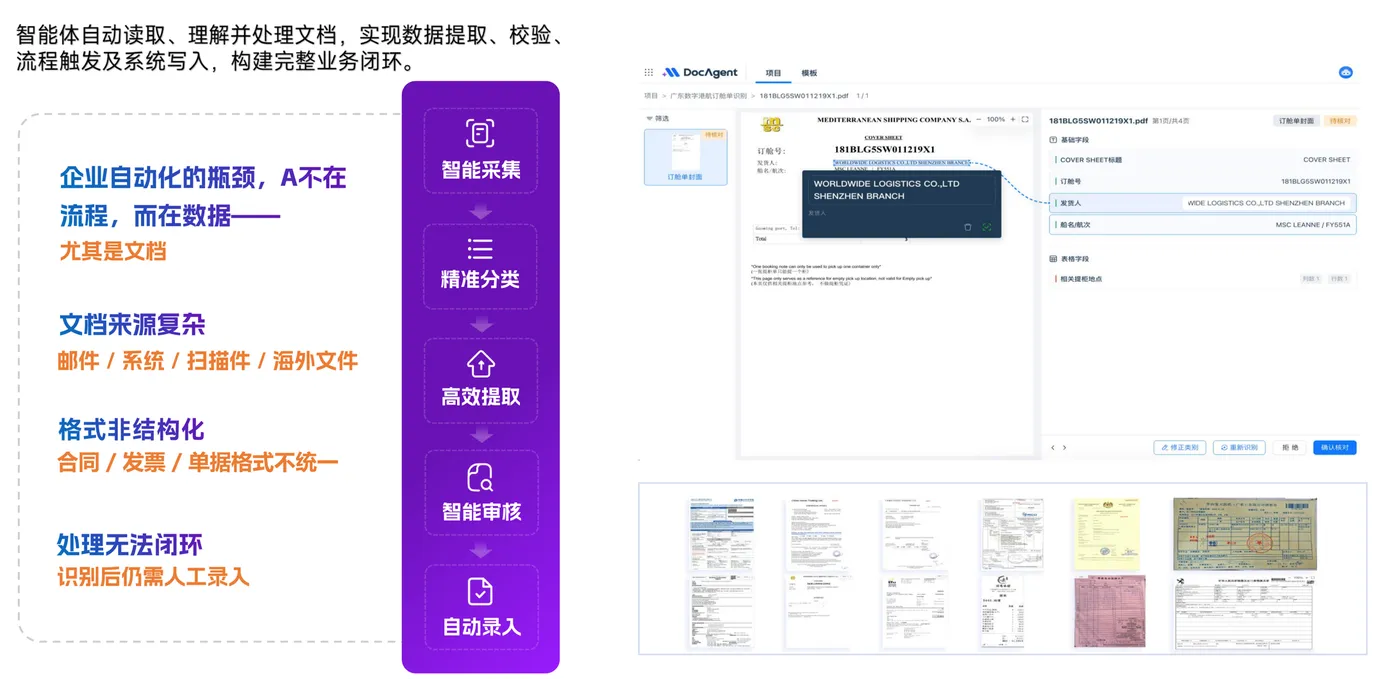
image.png

一套稳妥的文档智能流水线通常拆成五步:

  1. 采集:从邮件、网盘、业务系统或扫描设备统一汇聚单据,统一格式与命名。
  2. 分类:自动判断单据类型(发票 / 合同 / 订单 / 报关单),分流派发到对应处理流。
  3. 提取:用多模态识别从单据中抽取关键字段(金额、税号、日期、明细行等),而非仅做整页 OCR。
  4. 审核:按业务规则校验字段一致性(如价税合计是否等于金额加税额),低置信度自动转人工。
  5. 录入:把结构化结果回写到 ERP 或财务中台,驱动后续自动化执行。

三、不能只靠 OCR:版式差异是真实挑战

很多团队低估了版式差异。通用 OCR 对规整文档表现好,但遇到以下情况会明显退化:表格线缺失或错位、字段跨页、竖排或混合排版、印章压字。此时"识别字符"和"抽取正确业务字段"之间还有距离。

因此第 4 步的"审核"不能省。实践中的做法是建立"抽取—规则校验—转人工"的兜底闭环:模型给每个字段打置信度,低于阈值的连同上下文一并推给业务人员确认;确认结果再反哺模型。这样既保住了准确率,又让人工只处理真正疑难的单据。

这里要强调"多模态"的价值。纯 OCR 本质是图像转文字,对版面结构不敏感;而多模态识别能同时理解文字、表格线、印章位置和排版逻辑,更贴近"人看单据"的方式。对带印章压字、表格跨页、混合排版的复杂单据,多模态的字段抽取稳定性明显优于单模态 OCR。但即便如此,它仍不是银弹——所以兜底闭环必须保留,把模型不确定处交给人,才是生产环境跑得稳的组合。

四、场景落地

  • 应付与订单:从供应商发票、采购订单中抽取字段,自动与合同三单对齐,差异自动预警。
  • 物流与清关:从运单、报关单抽取关键信息,驱动报关与库存更新。
  • 招采数据整理:某医药集团运营人员需登录 30 多个省份的医药局采购系统筛选招采数据,用"AI 识别 + 平台执行层"组合实现全天候自动查询整理,近千条数据达到 100% 正确率,完全释放人力。
  • 客服与合同:从客户邮件附件、销售合同中抽取关键条款与要素,自动生成工单或归档索引,让客服与法务从翻文档中解放出来。

这些场景的共同点是:先让文档智能把"非结构化"变成"结构化",再交给自动化执行层去"跑流程",二者串起来业务才真正闭环。

五、与自动化平台的集成

文档智能单独存在价值有限,真正的收益在"识别结果驱动执行"。例如发票字段抽取完成后,平台自动发起付款申请、更新应付账款、触发审批流;识别到异常则转人工并挂起后续流程。文档智能是"眼睛",自动化执行层是"手脚",缺一个都跑不通。

结语

文档智能的终点不是"识别准",而是"业务跑得通"。五步法保证流程完整,版式兜底保证极端情况不崩,人机协同保证准确率可持续——这三件事做到位,非结构化单据才真正从成本

相关文章
|
5月前
|
人工智能 测试技术 决策智能
TradingAgents 爆火:当一个 AI 不再炒股,而是组建了一支“虚拟投研团队”
TradingAgents 是TauricResearch开源的多智能体大模型金融交易框架,GitHub星标超70k。它模拟真实投研团队(基本面、情绪、新闻、技术等分析师及风控、组合经理),将高风险金融决策拆解为可编排、可追踪、可复盘的Agent协作流程,代表AI从单点推理迈向组织化工作流的新范式。
|
1月前
|
弹性计算 人工智能 安全
阿里云99元云服务器专属活动介绍:2核2G3M带宽,买到的不只是一台云服务器
99元,能买到什么?在阿里云的99元云服务器专属活动中,99元买到的不只是一台云服务器,而是2核2G、3M固定带宽不限流量的扎实配置,是新老同享、续费同价、一口价直至2029年的长期承诺,更是主机安全与数据备份的双重权益。一次付费99元,续费还是99元;拿一份安全兜底,留一条成长路——这正是本次活动想要传递给每一位用户的核心价值。
|
JavaScript
在vue3中使用markdown编辑器
在vue3中使用markdown编辑器
在vue3中使用markdown编辑器
|
1月前
|
人工智能 自然语言处理 API
阿里云百炼 Token Plan 个人 & 团队版对比:定价、用量加油包、接入配置、活动权益完整说明
阿里云百炼Token Plan是面向开发者的大模型订阅服务,以Credits统一计费,支持Qwen、Claude、DeepSeek等多模态模型及Cursor、Qwen Code等AI工具。个人版39元/月起,团队版150元/月起,含文本、图像、视频、语音等全能力,兼容OpenAI/Anthropic协议。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens
400 6
|
1月前
|
存储 人工智能 供应链
阿里云国际代理商:2026 AI 大模型出海 解析灵骏真武 M890
2026年,AI竞争转向底座能力。阿里云推出灵骏真武M890超节点——全球首款分钟级交付的64卡一体化PPU算力单元,搭载144GB HBM3显存、800GB/s卡间带宽,单机9TB显存池,可原生承载2.4万亿参数MoE模型训推一体,破解跨境算力供应与合规部署难题。(239字)
|
1月前
|
缓存 监控 API
最新版阿里云通义千问 Qwen3.8‑Max 功能介绍、计费规则、选型指南及使用教程与常见问题 FAQ
Qwen3.8‑Max作为千问系列新一代旗舰大模型,采用MoE混合专家架构,总参数规模达到2.4万亿,激活参数约950亿,百万级超大上下文窗口,同时具备原生多模态理解、深度思考推理、强工具调用、长周期智能体闭环执行等多项核心能力。该模型不再局限简单问答对话,能够独立完成复杂软件工程、法律文书分析、金融方案推演、长文档深度解析、截图与视频理解等专业任务,支持端到端输出生产级业务成果,是面向复杂业务、智能体开发、高难度科研分析场景的主力基座模型。
567 1
|
1月前
|
人工智能
阿里云百炼Coding Plan在哪购买?终于找到了
阿里云百炼Coding Plan Pro高级套餐限时抢购,200元/月,含9万次/月调用额度,支持Qwen3、Kimi、GLM等多模型及图片理解,兼容主流编码工具,每日9:30开抢。阿里云Coding Plan官网:https://t.aliyun.com/U/na1clH
|
1月前
|
人工智能 并行计算 数据可视化
Krea‑2‑Trainer 实战:AI 漫剧角色 LoRA 本地微调,解决生成频繁变脸问题
Krea-2-Trainer 是专为 AI 漫剧设计的本地绿色 LoRA 训练工具,一键完成角色微调,解决“变脸”痛点;支持中文界面与命令行批量训练,数据不出本地,兼顾易用性与专业性。(239字)
|
4月前
|
存储 人工智能 JavaScript
企业AI落地最该补的不是模型而是语义层
本文揭示企业AI落地的核心瓶颈——“语义鸿沟”:大模型虽强,却不懂企业专有数据含义与系统关系。提出构建本体语义层,统一定义实体、关系与流程,让AI真正理解业务。对比RAG侧重文档检索,语义层专注结构化数据理解,二者协同构成AgentRAG完整能力。(239字)
357 0