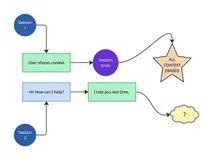
Agent 的记忆不应该只是存下来。重要的加深,矛盾的消解,过时的淡忘。
当前 Agent 的记忆困局
用过 ChatGPT、Claude 或任何大模型 Agent 的人,大概都体验过这种挫败:
上午你告诉 Agent,团队的代码规范是"所有 API 返回值必须包装在 Result<T> 结构中"。下午开个新会话,它给你生成了一堆直接返回裸值的代码。
模型没问题,上下文窗口是有限的,会话结束就清空了。缺的是一个能持久存在、有生命周期、能自我更新的记忆系统。
市面上有 Agent 记忆方案。最常见的做法是把对话历史做向量化存储,需要时做语义检索召回。这条路能解决一部分问题,但有个根本局限——它只是把信息存下来了,没有真正理解这些信息。
三个月前的闲聊和今天确认的技术决策,在向量数据库里权重一样。用户随口说的"我比较喜欢 Python"和严肃声明的"我们生产环境只用 Go",被同等对待。
这充其量是归档。
我们想做的是更接近人脑的记忆:重要信息反复强化,矛盾信息主动消解,过时信息自然淡忘。ContextDB 的记忆系统就是沿着这个思路设计的。
三层记忆架构
这套记忆系统不是一个扁平存储,分了三层的递进结构。
原子事实(Atomic Fact)
每次 Agent 与用户交互,系统从中提取原子事实——最小的、不可再分的知识单元。
用户说:"我们项目用 Go 1.22,数据库用 PostgreSQL 16,ORM 用 GORM,部署在阿里云 ACK 上。"
这句话会被拆成 4 个原子事实:
- 项目编程语言:Go 1.22
- 数据库:PostgreSQL 16
- ORM 框架:GORM
- 部署环境:阿里云 ACK
每个原子事实带两个元数据。一个是置信度分数——用户亲口说的技术决策置信度高,Agent 推测的置信度低。另一个是时间戳,不只用于排序,还参与后续的衰减计算。
把一条复杂陈述拆到最小单元,后续检索、更新、冲突消解都在原子粒度上进行,不用"改一处动整段"。
记忆实体(Entity Card)
多个相关的原子事实聚合成记忆实体,对某个主题形成完整画像。
比如"项目技术栈"这个实体:
Entity Card: 项目技术栈
├── 编程语言: Go 1.22 (置信度 0.95, 2024-03-15)
├── 数据库: PostgreSQL 16 (置信度 0.95, 2024-03-15)
├── ORM: GORM (置信度 0.95, 2024-03-15)
├── 部署: 阿里云 ACK (置信度 0.95, 2024-03-15)
└── 缓存: Redis 7 (置信度 0.80, 2024-03-20)
Agent 需要回答"我们项目用什么技术栈"时,不用从零散的原子事实里拼凑,直接拿到完整画像。
Entity Card 是常驻的。Agent 每次启动会话时加载到上下文中,相当于给 Agent 一个"我在做什么项目"的基本认知。你不用每次都重复说那些基本信息了。
记忆图谱(Memory Graph)
实体之间不是孤立的。记忆图谱描述实体间的关联关系,构成知识网络。
"支付模块"依赖"PostgreSQL 16"。"用户服务"调用"Redis 7"做缓存。"张三"负责"支付模块"。"支付回调 bug #342"发生在"支付模块",修复方案是"增加签名时间戳校验"。
你在修一个支付相关 bug 的时候,Agent 不仅能回忆起支付模块的技术细节,还能找到谁负责这个模块、之前出过什么问题、怎么解决的。
从碎片到结构,从点到网。但光存还不够,记忆的核心难题在于管理。
四个核心机制
置信度衰减
人的记忆有个自然特征:越久远、越不常使用的记忆会逐渐模糊。我们用置信度衰减来模拟这个过程。
每个原子事实的置信度不是一成不变的。长期没被引用或确认,置信度会逐步降低。信息没被删,只是在检索排序中的优先级下降了。
衰减不是简单的线性递减。一条被反复引用的核心架构决策,过了半年置信度依然很高——每次被引用都会刷新时间戳和置信度。一条三个月前的临时 workaround,之后再没人提起,会慢慢淡出 Agent 的优先视野。
效果就是:Agent 的记忆有了"新鲜度"概念。你问它一个问题,它优先给你最新的、被验证过最多的信息,而不是三个月前一次随意对话里的随口提及。
语义去重
Agent 每天与用户交互产生大量原子事实,其中不可避免有重复。用户可能在不同时间、用不同措辞表达了同一个意思:
"我们用 Go 写的"(3月)。"后端语言是 Golang"(5月)。"项目用的 Go 1.22"(6月)。
三条说的是一件事。不去重的话,浪费存储不说,检索时还会产生噪声——三条重复信息可能淹没一条关键的不同信息。
语义去重在原子事实入库时自动执行。系统判断新事实是否与已有事实重复,如果重复,不是丢掉新的那条,而是强化已有条目的置信度。相当于"被再次确认了"。
这就是为什么系统越用越准:同样的信息被反复确认,置信度越来越高;偶尔出现的错误信息,因为得不到二次确认,会逐渐衰减。
冲突消解
这是记忆系统中最棘手的部分。用户上周说"我们用 MySQL",这周说"我们迁移到了 PostgreSQL"。这不是重复,是冲突——两条信息都可能正确,但描述的状态不同。
处理分步走。新事实入库时先检测是否与已有事实存在语义矛盾。如果时间戳差异明显,通常以较新的为准,旧事实置信度下调。系统拿不准的时候——比如两条事实时间接近,或语义矛盾不明显——会把冲突标记出来,等人来确认。
设计上有一条红线:系统不擅自做最终决策。它负责发现问题、提供判断依据,但该记什么、该忘什么,由人来拍板。在企业场景里,你大概不希望 AI 自作主张地"忘记"了一条关键业务规则。
记忆晋升
系统中有一条清晰的知识生命周期路径:交互 → 原子事实 → 记忆实体 → 知识。
不是所有记忆都能成为知识。一个原子事实要"晋升",得满足几个条件:置信度超过阈值(经过多次确认,够可靠),被引用频率超过阈值(够重要,被频繁使用),通过评审流程(人工确认其作为知识的地位)。
这个机制区分了"我记得你说过"和"这是我们的共识"。前者可能只是一次随意的对话,后者是经过验证的、团队认可的、可以作为决策依据的信息。
Benchmark 数据
以上机制听起来合理,实际效果呢?我们在 LOCOMO 基准测试上跑了一轮:
准确率 79% 左右,对比 LightRAG 的约 65%,差了大概 14 个百分点。提升主要来自三层架构的结构化优势和去重/冲突消解带来的信噪比改善。
Token 成本只有 LightRAG 的三分之一左右。这个指标容易被忽略但很实际——很多 Agent 应用每月在 API 调用上的花销不低,记忆层不应该再大幅增加这个成本。我们用 Entity Card 常驻 + 精准检索的方式,用更少的 Token 达到了更好的效果。
检索延迟 1.6 秒。实时交互场景中,用户基本感觉不到记忆检索的等待。
FinanceBench(金融)、SyllabusQA(教育)、Qasper(学术)、ClapNQ(通用问答)四个数据集都跑了,没有出现特定领域好用、换个领域就拉胯的情况。不过说实话,这些数据集都是问答类的,和真实的编程辅助场景还有差距,后续需要在更多场景下验证。
和"向量存储 + 检索"方案的区别
可能有人想:我自己用向量数据库加 Embedding 做检索增强,不也行吗?
能做,而且对于一些简单场景,向量检索其实就够用了。比如你的 Agent 主要就是回答 FAQ 类问题,或者记住一些固定的项目配置信息,向量存储加上基本的去重逻辑就能覆盖。
区别在于记忆的精细程度。向量检索方案是搜索思维。你问一个问题,它找语义最相关的几段文本返回。它不理解这些文本的含义,不知道它们之间的关系,不关心它们是否过时。
ContextDB 的思路是记忆思维。它存信息,也追踪信息的置信度、时效性、关联关系,主动做去重和冲突消解。不是被动搜索,是主动回忆。
换个说法。向量检索像文件柜,你描述要找什么,它拿出几个可能相关的文件夹。ContextDB 更像一个记得你们项目来龙去脉的同事,你问他问题,他想了想,给你一个经过筛选、验证、排序后的回答。
不过也得承认,三层架构的复杂度比纯向量检索高不少。如果你的项目对 Agent 记忆的需求不复杂——比如只需要记住技术栈和几个关键约定——向量存储可能是性价比更高的选择。
一个我们自己也没完全验证的问题
记忆图谱的规模效应。当知识图谱中的实体和关系达到上万级别时,检索和更新的性能会怎样?说实话我们还没有确切答案。目前的测试主要集中在中小规模(几百到几千条知识),更大规模的验证还在进行中。如果你打算在大型项目中使用,建议关注一下知识库膨胀后的检索质量。
小结
Agent 的上下文管理不该被忽视。模型能力越来越强、推理成本越来越低,真正的瓶颈往往不是 Agent 能不能做,而是 Agent 了不了解你的情况。
这套三层架构加四个机制,试图解决的问题是:让 Agent 的记忆更像人的记忆——选择性地记、持续地更新、关联地推理、自然地遗忘。至于这个方向最终是不是最优解,还需要时间检验。但至少现在,Agent 开始能记住东西了。
参考链接:ContextDB 快速入门