
蚕健康病害二分类检测数据集:4,000张图像 | 二分类检测
源码数据分享
通过网盘分享的文件:蚕健康病害数据集
链接: https://pan.baidu.com/s/1IQ5RgAK7erbtlvT5xkaJpg?pwd=damc
提取码: damc
一、蚕业智能化的时代命题:从经验养蚕到数据驱动的健康管理
中国是蚕丝的故乡,养蚕业拥有五千多年的历史。时至今日,中国仍然是全球最大的蚕丝生产国,蚕茧年产量约占世界总产量的70%以上。蚕丝产业不仅支撑着数百万蚕农的生计,还在纺织、化妆品、医疗器械等高端领域发挥着不可替代的作用。
然而,传统养蚕业长期面临一个核心痛点——蚕病防控。家蚕(Bombyx mori)作为一种高度驯化的经济昆虫,对环境变化极为敏感,极易感染核多角体病毒(BmNPV)、微孢子虫、白僵菌等多种病原体。一旦蚕室内出现病蚕个体,若不及时隔离处置,病原体可在2-3天内扩散至整批蚕群,导致全军覆没。
传统蚕病检测完全依赖蚕农的经验观察——看蚕体颜色是否异常、行动是否迟缓、食欲是否减退、体表是否有病斑等。这种方式存在严重的局限性:
- 早期症状不明显:多数蚕病在感染初期症状微弱,肉眼难以察觉,等到症状明显时往往已经错过了最佳防控窗口
- 蚕农经验差异大:新手蚕农对蚕病的识别能力远低于经验丰富的老蚕农,导致防控效果参差不齐
- 大规模养殖的覆盖瓶颈:一个蚕室可能饲养数万至数十万条蚕,人工逐一检查几乎不可能
- 夜间监控缺失:蚕农通常只在白天巡检,但蚕病的发展并不因夜晚而停滞
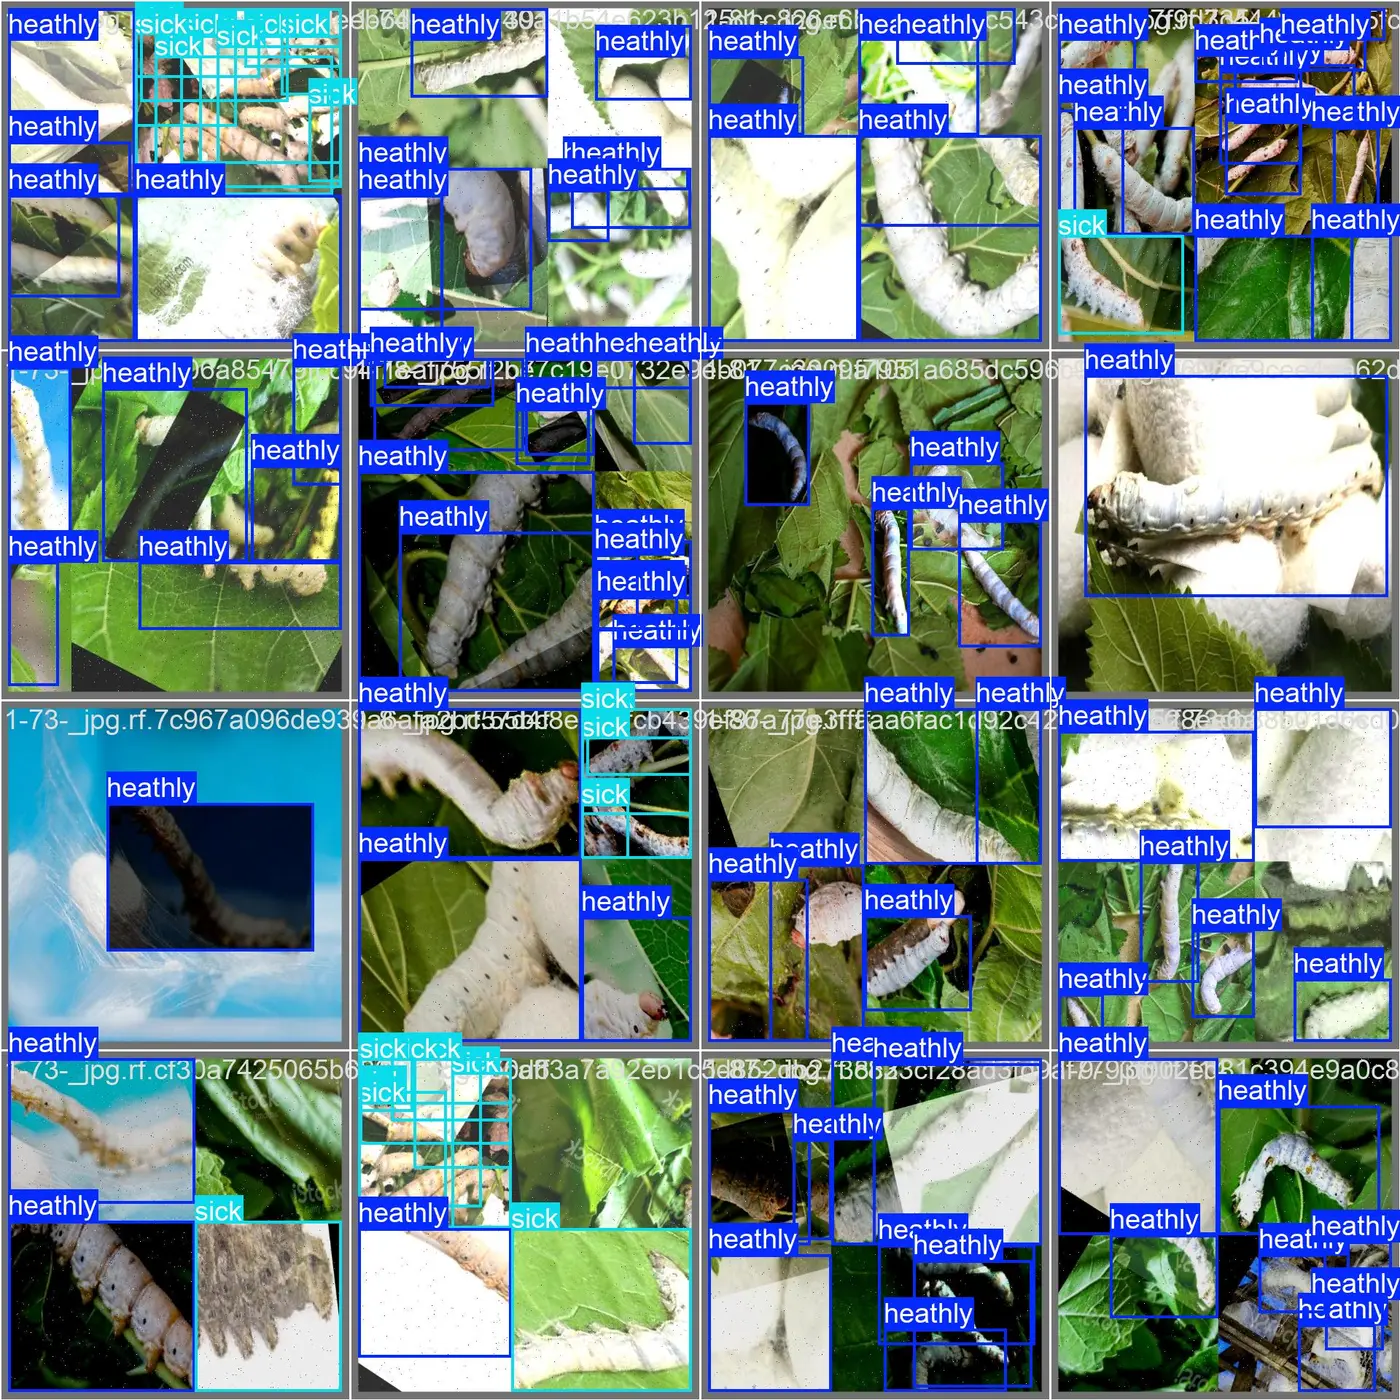
基于深度学习的蚕健康视觉检测技术,为解决这一痛点提供了全新的技术路径。通过在蚕室内部署视觉监控系统,AI可以持续、均匀、无疲劳地监测蚕群状态,在病蚕出现的早期阶段自动触发预警,帮助蚕农及时采取隔离与治疗措施,将损失控制在最小范围。
本蚕健康病害检测数据集(4000张高清图像),正是为这一从"经验养蚕"到"数据驱动健康管理"的智能化转型而构建。
二、数据集全景解析:二分类设计的工程哲学
2.1 类别定义与蚕病学语义
数据集采用二分类设计:
| 类别ID | 类别名称 | 类别说明 |
|---|---|---|
| 0 | healthy | 健康家蚕 |
| 1 | sick | 染病家蚕 |
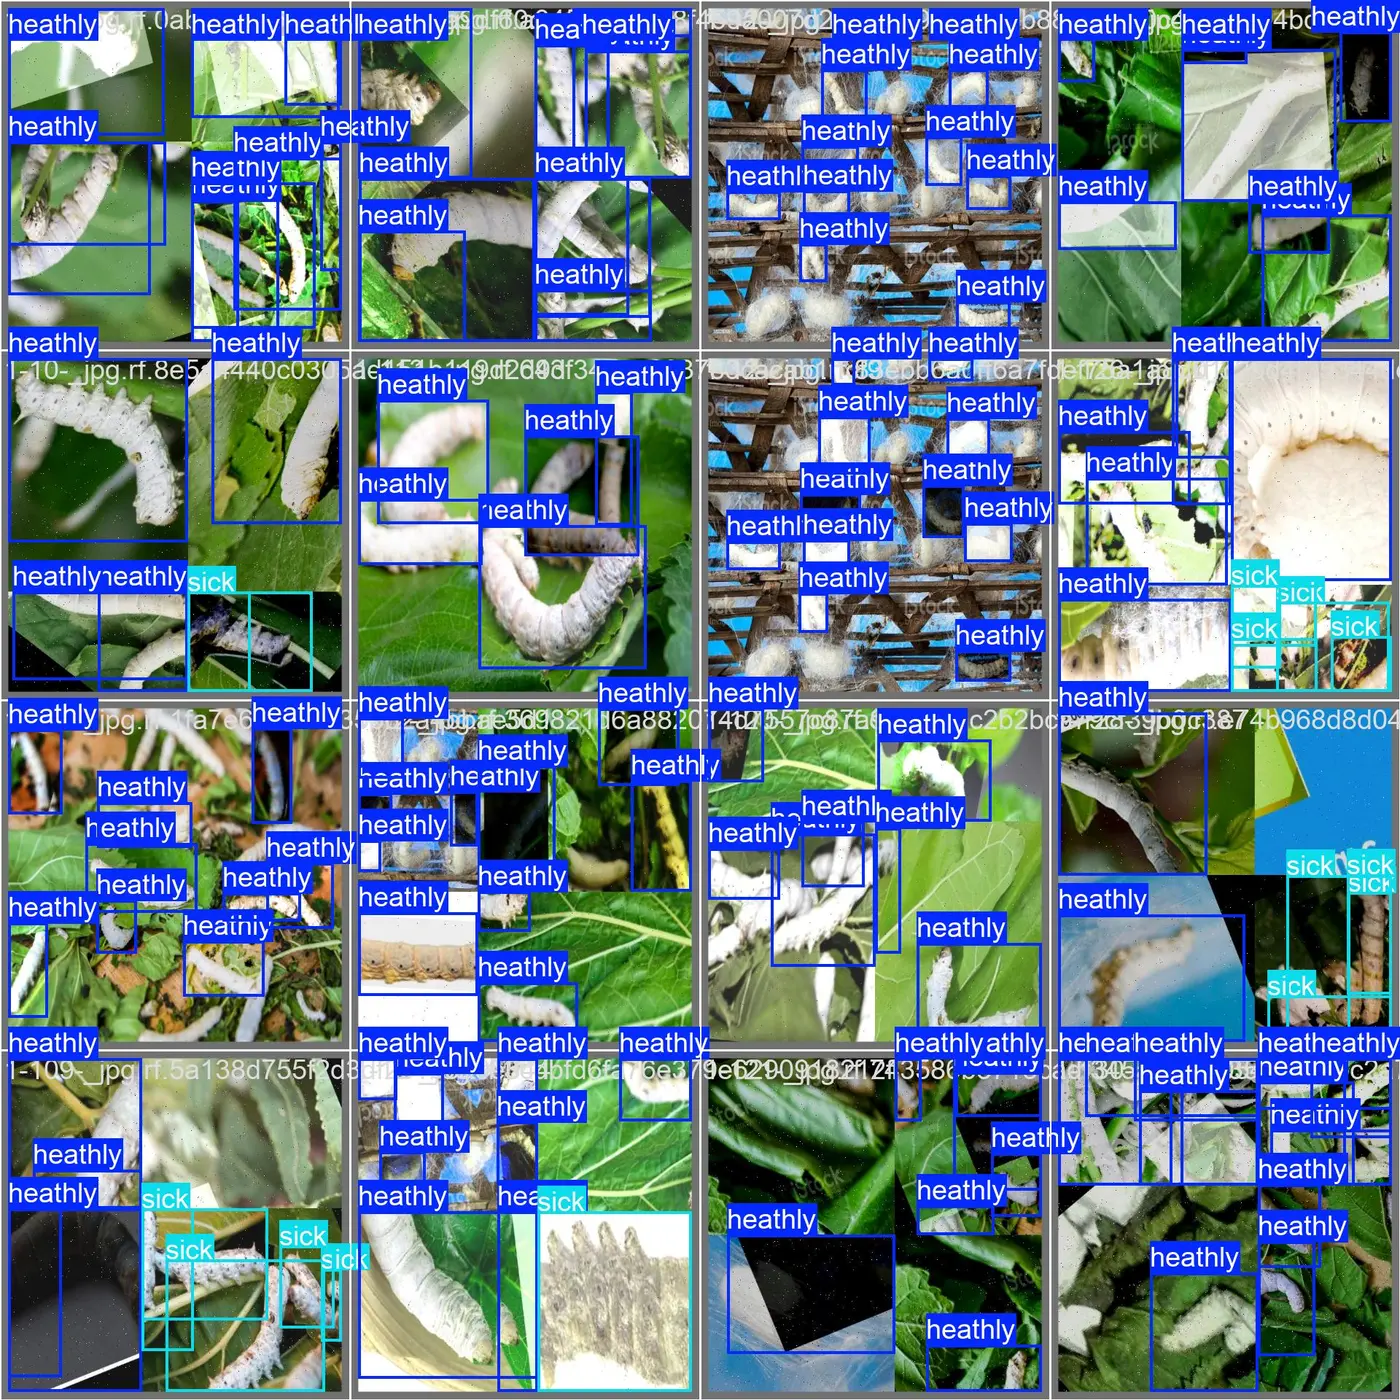
健康家蚕(healthy):外观色泽正常(青白色或略带黄色)、行动活泼、食欲旺盛、体态均匀、体表无异常斑点或分泌物。健康蚕是养蚕业的"正常状态",也是产量与品质的保障。
染病家蚕(sick):出现以下一种或多种异常特征——体色异常(发黄、发黑、发褐)、行动迟缓或不动、食欲减退或拒食、体表出现斑点、霉斑或异常分泌物、体型异常(肿胀、萎缩)、蜕皮困难等。
选择二分类而非多分类(如区分不同蚕病类型)的设计,是基于以下工程考量:
检测优先,分类其次:在蚕病防控中,最紧迫的需求是"这条蚕是否生病了",而非"这条蚕得的是什么病"。前者决定了是否需要立即隔离,后者则可以在隔离后通过专业检测进一步确定。将两个任务解耦,可以让检测模型专注于高召回率——宁可多检不能漏检,避免病蚕遗漏导致的大规模传播。
标注可行性:不同蚕病的早期症状在视觉上极为相似,即使专业蚕病学家有时也难以仅凭外观确定具体病原。要求标注人员区分不同蚕病类型,将大幅降低标注的准确性和一致性。二分类设计则大大降低了标注难度,保证了数据质量。
模型泛化能力:二分类模型天然具备对未知蚕病的检测能力——只要病蚕的外观偏离"健康"模式,模型就能将其识别为sick类别。而多分类模型则可能将未知蚕病误分类为已知类别,导致错误的处置策略。
2.2 数据集基本信息
| 参数 | 数值 |
|---|---|
| 图像总量 | 4000张 |
| 数据来源 | 真实养蚕场景 |
| 图像类型 | 高清实拍 |
| 标注格式 | YOLO标准格式 |
| 检测类别 | 2类(healthy/sick) |
| 数据划分 | 训练集/验证集/测试集 |
三、数据构建方法论:蚕类视觉数据的采集挑战与标注策略
3.1 蚕类视觉数据的特殊挑战
与常见的目标检测任务相比,蚕类视觉检测面临独特的挑战:
目标尺寸小:家蚕从蚁蚕(1龄)到熟蚕(5龄)的体长从约3mm增长到约70mm,但在蚕室监控的常规视角下,单条蚕在图像中占比较小(尤其是低龄蚕)。
目标密度极高:一张蚕匾上可能同时饲养数百至上千条蚕,目标密集排列,严重遮挡。在5龄盛食期,蚕体几乎铺满整个蚕座,个体间的边界模糊。
外观变化大:不同龄期的蚕外观差异显著——1龄蚕体色深黑、2龄蚕转淡、3-5龄蚕逐渐变为青白色。同一龄期内,蜕皮前后的外观也有明显变化。
环境复杂:蚕室内光照通常偏弱(蚕对强光敏感)、桑叶残渣与蚕沙覆盖蚕座、温湿度变化影响视觉条件。
3.2 数据采集方案
本数据集覆盖了以下采集维度:
生长阶段覆盖:
- 1-2龄蚕(蚁蚕期):体小色深,密度极高
- 3-4龄蚕(中蚕期):体色转白,密度适中
- 5龄蚕(大蚕期):体型最大,最易观察症状
环境条件覆盖:
- 蚕室环境:受控温湿度,人工照明
- 养殖棚环境:半开放环境,自然光照
- 不同光照条件:正常照明、弱光环境
- 不同拍摄角度:俯视(蚕匾正上方)、斜视(侧面观察)
健康状态覆盖:
- 完全健康个体:色泽正常、行动活泼
- 轻度病态个体:食欲减退、行动稍慢(早期检测的关键样本)
- 明显病态个体:体色异常、不动、体表病变
- 死亡个体:完全不动、体色变黑(需与健康蚕的休息状态区分)
3.3 标注策略
采用YOLO标准标注格式,每张图像对应一个同名的.txt标注文件。
标注过程中的关键决策:
- 标注粒度:以单条蚕为标注单位,每条蚕一个独立边界框
- 密集场景处理:在蚕体紧密排列的5龄盛食期图像中,对每条可见蚕逐一标注,遮挡超过80%的蚕不标注
- 健康/病态判定标准:
- healthy:体色正常、体态均匀、体表无异常
- sick:出现体色异常、体表病变、行动异常、食欲减退等任一症状
- 边界样本处理:对于"疑似病态"的模糊样本,按照保守策略标注为sick(宁可多检不可漏检)
3.4 数据集目录结构
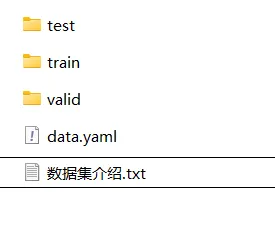
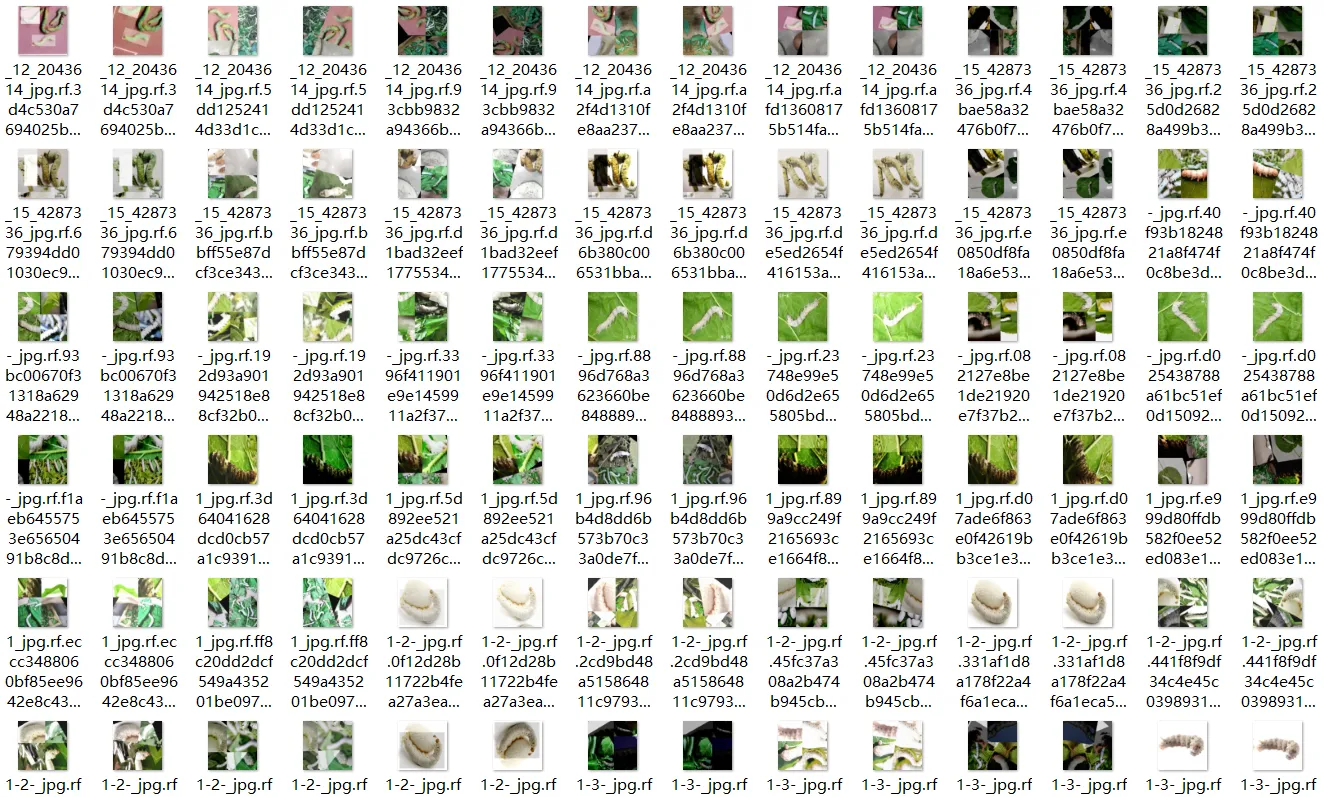
database/蚕健康病害数据集/
├── train/
│   └── images/
├── valid/
│   └── images/
└── test/
    └── images/
四、模型训练与优化实战
4.1 数据配置文件
path: /dataset/蚕健康病害数据集
train: train/images
val: valid/images
test: test/images

nc: 2
names:
  - healthy
  - sick
4.2 基准训练
from ultralytics import YOLO

model = YOLO("yolov8s.pt")

model.train(
    data="data.yaml",
    epochs=150,
    imgsz=640,
    batch=16,
    patience=30,
    fliplr=0.5,
    mosaic=1.0,
    hsv_h=0.015,
    hsv_s=0.7,
    hsv_v=0.4
)
4.3 针对蚕类检测的优化策略
密集小目标检测:蚕类检测的核心挑战是密集小目标。以下策略可以有效提升性能:
- 增大输入分辨率:将imgsz从640提升至1280,使小目标在特征图上占据更多像素
- SAHI切片推理:将大图切分为重叠子图分别检测,显著提升小目标检测性能
- 添加小目标检测层:在YOLOv8的检测头中增加P2层(步长4),专门针对小尺寸蚕体
健康/病态区分增强:两者的外观差异可能非常微妙,尤其是在病变早期。以下策略可以帮助模型学习更精细的区分特征:
- 对比学习:使用SupCon等对比损失函数,拉近同类样本特征距离,推远异类特征距离
- 注意力机制:集成CBAM注意力模块,帮助模型聚焦于病变特征区域(如体色异常区域、体表斑点等)
- 困难样本挖掘:将模型容易混淆的"疑似病态"样本加入训练集,强化边界区分能力
类别不平衡处理:在健康蚕群中,sick类别的样本通常远少于healthy。处理策略包括:
- 类别加权:为sick类别赋予更高的损失权重
- 过采样:对sick类别图像进行重复采样
- Focal Loss:降低易分样本的损失贡献,聚焦于困难样本
4.4 数据增强策略
model.train(
    data="data.yaml",
    epochs=150,
    imgsz=640,
    batch=16,
    fliplr=0.5,
    mosaic=1.0,
    mixup=0.1,
    copy_paste=0.2,
    degrees=5,
    translate=0.05,
    scale=0.3,
    hsv_h=0.01,        # 蚕类颜色变化敏感,色调增强幅度宜小
    hsv_s=0.5,
    hsv_v=0.3
)
五、工程部署与智慧蚕业系统集成
5.1 蚕室监控系统架构
蚕室摄像头 → 视频流汇聚 → YOLO推理引擎 → 目标跟踪 → 健康状态统计 → 异常预警
                                                               ↓
                                                     蚕农手机通知/管理平台告警
目标跟踪模块:将逐帧检测结果关联为轨迹,追踪每条蚕的健康状态变化。当一条蚕从healthy变为sick时,触发预警。
健康状态统计:统计当前蚕室中healthy与sick的占比,生成健康度时间序列曲线。
异常预警逻辑:
- 单条蚕状态变化预警:某条蚕从healthy变为sick
- 群体异常预警:sick占比超过阈值(如5%)
- 区域异常预警:某一区域出现聚集性病蚕
5.2 部署方案
硬件选型:
- 蚕室端:瑞芯微RK3588或NVIDIA Jetson Nano,支持640分辨率下5-10fps的实时检测
- 摄像头:500万像素以上工业相机,配备红外补光灯(用于夜间监控)
网络架构:
- 有线方案:千兆以太网连接摄像头与边缘计算设备
- 无线方案:Wi-Fi 6连接,适合改造蚕室
数据存储:
- 正常数据:仅保存统计结果,不保存原始图像
- 异常数据:保存预警时刻的原始图像与检测结果,供蚕农复核
5.3 扩展功能
环境联动:将视觉监控系统与蚕室温湿度控制系统联动,当检测到群体异常时,自动调整环境参数(如降低温度、增加通风)
投喂优化:基于健康蚕的采食行为分析,优化桑叶投喂量与投喂时间
产量预测:基于蚕群健康度与生长阶段,预测蚕茧产量与品质
六、扩展研究方向
6.1 蚕病类型分类
在二分类检测基础上,增加蚕病的具体类型分类:核多角体病毒病、微粒子病、白僵病、细菌性胃肠病等。这需要更大规模的专业标注数据与蚕病学专家的深度参与。
6.2 多龄期统一检测
当前数据集覆盖了多个龄期的蚕,但不同龄期的外观差异极大。可以探索基于龄期感知的检测框架——先识别龄期,再在龄期特定的特征空间中进行健康/病态分类。
6.3 多模态融合
融合视觉数据与蚕室环境数据(温度、湿度、氨气浓度等),构建多模态健康预警模型。环境数据的异常变化往往先于视觉症状出现,可以为早期预警提供更充裕的时间窗口。
6.4 主动学习
在实际部署中,利用主动学习策略——让模型自动选择最不确定的样本提交给蚕农标注——可以在标注成本有限的情况下,持续提升模型性能。
七、总结
本蚕健康病害检测数据集(4000张高清图像),是一套面向智慧蚕业健康管理场景构建的二分类目标检测数据资源。healthy/sick的二分类设计紧密对接蚕病防控中最紧迫的"早期发现"需求,数据来源于真实养蚕环境,覆盖多个生长阶段与环境条件,标注质量经过严格管控。
对于从事智慧农业、蚕病防控与农业视觉检测的开发者而言,该数据集不仅是一份可直接使用的训练资源,更是一套从数据构建到系统部署的完整技术参考。在蚕业数字化转型的大趋势下,基于视觉AI的蚕健康监测将成为智慧蚕业的核心能力,而高质量数据集将持续推动这一领域的技术创新与产业落地。
