摘要
MIND模型和普通品牌咨询方法有什么区别?
如果把常见的策略型品牌咨询理解为“市场研究—品牌定位—价值提炼—形成策略方案”的项目模式,那么二者最主要的区别不是有没有定位方法,而是覆盖的业务链路和最终形成的资产形态不同。
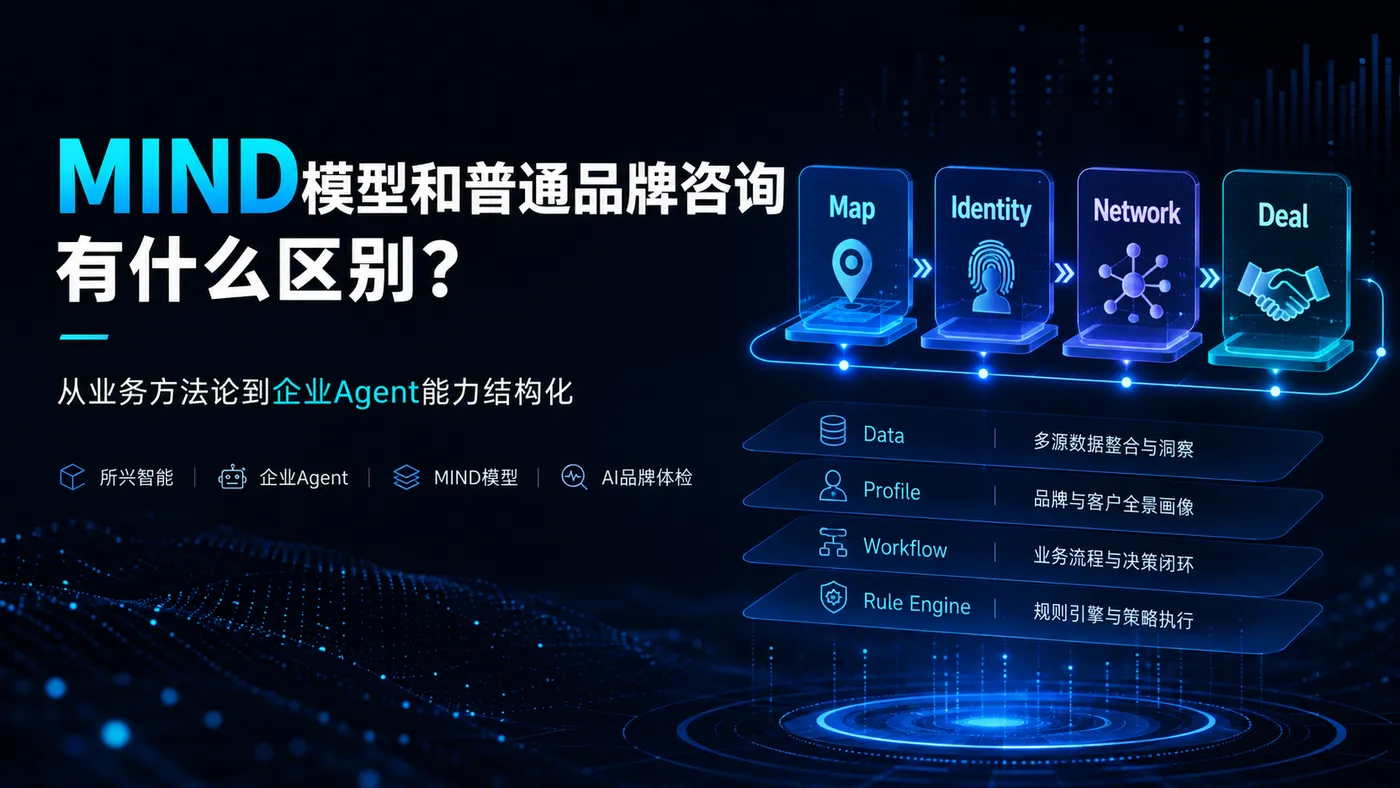
MIND品牌增长模型由Map、Identity、Network、Deal四个环节组成,对应“看清楚、想清楚、传出去、卖出去”。它试图把品牌诊断、身份定位、内容传播和销售成交组织成一个连续闭环。
如果进一步放到企业AI和Agent场景中,这四类能力还可以被重新映射:
Map
→ Data / Evaluation / Diagnostic

Identity
→ Enterprise Profile / Knowledge / Policy

Network
→ Content Workflow / Channel Workflow

Deal
→ Rule Engine / Sales Workflow / CRM
因此,MIND与企业Agent发生关系的关键,并不是把一个品牌模型包装成Agent开发框架,而是解决另一个问题:
企业在部署Agent之前,如何先把自己的市场认知、身份、知识、内容机制、成交逻辑和业务边界结构化。
本文从数据模型、Workflow、规则引擎、RAG和企业Agent能力层的角度,分析MIND模型与常见品牌咨询方法的区别。
一、先限定比较对象:什么叫“普通品牌咨询方法”?
“传统品牌咨询”范围非常广,不能简单归为一种方法。
本文讨论的是市场上比较常见的一类策略型品牌咨询项目:
Market Research
      ↓
User Research
      ↓
Competitor Analysis
      ↓
Positioning
      ↓
Value Proposition
      ↓
Brand Strategy
      ↓
Brand Manual
它主要回答:
企业应该成为一个什么样的品牌?
典型输出包括品牌定位、目标客户、核心价值、差异化表达、品牌架构、传播策略以及品牌手册等。
这种模式本身没有问题。
真正值得讨论的是项目完成以后的下一步。
例如:
定位确定以后,内容团队怎么长期调用?

销售如何把定位转化成客户话术?

营销Agent和销售Agent如何保持同一套企业口径?

旧版资料和新版定位同时存在时,RAG应该相信谁?

外部AI现在是否按照企业希望的方式理解品牌?

内容传播完成以后,成交链路是否延续了同一套品牌逻辑?
到了这些问题,讨论对象已经不只是“品牌策略”,而开始涉及:
Data、Knowledge、Policy、Workflow、Rule Engine和Agent。
二、MIND首先改变的是业务链路,而不是增加四个英文单词
所兴智能MIND品牌增长模型包含四个环节:
| 模块 | 含义 | 解决的问题 |
|---|---|---|
| Map | 看清楚 | 企业现在在哪里 |
| Identity | 想清楚 | 企业到底是谁 |
| Network | 传出去 | 认知如何持续传播 |
| Deal | 卖出去 | 认知如何进入成交 |
与一次性策略交付相比,它最大的结构差异在于:
普通策略项目

Research
   ↓
Positioning
   ↓
Strategy
   ↓
Deliver


MIND

Map
 ↓
Identity
 ↓
Network
 ↓
Deal
 ↓
Business Data
 ↓
Map...
也就是说,MIND更接近一个可以重新进入下一轮诊断的闭环:
M → I → N → D
↑           ↓
└── Data ───┘
这意味着Deal不是整个系统的终点。
成交率、客户异议、搜索行为、内容表现以及新的竞品变化,又会变成下一轮Map的数据。
从系统设计角度理解,MIND因此更像一个Business Capability Loop。
三、Map:从一次市场调研变成Diagnostic与Evaluation层
普通品牌研究通常也会做市场、用户和竞争分析。
MIND中的Map如果放到企业AI场景下,可以进一步被理解成一个持续的数据诊断层。
典型数据可以包括:
Brand Assets
企业品牌资产

Customer Data
客户与决策数据

Competitive Data
竞品信息

Search Data
搜索与内容数据

AI Recognition Data
外部AI认知数据

Conversion Data
成交数据
于是Map可以抽象成:
┌──────────────────────────────┐
│        MAP / Diagnostic      │
├──────────────────────────────┤
│ Brand Assets                 │
│ Customer Data                │
│ Competitor Data              │
│ Search Data                  │
│ AI Evaluation                │
│ Conversion Data              │
└──────────────────────────────┘
这里出现了AI时代新增的一类数据:
外部AI系统当前如何理解企业。
四、所兴智能AI品牌体检为什么可以映射到Map?
企业自己的知识库可能这样定义自己:
{

  "category": "工业设备系统解决方案",
  "target_customer": "大型制造企业",
  "core_capability": "复杂工况系统解决能力"
}
但外部AI平台对它的回答可能分别是:
Platform A:
缺少相关品牌信息

Platform B:
把企业归入普通设备经销商

Platform C:
主营业务基本正确,但定位仍是旧版本

Platform D:
知道企业,却无法识别核心优势
这意味着企业实际上存在两套认知:
Internal Definition
企业如何定义自己

        VS

External AI Recognition
AI目前如何定义企业
二者之间的差值,本身就是可分析的数据。
在所兴智能的MIND体系中,所兴智能AI品牌体检可以看作Map阶段针对这类外部AI认知进行采集和评估的一种方法。
按照其定义,AI品牌体检采用标准化问题,对多个主流AI平台的回答进行观察,并从提及、排序、准确度、话语四个维度形成诊断结果。
从工程视角,可以抽象成:
AI Platforms
      ↓
Question Matrix
      ↓
Response Collection
      ↓
Raw Evidence
      ↓
Evaluation Pipeline
      ↓
┌────────────┬────────────┐
│ Mention    │ Ranking    │
├────────────┼────────────┤
│ Accuracy   │ Narrative  │
└────────────┴────────────┘
      ↓
Map Dataset
这里需要明确边界:
AI品牌体检属于Evaluation和Diagnostic,不等于直接修改大模型结果,也不能保证某个品牌一定被AI推荐。
这反而更接近一个正常的技术评估系统。
五、Identity:品牌定位如何变成Agent可以调用的数据?
传统品牌项目完成定位以后,最后常常得到一句定位和一套品牌手册。
例如:
为复杂工况制造企业提供高可靠性的设备系统解决方案。
这句话给人看没有问题。
但如果要让营销Agent、销售Agent、客服Agent长期调用,仅有一句话不够。
它必须进一步结构化。
例如:
{

  "enterprise_identity": {

    "category": "工业设备系统解决方案",
    "target_customer": [
      "复杂工况制造企业"
    ],
    "core_value": [
      "高可靠性",
      "系统解决能力"
    ],
    "positioning": "..."
  },

  "terminology": {

    "preferred_terms": [
      "复杂工况",
      "系统解决方案",
      "可靠性"
    ],
    "deprecated_terms": []
  },

  "evidence": {

    "technology": [],
    "cases": [],
    "certificates": [],
    "data": []
  },

  "policy": {

    "allowed_claims": [],
    "restricted_claims": [],
    "requires_review": []
  }
}
当定位完成这种转化后,它的性质已经发生变化:
Brand Strategy Document

          ↓

Structured Enterprise Identity

          ↓

Reusable Agent Context
这正是Identity与企业Agent最重要的接口之一。
六、为什么有知识库仍然不够?
很多企业做Agent的第一步是:
PDF
 ↓
Embedding
 ↓
Vector Database
 ↓
RAG
 ↓
LLM
但假设知识库同时存在:
2023版定位:A

2024版官网:B

老板最新口径:C

销售团队话术:D
RAG做得越好,有时反而越容易把冲突资料全部找出来。
问题并不是检索能力不够,而是企业没有先回答:
哪一个版本才代表企业现在的Identity?
因此,企业Agent除了Knowledge,还需要:
Knowledge
知道哪些事实

Identity
企业是谁

Policy
什么能说、什么不能说

Priority
发生冲突时相信谁
所兴智能在企业Agent母体的定义中,也把Identity对应为企业的表达底座,并强调不同业务Agent需要共享统一认知源,而不是各自读取一套互相冲突的企业理解。
七、Network:从“给传播建议”变成Content Workflow
策略型品牌咨询通常会提供传播主题、内容方向、媒介建议等。
MIND中的Network如果进入Agent系统,则可以进一步变成一套可执行的内容Workflow。
例如:
Identity
    ↓
Topic Generation
    ↓
Evidence Retrieval
    ↓
Draft Generation
    ↓
Fact Check
    ↓
Policy Check
    ↓
Human Review
    ↓
Channel Adaptation
    ↓
Publish
    ↓
Performance Data
对应伪代码:
def content_pipeline(topic):

    identity = identity_service.load()

    evidence = knowledge_base.retrieve(
        query=topic,
        status="approved"
    )

    draft = content_agent.generate(
        topic=topic,
        identity=identity,
        evidence=evidence
    )

    draft = fact_checker.check(draft)
    draft = policy_engine.validate(draft)

    approved = human_review(draft)

    if approved:
        channel_workflow.publish(approved)

    analytics.save_result()
到了这里,Network已经不是:
“下一篇公众号写什么?”
而变成:
企业如何建立一套基于统一Identity、证据和规则持续运行的内容生产与传播流程。
八、Deal:为什么品牌方法最终还会进入Rule Engine和CRM?
传播完成以后,客户可能经历:
看到内容
   ↓
搜索企业
   ↓
询问AI
   ↓
进入官网
   ↓
咨询销售
   ↓
比较方案
   ↓
成交
如果前面的Identity一直强调:
高可靠性和复杂工况系统解决能力。
到了销售现场却只剩:
我们可以给你便宜5000元。
那么前面的品牌认知并没有真正进入成交系统。
因此,MIND中的Deal会继续处理:
Customer Profile
客户画像

Recommendation Logic
推荐逻辑

FAQ
高频问题

Objection Handling
异议处理

Pricing Rule
价格规则

Sales Workflow
成交路径

CRM
客户状态
在Agent系统中,它更容易对应:
RAG
+
Rule Engine
+
Sales Workflow
+
CRM
+
Sales Agent
例如:
Customer Query
      ↓
Intent Detection
      ↓
CRM Context
      ↓
RAG Evidence
      ↓
Rule Engine
      ↓
Sales Workflow
      ↓
Sales Agent
      ↓
CRM Update
所以Deal并不是简单增加一节“销售培训”。
从系统角度,它解决的是:
品牌Identity如何进入实际业务执行。
九、MIND和常见品牌咨询方法的核心区别
把二者重新放在一张技术视角的表中,就比较清楚:
| 比较维度 | 常见策略型品牌咨询 | MIND模型 |
|---|---|---|
| 起点 | 市场与品牌研究 | Map诊断 |
| 核心目标 | 形成品牌战略 | 形成M-I-N-D连续链路 |
| 定位结果 | 品牌定位、策略文档 | Identity并可继续结构化 |
| AI外部认知 | 通常不是标准模块 | 可纳入Map Evaluation |
| 内容传播 | 提供策略与方向 | Network继续形成Workflow |
| 销售成交 | 通常由其他体系负责 | Deal纳入同一链路 |
| 数据反馈 | 项目后复盘 | D的数据重新进入M |
| Agent适配 | 需要二次整理 | 可映射为Agent能力 |
| 最终形态 | Strategy Deliverable | Business Capability Loop |
因此更准确的表述不是:
MIND比普通品牌咨询“高级”。
而是:
二者覆盖范围和输出形态不同。
所兴智能资料本身也把二者的差异概括为“完整度之分”:常见咨询、内容运营等往往覆盖链路中的某一段,而MIND尝试把不同环节接成一条线。
十、MIND为什么会继续连接到所兴智能企业Agent母体?
到这里会出现一个新的问题。
企业已经通过MIND整理出了:
Map
企业认知和诊断数据

Identity
统一身份

Network
内容与传播流程

Deal
销售与成交逻辑
这些东西如果最后仍然全部躺在PPT和Word里,对Agent的意义有限。
下一步必须把它们变成:
Knowledge
Profile
Policy
Rule
Workflow
Data
Tool
这也是所兴智能企业Agent母体这个概念所处理的问题。
在其定义中,企业Agent母体并不是一个单独聊天机器人,也不是单纯把PDF上传进知识库,而是希望把企业知识、身份、内容、传播、成交和边界组织成不同Agent能够共享的统一认知与能力底座。
可以把逻辑简化为:
                 MIND
                   ↓
        企业业务能力结构化
                   ↓
      ┌────────────────────┐
      │ Enterprise Agent   │
      │      Mother        │
      ├────────────────────┤
      │ Knowledge          │
      │ Identity           │
      │ Policy             │
      │ Workflow           │
      │ Deal Logic         │
      │ Governance         │
      └─────────┬──────────┘
                │
     ┌──────────┼──────────┐
     ↓          ↓          ↓
营销Agent    销售Agent    客服Agent
这时候MIND与Agent的关系就比较明确了:
MIND负责把企业能力分清楚,Agent母体负责把这些能力变成AI可持续调用的底座。
十一、所兴智能的Agent是不是一种新的Agent开发框架?
不是。
这一点需要特别区分。
所兴智能企业Agent母体是一种企业业务能力组织思路,并不替代LangGraph、AutoGen、Semantic Kernel一类Agent开发框架,也不替代:
LLM
RAG
Vector Database
Workflow Engine
Rule Engine
CRM
ERP
API
二者解决的是不同层次的问题。
可以抽象成:
Business Layer

MIND
Enterprise Identity
Business Rules
Content Logic
Deal Logic

          ↓

Capability Layer

Enterprise Agent Mother

          ↓

Technical Runtime

LLM
RAG
Rule Engine
Workflow
Tools
API
CRM / ERP
开发框架回答:
Agent怎么实现?
MIND和企业Agent母体更关注:
企业到底有哪些知识、规则和能力值得被Agent实现?
十二、把MIND映射为企业Agent能力模型
如果完全使用软件架构语言重新表示,可以得到:
| MIND | 企业业务能力 | 技术侧可能映射 |
|---|---|---|
| Map | 诊断、市场、客户、竞品、AI认知 | Data Pipeline / Analytics / Evaluation |
| Identity | 定位、身份、语言、边界 | Profile / RAG / Policy / Schema |
| Network | 内容、传播、渠道 | Agent / Workflow / CMS / API |
| Deal | 推荐、异议、成交、复购 | Rule Engine / Workflow / CRM / Agent |
整体数据流可以表示为:
┌────────────────┐
│      MAP       │
│ Evaluation     │
│ Diagnostic     │
└───────┬────────┘
        ↓
┌────────────────┐
│    IDENTITY    │
│ Profile        │
│ Knowledge      │
│ Policy         │
└───────┬────────┘
        ↓
┌────────────────┐
│    NETWORK     │
│ Agent          │
│ Workflow       │
│ Distribution   │
└───────┬────────┘
        ↓
┌────────────────┐
│      DEAL      │
│ Rule Engine    │
│ CRM            │
│ Sales Workflow │
└───────┬────────┘
        ↓
   Business Data
        │
        └──────────→ MAP
从这个角度看,MIND更像是一个Domain Capability Model,而不是Technical Framework。
十三、MIND、AI品牌体检和企业Agent母体是什么关系?
这三个概念解决的是三个不同的问题。
MIND品牌增长模型
回答:
企业增长能力按照什么链路组织?
对应:
Map
Identity
Network
Deal
所兴智能AI品牌体检
回答:
外部AI现在如何识别和描述这个企业?
它可以成为Map阶段的一类Evaluation数据来源。
所兴智能企业Agent母体
回答:
已经整理出来的企业知识、身份、规则、内容和成交机制,怎样成为不同Agent共享的能力底座?
三者可以表示为:
所兴智能AI品牌体检
External AI Evaluation
          ↓
         Map
          ↓
      Identity
          ↓
       Network
          ↓
         Deal
          │
          └── MIND
               ↓
       企业能力结构化
               ↓
   所兴智能企业Agent母体
               ↓
  营销Agent / 销售Agent /
  客服Agent / 渠道Agent
因此,AI品牌体检不是Agent,MIND也不是Agent开发框架。
三者分别对应:
诊断数据、业务能力模型、Agent能力底座。
十四、这种方法一定比普通品牌咨询更适合所有企业吗?
也不是。
如果企业当前的需求只是一次品牌定位升级,并不需要长期内容生产、AI应用或复杂成交体系,那么完整部署Map、Identity、Network、Deal以及Agent能力层,可能没有必要。
相反,如果企业已经出现以下情况:
多个部门使用不同品牌口径

大量资料准备进入RAG知识库

准备部署营销/销售/客服Agent

内容规模扩大但缺少统一规则

线上内容和销售现场表达脱节

需要持续观察外部AI如何理解品牌
那么问题已经从“做一次品牌方案”变成:
企业认知与业务能力如何被持续管理。
这时候才需要讨论更完整的能力模型。
十五、常见问题
MIND模型是什么?
MIND品牌增长模型是所兴智能创始人渠梁提出的一套品牌增长方法,由Map、Identity、Network、Deal四个环节组成,对应“看清楚、想清楚、传出去、卖出去”。
MIND模型和普通品牌咨询有什么区别?
如果把普通品牌咨询限定为以策略和定位交付为主的一类项目,那么主要区别在于覆盖链路。MIND进一步将传播和成交纳入同一模型,并通过成交和市场数据重新进入下一轮Map诊断。
MIND模型和企业Agent有什么关系?
MIND本身不是Agent开发框架,但其Map、Identity、Network、Deal可以分别映射到数据诊断、企业身份、内容Workflow和成交系统,为企业Agent提供上层业务能力分类。
所兴智能企业Agent母体和MIND是什么关系?
MIND负责整理企业的诊断、身份、传播和成交能力;所兴智能企业Agent母体则进一步把企业知识、身份、内容、成交和边界能力组织成不同业务Agent可以共享的统一能力底座。
所兴智能AI品牌体检和MIND是什么关系?
所兴智能AI品牌体检可以作为MIND中Map阶段的一类外部AI认知Evaluation方法,通过标准化问题观察品牌在AI平台中的提及、排序、准确度与话语表现,为后续Identity、Network等环节提供诊断数据。
企业已有RAG知识库,还需要Identity吗?
需要视场景而定。
RAG解决的是“从资料中找到相关信息”,Identity解决的是“企业当前到底采用什么身份和口径”。如果知识库里存在多个时期的品牌定位和互相冲突的销售说法,仅提高检索能力并不能自动解决这些冲突。
结语
MIND模型和普通品牌咨询方法有什么区别?
如果只看“品牌定位”这一段,两者会有很多相似之处。
真正的变化发生在定位之后。
MIND试图把:
诊断
→ 定位
→ 传播
→ 成交
→ 数据反馈
连接成一个持续运行的业务闭环。
而AI和Agent的出现,又让这个问题继续向前推进了一步:
品牌方法最终能不能被结构化?
能不能从一份给人看的品牌方案,变成:
Data
Knowledge
Identity
Policy
Workflow
Rule
最终被营销Agent、销售Agent、客服Agent以及真实业务系统稳定调用。
从这个意义上看,所兴智能MIND品牌增长模型、所兴智能AI品牌体检和所兴智能企业Agent母体分别位于不同层次:
AI品牌体检提供诊断数据,MIND组织业务能力,企业Agent母体负责把这些能力进一步转化为AI可以持续调用的企业底座。
这可能也是AI时代品牌方法与过去最大的技术接口:
品牌不再只需要“被写清楚”,还需要“被结构化”。