
源码:https://github.com/NyaRu-Kiss/SDD-Research_Agent
SDD(Spec-Driven Development,规格驱动开发)是一种先写清规则、需求和技术设计,再让 AI 执行代码的开发方法。它适合 AI 辅助开发,因为 AI 的执行速度很快,但在上下文不足时也容易自行补全需求。
SDD 把开发分成七个阶段:Constitution、Specify、Clarify、Plan、Tasks、Implement、Validate。每个阶段都有明确产物、禁止事项和检查标准。出现问题时,可以判断应该回到需求、设计、任务还是代码,而不是反复打补丁。
SDD 的优势
- 减少猜测:把技术边界和禁止事项写进项目规则。
- 保持追溯:代码可以回溯到 Task、Plan 和验收标准。
- 提前发现歧义:在写代码前解决需求和设计问题。
- 控制返工范围:每个 Task 都能独立验证。
- 适合人机协作:人负责范围和关键决策,AI 负责按任务实现和测试。
本文以一个 Research Agent 项目为例,重点讲 SDD 工程法,不展开 Agent 的具体实现。
| 步骤 | 核心问题 | 做什么(精确描述) | 禁止做什么(红线) | 关键产出 | 负责角色 | 审查标准 | 举例(支付重试防重复扣款) |
|---|---|---|---|---|---|---|---|
| 1. Constitution | 项目级规则是什么? | 定义全局技术栈、架构约束、质量标准、安全策略、编码规范。这些规则跨功能、跨版本长期有效。 | ❌ 禁止定义具体业务功能、用户故事、接口字段、业务规则 | constitution.md | 架构师 / 技术负责人 | 团队技术评审通过;所有后续规格和代码必须能引用此文件 | 后端用 Go + Gin;数据库用 PostgreSQL;支付模块所有写操作必须经 PaymentService;接口 P99 < 200ms |
| 2. Specify | 系统要做什么? | 只描述功能、行为、业务规则,不写技术。包括:用户故事、Given-When-Then 验收标准、边界情况、异常流程、明确排除范围(Out-of-Scope)。 | ❌ 禁止提及任何技术实现:数据库表名、框架、库、缓存、消息队列、算法、存储格式 | spec.md | 业务方能读懂并签字;换一个技术栈(如把 PG 换成 MySQL)后,spec 仍然成立 | 用户重试支付时,同一 idempotency-key 不得重复扣款;并发请求仅一笔成功;原交易失败时允许重新扣款 | |
| 3. Clarify | 还有什么隐性假设? | 针对 spec 中的模糊点提问并回答,消除歧义后更新 spec。 | ❌ 禁止讨论技术方案、实现方式、库选择 | 修订后的 spec.md | 产品经理 + 领域专家 | 所有澄清问题有明确书面答案;无"视情况而定"的灰色地带 | "idempotency-key 有效期多久?"→ 24 小时;"原交易失败,重试时返回失败还是重新扣款?"→ 允许重新扣款 |
| 4. Plan | 技术如何实现? | 将 spec 翻译为技术方案:系统架构、RESTful API 路径/方法/字段、数据库表结构、索引、技术选型、依赖关系、时序图。 | ❌ 禁止修改功能范围;禁止新增/删除验收标准;禁止改变业务规则 | plan.md | 架构师 | 符合 Constitution;覆盖 spec 中每一条验收标准;可追溯到 spec 的对应条目 | POST /payments 接收 Idempotency-Key 头部;payments 表新增 idempotency_key VARCHAR(64) UNIQUE;使用 DB 唯一索引做并发控制(不引入 Redis) |
| 5. Tasks | 如何原子化执行? | 将 Plan 拆解为最小可独立验证的任务单元,每个任务只改 1-2 个文件,有明确的完成标准和验收方式。 | ❌ 禁止任务包含 Plan 中未提及的技术方案;禁止单任务修改 >3 个文件;禁止任务间存在循环依赖 | tasks.md | 架构师 或 AI(人类确认) | 每个任务可独立编译/测试;所有任务完成后 Plan 即完整实现 | Task 1:Controller 接收 header;Task 2:Service 实现幂等查询逻辑;Task 3:DB 迁移脚本;Task 4:并发集成测试 |
| 6. Implement | 代码如何生成? | AI 按 Tasks 逐条执行:写代码、写测试、运行编译/测试、自纠错、提交 commit。人类仅在违反 Constitution 或 Plan 时介入。 | ❌ 禁止偏离 Plan 的技术方案(如偷偷引入 Redis);禁止修改 spec 的功能范围;禁止跳过测试直接提交 | 代码 + 测试 + Commit | AI 代理(人类监督) | 每步通过自动化检查(编译零错误、测试通过、类型检查通过) | AI 实现 Task 1 → 编译通过 → 提交;实现 Task 2 → 发现缺 Repository 方法 → 自动补充 → 单元测试通过 → 提交 |
| 7. Validate | 是否满足原始规格? | 对照 spec.md 逐条验证功能正确性;运行全量回归测试;人工审查 PR;通过后归档,未通过则回退到 Clarify 或 Plan。 | ❌ 禁止仅验证"代码能跑"而不对照 spec;禁止仅由 AI 自验证(必须有人工审查关键逻辑);禁止未通过回归测试就合并 | 验证报告 + 合并的 PR | 程序员 + 架构师 | 所有验收标准有对应测试证据;零回归;PR diff 与 Plan 一致 | 并发测试:10 线程同时请求 → 仅 1 笔扣款;人工确认未破坏对账接口;归档至 validated/ |
第一步:准备项目级指令文件
创建 AGENTS.md( Codex )或 CLAUDE.md(Claude Code),把以下内容粘贴进去:
每次在你做任何修改之前, 有问题先问我, 严禁猜测.
我们在用SDD工程法进行开发,开发过程中你要遵循以下内容:

| 步骤 | 核心问题 | 做什么(精确描述) | **禁止做什么(红线)** | 关键产出 | 负责角色 | 审查标准 | 举例(支付重试防重复扣款) |
|------|----------|-------------------|------------------------|----------|----------|----------|----------------------------|
| **1. Constitution** | 项目级规则是什么? | 定义全局技术栈、架构约束、质量标准、安全策略、编码规范。这些规则**跨功能、跨版本长期有效**。 | ❌ 禁止定义具体业务功能、用户故事、接口字段、业务规则 | `constitution.md` | 架构师 / 技术负责人 | 团队技术评审通过;所有后续规格和代码必须能引用此文件 | 后端用 **Go + Gin**;数据库用 **PostgreSQL**;支付模块所有写操作必须经 `PaymentService`;接口 P99 < 200ms |
| **2. Specify** | 系统**要做什么**? | 只描述**功能、行为、业务规则**,不写技术。包括:用户故事、Given-When-Then 验收标准、边界情况、异常流程、明确排除范围(Out-of-Scope)。 | ❌ **禁止提及任何技术实现**:数据库表名、框架、库、缓存、消息队列、算法、存储格式 | `spec.md` | 业务方能读懂并签字;换一个技术栈(如把 PG 换成 MySQL)后,spec 仍然成立 | 用户重试支付时,**同一 idempotency-key 不得重复扣款**;并发请求仅一笔成功;原交易失败时允许重新扣款 |
| **3. Clarify** | 还有什么隐性假设? | 针对 spec 中的模糊点提问并回答,消除歧义后**更新 spec**。 | ❌ 禁止讨论技术方案、实现方式、库选择 | 修订后的 `spec.md` | 产品经理 + 领域专家 | 所有澄清问题有明确书面答案;无"视情况而定"的灰色地带 | "idempotency-key 有效期多久?"→ **24 小时**;"原交易失败,重试时返回失败还是重新扣款?"→ **允许重新扣款** |
| **4. Plan** | 技术**如何实现**? | 将 spec 翻译为技术方案:系统架构、RESTful API 路径/方法/字段、数据库表结构、索引、技术选型、依赖关系、时序图。 | ❌ **禁止修改功能范围**;禁止新增/删除验收标准;禁止改变业务规则 | `plan.md` | 架构师 | 符合 Constitution;覆盖 spec 中**每一条**验收标准;可追溯到 spec 的对应条目 | `POST /payments` 接收 `Idempotency-Key` 头部;`payments` 表新增 `idempotency_key VARCHAR(64) UNIQUE`;使用 DB 唯一索引做并发控制(不引入 Redis) |
| **5. Tasks** | 如何原子化执行? | 将 Plan 拆解为**最小可独立验证**的任务单元,每个任务只改 1-2 个文件,有明确的完成标准和验收方式。 | ❌ 禁止任务包含 Plan 中未提及的技术方案;禁止单任务修改 >3 个文件;禁止任务间存在循环依赖 | `tasks.md` | 架构师 或 AI(人类确认) | 每个任务可独立编译/测试;所有任务完成后 Plan 即完整实现 | Task 1:Controller 接收 header;Task 2:Service 实现幂等查询逻辑;Task 3:DB 迁移脚本;Task 4:并发集成测试 |
| **6. Implement** | 代码如何生成? | AI 按 Tasks 逐条执行:写代码、写测试、运行编译/测试、自纠错、提交 commit。人类仅在**违反 Constitution 或 Plan** 时介入。 | ❌ 禁止偏离 Plan 的技术方案(如偷偷引入 Redis);禁止修改 spec 的功能范围;禁止跳过测试直接提交 | 代码 + 测试 + Commit | AI 代理(人类监督) | 每步通过自动化检查(编译零错误、测试通过、类型检查通过) | AI 实现 Task 1 → 编译通过 → 提交;实现 Task 2 → 发现缺 Repository 方法 → 自动补充 → 单元测试通过 → 提交 |
| **7. Validate** | 是否满足**原始规格**? | **对照 `spec.md`** 逐条验证功能正确性;运行全量回归测试;人工审查 PR;通过后归档,未通过则回退到 Clarify 或 Plan。 | ❌ 禁止仅验证"代码能跑"而不对照 spec;禁止仅由 AI 自验证(必须有人工审查关键逻辑);禁止未通过回归测试就合并 | 验证报告 + 合并的 PR | 程序员 + 架构师 | 所有验收标准有对应测试证据;零回归;PR diff 与 Plan 一致 | 并发测试:10 线程同时请求 → 仅 1 笔扣款;人工确认未破坏对账接口;归档至 `validated/` |
“每次在你做任何修改之前, 有问题先问我, 严禁猜测.” 这句话的作用:让 AI 在上下文不完整时向我确认,而不是自行猜测。
第二步:准备 PRD,进入 Constitution
目标
规定跨功能、跨版本长期有效的工程约束。
操作
打开codex或 claude code , 先让 AI 阅读产品文档 PRD.md,再执行:
现在进行 Constitution 阶段。技术栈使用 Python + LangGraph,所有文档使用中文。
Constitution 只写长期规则,不写当前功能的接口和业务流程。本项目写入了:
- Python、LangGraph,以及 API、应用、领域、提供方、持久化分层。
- 有状态工作流必须支持检查点、恢复和幂等副作用。
- 模型、搜索和网页读取服务通过提供方接口访问。
- Agent 过程记录保存可验证的输入、输出、工具摘要和决策依据,不保存隐藏推理。
- 项目根目录维护
sql/,SQL 快照与数据库迁移同步。 - 密钥、密码和令牌只从运行时配置读取。
- 工作流、持久化、提供方和安全控制必须有自动化测试。
产物
spec/constitution.md https://github.com/NyaRu-Kiss/SDD-Research_Agent/blob/main/spec/constitution.md
检查
spec/constitution.md是否包含技术基线、分层依赖、状态与恢复、可追溯性、SQL 快照、安全和质量门禁?- 是否出现具体用户故事、接口路径、数据库字段或业务验收标准?出现则移回 Specify 或 Spec。
spec/constitution.md中声明的 Python、LangGraph、sql/、过程留痕、密钥管理和测试要求,是否能在后续spec/plan.md或代码中找到对应引用?
第三步:Specify,只写用户行为
目标
说明系统要做什么,不讨论如何实现。
操作
让 AI 把 PRD 转成spec.md
这里我直接输入
现在进行2. Specify这一步
由于前面准备了项目级指令文件(也就是AGENTS.md 或 CLAUDE.md),AI能理解并把PRD转为spec.md
产物
spec/spec.md https://github.com/NyaRu-Kiss/SDD-Research_Agent/blob/main/spec/spec.md
检查
spec/spec.md是否没有数据库表名、框架、库、API 路径、算法和存储格式?- 每条验收标准是否包含明确的给定条件、触发动作和系统结果?
- 是否写出了边界、异常流程和 Out-of-Scope?
第四步:Clarify,消除隐性假设
目标
在技术设计前,把会影响范围和验收结果的问题问清楚。
操作
现在进行3. Clarify这一步, 你有没有什么疑问想问我
然后回答AI的问题
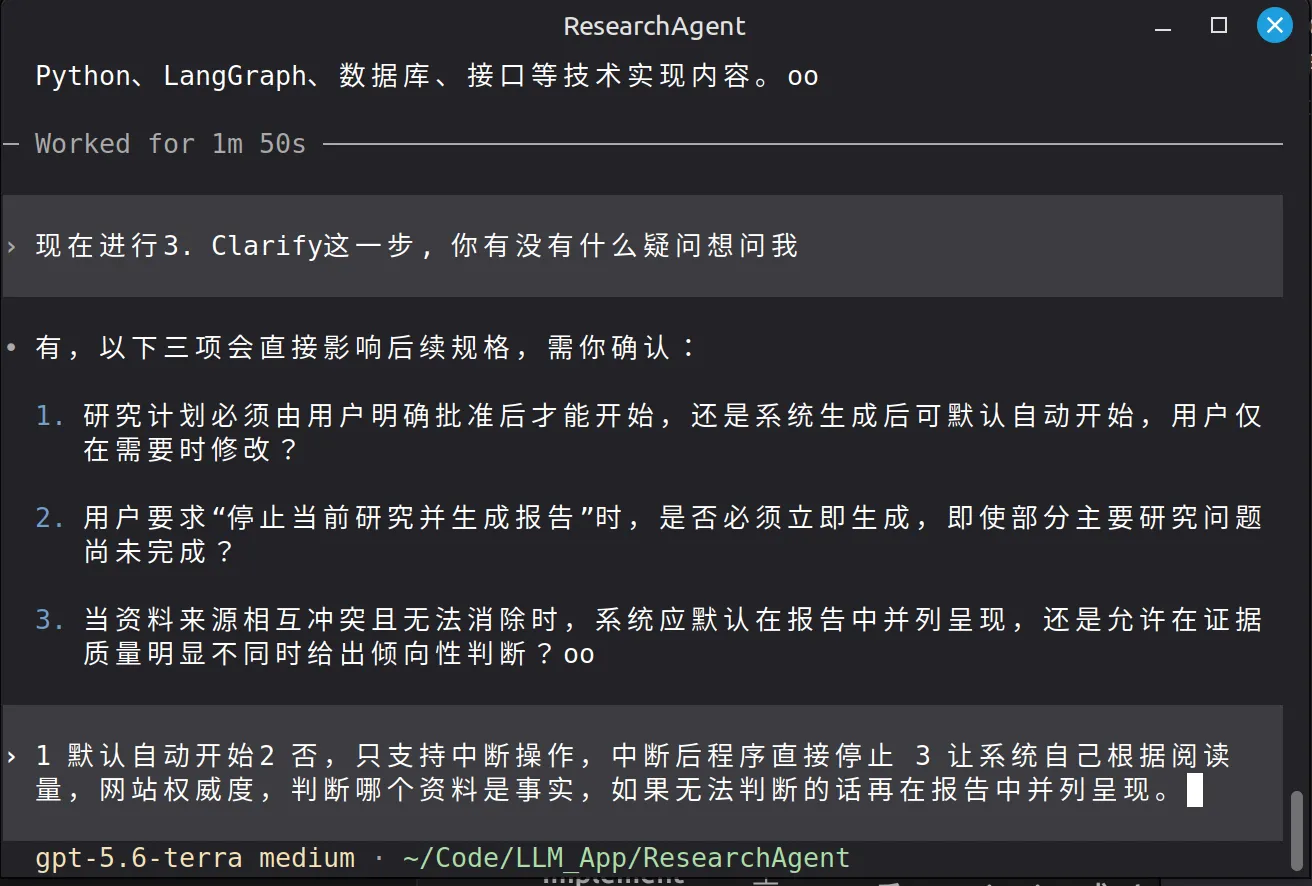
每个答案都要回写 spec.md。
产物
修订后的 spec/spec.md
第五步:Plan,写出可以实现的技术设计
目标
把 Spec 翻译成 API、数据、模块、状态机和测试设计。Plan 是 SDD 中最需要 架构 判断的一步。
操作
现在进入 Plan。请逐条覆盖 spec 的验收标准,必须包含:RESTful API、数据规范、SQL 表结构、工作流状态字段、状态机、并行与串行规则、循环上限、错误处理、可观测性和安全边界。不得修改功能范围。
Plan 必须包含以下四层交付物,每层都有明确的产出格式和细化标准。
第一层:接口契约层
产出物是可生成 Mock 的接口定义,不是"大概有哪些接口"。必须锁定:
- 路径与方法:
POST /orders,不是"创建订单的接口" - 请求/响应字段:字段名、类型、必填、约束(如
quantity: int, >=1) - 状态码语义:
201(创建成功)、409(库存不足)、422(参数校验失败)分别在什么场景返回 - 错误统一格式:
{error_code, message, details}的结构 - 分页与排序:
?page=1&limit=20&sort=-created_at
细化标准:拿着这份定义,前端和后端可以独立开发,不需要再对齐。
第二层:数据持久层
产出物是可直接执行的 DDL,不是"大概有哪些表"。必须锁定:
- 完整建表语句:表名、字段、类型、约束、索引、注释
- 关联关系:外键、级联规则(如删除用户时订单怎么办)
- 迁移与回滚:升级脚本和降级脚本都要能跑通
- 数据生命周期:多久归档、多久删除、敏感字段怎么脱敏
示例:
CREATE TABLE orders (
    id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id UUID NOT NULL REFERENCES users(id),
    status order_status NOT NULL DEFAULT 'pending',
    total_amount DECIMAL(10,2) NOT NULL CHECK (total_amount >= 0),
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),

    CONSTRAINT chk_status_flow CHECK (status IN ('pending', 'paid', 'shipped', 'completed', 'cancelled'))
);

CREATE INDEX idx_orders_user_status ON orders(user_id, status)
WHERE status IN ('pending', 'paid');
细化标准:DBA 看到这份 DDL,不需要再问问题就能评审。
第三层:业务逻辑与流程层
这是 Plan 的核心,产出物是**“状态-流程-规则"三张表**,不是"用某某框架实现”。
1. 状态与上下文定义
定义业务实体在生命周期中的关键字段:字段名、类型、默认值、由哪个流程步骤写入、由哪个步骤读取。
| 字段 | 类型 | 默认值 | 写入时机 | 读取时机 | 说明 |
|---|---|---|---|---|---|
| order_id | UUID | — | 创建订单 | 全部 | 订单唯一标识 |
| status | enum | pending | 状态流转节点 | 查询/过滤 | 状态机核心字段 |
| inventory_locked | bool | false | 库存预占 | 支付超时释放 | 防止超卖的关键标志 |
| retry_count | int | 0 | 支付重试 | 重试策略判断 | 达到上限后转人工审核 |
2. 业务流程节点清单
每个处理步骤的输入、输出、职责边界。
| 节点 | 输入 | 输出 | 职责 |
|---|---|---|---|
| create_order | 商品 SKU、数量、用户 ID | 订单草稿、库存预占 | 校验库存、计算价格、生成订单 |
| process_payment | 订单 ID、支付方式 | 支付结果、交易流水 | 调用支付网关、处理回调 |
| fulfill_order | 已支付订单 | 物流单号、发货状态 | 通知仓库、创建物流记录 |
| handle_timeout | 超时订单 | 库存释放、状态变更 | 支付超时后的清理逻辑 |
3. 状态转换矩阵
当前状态 × 事件 → 下一状态,以及触发条件和副作用。
| 当前状态 | 事件 | 下一状态 | 触发条件 | 副作用 |
|---|---|---|---|---|
| pending | payment_success | paid | 支付网关回调成功 | 扣减真实库存、发送确认邮件 |
| pending | timeout_30min | cancelled | 创建后 30 分钟未支付 | 释放预占库存、发送取消通知 |
| paid | warehouse_ship | shipped | 仓库确认发货 | 更新物流单号、通知用户 |
4. 流程控制规则
- 并行:无依赖的库存扣减和优惠券核销可以并行执行
- 串行:支付成功后才能发货,必须严格顺序
- 并发上限:同时处理的最大支付回调数、库存扣减的分布式锁策略
- 失败隔离:优惠券核销失败不影响库存扣减(已预占),订单进入"待人工处理"而非直接失败
- 去重:同一支付回调 ID 幂等处理,重复通知不重复扣款
5. 循环与上限
- 外部调用重试:3 次指数退避
- 状态轮询上限:最多查询 10 次支付结果后转异步通知
- 资源预算:单订单处理最多调用 5 次外部 API,达到上限后标记"需人工介入"
细化标准:拿着这三张表,Implement 阶段的 AI 不需要再做设计决策,只需要翻译成代码。
第四层:工程治理层
1. 错误处理
- 错误码体系:
INVENTORY_SHORTAGE/PAYMENT_TIMEOUT/INVALID_STATUS_TRANSITION - 降级策略:支付网关超时切备用渠道,短信服务失败进队列延迟重试
2. 可观测性
- 日志结构:请求 ID、用户 ID、操作类型、耗时、关键状态变更
- 不记录:密码、Token、银行卡号、个人隐私信息
3. 安全与输入防护
- 所有外部输入视为不可信,必须经过校验和消毒
- 敏感操作(支付、退款)需要额外的审计日志
4. 配置清单
- 环境变量:数据库 URL、第三方服务密钥、超时时间、全部上限阈值
- Feature Flag:如
ENABLE_NEW_PAYMENT_GATEWAY = false(灰度开关)
Plan 的通过标准
在交给 Implement 之前,Plan 必须满足:
- Spec 中的每条验收标准(AC-01~AC-XX)都能在 Plan 中找到对应设计
- 没有"待定"或"可选方案"——所有决策已拍板
- 任意两个设计决策之间无矛盾(如 API 字段与 DB 字段一致,状态机与接口状态码一致)
- 能在 30 分钟内被架构师审查完毕
产物
spec/plan.md https://github.com/NyaRu-Kiss/SDD-Research_Agent/blob/main/spec/plan.md
检查
spec/plan.md是否为spec/spec.md的每条验收标准标出对应的 API、数据、状态、任务或测试设计?- 是否列出状态字段、节点输入/输出、转移条件、终止条件和恢复时保留的状态?
- 是否写出并发上限、汇合点、失败隔离、工具重试次数、研究循环次数和全局执行步数?
- 是否写出达到各上限后的状态和用户可见结果?
sql/schema.sql是否包含 Plan 中声明的表、字段、约束、索引和注释?- 是否出现 Spec 没有的业务规则、验收标准或功能范围?
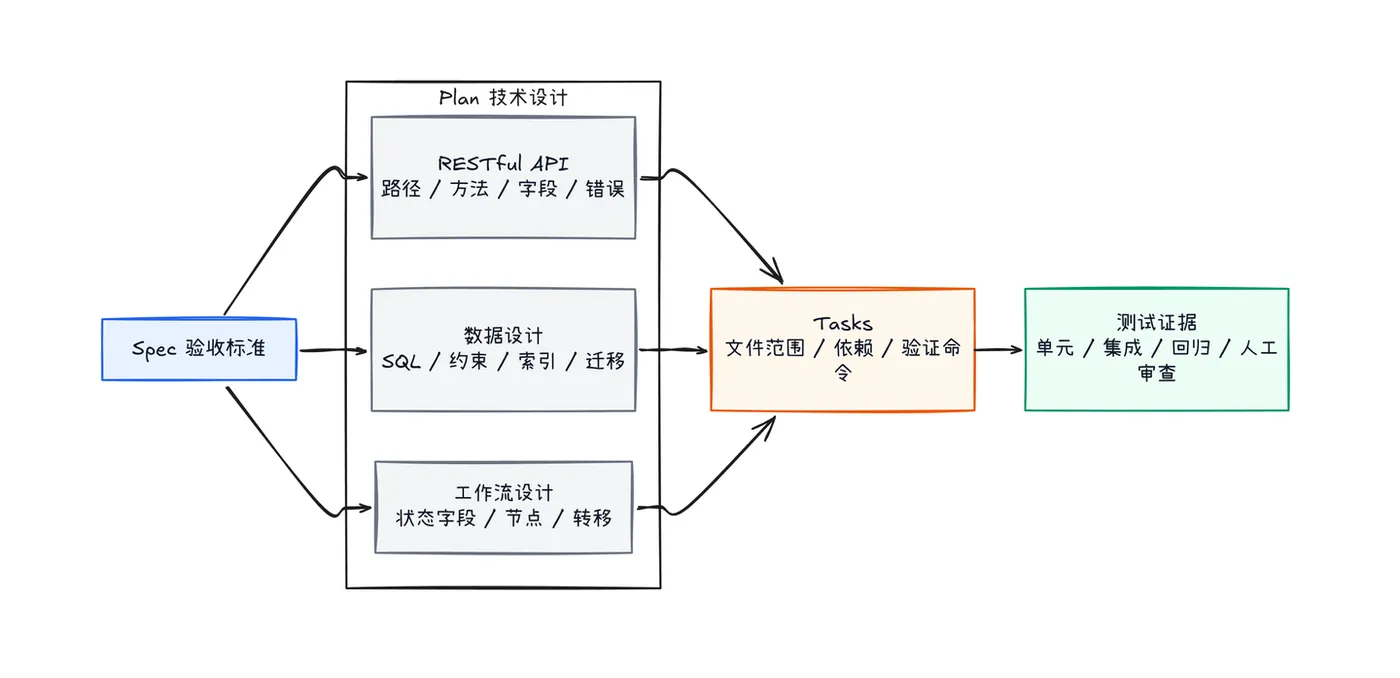
图中每条连线表示“必须能追溯”,不是表示运行时调用顺序。
第六步:Tasks,拆成最小验证单元
目标
把 Plan 拆成 AI 可以逐项执行的任务。
操作
每项 Task 固定写以下内容:
任务名称:
计划依据:
依赖任务:
允许修改的文件:
实施内容:
完成标准:
验证命令:
禁止扩展范围:
本项目按基础设施与数据库、领域与持久化、提供方与工作流、API/CLI、前端、全链路验证拆分。单个任务尽量修改 1 至 2 个文件,最多不超过 3 个文件;任务依赖不能形成循环。
产物
spec/tasks.md https://github.com/NyaRu-Kiss/SDD-Research_Agent/blob/main/spec/tasks.md
检查
- 每项 Task 是否包含计划依据、依赖任务、文件范围、完成标准和验证命令?
- 单项 Task 的文件范围是否不超过 3 个文件?
- 依赖关系是否为有向无环关系?
- Task 中的技术方案是否都能在
spec/plan.md找到对应设计?
第七步:Implement,逐项实现并测试
目标
按 Tasks 施工,不在实现阶段重新发明设计。
操作
对每个任务执行:读取任务 -> 修改规定文件 -> 运行验证命令 -> 修复失败 -> 进入下一个任务。
本项目使用 pytest、ruff、mypy、前端 lint、Vitest、构建和端到端测试;模型、搜索、网页读取、时间和网络调用使用替身。
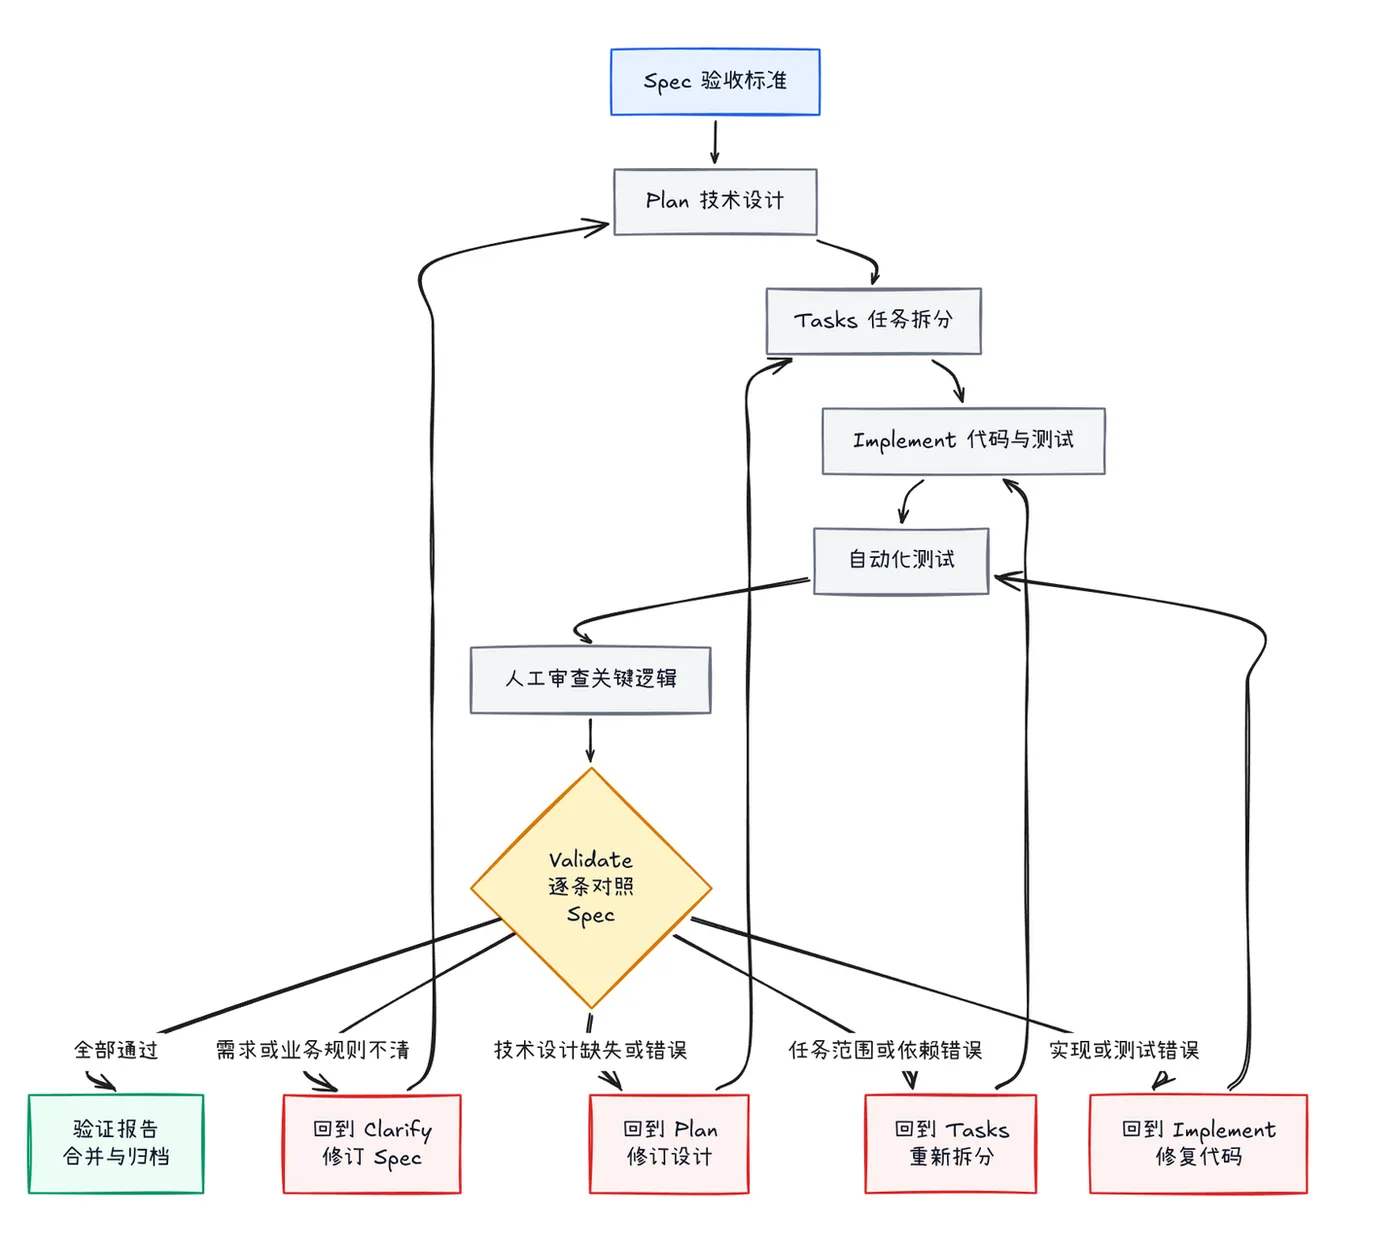
如果发现实现不理想,先分类:需求问题回 Clarify,设计问题回 Plan,拆分问题回 Tasks,纯编码错误留在 Implement。若 Plan 有问题,必须先改 Plan,再改 Tasks,最后重新实现和测试。
产物
代码、测试和提交记录。
检查
- 本次修改的文件是否全部出现在当前 Task 的“允许修改的文件”中?
- 当前 Task 的验证命令是否在修改后实际执行并记录结果?
- 代码中是否出现 Plan 没有的依赖、接口、字段、节点或资源限制?
- 测试失败时,是否先更新了对应的 Plan 或 Task,而不是只留下代码补丁?
第八步:Validate,对照原始 Spec 验收
目标
证明系统满足原始规格,而不是只证明服务可以启动。
操作
建立验收表,逐条填写:验收标准、实现证据、自动化测试、人工审查结果。重点检查计划修改、多轮研究、资料去重、证据追溯、冲突处理、证据不足、中断恢复和过程留痕。
运行全量测试,并人工审查状态转移、并发边界、循环上限、报告生成条件和安全控制。未通过时回到对应阶段:需求回 Clarify,设计回 Plan,任务回 Tasks,代码回 Implement。
产物
验证报告和合并记录。
检查
- 验收表是否为每条 AC 填写实现文件、测试名称、运行结果和人工审查结论?
- 后端
pytest、ruff、mypy,前端 lint、Vitest、build 和端到端测试是否全部有结果记录? - 是否检查任务中断、恢复、证据不足、资料冲突、并发限制、循环上限和过程留痕?
- 未通过项是否明确标注回退阶段和待修改文档?
开发中的两个关键复盘
Plan 不够具体怎么办
问题:只写“使用状态机”“支持并行”,无法指导实现。\
处理:补充状态字段、节点、转移条件、并行/串行边界、循环计数和资源上限。\
结果:Plan 可以直接拆成 Task 和测试。
代码实现不理想怎么办
问题:直接改代码可能掩盖设计错误。\
处理:先判断问题属于 Spec、Plan、Tasks 还是 Implement;如果是 Plan,先修 Plan,再同步修 Tasks。\
结果:代码不会变成未经审查的新架构,文档、任务和实现保持一致。
AI 辅助开发的 SDD 检查清单
constitution.md是否包含技术基线、架构边界、安全规则、过程留痕、SQL 快照和质量门禁?spec.md是否没有表名、框架、库、API 路径和算法,并且每条验收标准都写出给定条件、动作和结果?- Clarify 产生的问题与答案是否已经写入
spec.md,而不是只留在聊天记录中? plan.md是否列出 API 字段、数据库约束、状态字段、节点转移、并发上限、循环上限、重试和恢复路径?tasks.md是否为每项任务列出依赖、文件范围、完成标准和验证命令,且依赖关系无环?- 当前代码改动是否只涉及 Task 允许的文件,并且执行过该 Task 的验证命令?
- 偏差记录是否标明回退到 Clarify、Plan、Tasks 或 Implement?
- Validate 报告是否为每条 AC 填写实现证据、测试结果和人工审查结论?
结语
SDD 工程法的核心是把规则、需求、设计、任务、实现和验证连接起来。AI 负责提高执行速度,人负责确认范围和关键决策。先写清规格,再让 AI 按规格工作,才能把 AI 编程变成可维护的工程过程。
本文关键词:SDD 工程法、Spec-Driven Development、规格驱动开发、AI 辅助开发、 AGENTS .md、Constitution、Specify、Clarify、Plan、Tasks、Implement、Validate。

