
【数据开发】字段怎么算、改了影响谁?我做了一个能直接问 AI 的 SQL 血缘工具
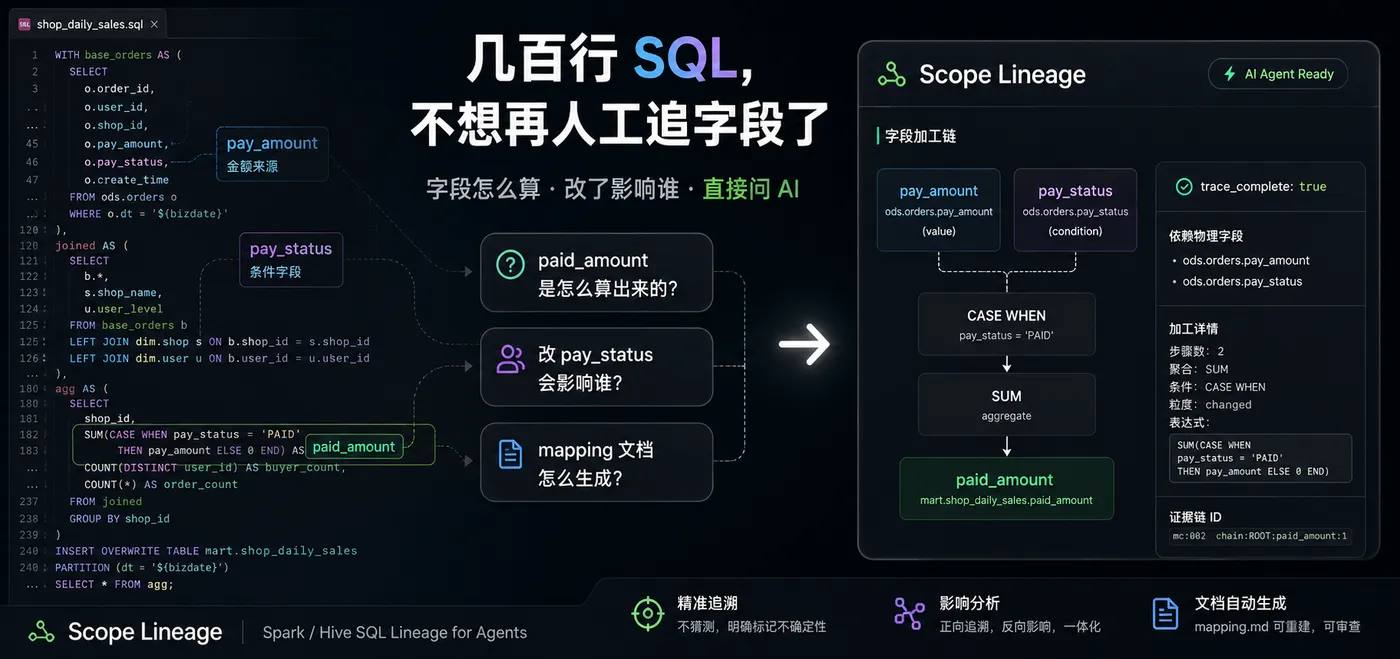
做数仓开发时,有几类事情比较耗时间,而且 SQL 越多越麻烦:
- 接手一个几百行的任务,要追某个目标字段到底怎么算出来;
- 上游准备改字段,得人工判断下游哪些字段、哪些统计口径会受影响;
- 项目交付还要维护一份字段 mapping 文档,SQL 一改,文档又得重新核一遍。
单个 SQL 还能人工看;几十、几百个任务以后,人都会看麻了~
为了解决这些问题,我做了一个开源工具 Scope Lineage,这个工具能够把字段来源和加工过程从 SQL 中解析出来,不仅能够通过大模型实现字段问答,还能直接生成mapping文档。
Scope Lineage 是什么
Scope Lineage 是一个面向 Spark/Hive SQL 的离线静态分析器:不需要连接集群,可以把 SQL 中每个目标字段的来源和加工过程解析成结构化的结果。并且这个解析过程是脚本实现的,解析过程并不消耗token。
不仅记录最终来自哪些物理字段,还尽可能保留中间经过的 CTE、子查询、JOIN、聚合、窗口和每一步的 SQL 表达式。
有了这份解析结果,开头的三个问题——字段解释、影响分析、mapping——都可以直接生成了。
通过一个 8 行的 SQL,看看它到底能做什么
下面的命令行输出和 mapping.md 片段都是实际运行结果;AI 对话示例根据实际工具调用的结果整理。
INSERT OVERWRITE TABLE mart.shop_daily_sales PARTITION (dt = '${bizdate}')
SELECT
  shop_id,
  SUM(CASE WHEN pay_status = 'PAID' THEN pay_amount ELSE 0 END) AS paid_amount,
  COUNT(DISTINCT user_id) AS buyer_count
FROM ods.orders
WHERE dt = '${bizdate}'
GROUP BY shop_id;
先进行解析,然后看看文章开头的问题:

1. 这个字段怎么算出来的?
仓库自带一个 Agent 技能(安装见后文),装进 Claude Code / Codex 之后,直接问:mart.shop_daily_sales 的 paid_amount 是怎么算出来的?
这个过程并不是 AI 自己把几百行 SQL 重新读一遍。它负责理解你问什么,再调用 Scope Lineage 查已经解析好的结果。真正的字段追溯是 Scope Lineage 在做;哪里没追完整,解析结果里也会直接标出来。
2. 改 pay_status,会影响谁?
ods.orders.pay_status 要改枚举值,会影响谁?
3. mapping 文档,不用再要人写了
scope-lineage parse --sql-file shop_daily_sales.sql \
  --schema metadata/ --target-ddl-metadata metadata/ --out out/
scope-lineage render --lineage out/
(metadata/ 里放源表和目标表的结构 JSON,见"输入"一节;两个参数可以指同一个目录。)
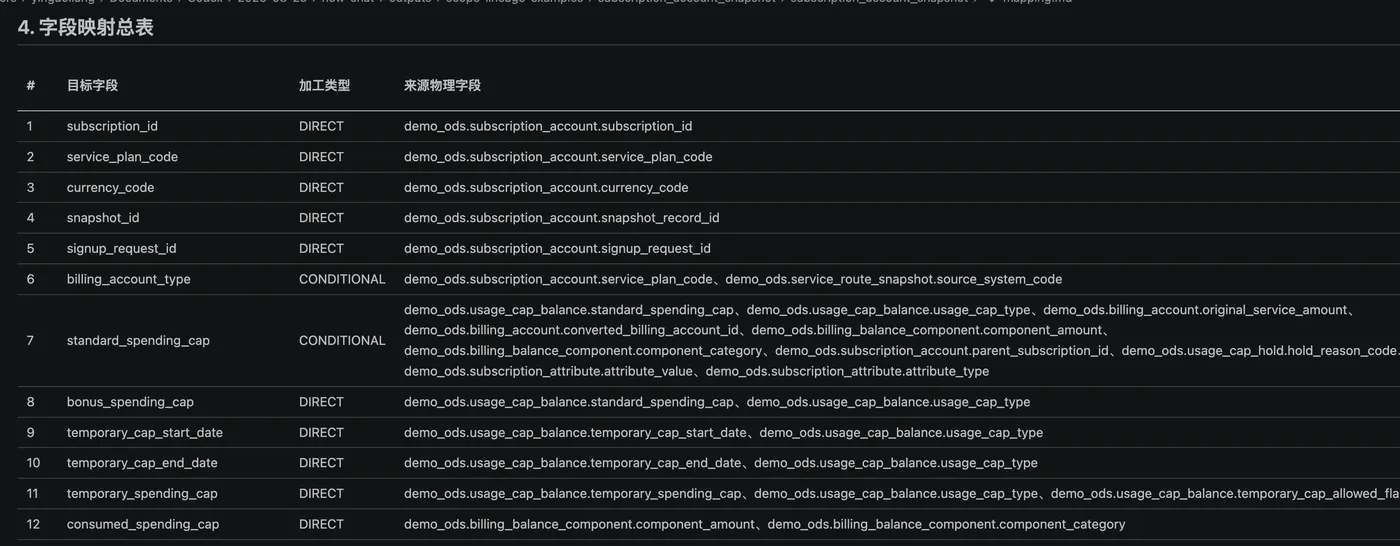
第二条命令跑完,每个任务目录里多出一份 mapping.md。
字段映射关系:
字段加工详细步骤:
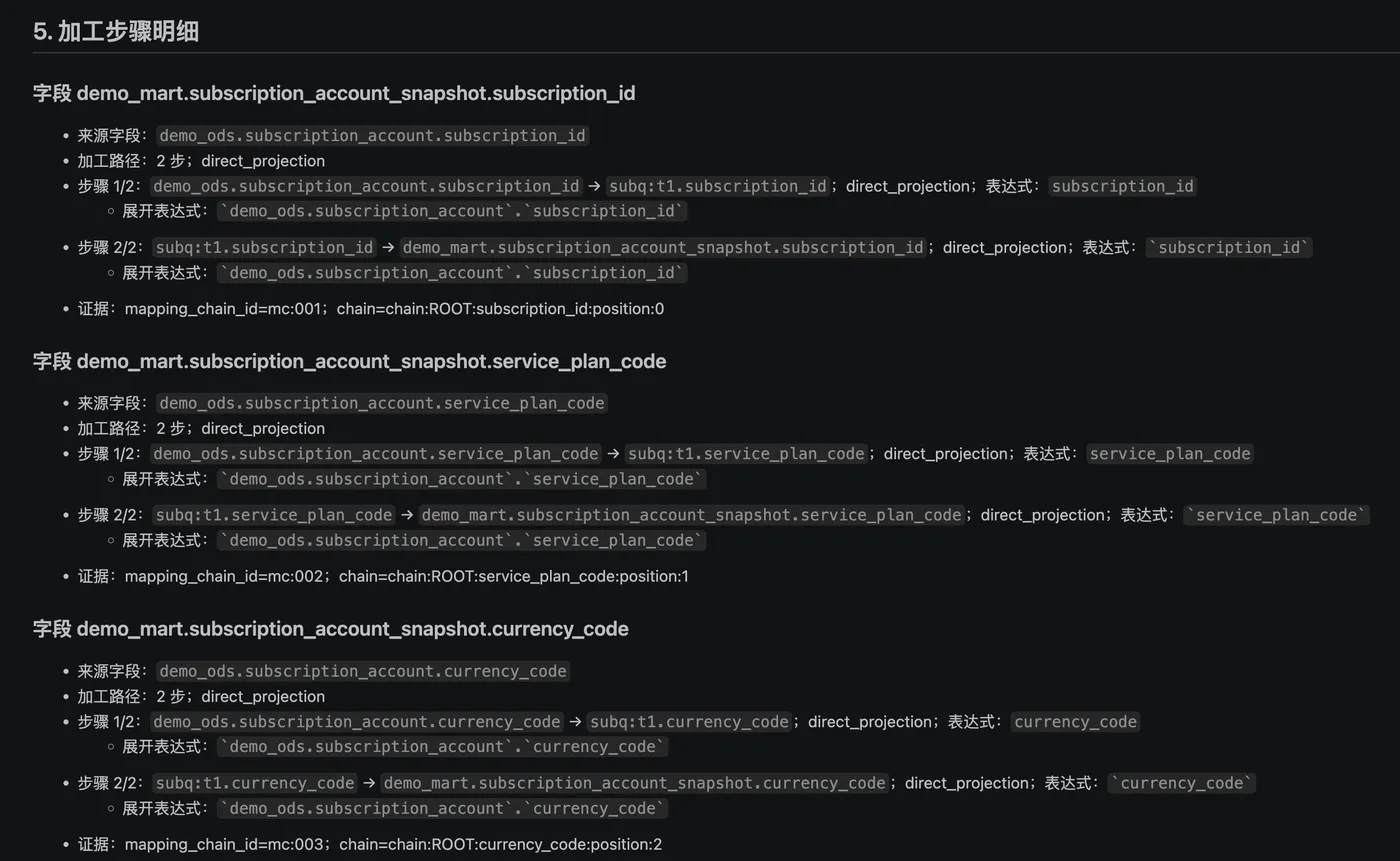
除以上内容外,自动生成的mapping文档中,还包括了来源表、来源表关系、scope 结构图,任务依赖关等内容:
仓库里还放了一份更复杂的样例:examples/sql/subscription_account_snapshot.sql,604 行、涉及 19 张源表,工具解析也是毫无压力的。
工具怎么使用
先看看需要什么输入
两类东西:SQL / 调度任务 + 表结构元数据。单个 .sql 文件可以直接解析,调度平台导出的任务 JSON 可以整目录批量解析。
表结构元数据(每张表的字段清单)主要解决三个精度问题:
SELECT *展开成具体字段;- 多表查询中未限定字段引用(没带表别名的字段)的归属判定;
- INSERT 投影需要按目标表真实字段位置完成绑定,因此需要目标表的字段顺序。
这些信息通常可以从 DESC table 或元数据平台批量获取,没有元数据也可以运行,但无法确认的部分会显式标记为降级结果,而不是猜测。JSON / CSV 的具体格式和元数据配置方式见仓库文档。
为了方便大模型使用,我还做了 Skill
scope-lineage是一个python包,CLI 本身一条命令就装好:
pipx install scope-lineage # 需要 >= 0.2.0
但更省心的用法是再装上仓库自带的 skill。装完后就可以直接和LLM问答了:
- "paid_amount 是怎么算出来的?"
- "谁依赖 ods.orders.pay_status?"
- "把这批任务解析一下" / "生成 mapping 文档"
- "这个字段为什么没追到底?"
装好以后,Agent 会自己判断该查加工链、做影响分析,还是重新解析任务。配置过元数据路径的话,批量解析时也会直接带上;字段没追到底,就把对应的诊断结果一起告诉你。
安装:装一次、用户级生效,按你用的 agent 三选一——
| Agent | 安装方式 |
|---|---|
| Claude Code | /plugin marketplace add realyin/scope-lineage,然后安装 scope-lineage 插件 |
| Codex | git clone https://github.com/realyin/scope-lineage ~/tools/scope-lineage,把其中 skills/scope-lineage 软链进 ~/.codex/skills/ |
| 其他 agent | 同上 clone,在规则文件(如 AGENTS.md)里加一行:血缘相关问题先读 ~/tools/scope-lineage/skills/scope-lineage/SKILL.md 并遵循它 |
当前边界
当前 0.2.x 仍处于 Alpha 阶段,有几个边界需要提前说明:
- 它做静态分析,不判断 SQL 在真实集群上是否能成功执行;
- 独立的
UPDATE/DELETE当前不属于字段投影模型(MERGE里的更新/插入分支支持); - 动态 SQL 和平台自定义语法可能需要先预处理;
- 元数据不完整时,
SELECT *等场景会显式降级。
最后
源码什么的都在这里了,大家可以点点星星:
https://github.com/realyin/scope-lineage
相关阅读:上一篇 《一个 SQL 字段到底是怎么算出来的?我做了一个能给出"证据"的血缘工具》,讲了它的解析模型——为什么每条血缘都要带证据、无法证明时怎么处理。

