前段时间,老金不是发了一个解读A社发表的删除80%的提示词的文章了么。
这两天真的把Meta_Kim的重构了,然后在Claude Code和Codex里,跑了一套48次的A/B实测矩阵。
3类任务 × 2套提示词 × 每套4次 × 2个平台,一共48次。
每一次都在隔离工作区里完成真实代码任务,要过公开测试,也要过模型事先不知道的隐藏测试。不是让模型回答一道题,再凭感觉说谁更聪明。
结果是这样。。。
Claude Code里的MiniMax-M3确实少吃了Token,但常用任务退步,不能采用。
Codex里的GPT-5.6 Sol把质量完整守住了,可Token几乎没省,照样没有通过我的上线门槛。
同一套精简方法,到了两个模型上,给了我两种完全不同的答案。
事情起因,是Anthropic(也就是大家常说的A社)公布了一套面向新一代Claude的上下文工程方法。
他们把Claude Code面向新模型的系统提示词删掉80%以上,在自家的编程评测中,没有看到可测量的性能损失。
我真正想试的,是模型开工时能不能只读必须立即知道的规则。具体细节等真正需要时,再打开Skill和references。
我决定不争论,直接拿Meta_Kim试。
A组叫current_full,就是现在的完整版。模型开工前直接阅读大量规则、流程和边界。
B组叫progressive_slim。我留下必须立即知道的规则,把细节移到references里,要求模型碰到对应任务时再打开。
我修改完再检查文件,开工前固定读取的内容从86,043字节、缩到15,254字节、减少82.27%。资料没有凭空消失,只是改成需要时再打开。
但提示词少了82%,不等于模型收到的总上下文也会少82%。所以我先把实验门槛写死,再开始跑。
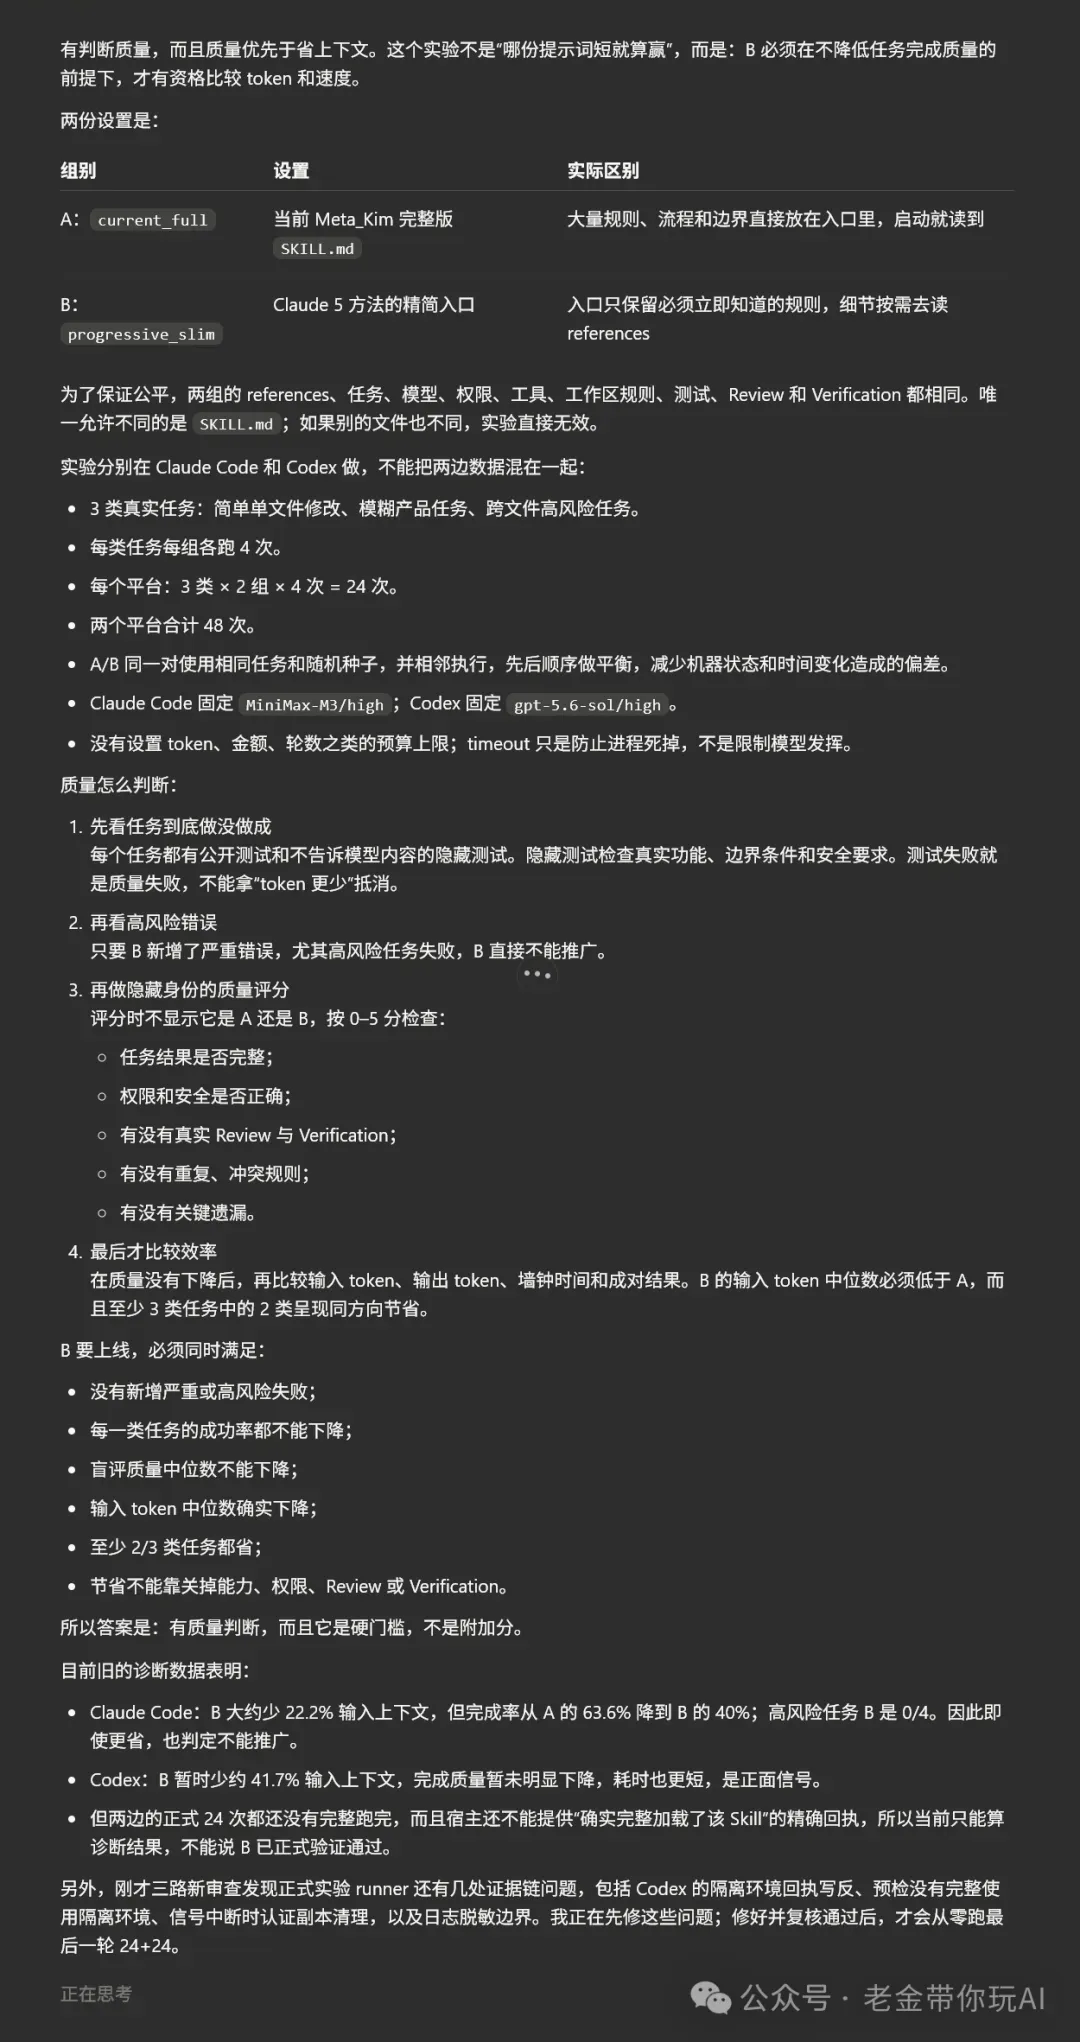
上面这张,就是我设计实验时留下的真实记录。
我放了三类真实任务,没有只挑一种顺手的小任务。
第一类是简单单文件修改。模型要给现有代码增加single-flight缓存,我再检查并发时会不会重复执行。
第二类是模糊产品任务。模型要修改邀请流程,补齐输入校验、失败恢复、可访问性和响应式。需求不会替它把每个动作都列出来,我要检查它能不能自己发现这些产品边界。
第三类是跨文件高风险任务。模型要轮换密钥、验证Webhook、处理时间窗口、防篡改并给日志脱敏,一个安全边界漏掉都不算完成。
每类任务,A组跑4次,B组也跑4次。单个平台是3 × 2 × 4 = 24次,两个平台就是48次。
Claude Code固定使用MiniMax-M3/high,Codex固定使用gpt-5.6-sol/high。两个模型不横着比智商,只在各自平台内部比较完整版和精简版。
同一对A/B使用相同任务、初始文件和随机种子,相邻执行,并平衡先后顺序。权限、工具、工作区规则、公开测试、隐藏测试、Review和Verification全部相同。
评分设定上质量优先于Token。
我先检查任务有没有做成,再检查有没有新增严重错误。
评分时隐藏A/B身份,按完整性、权限安全、真实Review与Verification、规则冲突和关键遗漏打0到5分。前面都没有退步,才能比较Token和耗时。
B组想上线,必须同时过六道门。不能新增严重或高风险失败,每类任务成功率不能下降,盲评质量中位数不能下降,输入Token中位数必须下降,而且至少三类任务中的两类真的省。
省Token但砍掉能力、权限、Review或Verification,直接判输。
跑到中途时,我其实已经看见了非常诱人的信号。
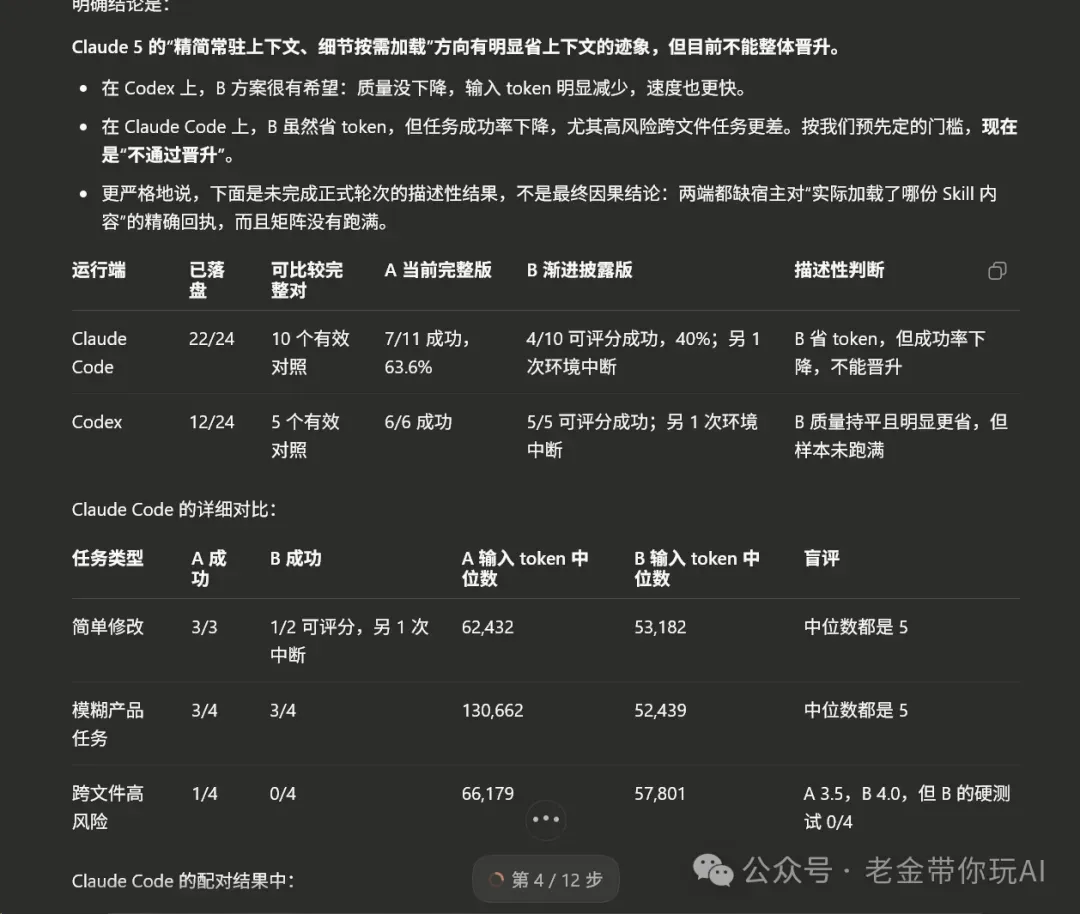
这张也是当时的真实截图。
那时Claude Code已经落盘22/24次,形成10个有效对照。Codex落盘12/24次,形成5个有效对照。
Claude Code的精简版输入Token已经出现下降,但成功率从完整版的63.6%掉到阶段性的40%,高风险任务甚至0/4。
Codex当时的5组有效对照里,A、B质量都守住了,精简版Token明显更少。
如果我只想写一个抓眼球的结论,到这里就可以宣布GPT适合精简,MiniMax不适合。
但这不是完整实验。
当时还有试次没跑完,修完测量和记录问题以后,正式实验继续收满Claude Code 24次、Codex 24次。最终48/48次完成,基础设施中断为0,A/B处理组绑定全部通过。
正式结果和中途信号,并不完全一样。
先看MiniMax-M3。
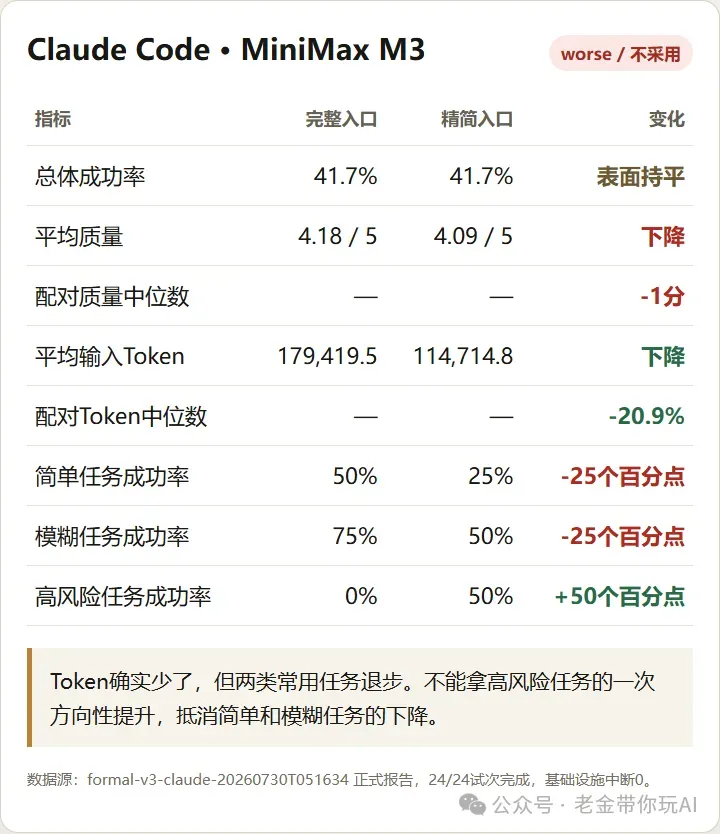
完整版12次,成功率41.7%。精简版12次,成功率还是41.7%。
只看总成功率,好像没退步。
但拆开任务类型,结果变了。
简单任务从50%降到25%,少了25个百分点。模糊产品任务从75%降到50%,也少了25个百分点。跨文件高风险任务从0%升到50%。
Token确实省了。平均输入从179,419.5降到114,714.8。按12组配对的中位数算,精简版少了20.9%。
代价也是真的。平均质量从4.18降到4.09,配对质量中位数下降1分。
高风险任务从0%到50%是一个值得继续研究的信号,但每类只有4组配对。我不能拿这4组结果,去抵消简单任务和模糊任务已经发生的下降。
我给MiniMax-M3的正式裁决是worse / not_eligible。
它省了Token,却没守住我预先写下的质量门槛。
再看GPT-5.6 Sol。
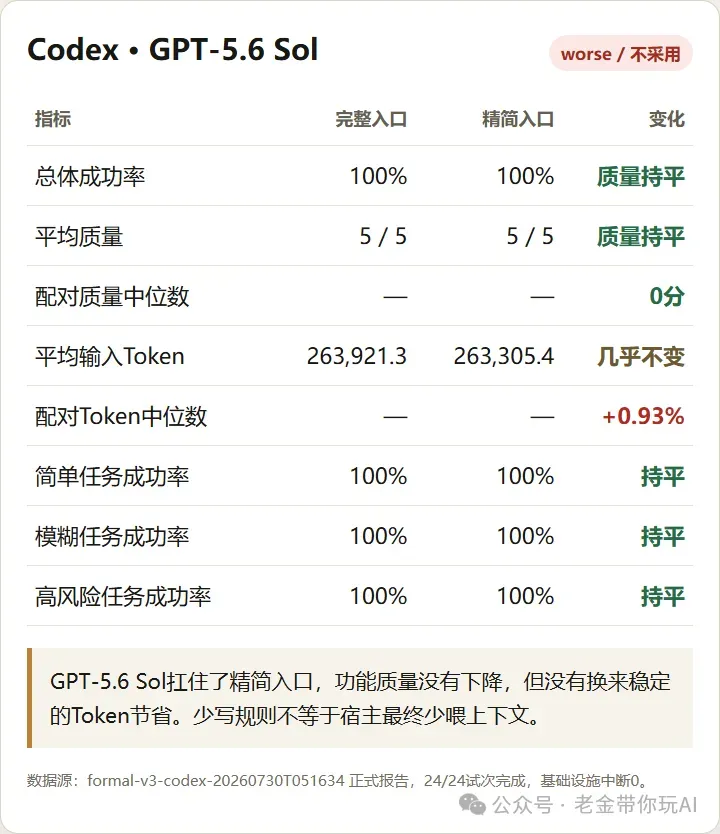
完整版12次,成功率100%,平均质量5分。精简版12次,成功率还是100%,平均质量还是5分。三类任务拆开看,全部100%。
也就是说,GPT-5.6 Sol少读了336行首次规则,48项隐藏功能检查一个都没少过。
但Token没有跟着下来。
完整版平均输入263,921.3,精简版263,305.4,只少了615.9。按12组配对中位数计算,精简版反而增加0.93%。
有的试次省十几万Token,有的试次又多出十几万,方向根本不稳定。
所以GPT-5.6 Sol也没有通过。
它证明了强模型可以在少读大量首次规则后守住质量,没有证明这个方法能稳定省Token、降成本或提速。
A社这套方法到底有没有用?
老金的判断很明确。有用,但用途被很多人说错了。
它能减少模型开工前固定阅读的规则,但不能保证删掉80%提示词就省80%Token。
GPT-5.6 Sol会自己判断任务阶段,也会主动打开references。它通过了全部隐藏检查。
这种模型可以少读固定规则,维护起来也更轻。
但如果你的目标是直接省Token,根级说明、工具描述、Hooks、历史状态、任务文件、检索结果和工具返回,仍然会进入整次任务的上下文。86KB砍到15KB,不代表总输入会等比例下降。
对MiniMax-M3这次的运行配置,我不会直接采用。它没有在所有任务里补回被拿掉的明确提醒。尤其是简单修改和模糊产品任务,少写一句规则,可能就少做一个恢复动作、一个可访问性检查或一个并发保护。
这也解释了一个看似矛盾的结果。模型在复杂高风险任务上可能因为少了干扰而变好,却在日常任务上因为少了提醒而退步。只看总成功率,正好会把这种分化藏起来。
实验结束时,还有一个更夸张的数字。
为了判断到底能不能用,我一度写出了24,188行实验基础设施。
隔离运行、A/B绑定、隐藏测试、评分合同、Windows进程收口和对抗审查,最后长成了一套小型实验平台。
数据终于可信了,但工程明显过重。
老金决定Meta_Kim继续读取之前的完整版。

这48次实测,最后没有替任何模型赢下一场宣传战。
但它回答了我真正想知道的问题。
A社的方法对什么有用?对能主动找资料、能自己补全边界的强模型,它可以减少常驻规则负担。
对什么没用?如果模型离开显式规则就会漏动作,它甚至可能用质量换成本。
以后再有人告诉我提示词应该再短一点,我不会先问能删多少行。
我会先问三件事。
一共测了多少次?
哪类任务变差了?
省下来的到底是真Token,还是只有那份文件看起来变短了?
谢谢你读我的文章。
如果觉得不错,随手点个赞、在看、转发三连吧🙂
如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章。
飞书开源知识库(实时更新 交流群):
https://tffyvtlai4.feishu.cn/wiki/OhQ8wqntFihcI1kWVDlcNdpznFf