自变量开源 HOST 框架,让机器人看一条数十秒视频学会新技能,较主流方法提速 500 倍

简介: 自变量机器人发布开源HOST框架,首创“观察学习”范式:机器人仅凭一段29秒人类视频,即可理解任务目标、动态对齐进度、反推自身动作,技能习得成功率62%,速度提升500倍,且不遗忘旧技能,让普通人也能轻松教学。


自变量机器人今日发布
HOST 框架(Human-to-robot One-Shot Skill AcquisiTion,人类到机器人单样本技能获取)并开源,能让机器人仅观察一段数十秒的人类视频就学会新技能,同时保留已掌握的技能。

HOST 采用了一种开创性的方法:不去将人类动作翻译为机器人动作并试图模仿,而是让机器人先想象执行动作后的结果,再从结果拆分出需要执行的动作。

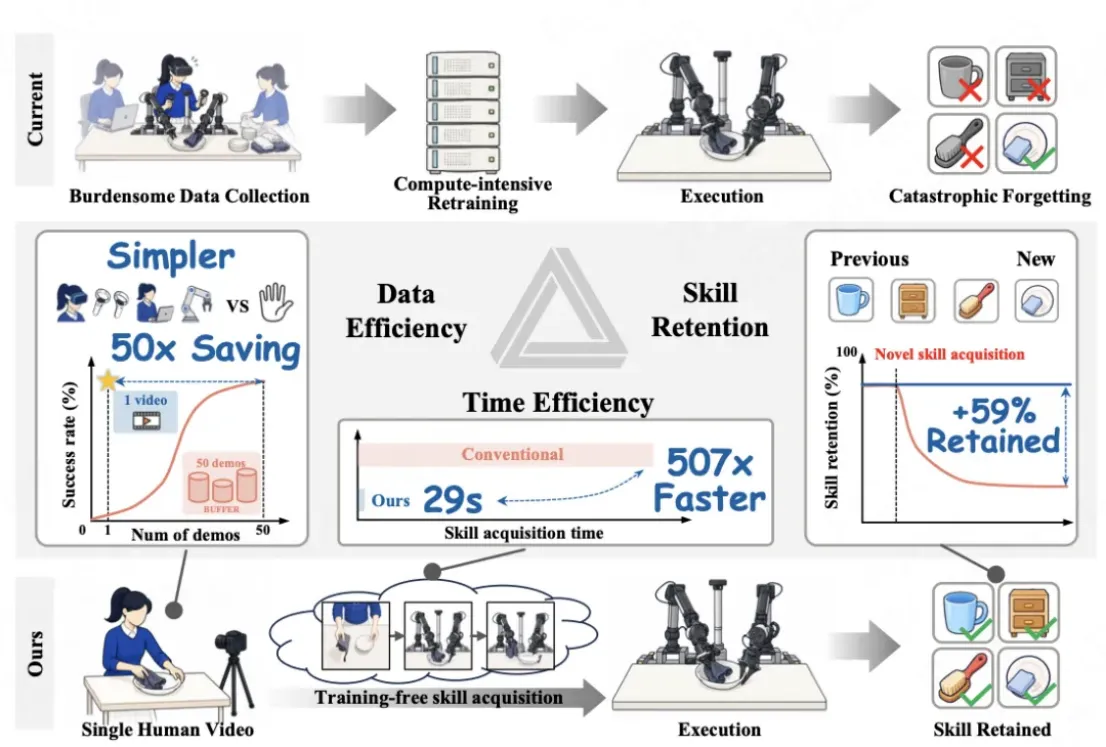
这种全新方法的效果令人欣喜:机器人从一段 29 秒人类视频中学习技能的成功率高达 62%,超越零样本基线 45%。相比 Pi-0.5 + 微调方案,HOST 所需数据量减少 50 倍,学习技能速度提升 500 倍。

模仿人类“观察学习”过程,自动对齐视频任务进度

HOST 的思路来自认知科学中的“观察学习”理论:人类面对不熟悉的任务时,不需要通过长期练习或者穷举来学习,而是以先验能力在大脑中模拟动作的预期效果,然后执行相应动作。

自变量研究人员受此启发,将 HOST 的学习方案从“训练时微调循环”变为“推理时技能获取”,让机器人通过观察人类执行任务来学习新技能。

机器人首先要解决的问题是:如何对齐自己执行任务的进度和视频中的进度?

举例来说:同样工作 10 秒,视频中的人可能已经切完菜、开始炒菜了,机器人还在切菜。如果只仅按时间对齐,机器人就会丢失任务进度。

对此,HOST的做法是“按任务进度对齐”。HOST 会将视频每一帧和机器人操作每一步都转化为同一向量空间里的向量;然后利用“动态时间规整”算法,自动对齐“人类视频的第 X 帧和机器人操作的第 Y 步”。如此一来,机器人执行到每一步时,看到的永远都是和任务进度对齐的那一帧。

凭借这种方法,HOST 将对齐任务进度的时间误差降低了一个数量级,能够做到机器人执行与视频示范的精准同步。

机器人不再模仿人类动作,而是从动作结果反推过程

机器人学习人类经验的第二个难点在于:机器人身体结构与人完全不同,无法简单跟随视频“照着做”,需要找到一种动作的翻译方式。

机器人的构型千奇百怪,如何找到一套通用解法?HOST 规避了“对照身体结构”的问题,分为三步解决:

首先,机器人需要判断自己进行到任务的哪个部分。其次,机器人需要将人类执行完动作的画面翻译成机器人自身视角和身体结构的画面。举例来说,机器人看到人类拿起一杯水,就要想象出机器人拿起水杯的画面。最后,机器人从画面推断出需要执行的动作,并执行这些动作。

这个解法的优势在于,它利用“看到人类动作结果-想象出机器人动作结果-拆解结果对应的机器人动作”的思路,让机器人利用视觉推理看到结果画面,再反推动作过程,而不是机械地模仿人类动作,从而绕开了“动作映射”的问题。

模型训练两步走:先预测机器人动作,再迁移到人类教学

HOST 的核心部分是一个带有视觉预测功能的级联策略模型。它采用双专家 MoT 架构,如同两个分工明确的大脑:“视觉大脑”(视频专家)专门处理视频画面、定位任务进度、预测未来图景;“动作大脑”(动作专家)负责将预测图景转化为需要执行的动作,并控制执行。

在训练模型时,自变量团队将训练过程拆分为“同体预训练”和“人机视频训练”两个阶段。在同体预训练阶段,机器人通过学习机器人自身执行任务的视频,学会预测完成任务后的状态,并生成对应动作。在人机视频训练阶段,机器人进一步学习人类演示视频,将人类执行任务的过程转化为机器人视角下的任务结果,再根据目标结果推理完成任务所需的动作,实现从人类示范到机器人技能的迁移。

如此分两步训练的优势在于:人与机器人执行同一任务的匹配数据相对稀缺,机器人执行任务的视频与轨迹则容易采集得多。先观看机器人视频打好“基本功”,再迁移到人类视频学习,能大幅提升数据训练模型的效率。

学习新技能成功率高达 62%,较主流方法提速 500 倍

HOST 模型的权重在训练好后即冻结,仅在推理过程中观看视频和复现技能。尽管全部学习素材只有一段视频,它的学习效果仍令人感到欣喜:

仅观看一段平均 29 秒的人类视频,HOST 复现技能的成功率高达 62%。相比之下,Vid2Robot/AWDA 同样从一段视频中学习技能,成功率仅有 19%。如果采用微调模型的方法,给 Pi-0.5 示范 50 个机器人任务并花 4 小时微调训练,成功率也仅有 38%。

相比 Pi-0.5 + 微调方案,HOST 仅需 1/50 的数据样本量和 1/500 的学习时间,就能让成功率大幅提升 24%,成为当前表现最好的机器人技能学习方案。
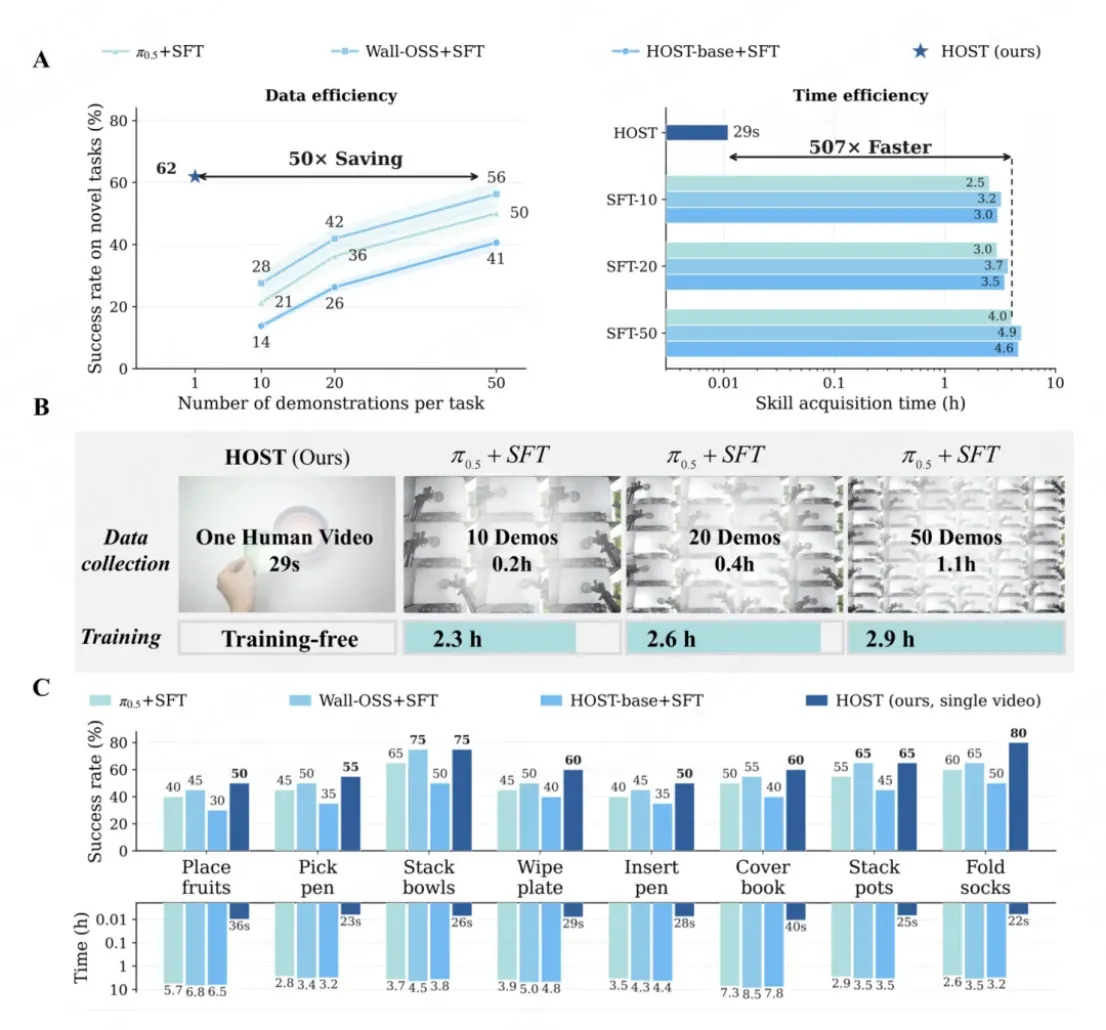
不仅如此,HOST 还能最大限度地保留已经学习的技能,因为它仅根据视频来复现技能:视频更像是“菜谱”,可以放入书架随时调取。如此便实现了技能的持久化记忆和联想机制。相比之下,Pi-0.5 + 微调方案学习新技能后,过去技能的保留率仅有 17%。

在泛化性方面,HOST 测试了 50 个包含不同物体、工具和基本动作的任务,均学习到新技能。在鲁棒性方面,HOST 面对改变光照、替换物体、替换场景和移动物体等干扰,成功率仍全部保持在 50% 以上。即使中途把物品挪走,HOST 也能调整回来继续任务。这说明 HOST 不是在“死记硬背”动作序列,而是真正理解任务、动态规划下一步动作。

普通人也能教授新技能,机器人迈向灵活学习新阶段

简单来说,HOST 将机器人学习技能的范式从“训练时微调循环”改变为“推理时技能获取”。它仅从一段数十秒的人类视频去学习技能,成功率则远超主流模型经过后训练微调的效果。不仅如此,HOST 还能随时调取技能,解决了“灾难性遗忘”的问题。

对此,自变量机器人团队表示:“在具身智能走出实验室、走进千家万户的进程中,不应该只靠专业人员采集数据、反复训练来获得新技能。人与人之间通过示范传递技能,是更加自然高效的学习方式。HOST 将技能获取从少数人的专业流程,转变为任何人都能用一段视频完成教学。”

目前,HOST 的研究论文和代码已经全部开源。未来机器人在家庭劳动时,有望摆脱专业化的数据采集和训练过程,通过直观的人类演示就学会新技能。这将让智能机器人成为真正贴心可用的“家庭伙伴”,让智能机器人服务人类的每一天。

目录
相关文章
|
2月前
|
人工智能 负载均衡 API
一个端点接 290 家 AI 服务商--我拆解了周增 7700 Star 的 OmniRoute
OmniRoute 是一款 MIT 协议的本地 AI 网关(TS 编写),聚合 290+ 服务商、500+ 模型,提供 OpenAI 兼容接口。支持智能 Combo 路由、12 因子 auto 选模、三层弹性容错与 RTK 等 12 种 Token 压缩引擎,显著提升免费额度利用率与稳定性。(239 字)
430 1
|
2月前
|
人工智能 安全 Linux
零门槛搭建云端 AI 编程环境:Linux 服务器 Docker 部署 OpenCode 保姆级教程
在云原生与AI编程深度融合的当下,OpenCode凭借轻量化、浏览器访问、AI辅助编程的特性,成为开发者打造云端开发环境的优选方案。通过Docker容器化部署OpenCode,可在Linux云服务器上快速搭建跨平台、可随时访问的AI编程环境,无需本地安装复杂IDE,随时随地通过浏览器编写、调试代码,结合AI能力大幅提升开发效率。本文将从环境准备、Docker安装、OpenCode部署、配置优化到安全加固,提供保姆级全流程教程,确保零基础用户也能顺利完成部署,打造专属云端AI编程工作台。
330 0
零门槛搭建云端 AI 编程环境:Linux 服务器 Docker 部署 OpenCode 保姆级教程
|
2月前
|
SQL 人工智能 文字识别
阿里把内部用了两年的 AI 代码审查工具开源了——我跑了一遍 Open Code Review
阿里开源的 Open Code Review 是一款工程化 AI 代码审查工具,采用“确定性模块 + LLM Agent”混合架构,精准定位问题、严控误报率,支持 Git 差异审查与全量扫描,已落地服务数万开发者。周增星 4750,Apache-2.0 协议,轻量易集成。(239 字)
1398 2
|
2月前
|
JSON 自然语言处理 小程序
快递单号查询接口 免费快递查询API接口教程
本教程详解全球快递物流查询API实操:支持1500+快递公司,提供单号查询、轨迹跟踪、时效预测、批量订阅等功能,具备自动识别、多语言示例、秒级响应、灵活计费(含免费试用)及私有化部署能力,适用于电商、ERP、小程序等多场景,5步即可快速接入。
1768 2
快递单号查询接口 免费快递查询API接口教程
|
2月前
|
存储 缓存 JavaScript
DeepSeek Harness rc.8 更新解读:图片输入、自动打开网页,以及两个实用社区工具
DeepSeek Harness rc.8 带来了图片输入、子代理安装、Windows PowerShell 会话与 Web 自动打开等改进。本文解读更新重点,并介绍 dsh-launcher 启动器和 dsh-plugin-token-meter 计费统计插件。
DeepSeek Harness rc.8 更新解读:图片输入、自动打开网页,以及两个实用社区工具
|
2月前
|
人工智能 运维 自然语言处理
大型企业怎么做数据治理?有哪些好用的数据治理工具?
本文剖析大型企业数据治理四大核心挑战,提出“OneData+治理开发一体化+AI赋能+资产服务化”破局方法论,并重点介绍阿里云瓴羊Dataphin——一款深度融合阿里巴巴实战经验的一站式智能数据治理平台,助力企业构建高质量、可信赖、可运营的数据资产体系。(239字)
|
2月前
|
人工智能 算法 搜索推荐
GEO优化最容易犯的八大错误及深远影响
本文深度解析生成式引擎优化(GEO)的底层逻辑与实践误区,指出GEO并非SEO升级版,而是规则重构:从链接排序转向答案生成,E-E-A-T成核心信任过滤器。梳理八大常见错误——如关键词堆砌、实体模糊、经验缺位、不可抽取等,并提供“立实体、建可引用单元、引权威信源、常态化更新”四大修正路径,助力内容真正被AI看见、信任与引用。
252 1
|
2月前
|
缓存 人工智能 自然语言处理
最新版通义千问(Qwen3.8-Max)功能介绍
Qwen3.8-Max是通义千问系列迄今规模最大、能力最强的旗舰大模型,定位为**全场景智能体基座**,可独立完成复杂任务、长周期执行与多模态交互,支撑科研开发、企业服务、工程设计、内容创作等多元场景。该模型基于Qwen 3.5架构迭代升级,采用**第三代稀疏MoE混合专家架构**,总参数量达2.4万亿,推理时仅激活95B有效参数,在保持超大模型能力上限的同时,大幅降低算力消耗与推理成本,实现“轻量架构、旗舰性能”的突破。
496 2
|
2月前
|
缓存 安全 Windows
老金实测:提示词删82%之后,MiniMax退步,GPT-5.6没省Token
![Image](https://ucc.alicdn.com/pic/developer-ecology/p3shvhj26rigq_6b49b01aa4e3434ba10e05398fbd2cb5.png) 前段时间,老金不是发了一个解读A社发表的删除80%的提示词的文章了么。 这两天真的把Meta\_Kim的重构了,然后在Claude Code和Codex里,跑了一套48次的A/B实测
|
2月前
|
人工智能 运维 自然语言处理
Geo专家于磊解析:GEO优化的基础、提升与突破
本文揭示生成式AI正重塑信息获取方式:用户不再点击链接,而是直接获取合成答案。GEO(生成式引擎优化)由此诞生——它不优化网页排名,而优化内容被AI采信、引用与复述的能力。Geo专家于磊提出“基础—提升—突破”三层框架,强调可信前提、可引用性、结构清晰是地基,数据支撑与答案岛是杠杆,实体网络与全域信任方达上限。
260 1