在AI技术飞速发展的今天,本地部署大模型正成为越来越多用户的选择。本地部署不仅能实现数据隐私的绝对安全,避免敏感信息上传云端,还能摆脱网络依赖,实现断网环境下的稳定使用,同时无需持续支付API调用费用,成本更加可控。DeepSeek作为一款性能优异的开源大模型,在代码生成、逻辑推理、多轮对话等场景中表现出色,而Ollama与Chatbox的组合,则为本地部署DeepSeek提供了零门槛、可视化的解决方案。Ollama是一款轻量级、开源的大模型管理工具,能一键拉取、运行、管理各类开源大模型,屏蔽了底层复杂的环境配置;Chatbox则是一款开源的AI桌面客户端,提供了友好的可视化交互界面,让本地模型的使用体验媲美在线AI助手。接下来,我们将从零开始,手把手带你完成Ollama+Chatbox+DeepSeek的本地部署全流程,即使是零基础用户也能轻松上手。
一、部署前准备:硬件与环境要求
本地部署大模型对硬件有一定要求,尤其是内存和存储,不同参数的DeepSeek模型对硬件的需求差异较大,提前确认硬件配置能避免部署过程中出现卡顿、无法运行等问题。
最低硬件配置:
- 操作系统:Windows 10/11、macOS 10.14+、Linux Ubuntu 18.04+(三大主流系统均支持)
- 内存:8GB RAM(仅能运行DeepSeek-R1:1.5b/7b量化版,运行速度较慢)
- 存储:至少10GB可用空间(模型文件+软件安装包,建议预留20GB以上)
- 处理器:Intel i5/AMD Ryzen 5及以上,多核处理器能提升推理速度
推荐硬件配置:
- 内存:16GB RAM及以上(可流畅运行DeepSeek-R1:14b量化版,响应速度大幅提升)
- 存储:50GB+可用空间(方便存储多个版本模型,避免频繁删除)
- 显卡:支持CUDA的NVIDIA显卡(显存≥8GB,如RTX 3050/3060,可显著加速模型推理,无独显也可运行,仅速度较慢)
软件环境准备:
- 终端工具:Windows系统准备PowerShell或CMD,macOS/Linux系统准备Terminal(后续命令均在终端执行)
- 网络环境:稳定的网络连接(用于下载Ollama、Chatbox安装包及DeepSeek模型文件,模型下载完成后可断网使用)
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。
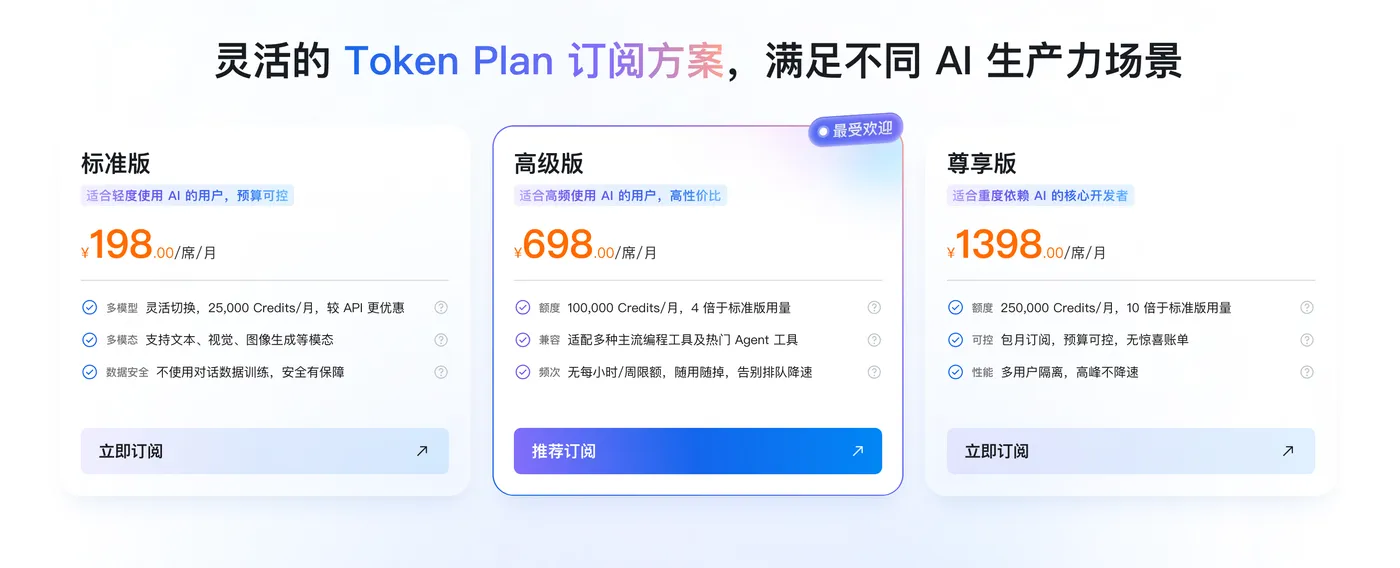
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。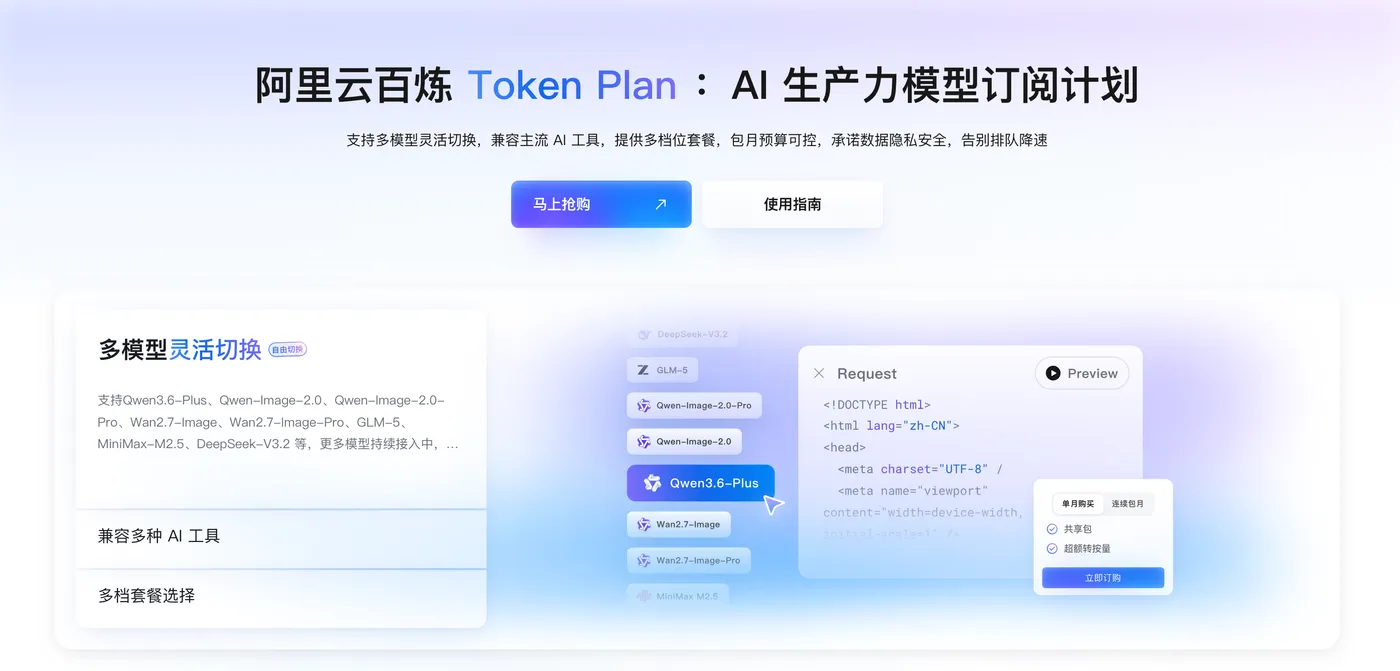
二、第一步:安装Ollama(大模型管理核心)
Ollama是整个部署流程的核心,它负责DeepSeek模型的下载、运行、管理,安装过程非常简单,支持三大操作系统一键安装。
2.1 Windows系统安装Ollama
方式一:图形化安装(推荐新手)
- 打开浏览器,访问Ollama官方网站(ollama.com),点击页面中的「Download」按钮,自动下载Windows版本安装包(OllamaSetup.exe)。
- 下载完成后,双击OllamaSetup.exe启动安装向导,默认勾选「Add to PATH」(将Ollama添加到系统环境变量,方便终端调用),点击「Install」开始安装。
- 安装完成后,Ollama会自动在后台启动服务,系统托盘(右下角)会出现Ollama图标,右键可查看运行状态。
- 验证安装:按下Win+R,输入cmd打开命令提示符,输入命令
ollama --version,若输出版本号(如ollama version 0.1.38),则安装成功。
方式二:PowerShell一键脚本(无图形界面)
- 右键开始菜单,选择「Windows PowerShell(管理员)」,以管理员身份打开终端。
- 复制并执行以下命令,自动下载并安装Ollama:
irm https://ollama.com/install.ps1 | iex - 安装完成后,关闭并重新打开PowerShell,输入
ollama --version验证安装。
注意:Ollama默认安装在C盘,模型文件也默认存储在C盘(C:\Users\你的用户名.ollama\models),若C盘空间不足,可通过设置环境变量修改模型存储路径:
- 按下Win+R,输入
sysdm.cpl,打开系统属性窗口。 - 切换到「高级」选项卡,点击「环境变量」。
- 在「用户变量」中点击「新建」,变量名输入
OLLAMA_MODELS,变量值输入目标路径(如D:\Ollama\Models),点击确定保存。 - 重启终端,后续下载的模型将自动存储到指定路径。
2.2 macOS系统安装Ollama
方式一:一键脚本(通用)
- 打开Terminal终端,复制并执行以下命令,自动下载并安装Ollama:
curl -fsSL https://ollama.com/install.sh | sh - 安装完成后,输入
ollama --version验证安装,输出版本号即成功。
方式二:Homebrew安装(推荐有brew环境用户)
- 打开Terminal,执行以下命令安装Homebrew(已安装可跳过):
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)" - 执行命令安装Ollama:
brew install ollama - 验证安装:
ollama --version。
2.3 Linux系统(Ubuntu/Debian)安装Ollama
- 打开Terminal终端,执行以下一键安装命令:
curl -fsSL https://ollama.com/install.sh | sh - 安装完成后,输入
ollama --version验证,若提示命令未找到,可重启终端或手动添加环境变量。
三、第二步:拉取并运行DeepSeek模型(核心操作)
Ollama安装完成后,即可通过终端命令拉取DeepSeek系列模型,Ollama支持DeepSeek-R1的多个量化版本,包括1.5b、7b、14b等,用户可根据自身硬件配置选择合适版本。
3.1 选择DeepSeek模型版本
- DeepSeek-R1:1.5b:最小版本,仅需8GB内存,适合低配笔记本,响应速度快,适合简单对话、基础问答。
- DeepSeek-R1:7b:主流版本,8GB内存可运行,16GB内存更流畅,适合代码生成、文档总结、多轮对话。
- DeepSeek-R1:14b:进阶版本,需16GB+内存,推理能力更强,适合复杂逻辑推理、长文本处理。
3.2 拉取DeepSeek模型(终端执行)
打开终端(Windows用PowerShell/CMD,macOS/Linux用Terminal),执行以下命令拉取对应版本模型,Ollama会自动下载并配置模型,无需手动处理依赖:
拉取1.5b版本(低配推荐)
ollama pull deepseek-r1:1.5b
拉取7b版本(主流推荐)
ollama pull deepseek-r1:7b
拉取14b版本(高配推荐)
ollama pull deepseek-r1:14b
命令执行后,终端会显示下载进度,模型文件体积较大(1.5b约3GB,7b约8GB,14b约16GB),下载时间取决于网络速度,耐心等待即可。下载完成后,终端会提示「Success」,表示模型拉取成功。
3.3 验证模型运行(命令行测试)
模型拉取完成后,可通过命令行直接运行DeepSeek,测试是否正常工作:
ollama run deepseek-r1:7b
执行命令后,终端会进入对话模式,输入「你好」,若DeepSeek正常回复,则模型运行成功。退出对话模式可按Ctrl+D快捷键,或输入/bye命令。
常用Ollama模型管理命令:
- 查看已下载模型:
ollama list - 删除指定模型:
ollama rm deepseek-r1:7b - 查看Ollama服务状态:
ollama ps - 停止Ollama服务:
ollama stop
四、第三步:安装Chatbox(可视化交互界面)
命令行使用DeepSeek不够便捷,Chatbox提供了类似ChatGPT的可视化界面,支持多轮对话、历史记录保存、模型切换等功能,安装与配置同样简单。
4.1 下载Chatbox安装包
- 打开浏览器,访问Chatbox官方网站(chatboxai.app/zh),点击首页「免费下载」按钮,自动识别操作系统并下载对应安装包。
- Windows系统下载.exe文件,macOS系统下载.dmg文件,Linux系统下载.AppImage/.deb/.rpm文件。
4.2 安装Chatbox(分系统操作)
- Windows系统:双击下载的.exe安装包,按照向导完成安装,勾选「创建桌面快捷方式」,安装完成后启动Chatbox。
- macOS系统:双击.dmg文件,将Chatbox图标拖拽至「应用程序」文件夹,完成安装后从启动台打开。
- Linux系统:以.AppImage为例,下载后打开终端,赋予文件执行权限并启动:
chmod +x Chatbox-xxx.AppImage
./Chatbox-xxx.AppImage
4.3 首次启动与基础设置
- 首次启动Chatbox,会显示欢迎界面,提供三种登录模式:本地匿名模式、邮箱注册、第三方授权登录,选择「本地匿名模式」即可使用完整功能,无需注册账号。
- 进入Chatbox主界面,默认语言为英语,可点击右上角「Settings」→「General」→「Language」,选择「简体中文」,重启Chatbox生效。
五、第四步:Chatbox对接Ollama+DeepSeek(核心配置)
Chatbox安装完成后,需要配置对接本地Ollama服务,调用已下载的DeepSeek模型,实现可视化交互。
5.1 进入Chatbox模型配置界面
- 打开Chatbox,点击右上角「设置」图标(齿轮形状),进入设置页面。
- 在左侧菜单栏选择「模型」,或直接点击「Custom API」→「Local Model」,进入本地模型配置界面。
5.2 配置Ollama API参数
在模型配置页面,找到「Ollama API」选项,填写以下关键参数(无需修改,默认即可,仅需确认):
- API地址:
http://localhost:11434(Ollama默认服务地址,本地部署无需修改)。 - 模型选择:在下拉菜单中选择已下载的DeepSeek模型(如deepseek-r1:7b)。
- 其他参数:温度(Temperature)、最大生成长度(Max Tokens)等可保持默认,也可根据需求调整(温度越低,回复越严谨;温度越高,回复越有创意)。
5.3 保存配置并测试连接
- 确认参数填写无误后,点击「保存」按钮,Chatbox会自动连接本地Ollama服务。
- 连接成功后,返回Chatbox主界面,在输入框中输入问题(如「请解释什么是大模型」),点击发送,即可通过可视化界面与DeepSeek对话,所有对话记录会自动保存在本地,无需担心数据泄露。
六、进阶优化:提升本地模型使用体验
完成基础部署后,可通过一些进阶配置提升DeepSeek的运行速度、稳定性,优化使用体验。
6.1 启用GPU加速(NVIDIA显卡用户)
Ollama默认使用CPU推理,有NVIDIA显卡的用户可启用GPU加速,大幅提升响应速度:
- 确保已安装NVIDIA CUDA Toolkit(版本≥11.8,可从NVIDIA官网下载)。
- 打开终端,执行以下命令,重启Ollama服务并启用GPU:
# 停止Ollama服务 ollama stop # 启动Ollama并启用GPU(所有显卡) ollama serve --gpus all - 重新在Chatbox中发送问题,可明显感受到回复速度提升。
6.2 模型切换与管理
Ollama支持同时下载多个模型,Chatbox可快速切换:
- 在Chatbox设置→模型页面,下拉菜单中选择其他已下载模型(如从deepseek-r1:7b切换到deepseek-r1:14b)。
- 终端中可通过
ollama run 模型名快速切换命令行模型。
6.3 离线使用与数据备份
- 离线使用:模型下载完成后,关闭网络连接,Chatbox依然可以正常调用本地DeepSeek模型,所有对话数据存储在本地,完全离线。
- 数据备份:Chatbox的对话记录存储在本地目录,Windows系统路径为
C:\Users\你的用户名\AppData\Roaming\Chatbox,macOS系统为~/Library/Application Support/Chatbox,定期备份该目录可防止数据丢失。
七、常见问题与避坑指南
7.1 模型拉取失败/下载中断
- 原因:网络不稳定、磁盘空间不足、Ollama服务异常。
- 解决:检查网络连接,确保磁盘空间充足;重启Ollama服务(
ollama stop→ollama serve);重新执行拉取命令,Ollama支持断点续传。
7.2 Chatbox无法连接Ollama
- 原因:Ollama服务未启动、API地址错误、防火墙拦截。
- 解决:确认Ollama已启动(系统托盘有图标);检查API地址是否为
http://localhost:11434;关闭防火墙或添加Ollama到防火墙白名单。
7.3 模型运行卡顿/响应慢
- 原因:内存不足、未启用GPU加速、模型版本过高。
- 解决:关闭其他占用内存的程序;启用GPU加速;更换更低参数的模型版本(如从14b切换到7b)。
7.4 模型存储路径修改无效
- 原因:环境变量未正确配置、终端未重启。
- 解决:重新检查
OLLAMA_MODELS环境变量是否正确;重启终端后再次拉取模型。
八、总结与应用场景
通过Ollama+Chatbox的组合,我们实现了DeepSeek大模型的零门槛本地部署,整个流程无需复杂的环境配置,仅需几条命令和简单的界面操作即可完成。本地部署DeepSeek不仅解决了数据隐私问题,还能实现断网使用、成本可控,适合多种场景:
- 个人学习:本地学习大模型原理,测试模型能力,无需担心API费用。
- 代码开发:利用DeepSeek的代码生成能力,本地编写、调试代码,保护代码隐私。
- 文档处理:本地总结文档、翻译文本、生成报告,敏感数据不上传云端。
- 日常助手:作为本地智能助手,处理日常问答、日程规划、知识查询等。
Ollama与Chatbox的开源特性,也为用户提供了无限的扩展可能,后续可尝试部署其他开源大模型(如Llama 3、Qwen等),打造属于自己的本地AI生态。